[Notatnik pomysłów AI 01] SlideOn: mniejszy model wyszukiwania z dwiema przydatnymi regulacjami kosztu
Poznaj SlideOn i mSlideOn firmy LightOn: modele wyszukiwania rzadkiego dla dokumentów angielskich i wielojęzycznych oraz praktyczny sposób porównania jakości, szybkości i rozmiaru indeksu.
Notatnik pomysłów AI przybliża idee i praktyczne możliwości nowych modeli i narzędzi AI.
Pamiętasz, że pewien dokument wyjaśnia anulowanie zamówienia. Wyszukiwarka zna jednak tylko słowo anulowanie, a dokument opisuje ten sam proces jako odstąpienie. Zbiór może zawierać właściwą odpowiedź i nadal być trudny w użyciu.
LightOn przedstawił SlideOn i mSlideOn 19 października 2026 r. jako dwa modele odnajdywania trafnych dokumentów. SlideOn skupia się na angielskim, a mSlideOn rozszerza podejście na tekst wielojęzyczny, długie dokumenty i kod. Wyróżniają je dwa regulowane budżety: liczba cech używanych przez zapytanie i liczba cech zachowywanych dla każdego dokumentu. Zapowiedź LightOn
Ten artykuł wyjaśnia zastosowania modeli, znaczenie tych ustawień i sposób przeprowadzenia niewielkiego porównania przed budową usługi wyszukiwania. Nie potrzebujesz nowej aplikacji czatu, żeby zrozumieć tę ideę. Zacznij od pytania, kilku dokumentów i definicji przydatnego wyniku.
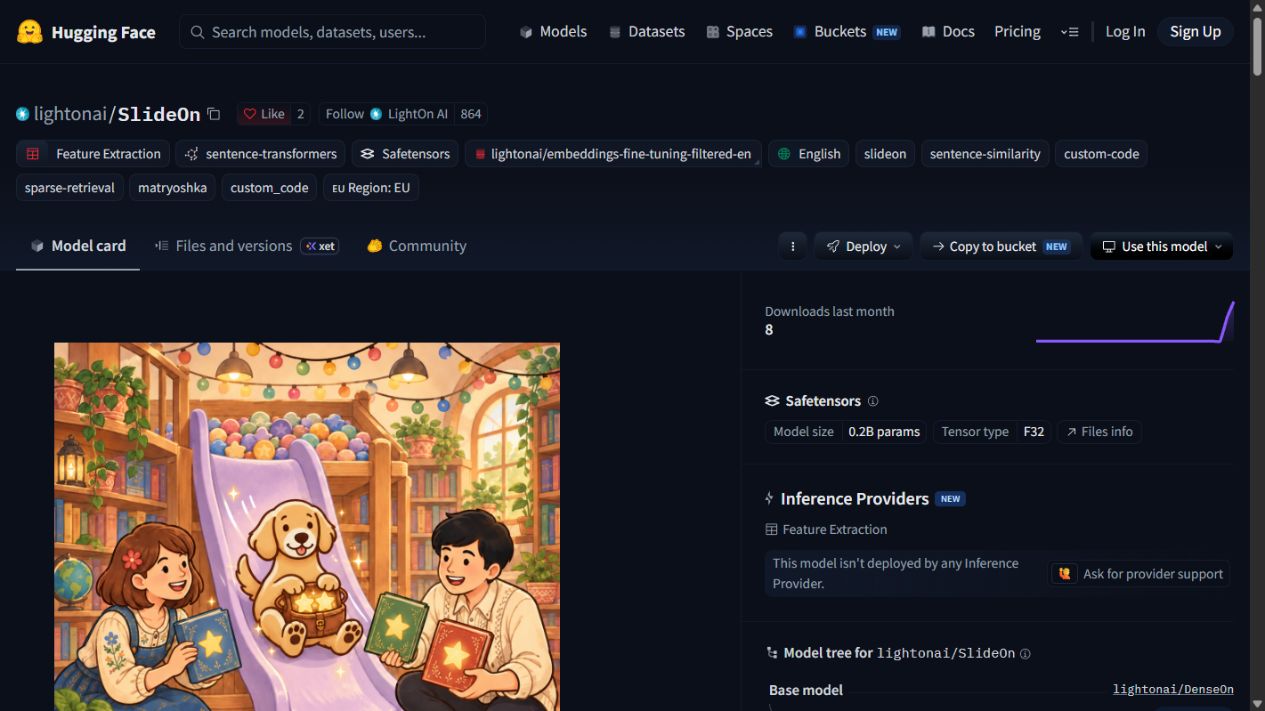 Zrzut publicznej karty modelu z 20 października 2026 r. Źródło: LightOn w Hugging Face. To opublikowana strona modelu, a nie wynik lokalnego wnioskowania. Interfejs pokazuje również, że model do pobrania nie musi mieć dostawcy hostowanego wnioskowania.
Wyszukiwanie potrzebuje dobrej listy źródeł, zanim powstanie odpowiedź
Model wyszukujący szereguje dokumenty względem zapytania. Nie musi pisać odpowiedzi, streszczać plików ani rozstrzygać, czy firma powinna zmienić zasady. Jego bezpośrednie zadanie jest węższe: umieścić najtrafniejsze materiały źródłowe wysoko na liście.
Wyobraź sobie wewnętrzny podręcznik z trzema stronami o zwrotach, wysyłce i urlopach. Pytanie o odesłanie uszkodzonego zamówienia powinno wskazać stronę o zwrotach. Jeżeli pierwszy wynik dotyczy kalendarza urlopowego, płynnie piszący generator odpowiedzi już zaczyna od niewłaściwych dowodów.
To rozróżnienie sprawia, że wyszukiwanie jest użyteczne także bez generatywnej AI. Specjalista wsparcia może bezpośrednio otworzyć wskazany dokument. Badacz zbierze fragmenty do porównania, a narzędzie programistyczne znajdzie prawdopodobną implementację przed jej oceną przez człowieka.
Pomaga również jasny podział odpowiedzialności. Wyszukiwanie lokalizuje dowody, lecz brzmienie zapisów, daty i wyjątki nadal sprawdzamy w oryginale. Dobry wynik ułatwia dotarcie do źródła, zamiast zastępować je wskaźnikiem pewności.
Wyszukiwanie rzadkie prowadzi selektywną książkę adresową
Pomyśl o indeksie jak o książce adresowej. Zwykły indeks słów kluczowych zapisuje, które dokumenty zawierają termin. Wyuczony model rzadki tworzy inny spis: przypisuje wagi stosunkowo niewielkiemu zestawowi wyuczonych cech, a wspólne aktywne cechy służą do oceniania dopasowania zapytań i dokumentów.
Słowo rzadki opisuje tę selektywność. Reprezentacja może mieć wiele możliwych pozycji, lecz dla danego tekstu wykorzystywać jedynie część z nich. Indeks odwrócony łączy każdą aktywną cechę z dokumentami, które jej używają, pomagając silnikowi przeszukiwać odpowiednie listy wystąpień.
Karta SlideOn podaje 32,768 możliwych wyuczonych cech oraz niezależne ustawienia przycinania zapytań i dokumentów. Pozycje te są wyuczonymi cechami ukrytymi, a nie przejrzystym słownikiem angielskich wyrazów. Cecha 100 nie jest gwarantowanym synonimem „zwrotów”. Karta modelu SlideOn
To ważne przy wyjaśnianiu wyników. Rzadkie reprezentacje mogą obniżać koszt wyszukiwania, nie czyniąc każdej wewnętrznej decyzji zrozumiałą dla człowieka. Praktycznym wyjaśnieniem nadal powinien być trafny fragment oryginału wraz z kontekstem pozwalającym sprawdzić dopasowanie.
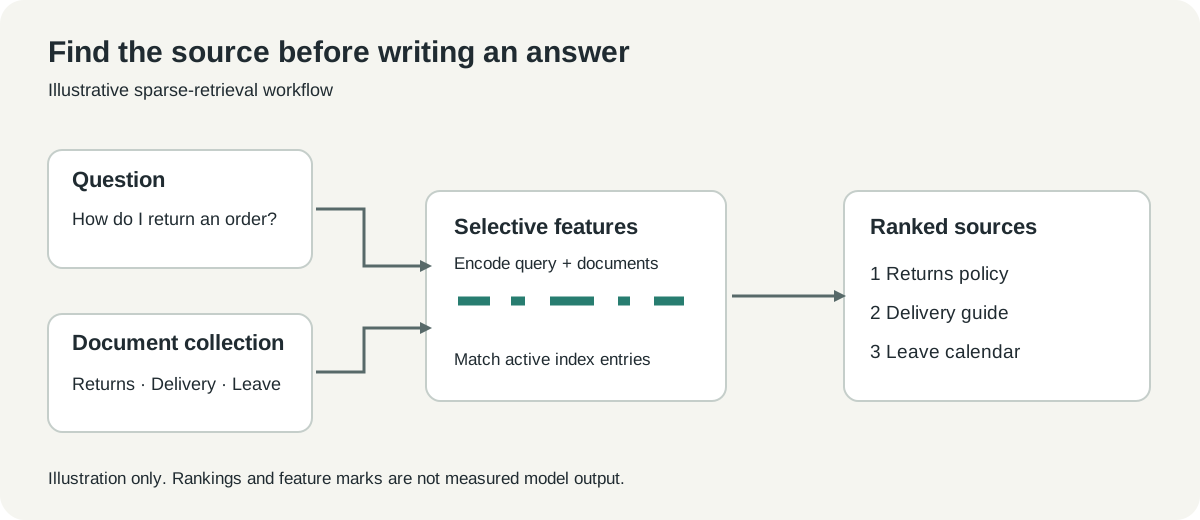 Autorski schemat objaśniający. Przykładowe znaczniki cech ilustrują proces; nie są aktywacjami zmierzonymi w SlideOn.
Dobierz model do rzeczywistego zbioru
Obie nazwy oznaczają powiązane punkty startowe, a nie wymienne ustawienia języka. W publikacji LightOn podaje 174 miliony parametrów dla SlideOn i 339 milionów dla mSlideOn. Sama większa liczba nie przesądza, który model lepiej obsłuży twój zbiór. Publikacja z 19 października
| Twój zbiór | Rozsądny pierwszy kandydat | Pytanie do rozstrzygnięcia w próbie |
|---|---|---|
| Angielskie artykuły pomocy | SlideOn | Czy odnajduje właściwy artykuł, gdy zapytanie używa innych słów? |
| Dokumenty w kilku językach | mSlideOn | Czy działa każdy ważny język osobno i czy zapytania międzyjęzykowe zachowują się zgodnie z potrzebami? |
| Długie dokumenty techniczne | mSlideOn z przemyślanym podziałem na fragmenty | Czy odpowiednia sekcja przetrwa przygotowanie danych i ranking? |
| Kod źródłowy połączony z prozą | mSlideOn jako kandydat | Czy zwracane pliki są przydatne osobie znającej repozytorium? |
Etykieta wielojęzyczności jest powodem do sprawdzenia modelu, nie skrótem omijającym ocenę. Dwujęzyczny katalog może zawierać tłumaczenia, odmienne zasady regionalne i terminologię bez jednego dosłownego odpowiednika. To różne problemy wyszukiwania, nawet jeśli dokumenty mają ten sam znacznik języka.
Przykładowo wyszukanie francuskich zasad zwrotów angielskim pytaniem jest zadaniem międzyjęzykowym. Francuskie zapytanie do francuskiego dokumentu to zadanie jednojęzykowe. Zapisuj je osobno: wynik zbiorczy może ukryć słabe doświadczenie jednej grupy czytelników.
Ta sama zasada dotyczy kodu. Znalezienie pliku o „odzyskiwaniu sesji” różni się od dopasowania dokładnej nazwy funkcji. W porównaniu uwzględnij zarówno konkretne identyfikatory, jak i pytania opisowe, ponieważ użyteczna wyszukiwarka zwykle potrzebuje obu.
Pierwszy eksperyment zmieści się w notatniku
Zacznij od tekstu publicznego lub syntetycznego i czystego środowiska Python. Opublikowany przykład używa SparseEncoder z Sentence Transformers: to interfejs ładowania modelu, a nie kompletny serwer wyszukiwania. Poniższy kod adaptuje oficjalny przepis, sprawdzony 20 października 2026 r. Udokumentowane użycie
- Otwórz kartę modelu i przejrzyj własny kod wnioskowania repozytorium oraz zależności. Loader używa
trust_remote_code=True, co pozwala uruchomić implementację Python z repozytorium. Do powtarzalnego eksperymentu wybierz przejrzaną rewizję. - Utwórz odizolowane środowisko i zainstaluj udokumentowany zakres wersji bibliotek.
- Zakoduj jedno zapytanie i kilka krótkich dokumentów. Korzystaj z metod modelu dla zapytań i dokumentów, zamiast ręcznie dodawać prefiksy.
- Obejrzyj wyniki punktowe obok treści dokumentów. Pierwszy test dotyczy kolejności, nie uniwersalnego progu punktowego.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
Dokumenty powyżej są wymyślonymi przykładami dydaktycznymi. Kodowi nie przypisujemy konkretnego wyniku ani zmierzonej trafności. Sprawdź, czy dokument o zwrotach zajmuje pierwsze miejsce, a następnie wypróbuj parafrazy i celowo trudne alternatywy.
Nie kończ, gdy działa najłatwiejsze pytanie. Zapytaj o anulowanie zamówienia przed wysyłką, uszkodzoną paczkę po dostawie i zwrot pieniędzy po terminie. Jeśli zbiór nie odpowiada na pytanie, test powinien ujawnić ten brak zamiast nagradzać atrakcyjny, lecz nietrafny wynik.
Dwa budżety odpowiadają na dwa różne pytania o koszt
Przycinanie zapytań ogranicza liczbę cech używanych przy zadawaniu pytania. Przycinanie dokumentów ogranicza cechy przechowywane dla każdego elementu indeksu. W dużej usłudze pierwszy budżet dotyczy pracy powtarzanej przy każdym wyszukiwaniu, drugi wpływa także na indeks pozostający między wyszukiwaniami.
Użyteczna próba zmienia jeden budżet naraz. Zachowaj reprezentacje dokumentów i zmieniaj przycinanie zapytań, a potem powtórz test dla innych budżetów dokumentów. Zmiana obu jednocześnie utrudnia ustalenie przyczyny różnicy w wynikach.
Nie ma uniwersalnego ustawienia „wystarczająco małego”. Krótkie FAQ, wielojęzyczne archiwum i repozytorium różnią się językiem, długością i powtórzeniami. Konfiguracja dobra dla ogólnych pytań może zgubić rzadki szczegół rozróżniający dwie niemal identyczne procedury.
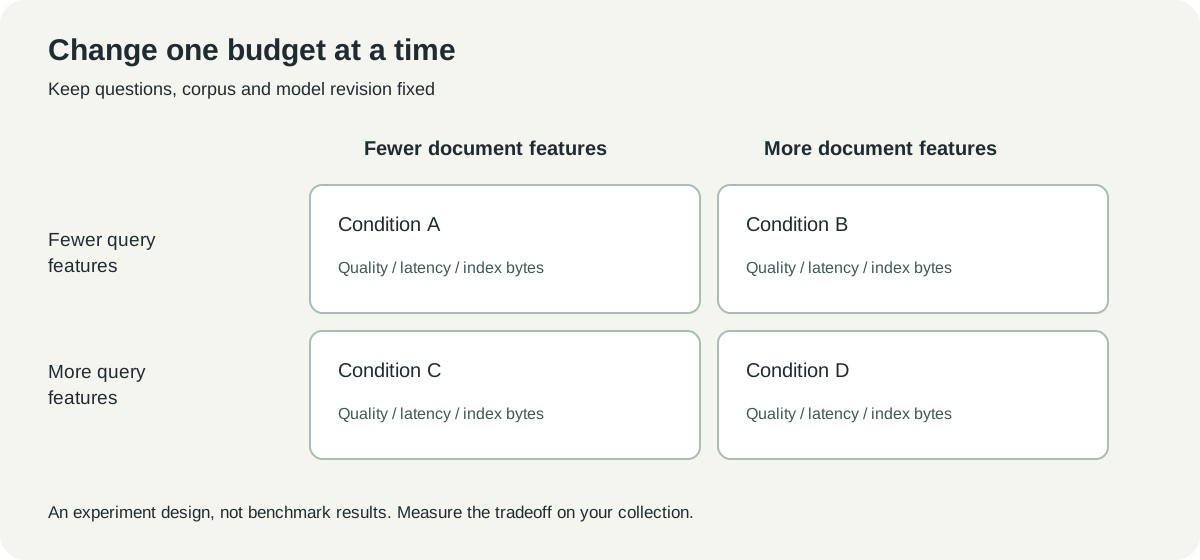 Autorski plan eksperymentu. To warunki porównania, a nie wyniki benchmarku ani zalecane ustawienia produkcyjne.
Trzymaj jakość, czas i przestrzeń dyskową w osobnych kolumnach. Gdy wyszukiwanie przyspiesza, lecz właściwy artykuł wypada z pierwszej strony, poprawa czasu ma cenę. Gdy większy indeks nie daje znaczącej korzyści dla rzeczywistych pytań, dodatkowe miejsce może się nie opłacać.
Wynik benchmarku nie jest pomiarem czasu odpowiedzi
Karta modelu podaje 56.68 nDCG@10 na BEIR-15 dla SlideOn bez przycinania. To przypisany autorom wynik jakości rankingu na zbiorach benchmarku, nie prawdopodobieństwo poprawności konkretnej odpowiedzi. Nie jest też liczbą milisekund. Opublikowana ocena
LightOn rozróżnia wskaźnik FLOPS wyszukiwania i zmierzone opóźnienie, a także liczbę niezerowych cech dokumentu i rozmiar indeksu w bajtach. Zachowaj ten podział w tabeli porównawczej. Przybliżenie matematyczne objaśnia mechanizm, a pomiar operacyjny pokazuje działanie twojego systemu.
Przy małej ocenie sam stoper również nie wystarczy. Pierwsze ładowanie modelu, kodowanie dokumentów, budowanie indeksu i kolejne zapytania to odrębne etapy. Podaj zimny start oddzielnie od wyszukiwania po rozgrzaniu i zaznacz, czy pomiar obejmuje kodowanie zapytania.
Podobnej staranności wymagają miary jakości. Model może znaleźć właściwy dokument, ale umieścić niewłaściwy fragment długiego pliku wysoko na liście. Zapisz, czy oceniasz plik, sekcję czy fragment, i stosuj tę samą jednostkę dla każdego kandydata.
Trzy praktyczne zbiory pokazują kompromisy
Podręcznik operacyjny jest dobrym początkiem, bo oczekiwany wynik bywa jasny. Napisz pytania o zwroty, opóźnienia wysyłki i dostęp do konta, a następnie wskaż autorytatywną stronę dla każdego. Uwzględnij sformułowania odmienne od tytułów, żeby nie testować wyłącznie dopasowania nagłówków.
Wielojęzyczne archiwum projektu dodaje problem: ten sam temat występuje w notatkach ze spotkań, tłumaczonym ogłoszeniu i starym planie. Metadane powinny rozróżniać aktualne zasady i historyczne dyskusje. Podobieństwo semantyczne nie rozstrzyga, którą wersją organizacja ma się kierować.
Dokumentacja programistyczna dodaje dokładne ciągi i niemal duplikaty. Pytanie o limit czasu może wymagać zarówno przewodnika po koncepcji, jak i klucza konfiguracji. Zachowaj wyszukiwanie leksykalne jako punkt odniesienia i sprawdź, czy hybrydowe podejście uzasadnia złożoność na twoich pytaniach.
To proponowane scenariusze oceny, nie opisy wdrożeń. Mają skonkretyzować kryteria akceptacji. W każdym najważniejszym artefaktem jest lista pytań, zaakceptowanych źródeł i zaobserwowanych rankingów, którą inna osoba może przejrzeć.
Ogranicz pierwsze porównanie tak, by je ukończyć
Wybierz na przykład 30 reprezentatywnych pytań zamiast nieograniczonego stosu zapytań. Podziel je na zwykłe wyszukiwania, parafrazy, przypadki niejednoznaczne i pytania bez odpowiedzi w zbiorze. To propozycja startu, nie statystycznie reprezentatywny benchmark.
Niech ekspert dziedzinowy oceni oczekiwane wyniki przed strojeniem. Inaczej każdy zaskakujący ranking skłoni do nowego wyjaśnienia, co pytanie „naprawdę znaczyło”. Zachowaj osobny, nietknięty zestaw do końcowego sprawdzenia, aby ustawienia nie zapamiętywały przykładów rozwojowych.
Zapisz rewizję modelu, reguły przygotowania danych, wielkość fragmentów, ustawienia przycinania i specyfikację komputera. Zmiana dowolnego elementu może zmienić porównanie. Krótki test możliwy do powtórzenia jest cenniejszy niż wysoki wynik z utraconymi danymi wejściowymi.
Na koniec obejrzyj ekran wyników w rozmiarze używanym przez odbiorców. Poprawny pierwszy wynik nadal zawodzi, jeśli ucięty tytuł jest nierozpoznawalny albo wycinek ukrywa decydujące zdanie. Jakość wyszukiwania spotyka jakość interfejsu, gdy człowiek wybiera, co otworzyć.
Lepsze wyszukiwanie skraca drogę do źródła
Naszym zdaniem użyteczną ideą SlideOn jest oddanie jakości i budżetów zasobów w postaci ustawień, które można przetestować. To praktyczniejszy początek niż założenie, że każde wyszukiwanie potrzebuje większego modelu odpowiedzi. Zachęca do skromnego eksperymentu: zachowaj pytania, zmień reprezentację i zobacz, co ludzie rzeczywiście znajdują.
Zacznij od dokumentu, którego zespół regularnie nie może odnaleźć. Jeśli nowy model konsekwentnie wskazuje go przy różnych sformułowaniach, masz konkretną podstawę dalszej pracy. Celem pozostaje czytelne źródło; model ma skrócić drogę.
Źródła i materiały graficzne
Sprawdzono 20 października 2026 r. Przykład konfiguracji adaptuje publiczną kartę modelu; nie deklarujemy instalacji, lokalnego wnioskowania ani niezależnego benchmarku. Zrzut: publiczna strona modelu LightOn w Hugging Face, wykonany przez autora. Oba schematy są autorskie. Źródła zasobów i informacje licencyjne towarzyszą rejestrowi materiałów.
- Publikacja LightOn z 19 października 2026 r.
- Karta SlideOn i instrukcja użycia
- Karta mSlideOn i informacje o językach
- Repozytorium treningu i oceny
Przechowuj pytania obok dowodów
Zapisz razem zestaw zapytań, linki do źródeł i notatki z oceny, aby późniejsze porównanie odpowiadało na te same pytania. Telli.sh pomaga porządkować taki zapis badań. Utwórz konto Telli.sh