[AI 아이디어 노트 01] SlideOn: 작은 검색 모델에 담긴 두 가지 비용 조절 장치
LightOn의 SlideOn과 mSlideOn을 소개합니다. 영어·다국어 문서를 찾는 희소 검색의 원리부터 첫 실험, 검색 품질·속도·저장 공간을 비교하는 방법까지 살펴봅니다.
AI 아이디어 노트는 이제 막 등장한 AI 모델·도구의 발상과 활용 가능성을 살펴보는 연재입니다.
주문을 취소하는 방법이 적힌 문서를 본 기억이 있습니다. 검색창에 취소를 입력했는데, 정작 문서는 같은 절차를 철회라고 부릅니다. 답이 들어 있는 자료를 갖고도 원하는 내용을 찾기 어려운 이유죠.
LightOn은 2026년 10월 19일, 관련 문서를 찾아주는 두 모델 SlideOn과 mSlideOn을 공개했습니다. SlideOn은 영어에 초점을 맞추고, mSlideOn은 다국어 텍스트와 긴 문서, 코드로 접근 범위를 넓힙니다. 눈여겨볼 부분은 두 가지 조절 장치입니다. 검색 질문에 사용할 특징의 수와, 저장할 문서마다 남겨둘 특징의 수를 따로 정할 수 있습니다. LightOn 발표
이 글에서는 두 모델이 어떤 역할을 하는지, 이 조절 장치가 무엇을 바꾸는지, 검색 서비스를 만들기 전에 어떻게 작은 비교 실험을 해볼 수 있는지 살펴봅니다. 새로운 채팅 앱부터 만들 필요는 없습니다. 질문 하나와 문서 몇 개를 준비하고, 어떤 결과를 유용하다고 볼지 정하는 데서 시작하면 됩니다.
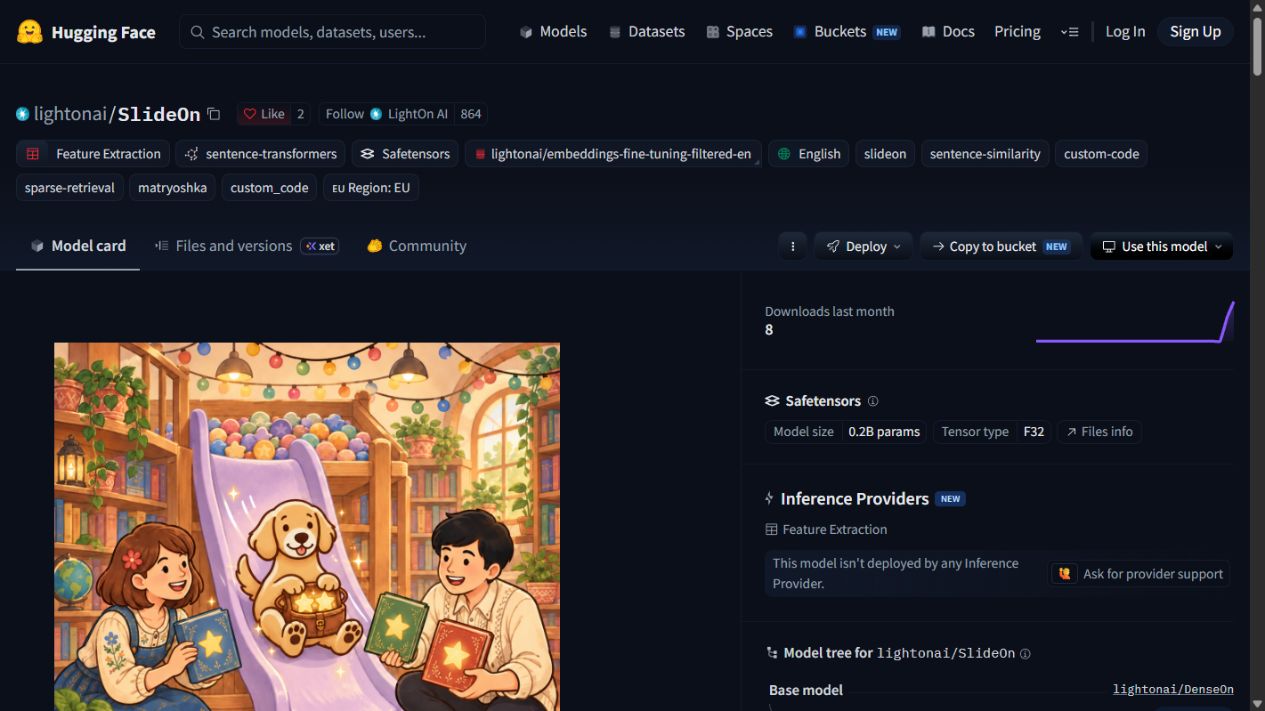 2026년 10월 20일 촬영한 공개 모델 카드 화면입니다. 출처: Hugging Face의 LightOn 페이지. 로컬 추론 결과가 아니라 공개된 모델 페이지입니다. 다운로드할 수 있는 모델이라고 해서 호스팅 추론 서비스까지 제공되는 것은 아니라는 점도 화면에서 확인할 수 있습니다.
좋은 답변보다 먼저 필요한 것은 좋은 후보 목록이다
검색 모델은 질문과 관련된 순서대로 문서를 정렬합니다. 답변을 작성하거나 파일을 요약하고, 회사 정책을 바꿔야 할지 판단하는 일까지 맡을 필요는 없습니다. 당장의 역할은 더 분명합니다. 가장 관련 있는 원문을 위쪽에 올려놓는 것입니다.
반품, 배송, 직원 휴가에 관한 세 페이지가 있는 사내 안내서를 떠올려보세요. 파손된 주문을 돌려보내는 방법을 물었다면 반품 페이지가 먼저 나와야 합니다. 첫 결과로 휴가 일정이 나온다면, 뒤에서 아무리 유창하게 답변을 만드는 모델이 있어도 출발점부터 근거가 잘못된 셈입니다.
이 구분 덕분에 생성형 AI가 없어도 검색은 쓸모가 있습니다. 고객지원 담당자는 정렬된 문서를 직접 열면 됩니다. 연구자는 비교할 구절을 모을 수 있고, 개발 도구는 사람이 코드를 검토하기 전에 구현이 있을 법한 위치를 찾을 수 있습니다.
역할을 나누는 데도 도움이 됩니다. 검색은 근거의 위치를 찾고, 정확한 문구와 날짜, 예외 조건은 원문에서 확인합니다. 좋은 검색 결과는 원문을 점수 하나로 대체하기보다 원문에 도달하기 쉽게 만들어야 합니다.
희소 검색은 필요한 주소만 남기는 주소록이다
검색 인덱스를 주소록이라고 생각해보면 쉽습니다. 일반적인 키워드 인덱스는 어떤 단어가 어느 문서에 들어 있는지 기록합니다. 학습된 희소 모델은 다른 방식의 주소록을 만듭니다. 비교적 적은 수의 학습된 특징에 가중치를 부여하고, 질문과 문서에서 함께 활성화된 특징을 이용해 관련도를 계산합니다.
희소하다는 말은 이렇게 일부만 골라 쓴다는 뜻입니다. 표현 가능한 위치가 많더라도 특정 텍스트는 그중 일부만 사용합니다. 역색인은 활성화된 각 특징과 그 특징을 쓰는 문서들을 연결하므로, 검색 엔진은 관련 있는 문서 목록에 집중할 수 있습니다.
SlideOn 모델 카드에는 32,768개의 학습된 특징 공간과 질문·문서별 독립적인 가지치기 조절 기능이 명시되어 있습니다. 이 위치들은 학습된 잠재 특징이지, 뜻을 곧바로 읽을 수 있는 영어 단어 사전은 아닙니다. 따라서 100번 특징이 반드시 ‘반품’의 동의어라고 해석해서는 안 됩니다. SlideOn 모델 카드
결과를 설명할 때도 이 차이가 중요합니다. 희소 표현이 검색 비용을 줄일 수 있다고 해서 모든 내부 판단이 사람에게 투명해지는 것은 아닙니다. 사용자에게는 여전히 원문의 관련 구절과, 왜 일치하는지 확인할 수 있는 충분한 맥락을 보여주는 편이 좋습니다.
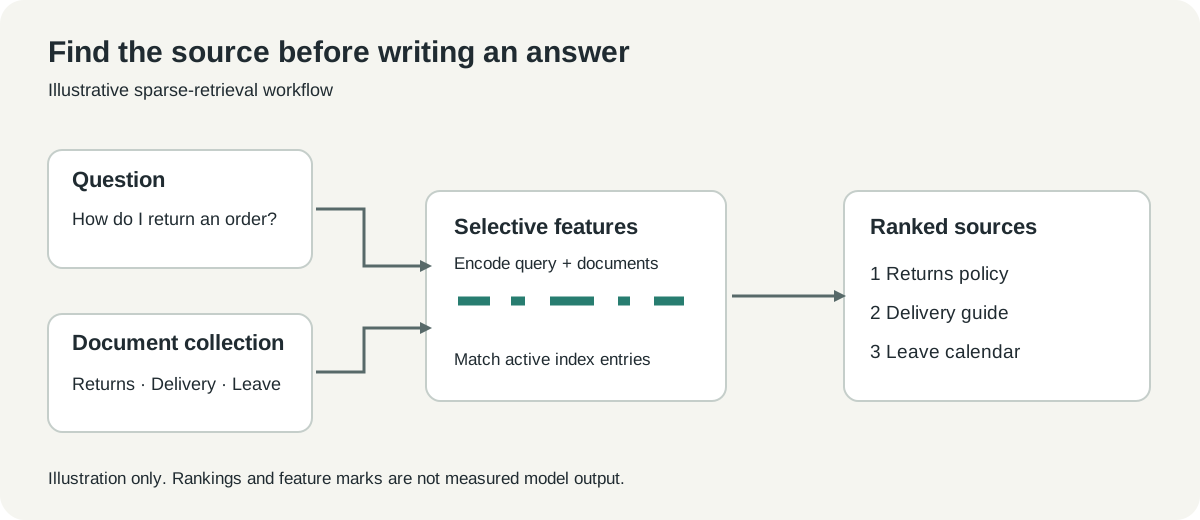 직접 제작한 설명용 인포그래픽입니다. 특징 표시는 과정을 설명하기 위한 예시이며, SlideOn에서 실제 측정한 활성값이 아닙니다.
보유한 자료에 맞춰 모델을 고른다
두 이름은 서로 관련된 출발점을 뜻합니다. 언어 설정만 바꿔 끼우는 관계로 볼 수는 없습니다. LightOn은 발표에서 SlideOn의 파라미터를 1억 7,400만 개, mSlideOn은 3억 3,900만 개라고 소개했습니다. 숫자가 더 크다는 이유만으로 어떤 모델이 내 자료에 더 적합한지 결정되지는 않습니다. 10월 19일 발표
| 보유한 자료 | 먼저 검토할 후보 | 실험에서 확인할 질문 |
|---|---|---|
| 영어 도움말 문서 | SlideOn | 질문의 표현이 달라도 올바른 문서를 찾는가? |
| 여러 언어로 된 문서 | mSlideOn | 중요한 각 언어의 검색과 필요한 언어 간 검색이 제대로 되는가? |
| 긴 기술 문서 | 문서 분할 방식을 정한 뒤 mSlideOn 검토 | 관련 구간이 전처리와 정렬을 거쳐도 결과에 남는가? |
| 설명문과 소스 코드가 섞인 자료 | mSlideOn을 후보로 검토 | 저장소를 아는 사람이 보기에도 반환된 파일이 유용한가? |
‘다국어’라는 표시는 검토할 이유이지 평가를 생략할 이유는 아닙니다. 두 언어로 된 자료실에는 번역본, 지역마다 다른 정책, 직역할 수 없는 용어가 함께 들어갈 수 있습니다. 같은 언어 태그를 공유해도 각각 다른 검색 문제입니다.
예를 들어 프랑스어 환불 정책을 영어 질문으로 찾는다면 언어 간 검색입니다. 프랑스어 문서를 프랑스어 질문으로 찾는 것은 같은 언어 안에서의 검색이죠. 둘을 나눠 기록하세요. 전체 평균 점수만 보면 특정 독자 집단의 불편이 가려질 수 있습니다.
코드도 마찬가지입니다. ‘세션 복구’에 관한 파일을 찾는 일은 정확한 함수 이름을 대조하는 것과 다릅니다. 설명형 질문뿐 아니라 식별자가 정확히 들어간 질문도 비교에 포함하세요. 실용적인 검색 시스템에는 둘 다 필요한 경우가 많습니다.
첫 실험은 노트북 하나로 시작할 수 있다
공개 자료나 합성 텍스트, 독립된 Python 환경부터 준비합니다. 공개 예제는 Sentence Transformers의 SparseEncoder를 사용합니다. 이는 모델을 불러오는 인터페이스이며, 완성된 검색 서버는 아닙니다. 아래 코드는 2026년 10월 20일 확인한 공식 사용법을 바탕으로 구성했습니다. 공식 사용법
- 모델 카드를 열고 저장소의 사용자 정의 추론 코드와 의존성을 검토합니다. 아래의
trust_remote_code=True는 해당 저장소의 Python 구현 실행을 허용합니다. 재현 가능한 실험에는 검토한 리비전을 지정하세요. - 격리된 환경을 만들고 문서에 제시된 라이브러리 버전 범위를 설치합니다.
- 질문 하나와 짧은 문서 몇 개를 인코딩합니다. 접두사를 직접 붙이기보다 모델의 질문용·문서용 메서드를 사용합니다.
- 실제 문서 텍스트와 점수를 나란히 확인합니다. 첫 점검의 목적은 순위를 보는 것이지, 어디서나 통하는 점수 임계값을 정하는 것이 아닙니다.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
위 문서는 학습을 위해 만든 가상 예시입니다. 코드에 특정 출력이나 측정된 정확도를 제시하지 않았습니다. 반품 문서가 첫 번째로 나오는지 확인하고, 같은 뜻을 다른 말로 질문하거나 일부러 구분하기 어려운 선택지를 추가해보세요.
가장 쉬운 질문이 맞았다고 실험을 끝내지는 마세요. 발송 전 주문 취소, 배송 후 파손, 정해진 기한을 넘긴 환불을 각각 물어볼 수 있습니다. 자료에 답이 없는 질문은 그 부재가 드러나야 합니다. 그럴듯하지만 관련 없는 문서에 높은 점수를 주는 실험이 되어서는 안 됩니다.
두 가지 예산은 서로 다른 비용을 조절한다
질문 가지치기는 검색할 때 사용하는 특징의 수를 제한합니다. 문서 가지치기는 인덱스에 넣는 각 항목이 보관할 특징의 수를 제한합니다. 큰 서비스에서 첫 번째 예산은 검색할 때마다 반복되는 작업에 영향을 주고, 두 번째는 검색 사이에도 계속 보관하는 인덱스에 영향을 줍니다.
유용한 실험은 한 번에 하나의 예산만 바꿉니다. 문서 표현을 고정한 채 질문 가지치기를 조절하고, 그다음 다른 문서 예산으로 반복하세요. 둘을 동시에 바꾸면 결과가 달라져도 무엇이 원인이었는지 알기 어렵습니다.
어디서나 통하는 ‘충분히 작은’ 설정은 없습니다. 짧은 FAQ, 다국어 기록 보관소, 소프트웨어 저장소는 언어와 길이, 반복 양상이 다릅니다. 넓은 범위의 질문에 잘 맞는 설정이 거의 같은 두 절차를 구분하는 드문 세부 사항은 놓칠 수 있습니다.
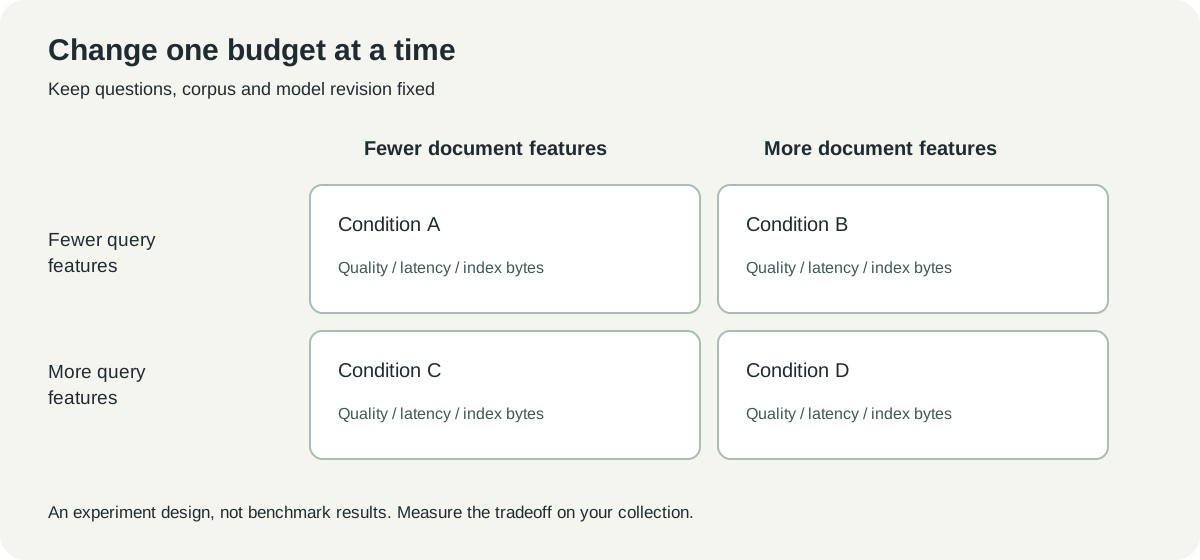 직접 제작한 실험 설계 인포그래픽입니다. 비교할 조건을 나타내며, 벤치마크 결과나 운영 환경의 권장 설정을 뜻하지 않습니다.
품질, 시간, 저장 공간은 서로 다른 열에 기록하세요. 검색이 빨라져도 관련 문서가 첫 페이지에서 사라진다면 공짜로 얻은 속도 향상이 아닙니다. 반대로 더 큰 인덱스가 실제 질문에서 의미 있는 이점을 주지 못한다면 추가 저장 공간의 가치도 따져봐야 합니다.
벤치마크 점수는 응답 시간 측정값이 아니다
모델 카드는 가지치기를 하지 않은 SlideOn 설정에서 BEIR-15의 nDCG@10이 56.68이라고 보고합니다. 이는 해당 벤치마크 데이터셋 전반의 순위 품질을 나타내는 발표자의 평가 결과입니다. 특정 답변이 정답일 확률도 아니고, 밀리초 단위의 속도도 아닙니다. 공개 평가
LightOn은 효율성을 설명하면서 검색 FLOPS 대리 지표와 실제 지연 시간을 구분하고, 문서의 0이 아닌 특징 개수와 바이트 단위 인덱스 크기도 구분합니다. 비교표에서도 이 차이를 유지하는 편이 좋습니다. 수학적 대리 지표는 원리를 설명하고, 운영 환경의 측정값은 실제 시스템의 동작을 보여줍니다.
작은 평가에서도 초시계 하나만으로는 충분하지 않습니다. 초기 모델 로딩, 문서 인코딩, 인덱스 생성, 반복 질의는 서로 다른 단계입니다. 처음 시작하는 시간과 준비가 끝난 뒤의 검색 시간을 따로 기록하고, 질문 인코딩 시간이 측정에 포함되는지도 명확히 적으세요.
품질 점수도 같은 주의가 필요합니다. 올바른 문서를 찾았지만 긴 파일의 엉뚱한 구절을 위쪽에 올릴 수 있습니다. 판단 단위가 파일인지, 절인지, 짧은 구절인지 정하고 모든 후보에 같은 단위를 적용하세요.
세 가지 자료로 장단점을 구체화한다
운영 안내서는 원하는 결과가 분명한 경우가 많아 첫 대상으로 좋습니다. 반품, 발송 지연, 계정 접근에 관한 질문을 쓰고 각각의 공식 안내 페이지를 지정하세요. 제목과 다른 표현으로 된 질문도 넣어야 제목 일치 이상의 능력을 볼 수 있습니다.
다국어 프로젝트 기록에는 또 다른 문제가 있습니다. 같은 주제가 회의록, 번역 공지, 이전 계획에 각각 등장할 수 있습니다. 메타데이터로 현재 정책과 과거 논의를 구분하세요. 의미가 비슷하다는 사실만으로 조직이 어느 버전을 따라야 하는지 결정되지는 않습니다.
개발자 문서에는 정확한 문자열과 거의 같은 내용의 문서가 함께 등장합니다. 시간 초과에 관한 질문에는 개념 설명과 설정 키가 모두 필요할 수 있습니다. 키워드 검색을 기준선으로 남겨두고, 혼합 방식의 추가 복잡성이 실제 질문에서 그만한 가치를 주는지 확인하세요.
이들은 제안하는 평가 시나리오이며 실제 도입 사례가 아닙니다. 목적은 합격 기준을 구체적으로 만드는 데 있습니다. 어느 경우든 중요한 산출물은 다른 사람이 검토할 수 있는 질문 목록, 인정할 근거 문서, 관찰된 검색 순위입니다.
끝낼 수 있는 크기로 첫 비교를 설계한다
끝없이 질문을 모으기보다 대표 질문 30개 정도로 시작해볼 수 있습니다. 일반 조회, 바꿔 말한 질문, 모호한 질문, 자료에 답이 없는 질문으로 나눠보세요. 이는 시작을 위한 설계 제안이지 통계적 대표성을 갖춘 벤치마크는 아닙니다.
설정을 조절하기 전에 해당 분야를 아는 사람이 기대 결과를 판단하게 하세요. 그렇지 않으면 예상 밖의 순위가 나올 때마다 질문의 ‘진짜 의도’를 새로 해석하기 쉽습니다. 마지막 확인용 질문은 따로 남겨 설정이 개발 예시만 외우지 않도록 합니다.
모델 리비전, 전처리 규칙, 문서 분할 크기, 가지치기 설정, 장비 정보를 기록하세요. 하나만 달라져도 비교 결과가 바뀔 수 있습니다. 입력이 사라진 큰 점수보다 다른 사람이 반복할 수 있는 짧은 실험이 더 유용합니다.
마지막으로 실제 사용자가 볼 크기로 결과 화면을 확인하세요. 정답 문서가 첫 번째여도 제목이 잘려 알아볼 수 없거나, 미리보기에서 결정적인 문장이 빠지면 사용자는 여전히 실패합니다. 검색 품질과 인터페이스 품질은 사람이 열어볼 문서를 고르는 순간 만납니다.
좋은 검색은 원문까지 가는 길을 줄인다
우리가 주목하는 SlideOn의 아이디어는 품질과 자원 예산을 실험 가능한 조절 장치로 나눴다는 점입니다. 모든 검색 문제에 더 큰 답변 모델이 필요하다고 가정하기보다 실용적인 출발점이 됩니다. 질문은 유지하고, 표현 방식을 바꾸고, 실제로 무엇을 찾게 되는지 살펴보는 작은 실험을 할 수 있습니다.
팀에서 반복해서 찾지 못하는 문서 하나로 시작하세요. 표현을 달리해도 새 검색기가 그 문서를 안정적으로 찾아준다면 개선의 근거가 생깁니다. 목적지는 여전히 읽고 확인할 수 있는 원문입니다. 모델의 역할은 거기까지의 길을 줄이는 것입니다.
출처와 이미지
2026년 10월 20일 확인했습니다. 설치 예시는 공개 모델 카드를 바탕으로 구성했으며, 직접 설치·로컬 추론·독립 벤치마크를 수행한 결과가 아닙니다. 화면은 작성자가 촬영한 Hugging Face의 LightOn 공개 모델 페이지입니다. 인포그래픽 두 개는 직접 제작했습니다. 자료 출처와 라이선스 고지는 이미지 기록에 있습니다.
질문과 근거를 함께 보관한다
나중에도 같은 기준으로 비교할 수 있도록 질문 목록, 원문 링크, 검토 메모를 함께 남겨두세요. Telli.sh는 이런 조사 기록을 정리하는 데 도움을 줄 수 있습니다. Telli.sh 계정 만들기