[Taccuino di idee sull'IA 01] SlideOn: un modello di ricerca più piccolo con due utili controlli sui costi
Scopri SlideOn e mSlideOn di LightOn: modelli di recupero sparso per trovare documenti in inglese e in più lingue, con un primo esperimento pratico e un metodo chiaro per confrontare qualità, velocità e spazio occupato.
Taccuino di idee sull'IA esplora le idee e le possibilità pratiche dei nuovi modelli e strumenti di IA.
Ricordi che un documento spiega come annullare un ordine. La casella di ricerca ricorda soltanto la parola annullamento. Purtroppo il documento chiama la stessa procedura recesso. Una raccolta può contenere la risposta giusta e restare comunque difficile da usare.
LightOn ha presentato SlideOn e mSlideOn il 19 ottobre 2026, due modelli per recuperare documenti pertinenti. SlideOn si concentra sull'inglese; mSlideOn estende l'approccio al testo multilingue, ai documenti lunghi e al codice. Il loro interesse particolare sta in due budget regolabili: quante caratteristiche utilizza una query e quante ne conserva ogni documento archiviato. Annuncio di LightOn
Questa introduzione spiega dove si collocano i modelli, cosa cambiano quei controlli e come provare un piccolo confronto prima di costruire un servizio di ricerca. Non serve una nuova applicazione di chat per capire l'idea. Parti da una domanda, da alcuni documenti e da una definizione di risultato utile.
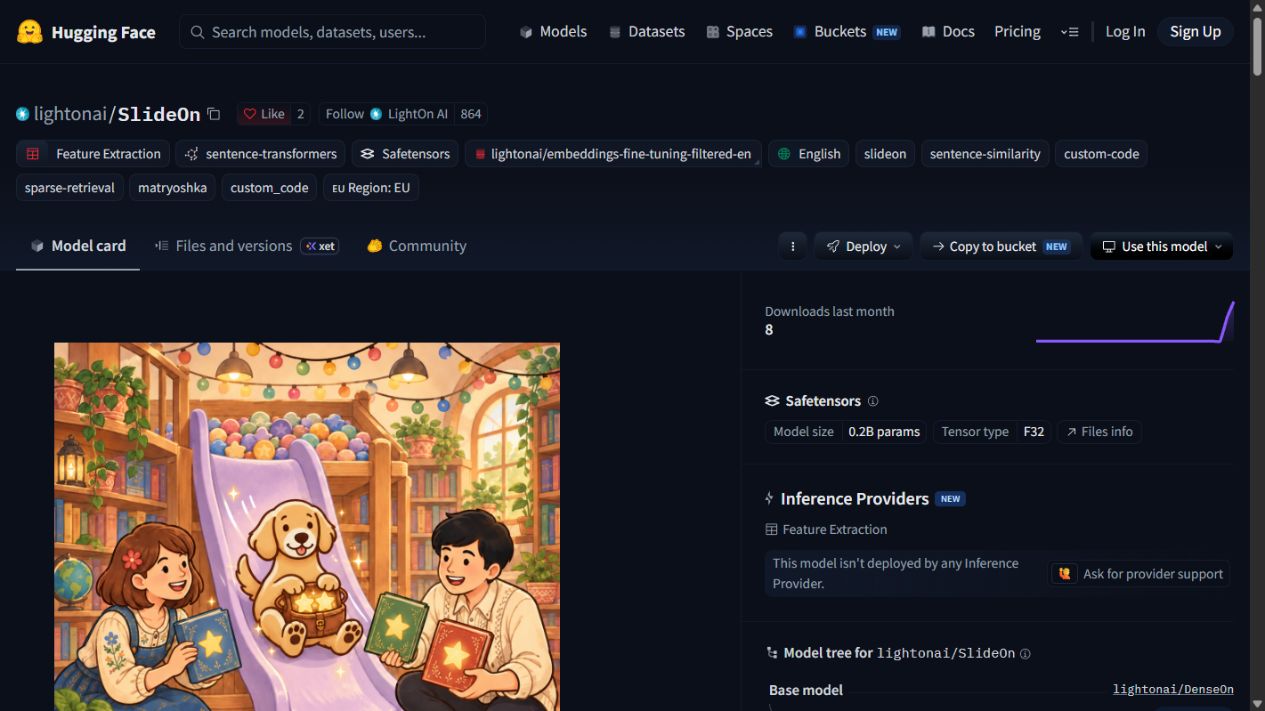 Schermata della scheda pubblica del modello acquisita il 20 ottobre 2026. Fonte: LightOn su Hugging Face. È la pagina pubblicata del modello, non un risultato di inferenza locale; l'interfaccia mostra anche che un modello scaricabile può non avere un fornitore di inferenza ospitata.
La ricerca richiede una buona selezione prima di una risposta
Un sistema di recupero ordina i documenti rispetto a una query. Non deve necessariamente scrivere una risposta, riassumere i file o decidere se un'azienda debba cambiare politica. Il suo compito immediato è più circoscritto: portare il materiale di riferimento più pertinente verso l'inizio dei risultati.
Considera un manuale interno con tre pagine dedicate a resi, spedizioni e ferie del personale. Una domanda su come restituire un ordine danneggiato dovrebbe mettere in evidenza la pagina dei resi. Se il primo risultato riguarda invece il calendario delle ferie, un generatore di risposte a valle parte già dalle prove sbagliate, per quanto sappia scrivere bene.
Questa distinzione rende il recupero utile anche senza IA generativa. Un addetto all'assistenza può aprire direttamente il documento classificato. Un ricercatore può raccogliere passaggi da confrontare. Uno strumento di programmazione può trovare un'implementazione probabile prima che una persona la esamini.
Esiste anche una separazione utile delle responsabilità. Il recupero aiuta a localizzare le prove; il documento originale resta il luogo dove verificare formulazioni, date ed eccezioni. Un buon risultato dovrebbe rendere più facile raggiungere quella fonte, anziché sostituirla con un punteggio di confidenza.
La ricerca sparsa mantiene una rubrica selettiva
Pensa a un indice di ricerca come a una rubrica di indirizzi. Un indice tradizionale per parole chiave registra quali documenti contengono un termine. Un modello sparso appreso crea un altro tipo di rubrica: assegna pesi a un insieme relativamente piccolo di caratteristiche apprese, poi usa le caratteristiche attive condivise per assegnare punteggi alle coppie query-documento.
La parola sparso descrive questa selettività. Una rappresentazione può avere molte posizioni possibili, utilizzandone soltanto una parte per un determinato testo. Un indice invertito può associare ogni caratteristica attiva ai documenti che la usano, aiutando il motore di ricerca a concentrarsi sulle liste di occorrenze pertinenti.
La scheda di SlideOn specifica 32,768 possibili caratteristiche apprese e controlli indipendenti di potatura per query e documenti. Quelle posizioni sono variabili latenti apprese, non un dizionario trasparente di parole inglesi. Non bisogna interpretare la caratteristica 100 come un sinonimo garantito di «resi». Scheda del modello SlideOn
Quest'ultimo dettaglio conta quando si spiegano i risultati. Le rappresentazioni sparse possono rendere economica la ricerca senza rendere leggibile ogni decisione interna. Per l'utente, la spiegazione pratica dovrebbe restare un passaggio pertinente del documento originale, con un contesto sufficiente a verificare perché corrisponde alla domanda.
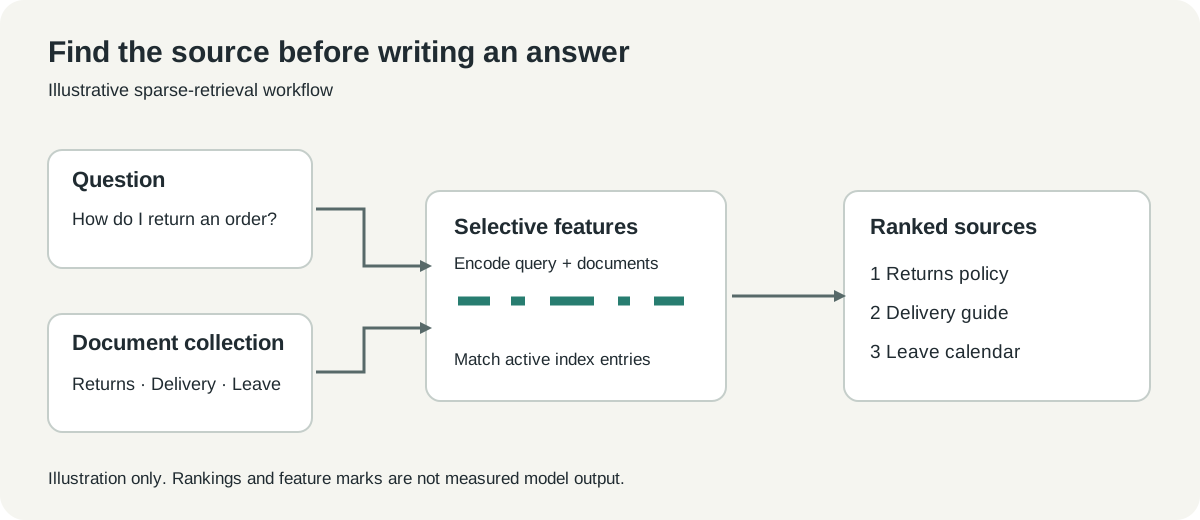 Diagramma esplicativo originale. I segni delle caratteristiche illustrano il processo; non sono attivazioni misurate di SlideOn.
Scegli il modello per la raccolta che possiedi davvero
I due nomi descrivono punti di partenza collegati, non impostazioni linguistiche intercambiabili. Nel rilascio LightOn indica 174 milioni di parametri per SlideOn e 339 milioni di parametri per mSlideOn. Il numero maggiore, da solo, non stabilisce quale servirà meglio la tua raccolta. Rilascio del 19 ottobre
| La tua raccolta | Primo candidato ragionevole | Domanda da risolvere nella prova |
|---|---|---|
| Articoli di assistenza in inglese | SlideOn | Recupera l'articolo giusto quando la query usa parole diverse? |
| Documenti in più lingue | mSlideOn | Ogni lingua importante funziona bene da sola e le query tra lingue diverse si comportano come serve? |
| Documenti tecnici lunghi | mSlideOn, con un piano deliberato di suddivisione | La sezione pertinente sopravvive al pretrattamento e all'ordinamento? |
| Codice sorgente mescolato a prosa | mSlideOn come candidato | I file restituiti sono utili a chi conosce il repository? |
L'etichetta multilingue è un motivo per approfondire, non una scorciatoia per saltare la valutazione. Un catalogo bilingue può contenere copie tradotte, politiche regionali differenti e termini privi di un unico equivalente letterale. Sono problemi di recupero diversi anche quando i documenti condividono un'etichetta linguistica.
Immagina, per esempio, di cercare una politica di rimborso francese con una domanda in inglese. È un'attività tra lingue diverse. Cercare un documento francese con una query in francese è un'attività nella stessa lingua. Registrale separatamente: un punteggio aggregato può nascondere un'esperienza debole per un gruppo di lettori.
Lo stesso principio vale per il codice. Trovare un file su «ripristino della sessione» richiede qualcosa di diverso dal trovare il nome esatto di una funzione. Mantieni nel confronto sia le query con identificatori esatti sia le domande descrittive, perché un sistema di ricerca utile ha spesso bisogno di entrambe.
Il primo esperimento può stare in un notebook
Parti da testo pubblico o sintetico e da un ambiente Python pulito. L'esempio pubblicato usa SparseEncoder di Sentence Transformers; è un'interfaccia per caricare modelli, non un server di ricerca completo. Quello che segue adatta la procedura ufficiale, consultata il 20 ottobre 2026. Uso documentato
- Apri la scheda del modello ed esamina il codice di inferenza personalizzato e le dipendenze del repository. Il caricatore seguente usa
trust_remote_code=True, che consente di eseguire l'implementazione Python del repository; usa una revisione esaminata per rendere ripetibile l'esperimento. - Crea un ambiente isolato e installa l'intervallo documentato di versioni delle librerie.
- Codifica una query e alcuni documenti brevi. Usa i metodi del modello dedicati a query e documenti, invece di aggiungere prefissi a mano.
- Esamina i punteggi accanto al testo effettivo dei documenti. Questa prima verifica riguarda l'ordinamento, non una soglia universale di punteggio.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
I documenti precedenti sono esempi didattici inventati. A questo codice non è associato alcun risultato dichiarato né un'accuratezza misurata. Il primo controllo è verificare se il documento sui resi si posiziona in testa, poi provare parafrasi e alternative volutamente difficili.
Non fermarti quando funziona la query più semplice. Chiedi come annullare un ordine prima della spedizione, cosa fare per un pacco danneggiato dopo la consegna e come ottenere un rimborso oltre il termine indicato. Se la raccolta non risponde a una domanda, il test dovrebbe rivelare quell'assenza, invece di premiare un risultato attraente ma irrilevante.
Due budget rispondono a due domande diverse sui costi
La potatura delle query limita le caratteristiche usate quando si pone una domanda. La potatura dei documenti limita quelle archiviate per ogni elemento indicizzato. In un servizio grande, il primo budget riguarda il lavoro ripetuto a ogni ricerca; il secondo influisce anche sull'indice che rimane tra una ricerca e l'altra.
Una prova utile cambia un budget alla volta. Mantieni fisse le rappresentazioni dei documenti mentre regoli la potatura delle query, poi ripeti con budget alternativi per i documenti. Se cambiano entrambi, un risultato diverso aiuta poco a capire quale modifica l'abbia causato.
Non esiste un'impostazione universalmente «abbastanza piccola». Una breve raccolta di FAQ, un archivio multilingue e un repository software hanno distribuzioni differenti di lingua, lunghezza e ripetizione. Una configurazione adatta a domande generali può perdere il dettaglio raro che distingue due procedure quasi identiche.
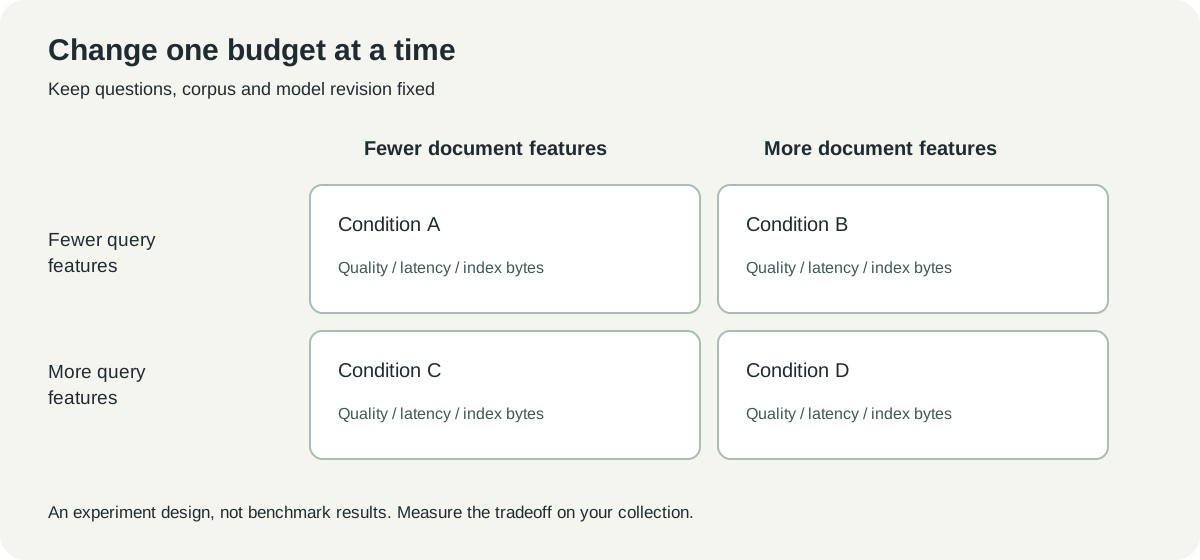 Piano sperimentale originale. Sono condizioni di confronto, non risultati di benchmark né impostazioni consigliate per la produzione.
Mantieni qualità, tempo e spazio occupato in colonne separate. Se la ricerca diventa più veloce ma l'articolo pertinente scompare dalla prima pagina, il guadagno di tempo ha un prezzo. Se un indice più grande non offre benefici significativi sulle domande reali, lo spazio aggiuntivo potrebbe non essere giustificato.
Un numero di benchmark non misura il tempo di risposta
La scheda del modello riporta 56.68 nDCG@10 su BEIR-15 per SlideOn senza potatura. È un risultato attribuito sulla qualità dell'ordinamento nei dataset del benchmark, non la probabilità che una determinata risposta sia corretta. Non è nemmeno una quantità di millisecondi. Valutazione pubblicata
La discussione sull'efficienza di LightOn distingue un indicatore indiretto dei FLOPS di recupero dalla latenza misurata, e il numero di valori non nulli dei documenti dalla dimensione dell'indice in byte. Vale la pena conservare queste distinzioni in ogni tabella comparativa. Un'approssimazione matematica aiuta a spiegare un meccanismo; una misura operativa indica cosa fa davvero il sistema.
Anche per una piccola valutazione il solo cronometro è insufficiente. Caricamento iniziale del modello, codifica dei documenti, costruzione dell'indice e query ripetute sono fasi diverse. Riporta separatamente l'avvio a freddo e una ricerca a sistema pronto, specificando se il tempo include la codifica della query.
La stessa attenzione vale per i punteggi di qualità. Un sistema può trovare il documento giusto e mettere in evidenza il passaggio sbagliato all'interno di un file lungo. Registra se l'unità di giudizio è un file, una sezione o un passaggio, e usa la stessa per tutti i candidati.
Tre raccolte pratiche rendono visibili i compromessi
Un manuale operativo è un buon primo esempio perché spesso il risultato desiderato è chiaro. Scrivi domande su resi, ritardi nelle spedizioni e accesso agli account, poi identifica la pagina autorevole per ognuna. Includi domande formulate diversamente dal titolo della pagina, per verificare qualcosa di più della corrispondenza tra titoli.
Un archivio multilingue di progetto aggiunge una difficoltà: lo stesso argomento può comparire negli appunti di una riunione, in un annuncio tradotto e in un vecchio piano. Usa i metadati per distinguere le politiche attuali dalle discussioni storiche. La somiglianza semantica non decide quale versione un'organizzazione debba seguire.
Una raccolta di documentazione per sviluppatori aggiunge stringhe esatte e quasi duplicati. Una domanda su un timeout può richiedere sia una guida concettuale sia una chiave di configurazione. Mantieni la ricerca lessicale come riferimento e verifica se un approccio ibrido giustifica la propria complessità sulle domande reali.
Questi sono scenari di valutazione proposti, non casi d'uso già distribuiti. Servono a rendere concreti i criteri di accettazione. In ogni caso, l'artefatto importante è un elenco di domande, fonti accettate e ordinamenti osservati che un'altra persona possa esaminare.
Rendi il primo confronto abbastanza piccolo da portarlo a termine
Usa, per esempio, 30 domande rappresentative invece di un insieme illimitato di query. Dividile in ricerche ordinarie, parafrasi, casi ambigui e domande a cui la raccolta non può rispondere. È una proposta iniziale, non un benchmark statisticamente rappresentativo.
Fai valutare i risultati attesi da un esperto del settore prima di regolare i parametri. Altrimenti ogni ordinamento sorprendente invita a una nuova spiegazione di cosa la domanda «intendesse davvero». Mantieni un insieme separato di domande mai toccate per la verifica finale, così le impostazioni non si limitano a memorizzare gli esempi di sviluppo.
Registra la revisione del modello, le regole di pretrattamento, la dimensione dei frammenti, le impostazioni di potatura e i dettagli della macchina. Cambiare anche uno solo di questi elementi può modificare il confronto. Una prova breve che un'altra persona può ripetere è più utile di un grande punteggio i cui dati di ingresso sono scomparsi.
Infine, esamina la schermata dei risultati nelle dimensioni che useranno le persone. Anche un primo risultato corretto delude se il titolo è troncato fino a diventare irriconoscibile o se l'estratto nasconde la frase decisiva. La qualità del recupero e quella dell'interfaccia si incontrano nel momento in cui una persona sceglie cosa aprire.
Una ricerca migliore accorcia il percorso verso la fonte
La nostra opinione è che l'idea utile di SlideOn sia separare qualità e budget di risorse in controlli verificabili. È un punto di partenza più pratico che presumere che ogni problema di ricerca richieda un modello di risposta più grande. Invita a un esperimento modesto: conservare le domande, variare la rappresentazione e osservare cosa riescono davvero a trovare le persone.
Parti dal documento che il tuo gruppo non riesce ripetutamente a individuare. Se il nuovo sistema lo porta in evidenza in modo affidabile anche con formulazioni diverse, hai un miglioramento concreto su cui costruire. La destinazione resta una fonte leggibile; il compito del modello è accorciare il percorso.
Fonti e materiali visivi
Consultato il 20 ottobre 2026. L'esempio di configurazione adatta la scheda pubblica del modello; non si dichiarano installazioni, inferenze locali o benchmark indipendenti. Schermata: pagina pubblica del modello LightOn su Hugging Face, acquisita dall'autore. I due diagrammi sono originali. Fonti dei materiali e avvisi di licenza accompagnano il registro dei media.
- Rilascio LightOn, 19 ottobre 2026
- Scheda del modello SlideOn e utilizzo
- Scheda del modello mSlideOn e dettagli linguistici
- Repository di addestramento e valutazione
Conserva le domande accanto alle prove
Salva insieme l'insieme delle query, i collegamenti alle fonti e le note di revisione, così un confronto successivo risponderà alle stesse domande. Telli.sh può aiutarti a organizzare questo registro di ricerca. Crea un account Telli.sh