[Carnet d’idées IA 01] SlideOn : un modèle de recherche plus petit, avec deux réglages de coût utiles
Découvrez SlideOn et mSlideOn de LightOn, deux modèles de recherche parcimonieuse pour les documents anglais et multilingues, avec un premier essai pratique et une comparaison claire de la qualité, de la vitesse et du stockage.
Le Carnet d’idées IA explore les idées et les possibilités concrètes des nouveaux modèles et outils d’IA.
Vous vous souvenez d'un document qui explique comment annuler une commande. Le moteur de recherche, lui, ne connaît que le mot annulation. Malheureusement, le document parle de rétractation. Une collection peut contenir la bonne réponse tout en restant difficile à exploiter.
LightOn a présenté SlideOn et mSlideOn le 19 octobre 2026, deux modèles destinés à retrouver les documents pertinents. SlideOn se concentre sur l'anglais ; mSlideOn étend l'approche aux textes multilingues, aux documents longs et au code. Leur intérêt particulier tient à deux budgets réglables : le nombre de caractéristiques utilisées par une requête et le nombre de caractéristiques conservées pour chaque document stocké. Annonce de LightOn
Cette introduction explique leur place, l'effet de ces réglages et la manière de réaliser une petite comparaison avant de construire un service de recherche. Il n'est pas nécessaire de créer une nouvelle application de chat pour comprendre l'idée. Commencez par une question, quelques documents et une définition de ce qu'est un résultat utile.
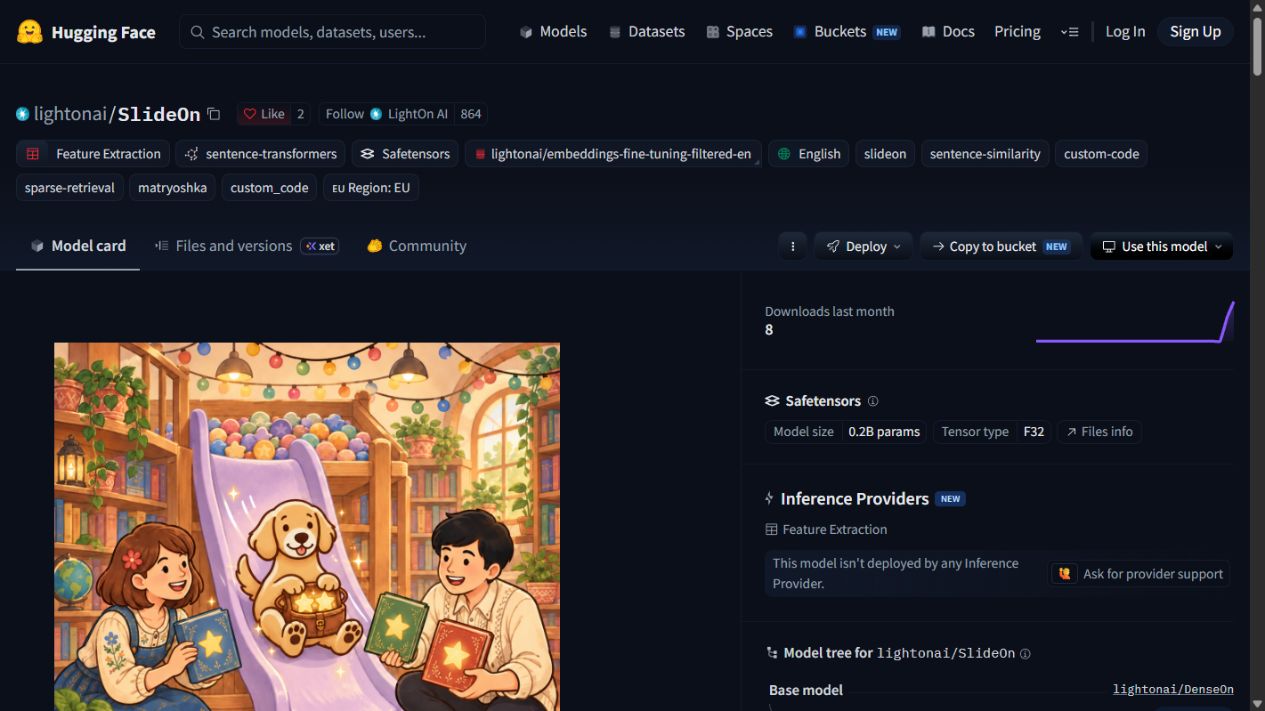 Capture de la fiche publique effectuée le 20 octobre 2026. Source : LightOn sur Hugging Face. Il s'agit de la page publiée du modèle, pas d'un résultat d'inférence locale ; l'interface montre aussi qu'un modèle téléchargeable ne dispose pas nécessairement d'un fournisseur d'inférence hébergée.
Avant une réponse, la recherche doit produire une bonne sélection
Un moteur de récupération classe les documents par rapport à une requête. Il n'a pas besoin de rédiger une réponse, de résumer les fichiers ou de décider si une entreprise doit modifier sa politique. Sa mission immédiate est plus précise : placer les sources les plus pertinentes en tête des résultats.
Prenons un manuel interne comportant trois pages sur les retours, les livraisons et les congés du personnel. Une question sur le renvoi d'une commande endommagée doit faire remonter la page consacrée aux retours. Si le premier résultat concerne plutôt le calendrier des congés, un générateur de réponses très fluide démarre déjà avec les mauvaises preuves.
Cette distinction rend la recherche utile même sans IA générative. Un spécialiste du support peut ouvrir directement le document bien classé. Un chercheur peut réunir des passages à comparer. Un outil de développement peut retrouver une implémentation probable avant qu'une personne l'examine.
Elle permet aussi de séparer utilement les responsabilités. La recherche aide à localiser les preuves ; le document original reste la référence pour vérifier les formulations, les dates et les exceptions. Un bon résultat doit faciliter l'accès à cette source, plutôt que de la remplacer par un score de confiance.
La recherche parcimonieuse tient un carnet d'adresses sélectif
Imaginez l'index comme un carnet d'adresses. Un index classique par mots-clés indique quels documents contiennent un terme. Un modèle parcimonieux appris crée un autre carnet : il attribue des poids à un ensemble relativement réduit de caractéristiques apprises, puis utilise les caractéristiques actives communes pour comparer requêtes et documents.
Le mot parcimonieux décrit cette sélection. Une représentation peut offrir de nombreuses positions possibles tout en n'en utilisant qu'une fraction pour un texte donné. Un index inversé peut associer chaque caractéristique active aux documents qui l'utilisent, afin de concentrer la recherche sur les listes de correspondances pertinentes.
La fiche de SlideOn indique 32,768 caractéristiques apprises possibles et des réglages indépendants d'élagage des requêtes et des documents. Ces positions sont des variables latentes apprises, pas un dictionnaire transparent de mots anglais. Il ne faut donc pas interpréter la caractéristique 100 comme un synonyme garanti de « retours ». Fiche de SlideOn
Ce détail compte pour expliquer les résultats. Les représentations parcimonieuses peuvent réduire le coût de recherche sans rendre chaque décision interne lisible. Pour l'utilisateur, l'explication pratique doit toujours être un passage pertinent du document source, avec assez de contexte pour vérifier pourquoi il correspond.
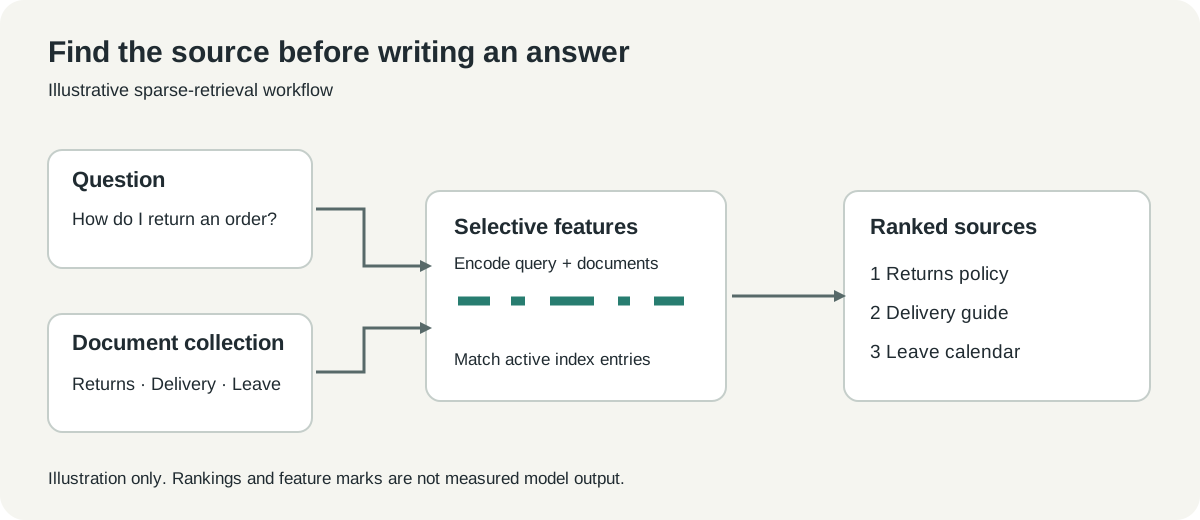 Schéma explicatif original. Les caractéristiques dessinées illustrent le mécanisme ; ce ne sont pas des activations mesurées sur SlideOn.
Choisissez le modèle adapté à votre véritable collection
Les deux noms désignent des points de départ apparentés, pas des réglages de langue interchangeables. Dans son annonce, LightOn donne 174 millions de paramètres pour SlideOn et 339 millions de paramètres pour mSlideOn. Le nombre le plus élevé ne suffit pas à déterminer lequel servira le mieux votre collection. Publication du 19 octobre
| Votre collection | Premier candidat raisonnable | Question à trancher lors de l'essai |
|---|---|---|
| Articles d'aide en anglais | SlideOn | Retrouve-t-il le bon article quand la requête emploie une autre formulation ? |
| Documents dans plusieurs langues | mSlideOn | Chaque langue importante fonctionne-t-elle séparément, et les requêtes interlingues répondent-elles au besoin ? |
| Longs documents techniques | mSlideOn, avec un découpage réfléchi | Le passage pertinent reste-t-il accessible après le prétraitement et le classement ? |
| Code source mêlé à du texte explicatif | mSlideOn comme candidat | Les fichiers renvoyés sont-ils utiles à quelqu'un qui connaît le dépôt ? |
L'étiquette multilingue justifie une investigation, pas un raccourci autour de l'évaluation. Un catalogue bilingue peut contenir des traductions, des politiques régionales différentes et des termes sans équivalent littéral unique. Ce sont des problèmes de recherche distincts, même si les documents partagent une étiquette de langue.
Imaginez une question anglaise visant une politique de remboursement française. C'est une tâche interlingue. Chercher dans un document français avec une requête française est une tâche monolingue. Enregistrez les deux séparément : une moyenne globale peut masquer une expérience médiocre pour certains lecteurs.
Le même principe s'applique au code. Retrouver un fichier sur la « restauration de session » demande autre chose qu'une correspondance exacte de nom de fonction. Conservez dans la comparaison les requêtes portant sur des identifiants précis et les questions descriptives, car un système utile a souvent besoin des deux.
Votre premier essai peut tenir dans un notebook
Commencez avec des textes publics ou synthétiques et un environnement Python propre. L'exemple publié utilise SparseEncoder de Sentence Transformers : c'est une interface de chargement du modèle, pas un serveur de recherche complet. L'exemple suivant adapte la recette officielle, vérifiée le 20 octobre 2026. Utilisation documentée
- Ouvrez la fiche du modèle et examinez le code d'inférence personnalisé et ses dépendances. Le chargement ci-dessous utilise
trust_remote_code=True, qui autorise l'exécution de l'implémentation Python du dépôt ; choisissez une révision examinée pour rendre l'essai reproductible. - Créez un environnement isolé et installez les versions de bibliothèques documentées.
- Encodez une requête et quelques documents courts. Utilisez les méthodes du modèle pour les requêtes et les documents plutôt que d'ajouter des préfixes à la main.
- Examinez les scores à côté du texte réel des documents. Ce premier test porte sur le classement, pas sur un seuil universel.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
Les documents ci-dessus sont des exemples pédagogiques inventés. Aucun résultat ni aucune précision mesurée ne sont revendiqués pour ce code. Vérifiez que le document sur les retours arrive en tête, puis essayez des reformulations et des alternatives volontairement difficiles.
Ne vous arrêtez pas à la première requête facile réussie. Posez des questions sur l'annulation avant expédition, un colis abîmé après livraison ou un remboursement demandé hors délai. Si la collection ne répond pas à une question, le test doit révéler cette absence plutôt que récompenser un résultat séduisant mais sans pertinence.
Deux budgets répondent à deux questions de coût différentes
L'élagage des requêtes limite les caractéristiques utilisées au moment de poser une question. Celui des documents limite les caractéristiques stockées pour chaque élément indexé. Dans un grand service, le premier budget concerne le travail répété à chaque recherche ; le second affecte aussi l'index conservé entre les recherches.
Un essai utile ne change qu'un budget à la fois. Gardez les représentations des documents fixes en ajustant l'élagage des requêtes, puis recommencez avec d'autres budgets documentaires. Si les deux changent simultanément, un résultat différent aide peu à identifier la cause.
Il n'existe pas de réglage universel « suffisamment petit ». Une FAQ courte, une archive multilingue et un dépôt logiciel présentent des distributions différentes de langue, de longueur et de répétition. Un réglage efficace sur des questions générales peut perdre le détail rare qui distingue deux procédures presque identiques.
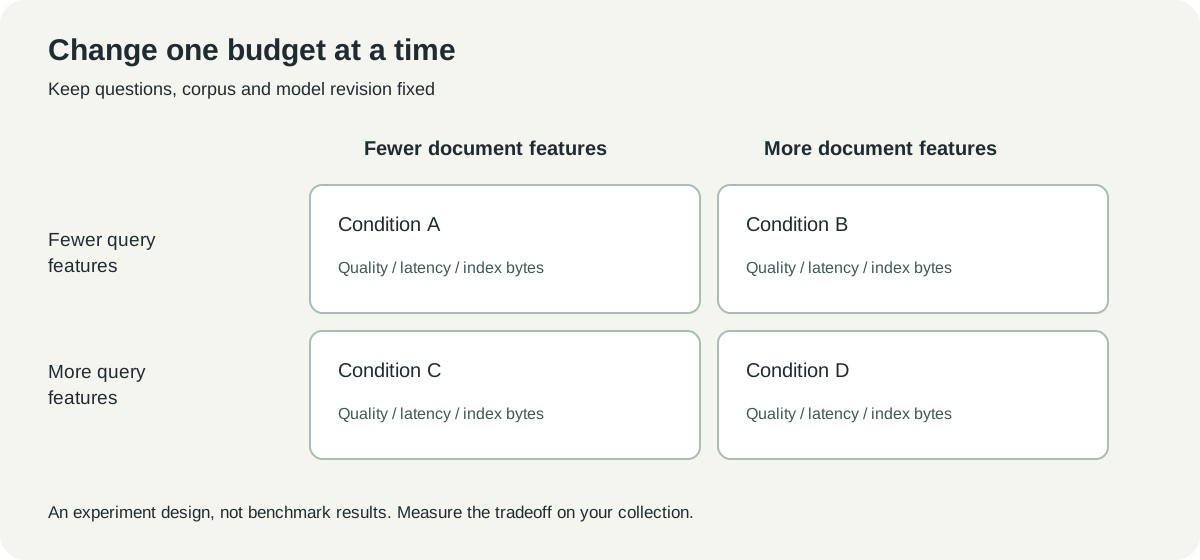 Plan d'expérience original. Il s'agit de conditions de comparaison, pas de résultats de benchmark ni de réglages recommandés en production.
Conservez la qualité, le temps et le stockage dans des colonnes distinctes. Si la recherche accélère mais que l'article pertinent disparaît de la première page, le gain de temps a un coût. Si un index plus volumineux n'apporte rien de significatif sur les questions réellement posées, son stockage supplémentaire n'est pas forcément justifié.
Un score de benchmark ne mesure pas le temps de réponse
La fiche publie 56.68 nDCG@10 sur BEIR-15 pour SlideOn sans élagage. C'est un résultat attribué à son auteur sur la qualité du classement à travers les jeux de données du benchmark, pas la probabilité qu'une réponse particulière soit exacte. Ce n'est pas non plus un nombre de millisecondes. Évaluation publiée
La discussion de LightOn sur l'efficacité distingue un indicateur approché de FLOPS de recherche et une latence mesurée, ainsi que le nombre de valeurs non nulles par document et la taille de l'index en octets. Il faut conserver cette distinction dans toute comparaison. Un indicateur mathématique aide à expliquer le mécanisme ; une mesure opérationnelle indique ce que fait réellement votre système.
Pour une petite évaluation, le chronomètre ne suffit pas non plus. Le chargement initial du modèle, l'encodage des documents, la construction de l'index et les requêtes répétées sont des phases différentes. Séparez le démarrage à froid d'une recherche à chaud et précisez si le temps inclut l'encodage de la requête.
La même attention s'applique à la qualité. Un moteur peut retrouver le bon document tout en plaçant le mauvais passage en tête d'un long fichier. Indiquez si vous jugez un fichier, une section ou un passage et gardez la même unité pour tous les candidats.
Trois collections pratiques rendent les compromis visibles
Un manuel opérationnel est un bon premier exemple, car le résultat souhaité est souvent clair. Rédigez des questions sur les retours, les retards d'expédition et l'accès au compte, puis identifiez la page de référence pour chacune. Ajoutez des questions dont les mots diffèrent du titre afin de tester davantage qu'une simple correspondance de titres.
Une archive de projet multilingue ajoute une difficulté : le même sujet peut apparaître dans des notes de réunion, une annonce traduite et un ancien plan. Utilisez les métadonnées pour distinguer une règle actuelle d'une discussion historique. La similarité sémantique ne décide pas quelle version une organisation doit appliquer.
Une collection de documentation développeur apporte des chaînes exactes et des quasi-doublons. Une question sur un délai d'attente peut nécessiter à la fois un guide conceptuel et une clé de configuration. Gardez la recherche lexicale comme référence et vérifiez sur vos vraies questions si une approche hybride mérite sa complexité.
Ce sont des scénarios d'évaluation proposés, pas des études de déploiement. Ils servent à rendre les critères d'acceptation concrets. Dans chaque cas, le livrable important est une liste de questions, de sources admises et de classements observés qu'une autre personne peut examiner.
Le premier comparatif doit rester assez petit pour être terminé
Partez par exemple de 30 questions représentatives plutôt que d'une accumulation illimitée. Répartissez-les entre recherches courantes, reformulations, cas ambigus et questions sans réponse dans la collection. Il s'agit d'un plan de départ proposé, pas d'un benchmark statistiquement représentatif.
Faites juger les résultats attendus par un spécialiste avant le réglage. Sinon, chaque classement surprenant invite à réinterpréter ce que la question « voulait vraiment dire ». Réservez un ensemble de questions intactes pour la vérification finale afin que les paramètres ne mémorisent pas simplement les exemples de développement.
Consignez la révision du modèle, les règles de prétraitement, la taille des segments, les réglages d'élagage et les caractéristiques de la machine. Modifier l'un de ces éléments peut changer la comparaison. Un petit essai reproductible est plus utile qu'un grand score dont les entrées ont disparu.
Enfin, examinez l'écran de résultats à la taille réellement utilisée. Même le bon premier résultat échoue si son titre est tronqué au point de devenir méconnaissable ou si l'extrait masque la phrase décisive. La qualité de la recherche et celle de l'interface se rejoignent au moment où l'on choisit quoi ouvrir.
Une meilleure recherche raccourcit le chemin vers la source
À notre avis, l'idée utile de SlideOn est de séparer qualité et ressources en réglages que l'on peut tester. C'est un point de départ plus concret que de supposer que tout problème de recherche demande un modèle de réponse plus gros. Il invite à une expérience modeste : conserver les questions, modifier la représentation et examiner ce que les personnes parviennent réellement à trouver.
Commencez par le document que votre équipe n'arrive régulièrement pas à retrouver. Si le nouveau moteur le fait remonter de façon fiable avec des formulations différentes, vous disposez d'une amélioration concrète à développer. La destination reste une source lisible ; le modèle doit raccourcir le trajet.
Sources et médias
Vérifié le 20 octobre 2026. L'exemple de configuration adapte la fiche publique ; aucune installation, inférence locale ou mesure indépendante n'est revendiquée. Capture : page publique du modèle LightOn sur Hugging Face, réalisée par l'auteur. Les deux schémas sont originaux. Les sources des ressources et les mentions de licence accompagnent le registre des médias.
- Publication de LightOn du 19 octobre 2026
- Fiche et utilisation de SlideOn
- Fiche de mSlideOn et détails linguistiques
- Dépôt d'entraînement et d'évaluation
Gardez les questions avec leurs preuves
Conservez ensemble les requêtes, les liens sources et les notes de vérification pour qu'une comparaison ultérieure réponde aux mêmes questions. Telli.sh peut vous aider à organiser ce dossier de recherche. Créer un compte Telli.sh