[Cuaderno de ideas de IA 01] SlideOn: un modelo de búsqueda más pequeño con dos controles de coste útiles
Conoce SlideOn y mSlideOn de LightOn: modelos de recuperación dispersa para encontrar documentos en inglés y en varios idiomas, con un primer experimento práctico y una forma clara de comparar calidad, velocidad y almacenamiento.
Cuaderno de ideas de IA explora las ideas y las posibilidades prácticas que hay detrás de los nuevos modelos y herramientas de IA.
Recuerdas que un documento explica cómo cancelar un pedido. El buscador solo recuerda la palabra cancelación. Por desgracia, el documento llama al mismo proceso desistimiento. Una colección puede contener la respuesta correcta y seguir siendo difícil de utilizar.
LightOn presentó SlideOn y mSlideOn el 19 de octubre de 2026, dos modelos para recuperar documentos relevantes. SlideOn se centra en el inglés; mSlideOn amplía el enfoque al texto multilingüe, los documentos largos y el código. Su atractivo particular reside en dos presupuestos ajustables: cuántas características utiliza una consulta y cuántas conserva cada documento almacenado. Anuncio de LightOn
Esta introducción explica dónde encajan los modelos, qué modifican esos controles y cómo probar una pequeña comparación antes de construir un servicio de búsqueda. No necesitas una nueva aplicación de chat para entender la idea. Empieza con una pregunta, unos cuantos documentos y una definición de qué resultado sería útil.
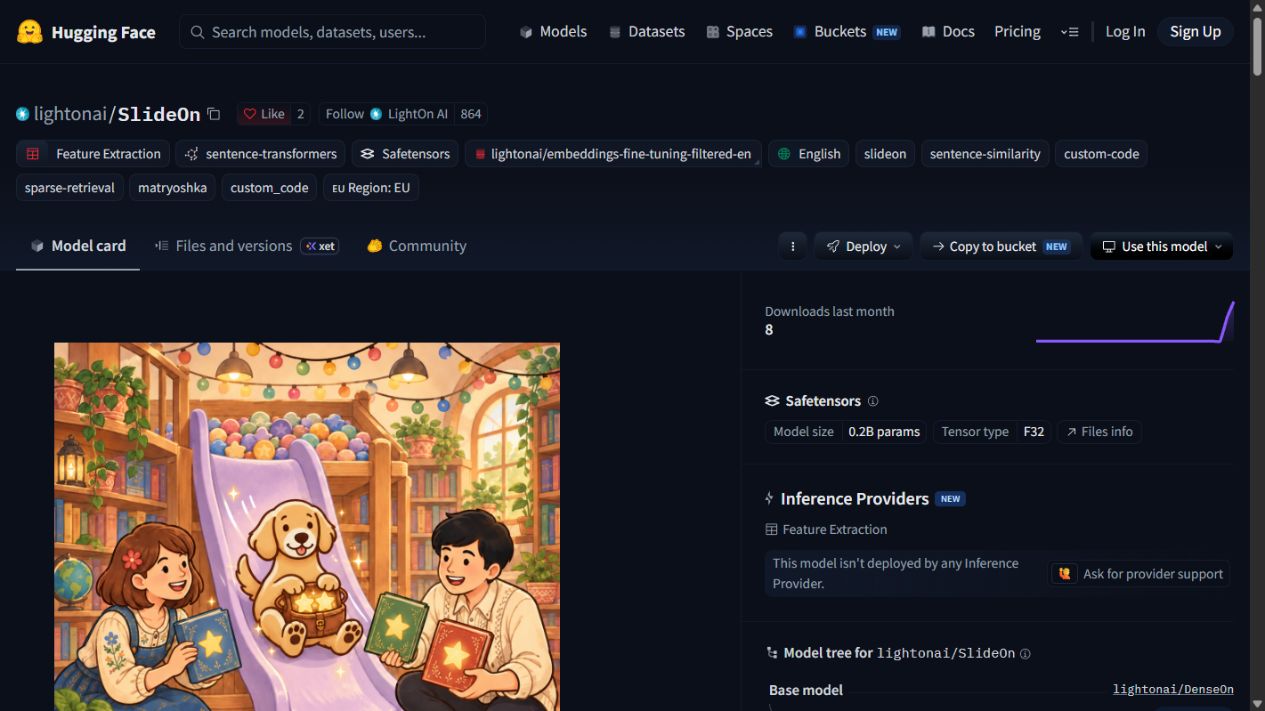 Captura de la ficha pública del modelo realizada el 20 de octubre de 2026. Fuente: LightOn en Hugging Face. Es la página publicada del modelo, no un resultado de inferencia local; la interfaz también muestra que un modelo descargable no tiene por qué disponer de un proveedor de inferencia alojada.
La búsqueda necesita una buena selección antes de ofrecer una respuesta
Un recuperador ordena documentos según una consulta. No tiene que redactar una respuesta, resumir los archivos ni decidir si una empresa debería cambiar su política. Su tarea inmediata es más concreta: situar las fuentes más relevantes cerca de la primera posición.
Pensemos en un manual interno con tres páginas sobre devoluciones, envíos y vacaciones del personal. Una pregunta sobre cómo devolver un pedido dañado debería destacar la página de devoluciones. Si el primer resultado trata del calendario de vacaciones, el generador de respuestas que venga después ya habrá partido de pruebas equivocadas, por muy fluido que escriba.
Esta distinción hace que la recuperación sea útil incluso sin IA generativa. Un especialista de soporte puede abrir directamente el documento clasificado. Un investigador puede reunir pasajes para compararlos. Una herramienta de programación puede localizar una implementación probable antes de que alguien la inspeccione.
También permite repartir las responsabilidades. La recuperación ayuda a localizar pruebas; el documento original sigue siendo el lugar donde verificar la redacción, las fechas y las excepciones. Un buen resultado debería facilitar el acceso a esa fuente, en lugar de sustituirla por una puntuación de confianza.
La búsqueda dispersa mantiene una agenda selectiva
Imagina un índice de búsqueda como una agenda de direcciones. Un índice convencional de palabras clave registra qué documentos contienen un término. Un modelo disperso aprendido crea otro tipo de agenda: asigna pesos a un conjunto relativamente pequeño de características aprendidas y después utiliza las características activas compartidas para puntuar consultas frente a documentos.
La palabra disperso describe esa selección. Una representación puede tener muchas posiciones posibles y utilizar solo una fracción para un texto concreto. Un índice invertido puede asociar cada característica activa con los documentos que la usan, lo que ayuda al buscador a centrarse en las listas de ocurrencias relevantes.
La ficha de SlideOn especifica 32,768 características aprendidas posibles y controles independientes para podar las representaciones de consultas y documentos. Esas posiciones son variables latentes aprendidas, no un diccionario transparente de palabras inglesas. No debes interpretar la característica 100 como un sinónimo garantizado de «devoluciones». Ficha del modelo SlideOn
Este último detalle importa al explicar los resultados. Las representaciones dispersas pueden abaratar la búsqueda sin que todas sus decisiones internas sean legibles para las personas. La explicación práctica para el usuario debería seguir siendo un pasaje relevante del documento fuente, con contexto suficiente para comprobar por qué coincide.
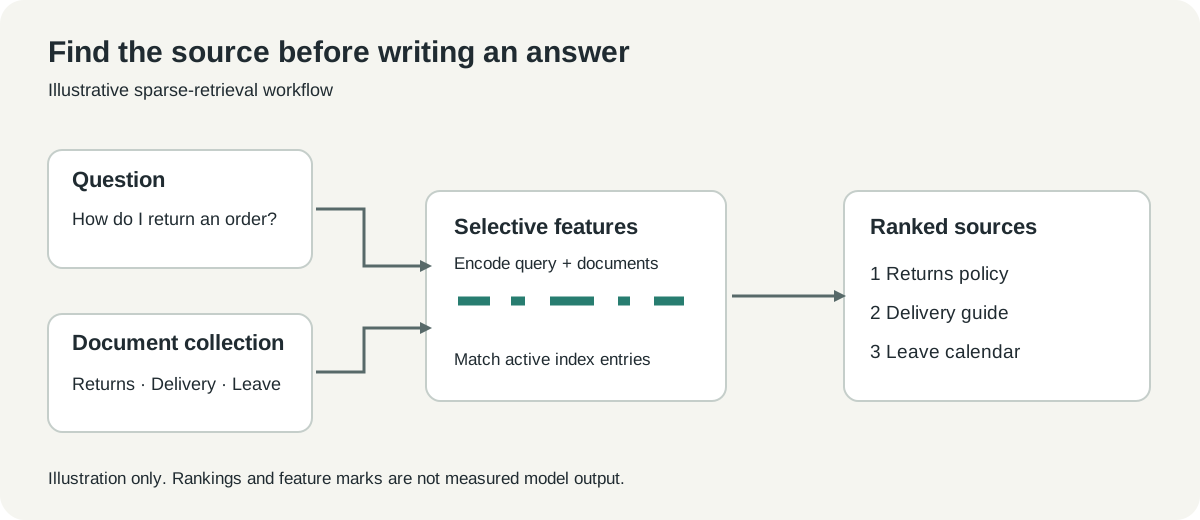 Diagrama explicativo original. Las marcas de características ilustran el proceso; no son activaciones medidas de SlideOn.
Elige el modelo según la colección que realmente tienes
Los dos nombres describen puntos de partida relacionados, no ajustes de idioma intercambiables. En su lanzamiento, LightOn atribuye a SlideOn 174 millones de parámetros y a mSlideOn 339 millones de parámetros. Esa cifra mayor, por sí sola, no determina cuál atenderá mejor a tu colección. Lanzamiento del 19 de octubre
| Tu colección | Primer candidato razonable | Pregunta que debe resolver la prueba |
|---|---|---|
| Artículos de ayuda en inglés | SlideOn | ¿Recupera el artículo correcto cuando la consulta emplea otras palabras? |
| Documentos en varios idiomas | mSlideOn | ¿Funciona bien cada idioma importante por separado y las consultas entre idiomas se comportan como necesitas? |
| Documentos técnicos largos | mSlideOn, con un plan deliberado de fragmentación | ¿La sección relevante sobrevive al preprocesamiento y a la clasificación? |
| Código fuente mezclado con prosa | mSlideOn como candidato | ¿Los archivos devueltos son útiles para alguien que conoce el repositorio? |
La etiqueta multilingüe es un motivo para investigar, no un atajo para evitar la evaluación. Un catálogo bilingüe puede contener traducciones duplicadas, políticas regionales distintas y términos sin una única equivalencia literal. Son problemas de recuperación diferentes incluso cuando los documentos comparten una etiqueta de idioma.
Por ejemplo, imagina que buscas una política de reembolsos francesa mediante una pregunta en inglés. Es una tarea entre idiomas. Buscar un documento francés con una consulta en francés es una tarea en el mismo idioma. Regístralas por separado: una puntuación agregada puede ocultar una experiencia deficiente para un grupo de lectores.
El mismo principio se aplica al código. Encontrar un archivo sobre «recuperación de sesiones» exige algo distinto de buscar el nombre exacto de una función. Incluye tanto consultas de identificadores exactos como preguntas descriptivas, porque un sistema de búsqueda útil suele necesitar ambas.
Tu primer experimento puede caber en un cuaderno
Empieza con texto público o sintético y un entorno Python limpio. El ejemplo publicado utiliza SparseEncoder de Sentence Transformers; es una interfaz para cargar modelos, no un servidor de búsqueda completo. Lo siguiente adapta la receta oficial, consultada el 20 de octubre de 2026. Uso documentado
- Abre la ficha del modelo y revisa el código de inferencia personalizado y las dependencias del repositorio. El cargador siguiente usa
trust_remote_code=True, que permite ejecutar la implementación Python de ese repositorio; utiliza una revisión revisada para que el experimento sea reproducible. - Crea un entorno aislado e instala el intervalo documentado de versiones de las bibliotecas.
- Codifica una consulta y unos pocos documentos breves. Utiliza los métodos del modelo para consultas y documentos en lugar de añadir prefijos manualmente.
- Inspecciona las puntuaciones junto al texto real de los documentos. Esta primera comprobación trata del orden de los resultados, no de un umbral de puntuación universal.
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
Los documentos anteriores son ejemplos didácticos inventados. Este código no lleva asociado ningún resultado declarado ni una exactitud medida. Lo razonable es comprobar si el documento de devoluciones queda primero y después probar paráfrasis y alternativas deliberadamente difíciles.
No te detengas cuando funcione la consulta más fácil. Pregunta por la cancelación de un pedido antes del envío, por un paquete dañado después de la entrega y por un reembolso fuera del plazo establecido. Si la colección no responde a una pregunta, la prueba debería mostrar esa ausencia en lugar de premiar un resultado atractivo pero irrelevante.
Dos presupuestos responden a dos preguntas de coste diferentes
La poda de consultas limita las características utilizadas al formular una pregunta. La poda de documentos limita las características almacenadas por cada elemento indexado. En un servicio grande, el primer presupuesto afecta al trabajo que se repite en cada búsqueda; el segundo también afecta al índice que se conserva entre búsquedas.
Una prueba útil modifica un presupuesto cada vez. Mantén fijas las representaciones de los documentos mientras ajustas la poda de consultas y repite después con otros presupuestos de documentos. Si ambos cambian a la vez, un resultado distinto aportará poca ayuda para decidir cuál fue la causa.
No existe un ajuste universal que sea «lo bastante pequeño». Unas preguntas frecuentes breves, un archivo multilingüe y un repositorio de software tienen distribuciones diferentes de idioma, longitud y repetición. Una configuración que funciona para preguntas generales puede perder el detalle raro que distingue dos procedimientos casi idénticos.
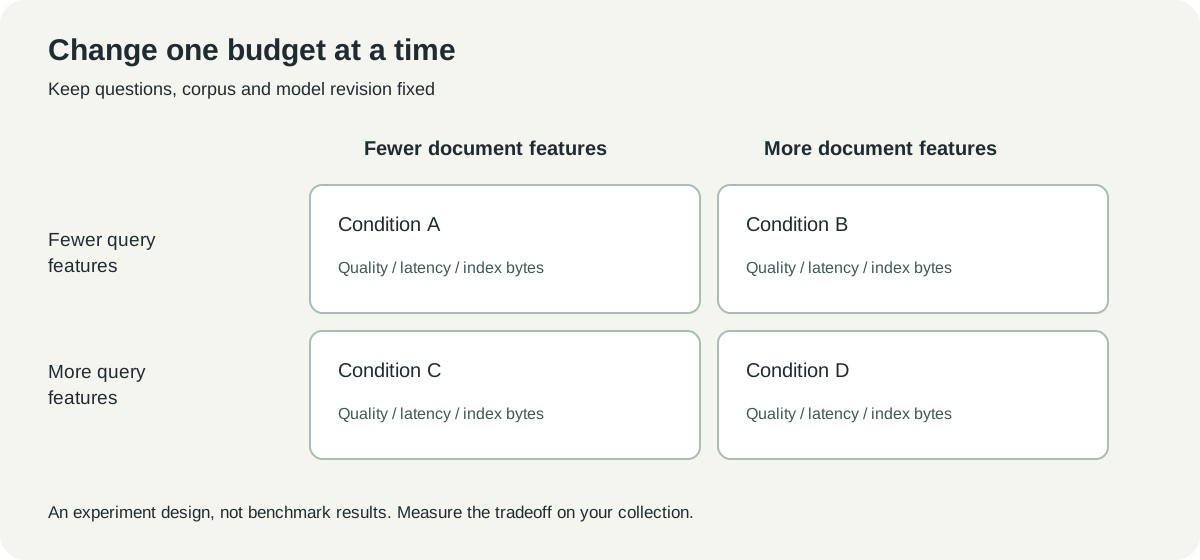 Plan experimental original. Son condiciones de comparación, no resultados de un benchmark ni ajustes recomendados para producción.
Mantén la calidad, el tiempo y el almacenamiento en columnas separadas. Si la búsqueda acelera pero el artículo relevante desaparece de la primera página, la mejora de tiempo tiene un coste. Si un índice mayor no aporta beneficios significativos para las preguntas reales, quizá su almacenamiento adicional no se justifique.
Una cifra de benchmark no mide el tiempo de respuesta
La ficha del modelo publica 56.68 nDCG@10 en BEIR-15 para SlideOn sin poda. Es un resultado atribuido de calidad de clasificación sobre los conjuntos del benchmark, no la probabilidad de que una respuesta concreta sea correcta. Tampoco es una cantidad de milisegundos. Evaluación publicada
El análisis de eficiencia de LightOn distingue entre un indicador indirecto de FLOPS de recuperación y la latencia medida, y entre el número de valores no nulos de los documentos y el tamaño del índice en bytes. Conviene conservar esa distinción en cualquier tabla comparativa. Una aproximación matemática ayuda a explicar un mecanismo; una medición operativa muestra qué hace realmente tu sistema.
Para una evaluación pequeña, un cronómetro tampoco basta. La carga inicial del modelo, la codificación de documentos, la construcción del índice y las consultas repetidas son fases diferentes. Informa por separado del arranque en frío y de la búsqueda con el sistema preparado, y aclara si el tiempo incluye la codificación de la consulta.
Las puntuaciones de calidad requieren el mismo cuidado. Un recuperador puede encontrar el documento correcto y colocar el pasaje equivocado al principio de un archivo largo. Registra si la unidad de evaluación es un archivo, una sección o un pasaje, y utiliza la misma para todos los candidatos.
Tres colecciones prácticas hacen visibles las concesiones
Un manual de operaciones es un buen primer ejemplo porque el resultado deseado suele estar claro. Escribe preguntas sobre devoluciones, retrasos de envío y acceso a cuentas, e identifica la página autorizada para cada una. Incluye preguntas cuya redacción difiera del encabezado de la página para evaluar algo más que la coincidencia de títulos.
Un archivo multilingüe de proyectos añade otra dificultad: el mismo tema puede aparecer en notas de reuniones, un anuncio traducido y un plan antiguo. Utiliza metadatos para distinguir una política vigente de una discusión histórica. La similitud semántica no decide qué versión debe seguir una organización.
Una colección de documentación para desarrolladores añade cadenas exactas y documentos casi duplicados. Una pregunta sobre un tiempo de espera puede necesitar tanto una guía conceptual como una clave de configuración. Conserva la búsqueda léxica como referencia e inspecciona si un enfoque híbrido justifica su complejidad en tus preguntas reales.
Son escenarios propuestos para evaluar, no casos de uso desplegados. Su objetivo es concretar los criterios de aceptación. En cada caso, el resultado importante es una lista de preguntas, fuentes aceptadas y clasificaciones observadas que otra persona pueda revisar.
Haz que la primera comparación sea lo bastante pequeña para terminarla
Utiliza, por ejemplo, 30 preguntas representativas en lugar de una pila ilimitada de consultas. Divídelas en búsquedas habituales, paráfrasis, casos ambiguos y preguntas que la colección no pueda responder. Es una propuesta inicial, no un benchmark estadísticamente representativo.
Pide a un experto en el tema que valore los resultados esperados antes de ajustar parámetros. De lo contrario, cada clasificación inesperada invita a reinterpretar lo que la pregunta «quería decir». Conserva otro grupo de preguntas intactas para la comprobación final, de modo que los ajustes no se limiten a memorizar los ejemplos del desarrollo.
Registra la revisión del modelo, las reglas de preprocesamiento, el tamaño de los fragmentos, los ajustes de poda y los detalles del equipo. Cambiar cualquiera de estos elementos puede alterar la comparación. Una ejecución breve que otra persona pueda repetir es más útil que una gran puntuación cuyos datos de entrada han desaparecido.
Por último, inspecciona la pantalla de resultados con el tamaño que usará la gente. Un primer resultado correcto sigue fallando si el título queda irreconocible por el recorte o si el extracto oculta la frase decisiva. La calidad de recuperación y la calidad de la interfaz se encuentran en el momento en que una persona elige qué abrir.
Una búsqueda mejor acorta el camino hacia la fuente
Nuestra opinión es que la idea útil de SlideOn consiste en separar la calidad y los presupuestos de recursos mediante controles que se pueden poner a prueba. Es un punto de partida más práctico que asumir que cada problema de búsqueda necesita un modelo de respuestas más grande. Invita a un experimento modesto: conservar las preguntas, variar la representación e inspeccionar qué consigue encontrar la gente.
Empieza por el documento que tu equipo no logra localizar una y otra vez. Si el nuevo recuperador lo destaca de forma fiable con distintas formulaciones, tendrás una mejora concreta sobre la que construir. El destino sigue siendo una fuente legible; la tarea del modelo es acortar el camino.
Fuentes y recursos visuales
Consultado el 20 de octubre de 2026. El ejemplo de configuración adapta la ficha pública del modelo; no se afirma haber realizado ninguna instalación, inferencia local ni benchmark independiente. Captura: página pública del modelo de LightOn en Hugging Face, capturada por el autor. Los dos diagramas son originales. Las fuentes de los recursos y los avisos de licencia figuran en el registro de medios.
- Lanzamiento de LightOn, 19 de octubre de 2026
- Ficha del modelo SlideOn y uso
- Ficha del modelo mSlideOn y detalles de idiomas
- Repositorio de entrenamiento y evaluación
Guarda las preguntas junto a las pruebas
Conserva el conjunto de consultas, los enlaces a las fuentes y las notas de revisión en un mismo lugar para que una comparación posterior responda a las mismas preguntas. Telli.sh puede ayudarte a organizar ese registro de investigación. Crea una cuenta en Telli.sh