Runway transmituje cyfrową postać w 24 kl./s. Jak długo czeka się na odpowiedź?
Artykuł badawczy Runway rozróżnia czas generowania wideo na żywo od czasu oczekiwania, który odczuwa rozmówca.
Gdy klient kończy pytanie, animowana postać ma chwilę, by dać znać, że je usłyszała. Obraz po uruchomieniu odtwarzania może być płynny, a przerwa przed pierwszą odpowiedzią i tak przypomina zerwane połączenie. Nowa publikacja Runway podaje wystarczająco dużo danych czasowych, by zobaczyć, skąd bierze się ta przerwa.
Runway udostępnił Characters 9 marca 2026 roku. Preprint z 3 listopada opisuje system konwersacyjnego awatara, który generuje obraz podczas mówienia. To opis techniczny istniejącego produktu. Autorzy z Runway podają wyniki własnego systemu, w tym generowanie obrazu na czterech kartach NVIDIA H100. Liczby pozwalają zespołom zadać konkretne pytania w pilotażu. Wyniki na innym urządzeniu, łączu lub w innej aplikacji trzeba zmierzyć osobno.
Serwer używany do testów H100, typu GPU opisanego w artykule Runway. Klatka kontekstowa od 极客湾Geekerwan, przeskalowana, CC BY 3.0. Źródło obrazu · Licencja.

Na każdą partię klatek przypada około 167 milisekund
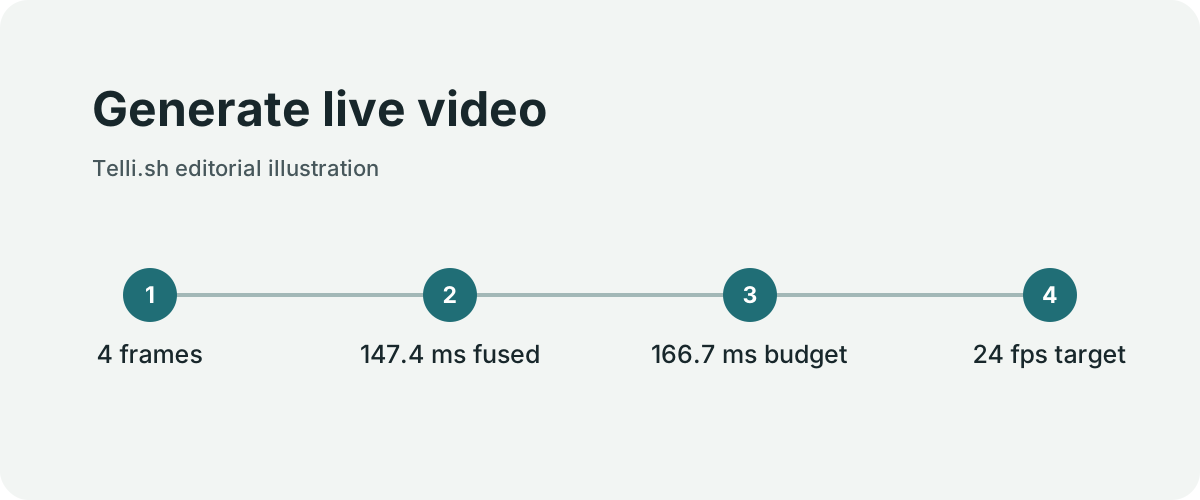
Generowanie wideo na żywo. Autorska ilustracja Telli.sh.
Przy 24 klatkach na sekundę partia czterech klatek musi być gotowa co około 167 milisekund. Jeśli partie przychodzą wolniej, niż odtwarzacz je zużywa, system potrzebuje większego bufora, innej jakości lub innej zmiany, by utrzymać płynność ruchu. Nawet przy płynnym odtwarzaniu przygotowanie jednej partii może zająć niemal całe 167 milisekund.
Autorzy Runway opisują system z około 57 miliardami parametrów, generujący klatki o wymiarach 704 na 1 088 pikseli. Mediana czasu kroku dyfuzji wyniosła 240,9 ms w konfiguracji odniesienia, 159,3 ms w jednej zoptymalizowanej konfiguracji i 147,4 ms po dalszym scaleniu operacji. Jedna odszumiona reprezentacja ukryta odpowiada czterem klatkom, a dekoder pracuje częściowo równolegle. Czasy kroków obejmują inny zakres pomiaru niż czas odpowiedzi odczuwany przez użytkownika.
Osobna kwestia polega na tym, że generowanie obrazu może osiągać wystarczające tempo po rozpoczęciu pierwszej partii. Autorzy podają 0,49 sekundy dla potoku wideo i około 2,1 sekundy mediany dla całej tury w warunkach pomiaru. W rozmowie znaczenie ma rozpoznawanie mowy, generowanie dialogu, synteza mowy, przesyłanie i pierwsze użyteczne odtworzenie. Etapy mogą się nakładać, więc odjęcie czasu wideo od całości nie ujawnia kosztu pojedynczego etapu.
| Miara | Na jakie pytanie odpowiada | Co mierzyć w pilotażu |
|---|---|---|
| Klatki na sekundę | Czy obraz utrzymuje ciągły ruch? | Dostarczone klatki i przerwy podczas długiej odpowiedzi |
| Czas do pierwszej odtwarzalnej odpowiedzi | Jak długa jest cisza po pytaniu? | Medianę i najwolniejsze przypadki na urządzeniach klientów |
| Reakcja na przerwanie | Czy użytkownik może ponownie zabrać głos bez czekania? | Czas od przerwania do zatrzymania dźwięku |
| Synchronizacja dźwięku i obrazu | Czy mowa zgadza się z ruchem? | Rozjazd po przerwaniach, zatrzymaniach i wznowieniu |
Gdzie animowana postać ma użyteczne zastosowanie
Przykładowy pilotaż to stanowisko prezentacji produktu w muzeum lub salonie. Odwiedzający pyta, do czego służy element sterujący, aplikacja wybiera krótką odpowiedź z zatwierdzonych materiałów, a postać odpowiada przy widocznym na ekranie schemacie. Osobie, która właśnie podeszła, może pomóc czytelna twarz, kierunek spojrzenia lub sygnał, że może zabrać głos. Przy niestabilnym połączeniu system może przejść do opisu tekstowego.
Drugi scenariusz to odgrywanie ról podczas szkolenia. Pracownik ćwiczy odpowiedź na skargę zdenerwowanego klienta, a następnie otrzymuje ocenę od aplikacji. To trudniejsze pod względem czasu niż nagrane powitanie. Postać musi zatrzymać się w połowie zdania, przyjąć przerwanie i odzyskać wątek po niezrozumianej wypowiedzi. Dobra próba rejestruje, czy uczestnicy się powtarzają albo mówią jednocześnie z postacią, obok zwykłych pomiarów opóźnienia.
Gdy awatar używa obrazu lub głosu prawdziwej osoby, liczą się zgoda i sposób przedstawienia. Organizacja może ustalić, kto tworzy postać, gdzie może pojawić się wizerunek i jak go usunąć. W eksperymencie wyraźnie fikcyjna postać lub aktor z udokumentowaną zgodą pomaga oddzielić wnioski o interfejsie od późniejszych spraw licencyjnych.
Jakich pytań nie rozstrzyga pomiar produkcyjny
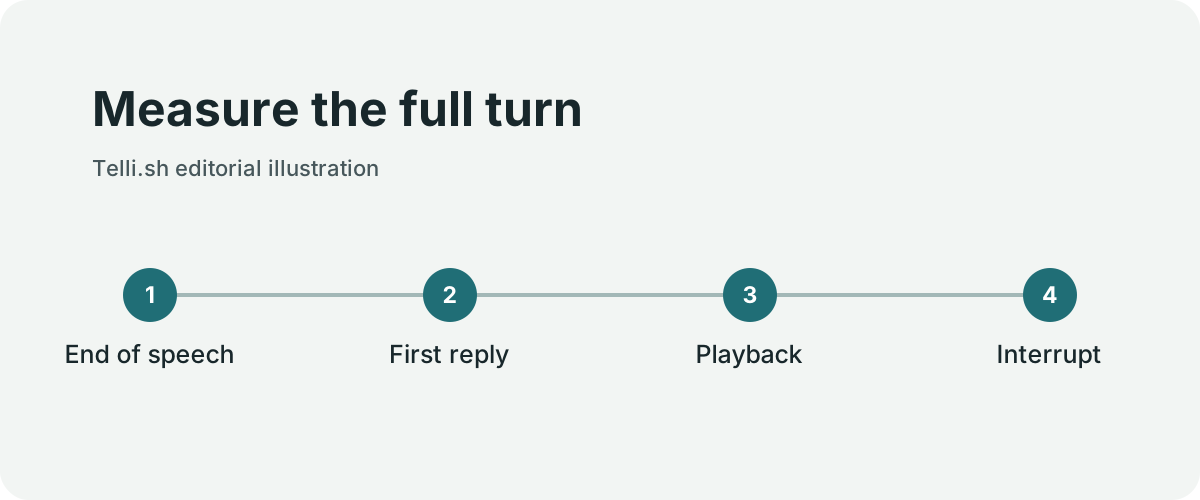
Pomiar całej tury. Autorska ilustracja Telli.sh.
Autorzy podają, że 99,5% sesji trwających co najmniej sekundę osiągało średnio ponad 23,5 klatki na sekundę. Liczą się przyjęty mianownik i okno uśredniania. Sesja może przekroczyć średni próg płynności i nadal mieć widoczną przerwę. Odpowiedź może też nadejść szybko, a potem stracić płynność. Artykuł nie daje każdemu nabywcy rozkładu czasów pierwszej odpowiedzi przy jego spodziewanym obciążeniu równoległym.
Mały pilotaż powinien objąć zwykłe łącze biurowe, ograniczone łącze mobilne i urządzenia rzeczywiście używane przez odwiedzających. Zacznij od odniesienia w postaci głosu i transkrypcji, a następnie przetestuj te same pytania z postacią. Porównaj ukończenie, porzucanie i przerywanie sesji. Zachowaj te same odpowiedzi i zasady dialogu, by różnice można było powiązać z interfejsem. Rejestruj wolne odpowiedzi razem z udanymi przykładami.
Konfiguracja sprzętowa z artykułu nie mówi, ile klient płaci za rozmowę. Przydatne jednostki kosztu to ukończona wymiana szkoleniowa albo prawidłowo obsłużone pytanie gościa. Liczba wygenerowanych minut ma sens, gdy zespół wie, ile z nich było użytecznych. Film pokazowy prezentuje wygląd i ruch. Rozmowa z pomiarem pokazuje, czy aplikacja jest gotowa dla odbiorców.
Obejrzyj jedną rozmowę klatka po klatce
Publikacja podaje dwa dokładniejsze rozkłady opóźnień. W 43 oznaczonych turach mediana od końca wypowiedzi użytkownika do dźwięku awatara po stronie klienta wyniosła 2,13 s, a percentyle 10. i 90. wyniosły 1,45 i 3,00 s. Od pierwszego dźwięku agenta do pierwszej klatki mowy zarejestrowanej przez LiveKit mediana wyniosła 493 ms, a odpowiednie percentyle 421 i 562 ms. Pierwszy czas opisuje ciszę przed słyszalną odpowiedzią w warunkach testu. Drugi dotyczy rozpoczęcia obrazu mówiącej postaci. Odwiedzający może odczuć oba.
Pomiar płynności pochodzi z innego zbioru danych. Autorzy rejestrowali telemetrię procesów roboczych przez siedem tygodni. Określili też, które sesje wchodzą do miary. Test w uczęszczanym miejscu może uzupełnić wynik, obserwując przerwy bezpośrednio po przerwaniu wypowiedzi lub przy nagłym napływie gości. Rejestruj dźwięk i obraz z rzeczywistego klienta, aby uwzględnić sieć i odtwarzanie.
Aby rzetelnie zmierzyć rozmowę, oznacz koniec wypowiedzi użytkownika, początek odpowiedzi agenta i pierwszą widoczną klatkę mowy. Powtarzaj pytania o znanej odpowiedzi. Tester może wtedy odróżnić trafną odpowiedź, która nadeszła wolno, od szybkiej odpowiedzi nie na temat. Wprowadź też kilka przerwań w porównywalnym momencie na obu interfejsach.
Porównaj koszty na podstawie ukończonej sesji
Centrum pomocy Runway opisuje opłatę 2 kredytów na początku i kolejnych 2 kredytów za każde 6 sekund aktywnego czasu sesji. Przy podanej cenie 0,01 USD za kredyt przed podatkiem, aktywna sesja trwająca 60 sekund daje w tym przykładzie 22 kredyty, czyli 0,22 USD. To przykład dla opublikowanych zasad rozliczeń. Łączna opłata zależy od konta, aktywnego czasu, aktualnej ceny i oddzielnie rozliczanych składników aplikacji.
Porównując interfejs z wersją głosową, zespół może śledzić koszt na ukończoną wymianę. Część osób opuści sesję przed końcem odpowiedzi. Inni rozpoczną drugą rozmowę z powodu problemu sieciowego lub niejasnej odpowiedzi. Te sesje zużywają zasoby nawet wtedy, gdy nie wykonano pierwotnego zadania. Przy liczeniu odsetka ukończenia zostaw porzucone sesje w mianowniku, a ich opłaty uwzględnij w wydatkach.
Może zmienić się też koszt moderacji i przeglądu treści. Firma może potrzebować kontroli zgodności wygenerowanej mowy z polityką, prawa do użycia postaci w danym regionie oraz sposobu skontaktowania gościa z pracownikiem, gdy system nie zna odpowiedzi. Przetestuj te ścieżki równie uważnie jak generowanie obrazu. Dobrze zaprojektowana ścieżka zastępcza może złagodzić skutki wolnego połączenia.
Przeprowadź porównanie z pomiarem
- Wybierz jedną zatwierdzoną interakcję z jasną prawidłową odpowiedzią i wynikiem.
- Wypróbuj wersję tekstową lub głosową i awatara, stosując to samo źródło odpowiedzi i te same reguły dialogu.
- Powtórz każde pytanie na urządzeniach i łączach odwiedzających. Uwzględnij długą odpowiedź, celowe przerwanie i chwilową utratę połączenia.
- Rejestruj początek odpowiedzi, początek obrazu mowy, przerwy odtwarzania, udane przerwania i ukończenie zadania.
- Przejrzyj niepowodzenia z nagraniem odtwarzania. Ustal, czy źródłem był odczyt mowy, generowanie odpowiedzi, synchronizacja, sieć czy interfejs.
- Porównaj liczbę ukończonych sesji i łączny koszt obu wersji przed przejściem do dłuższych interakcji lub większego ruchu.
Próba pokazuje, kiedy dodatkowy kanał wizualny rzeczywiście pomaga. Postać może jednej grupie ułatwić zabieranie głosu, a innej dołożyć zbędne opóźnienie. Wniosek z pilotażu należy wiązać z interakcją, łączem i urządzeniami, które go dały.
Sprawdź, jak zmieniło się zapotrzebowanie na sprzęt
Autorzy opisują przejście z ośmiu kart H100 na cztery dla jednej sesji w czasie rzeczywistym. Wersja z czterema kartami bez późniejszego scalenia operacji osiąga według publikacji 24,5 klatki na sekundę. To konkretna konfiguracja sprzętu i oprogramowania spełniająca cel w opisanym obciążeniu. Nie gwarantuje równoległej pracy przy innym obciążeniu ani nie określa zasobów przydzielanych kontu klienta.
Kupujący może zapytać dostawcę, która część usługi rusza pierwsza, co się dzieje przy ograniczonej dostępności i jak sesja wraca do działania. Salon wystawowy może tolerować krótki zanik obrazu, jeśli dźwięk trwa i pytanie doczeka się odpowiedzi. Zsynchronizowane szkolenie może wymagać pauzy, czytelnego statusu odzyskiwania i wznowienia od znanego miejsca. Powtórz czynność po przerwie i sprawdź, czy aplikacja wie, co rozmówca już usłyszał.
Kompromis ma znaczenie, gdy użytkownik przerywa w połowie zdania. System może gromadzić wygenerowany obraz i dźwięk, by utrzymać płynność. Zbyt duży bufor może sprawić, że postać mówi dalej, kiedy użytkownik chce zabrać głos. Mniejszy bufor może gorzej znosić zmienne łącze. Mierz osobno rzeczywiste zatrzymanie i początek kolejnej słyszalnej odpowiedzi.
Wypróbuj odzyskiwanie zrozumiałe dla użytkownika
Mały pilotaż może przełączyć połączenie z normalnego na wolniejsze podczas odpowiedzi. Zapisz, czy dźwięk się zatrzymuje, czy obraz zastyga i co pokazuje interfejs. Potem przywróć zwykłe połączenie i sprawdź, czy postać wznawia tę samą odpowiedź, prosi o powtórzenie pytania czy przenosi rozmowę do innego kanału. Każdy wynik inaczej wpływa na osobę stojącą przed kioskiem.
Jeśli system nie może wznowić, pokaż transkrypcję lub dostępny opis tekstowy albo przekaż sprawę człowiekowi, jeśli aplikacja to umożliwia. Krótkie zadanie może dać się ukończyć nawet bez obrazu. Długie ćwiczenie może wymagać powrotu do punktu kontrolnego. Właściwa reakcja zależy od tego, jaka część wymiany już się odbyła.
Regularny test obciążenia można zacząć od trzech wzorców przybywania użytkowników. Porównaj jedną długą sesję, kilka niezależnych krótkich sesji i grupę przychodzącą naraz. Obserwuj czas pierwszej odpowiedzi i najwolniejsze przypadki. Stabilna transmisja po rozpoczęciu odtwarzania wciąż może dać kiepskie doświadczenie, jeśli przy wzmożonym ruchu trzeba dużo dłużej czekać na początek.
Źródła
Jeśli chcesz przechowywać rozmowy i decyzje związane z pracą w formie, którą można przeszukiwać, załóż konto Telli.sh.