Runway trasmette un personaggio digitale a 24 fps. Quanto impiega a rispondere?
Uno studio di Runway distingue i tempi di generazione video in diretta dall’attesa che una persona avverte durante la conversazione.
Quando un cliente finisce di fare una domanda, il personaggio animato ha poco tempo per fargli capire che l’ha sentita. Il video può essere fluido dopo l’avvio e la pausa prima della prima risposta può comunque dare l’impressione che la chiamata sia caduta. Un nuovo articolo di Runway offre dati sufficienti per capire da dove viene quella pausa.
Runway ha lanciato Characters il 9 marzo 2026. La prestampa del 3 novembre descrive il sistema alla base di un avatar conversazionale che genera il video mentre parla. È un resoconto tecnico su un prodotto esistente. Gli autori di Runway riportano risultati del proprio sistema, incluso il funzionamento del video su quattro GPU NVIDIA H100. I dati suggeriscono domande concrete per un pilota. Per conoscere i risultati su un altro dispositivo, una diversa connessione o un’altra applicazione, occorre misurarli lì.
Server usato per provare hardware H100, il tipo di GPU utilizzato nello studio di Runway. Fotogramma di contesto di 极客湾Geekerwan, ridimensionato, CC BY 3.0. Fonte dell’immagine · Licenza.

Ogni gruppo di fotogrammi deve essere pronto in circa 167 millisecondi
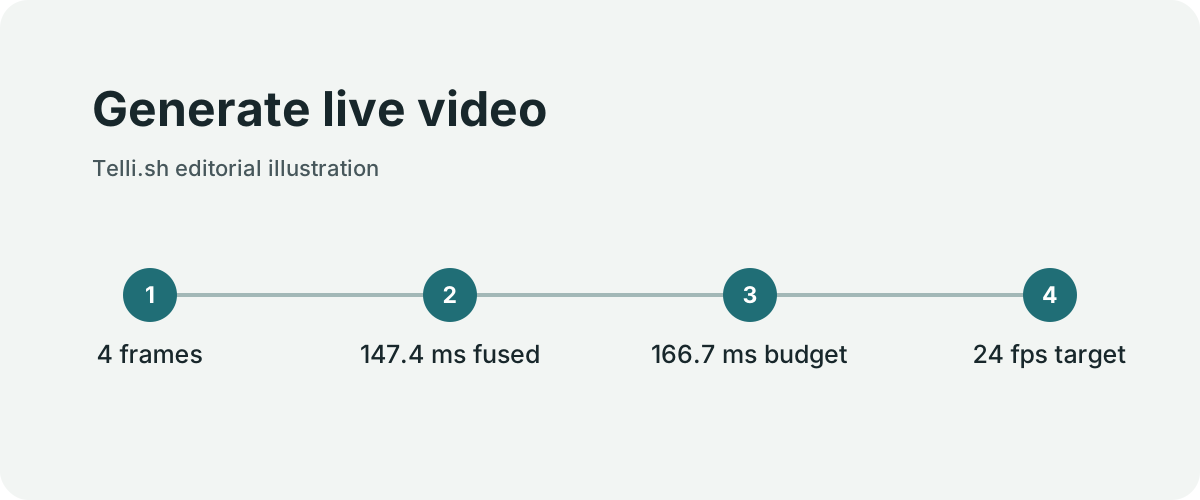
Generazione video in diretta. Illustrazione originale di Telli.sh.
A 24 fotogrammi al secondo, un gruppo di quattro deve essere pronto circa ogni 167 millisecondi. Se i gruppi arrivano più lentamente di quanto il lettore li consumi, per mantenere il movimento continuo servono più buffer, una qualità diversa o un altro adattamento. Un gruppo può richiedere quasi tutti i 167 millisecondi anche quando la riproduzione appare fluida.
Gli autori descrivono un sistema da circa 57 miliardi di parametri che produce fotogrammi da 704 per 1.088 pixel. Riportano mediane di 240,9 millisecondi per il passo di diffusione nella configurazione di riferimento, 159,3 in una configurazione ottimizzata e 147,4 dopo un’ulteriore fusione. Un latente a cui è stato tolto il rumore corrisponde a quattro fotogrammi, mentre la decodifica si sovrappone in una fase separata. I tempi del passo misurano qualcosa di diverso dal tempo di risposta percepito.
Un’altra distinzione è che la generazione può tenere il ritmo una volta avviato il primo gruppo. Nelle condizioni misurate, l’articolo indica 0,49 secondi per la pipeline video e circa 2,1 secondi per la mediana del turno completo. Elaborazione del parlato, generazione del dialogo, sintesi vocale, trasporto e inizio effettivo della riproduzione contano tutti. Le fasi possono sovrapporsi, quindi sottrarre il tempo del video dal totale non rivela il costo di una singola fase.
| Metrica | A quale domanda risponde | Che cosa misurare nel pilota |
|---|---|---|
| Fotogrammi al secondo | Il video mantiene un movimento continuo? | Fotogrammi consegnati e interruzioni durante una risposta lunga |
| Tempo alla prima risposta riproducibile | Quanto dura il silenzio dopo la domanda? | Mediana e casi più lenti sui dispositivi client |
| Risposta all’interruzione | La persona può riprendere a parlare senza aspettare? | Tempo dall’interruzione allo stop dell’audio |
| Allineamento audio-video | Parlato e movimento coincidono? | Disallineamento dopo interruzioni, blocchi e ripresa |
Dove un personaggio animato diventa utile
Un pilota plausibile è una postazione informativa per un museo o uno showroom. Una persona chiede a che cosa serve un comando, l’applicazione sceglie una risposta breve da materiali approvati e il personaggio risponde mentre sullo schermo resta visibile uno schema. Chi arriva alla postazione può beneficiare di un volto leggibile, della direzione dello sguardo o di un segnale che indica quando parlare. Se la connessione diventa instabile, il sistema può passare a una spiegazione scritta.
Un secondo scenario è la simulazione per dipendenti. Una persona si esercita a rispondere a un cliente frustrato e poi riceve indicazioni dall’app di formazione. La sincronizzazione è più impegnativa che in un saluto predefinito. Il personaggio deve fermarsi a metà frase, gestire le interruzioni e recuperare dopo aver capito male. Oltre alla latenza, una buona prova registra se i partecipanti si ripetono o parlano mentre il personaggio sta ancora rispondendo.
Consenso e rappresentazione contano quando l’avatar usa l’immagine o la voce di una persona reale. L’organizzazione può stabilire chi è autorizzato a creare un personaggio, dove può comparire la somiglianza e come rimuoverla. Una figura chiaramente sintetica o un interprete con un consenso documentato permette di separare i risultati sull’interfaccia dalle successive questioni di licenza.
Che cosa resta da sapere dopo i risultati in produzione?
Misurazione del turno intero. Illustrazione originale di Telli.sh.
Gli autori riferiscono che il 99,5% delle sessioni durate almeno un secondo ha superato una media di 23,5 fotogrammi al secondo. Il denominatore e l’intervallo della media contano. Una sessione può superare la soglia media e avere comunque un blocco visibile. Una risposta può arrivare subito e poi perdere fluidità. L’articolo non fornisce a ogni potenziale acquirente la distribuzione dei tempi alla prima risposta per il suo carico simultaneo.
Un piccolo pilota dovrebbe includere una normale connessione d’ufficio, una connessione mobile limitata e i tipi di dispositivi usati dai visitatori. Inizia con voce e trascrizione come riferimento, poi prova gli stessi prompt con il personaggio. Confronta completamenti, abbandoni e interruzioni. Mantieni uguali le risposte previste e le regole di dialogo, così puoi attribuire le differenze all’interfaccia. Registra i casi lenti insieme ai successi.
L’hardware dello studio non dice a chi acquista quanto costa una conversazione. Unità utili sono uno scambio formativo completato o una domanda a cui il visitatore ha ricevuto risposta corretta. Il numero di minuti generati conta dopo aver capito quanti sono serviti. Una demo mostra aspetto e movimento. Una conversazione misurata mostra se l’applicazione è pronta per il suo pubblico.
Osserva una conversazione fotogramma per fotogramma
L’articolo riporta due distribuzioni di latenza più precise. Su 43 turni annotati, la mediana fra fine del parlato dell’utente e audio dell’avatar sul client è 2,13 secondi, con 10º e 90º percentile a 1,45 e 3,00 secondi. Fra il primo audio dell’agente e il primo fotogramma parlante catturato da LiveKit, la mediana è 493 millisecondi, con percentili a 421 e 562 millisecondi. La prima misura è la pausa prima della risposta udibile nelle condizioni di test. La seconda riguarda l’inizio del video parlante. Un visitatore può percepirle entrambe.
La frequenza dei fotogrammi deriva da una raccolta distinta. Gli autori dicono di aver registrato la telemetria dei worker per sette settimane e specificano le sessioni incluse. Un pilota in un luogo affollato può integrare il risultato cercando interruzioni subito dopo che una persona riprende la parola o durante un arrivo simultaneo di visitatori. Registra audio e video dal client effettivo, così la misura include rete e riproduzione.
Per misurare la conversazione in modo equo, segna quando la persona finisce di parlare, quando l’agente comincia a rispondere e quando appare il primo fotogramma parlante. Ripeti domande con risposta attesa nota. Potrai distinguere una risposta precisa ma lenta da una rapida che non ha capito la richiesta. Includi alcune interruzioni con tempistiche uguali nelle due interfacce.
Confronta i costi per sessione completata
Il centro assistenza di Runway indica 2 crediti iniziali e altri 2 per ogni 6 secondi di sessione attiva. Al prezzo indicato di $0,01 a credito al netto delle imposte, 60 secondi attivi corrispondono a 22 crediti, ossia $0,22, a quelle tariffe. È un esempio del modello di addebito pubblicato. Il totale dipende da account, tempo attivo, prezzo corrente ed eventuali componenti fatturati separatamente.
Chi confronta l’interfaccia con una versione vocale può misurare il costo per scambio completato. Alcune persone abbandonano prima che l’avatar finisca. Altre devono ripetere la conversazione per un problema di rete o una risposta poco chiara. Queste sessioni consumano risorse anche senza completare il compito. Includi gli abbandoni nel denominatore del tasso di completamento e i relativi addebiti nella spesa.
Può cambiare anche il costo della moderazione e della revisione. L’azienda potrebbe dover verificare che il parlato rispetti le regole, che il personaggio sintetico possa apparire nel territorio previsto e che il visitatore possa raggiungere un addetto quando il sistema non ha una risposta. Prova questi percorsi con la stessa cura del rendering. Una buona alternativa può rendere meno grave una connessione lenta.
Conduci un confronto con misurazioni
- Scegli un’interazione approvata con risposta corretta ed esito atteso chiari.
- Prova una versione di riferimento in testo o voce e una con avatar, usando la stessa fonte e le stesse regole di dialogo.
- Ripeti ogni prompt sui dispositivi e sulle connessioni dei visitatori. Includi una risposta lunga, un’interruzione voluta e una breve caduta della connessione.
- Registra inizio della risposta, inizio del video parlante, blocchi, interruzioni riuscite e completamento del compito.
- Rivedi gli errori con i dati di riproduzione. Determina se dipendono da riconoscimento del parlato, generazione, sincronizzazione, rete o interfaccia.
- Confronta sessioni completate e costo totale delle due versioni prima di estendere la prova a usi più lunghi o trafficati.
La prova può mostrare dove aiuta il canale visivo. Un personaggio può rendere più chiaro quando prendere la parola a un pubblico e aggiungere un’attesa inutile per un altro. Il risultato vale per interazione, rete e dispositivi che l’hanno prodotto.
Guarda quante risorse stanno dietro i tempi
Gli autori descrivono il passaggio da otto GPU H100 a quattro per una singola sessione in tempo reale. La configurazione da quattro GPU senza la successiva ottimizzazione per fusione raggiunge 24,5 fotogrammi al secondo secondo l’articolo. Una precisa configurazione hardware e software raggiunge così l’obiettivo nel carico riportato. Il dato non garantisce la concorrenza di altri carichi e non descrive l’hardware assegnato all’account di un cliente.
Chi acquista può chiedere quale parte del servizio parte per prima, che cosa accade con risorse limitate e come recupera una sessione. Uno showroom può tollerare un breve blocco video se l’audio continua e arriva la risposta. Un’app di formazione sincronizzata può dover fermarsi, mostrare uno stato di recupero e ripartire da un punto noto. Dopo un’interruzione, ripeti l’azione e guarda se l’app ricorda che cosa l’utente ha già sentito.
Il compromesso si nota se una persona interrompe a metà frase. Il sistema può accumulare audio o video generato per mantenere fluidità. Un buffer troppo grande può far continuare a parlare il personaggio quando l’utente vuole intervenire. Un buffer ridotto può essere più sensibile a una connessione variabile. Misura separatamente l’arresto effettivo e la successiva risposta udibile.
Prova un recupero che il visitatore possa capire
Durante una breve prova, passa da una connessione normale a una più lenta mentre la risposta è in corso. Registra se l’audio si ferma, se il video si blocca e che cosa comunica l’interfaccia. Ripristina la connessione normale e controlla se il personaggio riprende la risposta, chiede di ripetere la domanda o passa a un altro canale. Per chi sta davanti a un chiosco, gli esiti sono diversi.
Se il sistema non recupera, offri una trascrizione, un percorso scritto accessibile o il passaggio a una persona se l’app lo consente. Un compito breve può concludersi anche se il video si blocca. Un esercizio lungo può dover ripartire da un punto salvato. Il comportamento più adatto dipende da quanto dello scambio è già completato.
Un test di carico può partire da tre schemi di arrivo. Confronta una sessione lunga, più sessioni brevi indipendenti e un gruppo che arriva insieme. In ciascun caso, osserva la prima risposta e i tempi più lenti. Un flusso stabile che raggiunge il ritmo dopo l’avvio può comunque offrire una cattiva esperienza se durante un picco l’attesa iniziale si allunga molto.
Fonti
Per conservare e ritrovare le conversazioni e le decisioni che accompagnano il tuo lavoro, crea un account Telli.sh.