Runway peut diffuser un personnage à 24 images par seconde. Combien de temps met-il à répondre ?
Un article de recherche de Runway distingue le rythme de génération de la vidéo en direct du temps d’attente ressenti au cours d’une conversation.
Lorsqu’un client termine sa question, un personnage animé a peu de temps pour montrer qu’il l’a entendue. La vidéo peut être fluide une fois lancée, tandis que le silence avant la première réponse donne l’impression que la connexion a coupé. Un nouvel article de Runway fournit assez de mesures pour comprendre d’où vient cette attente.
Runway a lancé Characters le 9 mars 2026. Son préprint du 3 novembre décrit le système derrière un avatar conversationnel qui génère sa vidéo en parlant. Il s’agit d’un compte rendu technique sur un produit existant. Les auteurs rapportent des résultats obtenus sur leur propre système, dont la production vidéo sur quatre GPU NVIDIA H100. Ces chiffres donnent des questions concrètes pour un essai. Les résultats doivent être mesurés séparément sur un autre appareil, une autre connexion ou une autre application.
Un serveur utilisé pour tester des H100, le type de GPU employé dans l’article de Runway. Image de contexte de 极客湾Geekerwan, redimensionnée, CC BY 3.0. Source de l’image · Licence.

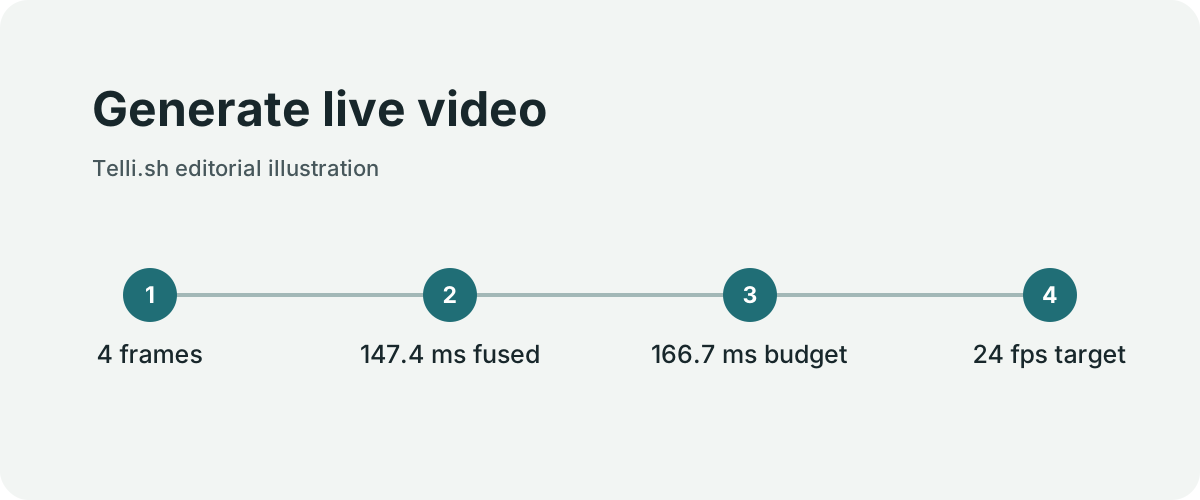
Chaque groupe d’images dispose d’environ 167 millisecondes
Génération de vidéo en direct. Illustration originale de Telli.sh.
À 24 images par seconde, un groupe de quatre images doit être prêt environ toutes les 167 millisecondes. Si les groupes arrivent plus lentement que le lecteur ne les consomme, il faut davantage de mémoire tampon, un autre réglage de qualité ou une autre adaptation pour garder un mouvement continu. Un groupe peut utiliser presque la totalité des 167 millisecondes et donner tout de même une vidéo fluide.
Les auteurs décrivent un système d’environ 57 milliards de paramètres qui produit des images de 704 × 1 088 pixels. Ils donnent des durées médianes pour une étape de diffusion de 240,9 millisecondes dans la configuration de référence, de 159,3 millisecondes dans une configuration optimisée et de 147,4 millisecondes après une fusion supplémentaire. Un bloc latent débruité correspond à quatre images, tandis que le décodeur travaille en parallèle. Ces durées ne couvrent pas le même périmètre que le délai de réponse perçu par l’utilisateur.
Une autre distinction vient du fait que la vidéo peut être produite à la cadence voulue dès que le premier groupe est lancé. L’article donne 0,49 seconde pour la chaîne vidéo et environ 2,1 secondes pour la médiane du tour complet dans les conditions mesurées. Le traitement de la parole, la génération du dialogue, la synthèse vocale, le transport et le premier événement de lecture utile comptent tous dans la conversation. Les étapes peuvent se chevaucher. Soustraire le délai vidéo du total ne donne donc pas le coût de l’une d’entre elles.
| Indicateur | Question posée | Mesure pendant un pilote |
|---|---|---|
| Images par seconde | La vidéo peut-elle garder un mouvement continu ? | Images effectivement affichées et interruptions pendant une longue réponse |
| Délai jusqu’à la première réponse lisible | Combien de temps dure le silence après une question ? | Médiane et cas les plus lents sur les appareils des utilisateurs |
| Réaction à une interruption | La personne peut-elle reprendre la parole sans attendre ? | Délai entre l’interruption et l’arrêt du son |
| Synchronisation du son et de l’image | La parole et les mouvements concordent-ils ? | Décalage après les interruptions, blocages et reprises |
Un personnage animé doit apporter quelque chose à l’échange
Un pilote possible est une borne de découverte dans un musée ou un espace d’exposition. Un visiteur demande à quoi sert une commande. L’application choisit une réponse courte à partir de documents approuvés, et le personnage répond pendant qu’un schéma reste affiché. Un visage identifiable, la direction du regard ou un signal de passage de parole peuvent aider une personne de passage. Si la connexion devient instable, le système peut proposer une explication écrite.
Un autre scénario est le jeu de rôle en formation. Une personne s’entraîne à répondre à un client mécontent et reçoit un retour de l’application. Le timing est plus exigeant que pour une salutation prévue à l’avance. Le personnage doit pouvoir s’arrêter en milieu de phrase, gérer les interruptions et repartir après avoir mal compris une expression. Un bon essai relève les répétitions et les prises de parole simultanées, en plus des mesures de latence.
Le consentement et les conditions d’utilisation de la représentation entrent en jeu si un avatar reprend l’image ou la voix de quelqu’un. Une organisation peut définir qui crée le personnage, où la ressemblance peut apparaître et comment la retirer. Pour un essai, un personnage ouvertement synthétique ou un interprète dont l’autorisation est documentée aide à séparer les conclusions sur l’interface des questions de droits ultérieures.
Ce que les résultats en production laissent ouvert
Mesure d’un tour complet. Illustration originale de Telli.sh.
Les auteurs indiquent que 99,5 % des sessions d’au moins une seconde ont dépassé 23,5 images par seconde en moyenne. Le dénominateur et la fenêtre de calcul sont importants. Une session peut dépasser ce seuil et présenter quand même un blocage visible. Une réponse peut aussi arriver rapidement puis devenir saccadée. L’article ne fournit pas à chaque acheteur la distribution des premiers délais pour son volume attendu de sessions simultanées.
Un petit pilote devrait couvrir une connexion de bureau ordinaire, une connexion mobile limitée et les catégories d’appareils effectivement utilisées. Commencez par une référence avec voix et transcription, puis rejouez les mêmes demandes avec le personnage. Comparez l’achèvement, les abandons et les interruptions. Gardez la source des réponses et les règles du dialogue stables afin de relier les écarts à l’interface. Consignez les réponses lentes avec les réussites.
La configuration matérielle du papier ne dit pas combien coûtera une conversation chez un acheteur. On peut mesurer le coût par échange de formation terminé ou par question de visiteur correctement traitée. Le nombre de minutes générées compte une fois que l’équipe sait combien de ces minutes étaient utiles. Une démonstration vidéo montre l’apparence et le mouvement. Une conversation mesurée montre si l’application convient à son public.
Observez un tour de conversation image par image
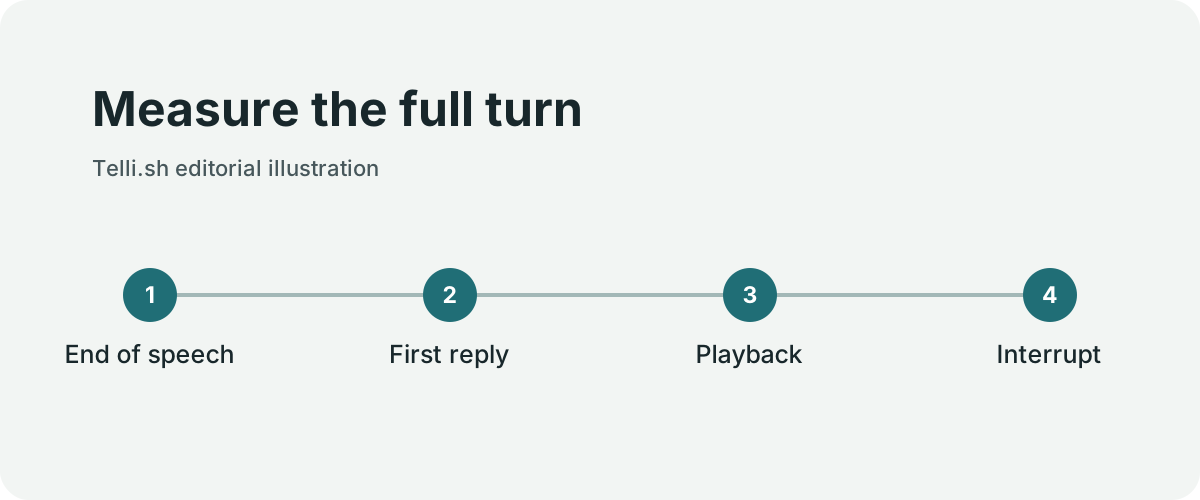
L’article publie deux distributions de latence plus précises. Sur 43 tours annotés, le délai médian entre la fin de la parole de l’utilisateur et le son de l’avatar côté client était de 2,13 secondes. Les 10e et 90e percentiles étaient de 1,45 et 3,00 secondes. Entre le premier son de l’agent et la première image où il parle, mesurés par LiveKit, la médiane était de 493 millisecondes et les deux percentiles de 421 et 562 millisecondes. La première mesure décrit l’attente avant une réponse audible dans le test. La seconde concerne le début de la vidéo parlée. Un visiteur peut percevoir les deux.
La cadence vidéo provient d’un autre relevé. Les auteurs indiquent avoir recueilli sept semaines de télémétrie sur les processus de génération et définissent les sessions prises en compte. Dans un lieu fréquenté, un pilote peut chercher des interruptions de lecture juste après une coupure de parole ou lors d’un afflux de visiteurs. Enregistrez le son et l’image du côté réellement utilisé afin d’inclure le réseau et la lecture.
Pour une mesure comparable, marquez le moment où la personne termine sa phrase, celui où l’agent commence à répondre et la première image visible où il parle. Répétez des questions dont la réponse correcte est connue. Cela permet de distinguer une réponse exacte et lente d’une réponse rapide mais hors sujet. Ajoutez quelques interruptions placées au même moment dans les deux interfaces.
Comparez le coût à l’échelle d’une session terminée
L’aide de Runway indique une facturation de 2 crédits au départ, puis 2 crédits par tranche de 6 secondes de session active. Au tarif indiqué de 0,01 dollar par crédit hors taxes, 60 secondes actives représentent dans cet exemple 22 crédits, soit 0,22 dollar. Le calcul illustre les règles publiées. Les montants dépendent du compte, du temps actif, du prix en vigueur et des composants facturés séparément.
Une équipe qui compare l’interface à une référence vocale peut suivre le coût par échange terminé. Certaines personnes quitteront la session avant la fin de la réponse. D’autres auront besoin d’un second échange à cause d’un problème réseau ou d’une réponse peu claire. Ces sessions consomment des ressources même si le visiteur n’a pas terminé sa tâche initiale. Incluez les abandons dans le dénominateur du taux d’achèvement et leur prix dans les dépenses.
Le coût de la modération et de la revue des contenus peut également changer. Une entreprise peut devoir contrôler que les paroles produites respectent les règles, que le personnage peut apparaître dans la région visée et qu’un visiteur peut joindre un employé quand le système ne sait pas répondre. Testez ces parcours avec autant de soin que le rendu. Un bon mode de repli peut limiter la gêne sur une connexion lente.
Mettez en place une comparaison avec des points de mesure
- Choisissez une interaction approuvée dont la bonne réponse et l’issue attendue sont claires.
- Essayez une version texte ou vocale de référence et la version avec avatar. Conservez la même source de réponses et les mêmes règles de dialogue.
- Répétez chaque demande sur les appareils et connexions du public. Incluez une réponse longue, une interruption volontaire et une coupure brève.
- Notez le début de la réponse, le début de la vidéo parlée, les trous de lecture, les interruptions réussies et l’achèvement de la tâche.
- Revoyez les échecs avec les éléments de lecture. Identifiez les problèmes de reconnaissance vocale, de réponse, de synchronisation, de réseau ou d’interface.
- Comparez les sessions terminées et le coût total avant de passer à des échanges plus longs ou plus fréquentés.
L’essai peut montrer où l’image apporte un bénéfice. Pour un public, le personnage peut clarifier qui parle. Pour un autre, il peut ajouter une attente inutile. Les résultats du pilote restent liés à l’interaction, au réseau et aux appareils qui les ont produits.
Examinez le changement de capacité derrière les délais
Les auteurs décrivent un passage de huit GPU H100 à quatre pour une session individuelle en temps réel. Selon eux, le système à quatre GPU atteint 24,5 images par seconde sans l’optimisation de fusion ultérieure. Une configuration matérielle et logicielle précise atteint donc la cible pour la charge mesurée. Cela ne garantit pas la capacité avec une charge différente et ne décrit pas le matériel attribué à un compte client.
Un acheteur peut demander quelle partie du service démarre la première, ce qui arrive si la capacité manque et comment une session reprend. Un espace d’exposition peut tolérer un arrêt visuel bref si le son continue et que la question trouve une réponse. Une formation synchronisée peut nécessiter une pause, un état de reprise clair et un redémarrage à un point connu. Rejouez l’action après une interruption et vérifiez si l’application sait ce que la personne a déjà entendu.
Le compromis se voit lorsque quelqu’un interrompt une phrase. Un système peut accumuler du son ou de l’image dans une mémoire tampon pour garder une lecture fluide. Un tampon trop grand peut faire continuer la voix alors que l’utilisateur reprend la parole. Un tampon plus court peut devenir plus sensible aux variations de débit. Mesurez séparément l’arrêt effectif et la prochaine réponse audible.
Testez une reprise que le visiteur peut comprendre
Dans un petit pilote, ralentissez la connexion pendant qu’une réponse est en cours. Notez si le son s’arrête, si l’image se fige et quel message apparaît. Rétablissez la connexion normale et vérifiez si le personnage reprend sa réponse, demande de répéter ou bascule vers un autre canal. Chaque issue a des conséquences différentes pour une personne devant une borne.
Si le système ne récupère pas, proposez une transcription, un parcours écrit accessible ou un relais humain selon ce que l’application permet. Une tâche courte peut s’achever même si la vidéo tombe en panne. Un exercice plus long peut devoir reprendre à un point enregistré. La bonne réaction dépend de la part de l’échange déjà réalisée.
Un test de charge courant peut commencer avec trois modes d’arrivée. Comparez une longue session, plusieurs sessions courtes indépendantes et un groupe qui arrive en même temps. Observez le début de la réponse et les cas les plus lents. Une vidéo fluide après le démarrage peut rester peu satisfaisante si l’affluence allonge fortement l’attente avant la première réponse.
Sources
Pour retrouver facilement la trace des conversations et décisions liées à votre travail, créez un compte Telli.sh.