Runway emite un personaje digital a 24 fotogramas por segundo. ¿Cuánto tarda en responder?
Un artículo de investigación de Runway distingue la cadencia de generación de vídeo en directo del tiempo de espera que se percibe en una conversación.
Cuando un cliente termina de preguntar, un personaje animado dispone de poco tiempo para dar una señal de que lo ha oído. El vídeo puede ir fluido al empezar y, aun así, el silencio antes de la respuesta puede parecer un fallo de la llamada. Un artículo reciente de Runway aporta mediciones para entender de dónde sale esa espera.
Runway lanzó Characters el 9 de marzo de 2026. Su preprint del 3 de noviembre describe el sistema de un avatar que genera vídeo a medida que habla. Es una descripción técnica de un producto existente. Los autores publican resultados de su propio sistema, entre ellos cómo funciona el vídeo con cuatro GPU NVIDIA H100. Sus cifras permiten formular preguntas concretas para un piloto. En otro dispositivo, conexión o aplicación habría que medir de nuevo.
Servidor usado para probar hardware H100, el tipo de GPU utilizado en el artículo de Runway. Fotograma de contexto de 极客湾Geekerwan, redimensionado, CC BY 3.0. Fuente de la imagen · Licencia.

Cada grupo de fotogramas dispone de unos 167 milisegundos
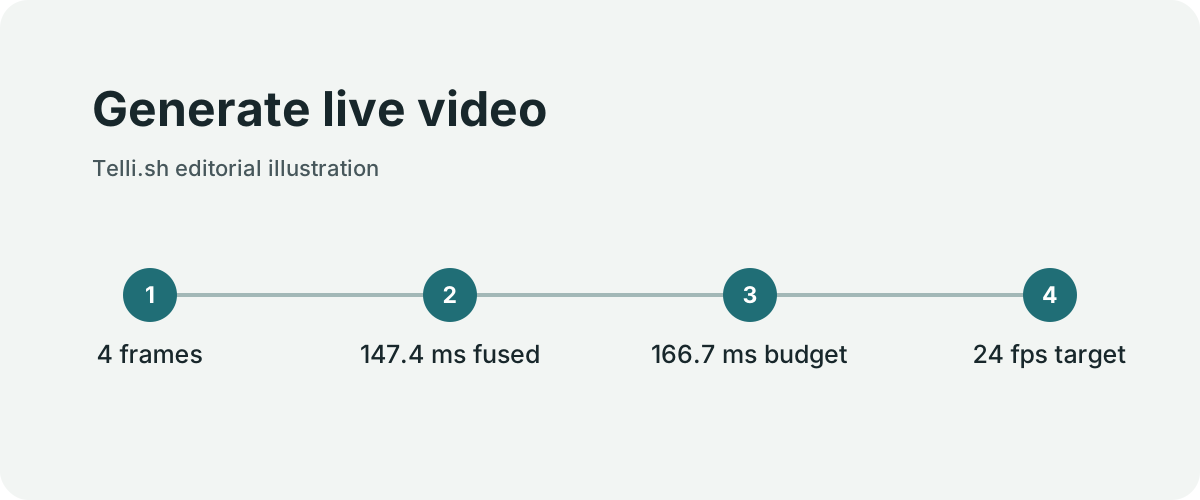
Generación de vídeo en directo. Ilustración original de Telli.sh.
A 24 fotogramas por segundo, debe estar listo un grupo de cuatro cada 167 milisegundos aproximadamente. Si los grupos llegan más despacio de lo que los consume el reproductor, el sistema necesita más búfer, otro ajuste de calidad o algún cambio para mantener el movimiento continuo. Un grupo puede consumir casi los 167 milisegundos y el vídeo seguir viéndose fluido.
Los autores describen un sistema de unos 57.000 millones de parámetros que produce fotogramas de 704 × 1.088 píxeles. Informan de medianas de 240,9 milisegundos por paso de difusión en la configuración de referencia, 159,3 milisegundos en una optimizada y 147,4 milisegundos tras aplicar una fusión adicional. Un bloque latente al que se ha quitado el ruido corresponde a cuatro fotogramas, mientras el decodificador trabaja de forma solapada. Esos pasos miden algo distinto del tiempo de respuesta que percibe una persona.
Otra diferencia es que el vídeo puede generarse al ritmo adecuado una vez que arranca el primer grupo. El artículo da 0,49 segundos para el procesamiento de vídeo y unos 2,1 segundos de mediana para un turno completo en las condiciones medidas. En la conversación cuentan el procesamiento de voz, la generación del diálogo, la síntesis de voz, la transmisión y el primer momento útil de reproducción. Las fases pueden solaparse. Restar el tiempo de vídeo del total no da el coste de una fase concreta.
| Métrica | Qué pregunta responde | Qué medir en un piloto |
|---|---|---|
| Fotogramas por segundo | ¿El vídeo mantiene el movimiento continuo? | Fotogramas entregados y cortes durante una respuesta larga |
| Tiempo hasta la primera respuesta reproducible | ¿Cuánto dura el silencio tras una pregunta? | Mediana y casos más lentos en los dispositivos de usuario |
| Reacción a una interrupción | ¿Puede la persona volver a hablar sin esperar? | Tiempo entre la interrupción y el corte del audio |
| Sincronización de audio y vídeo | ¿Coinciden la voz y los movimientos? | Desfase tras interrupciones, bloqueos y recuperaciones |
Un personaje en movimiento tiene que aportar algo al intercambio
Un piloto posible es un puesto de información sobre productos en un museo o sala de exposición. Alguien pregunta para qué sirve un control. La aplicación elige una respuesta breve de materiales aprobados y el personaje contesta mientras un diagrama sigue en pantalla. Un rostro claro, la dirección de la mirada o una señal de turno pueden ayudar a quien se acerca. Si falla la conexión, el sistema puede pasar a una explicación escrita.
Otro escenario son los juegos de rol para formar al personal. Una persona ensaya cómo responder a un cliente molesto y recibe comentarios de la aplicación de formación. El tiempo importa más que en un saludo preparado. El personaje debe parar a mitad de frase, gestionar interrupciones y recuperarse de una expresión mal entendida. Un buen ensayo registra si las personas se repiten o hablan por encima del personaje, además de las mediciones habituales de latencia.
El consentimiento y el uso de la imagen importan cuando el avatar emplea la imagen o la voz de alguien real. La organización puede establecer quién puede crear un personaje, dónde puede aparecer la representación y cómo se retira. Para un ensayo, una identidad claramente sintética o una persona intérprete con autorización documentada facilita separar los hallazgos de interfaz de las cuestiones de derechos posteriores.
Qué dejan abierto los resultados de producción
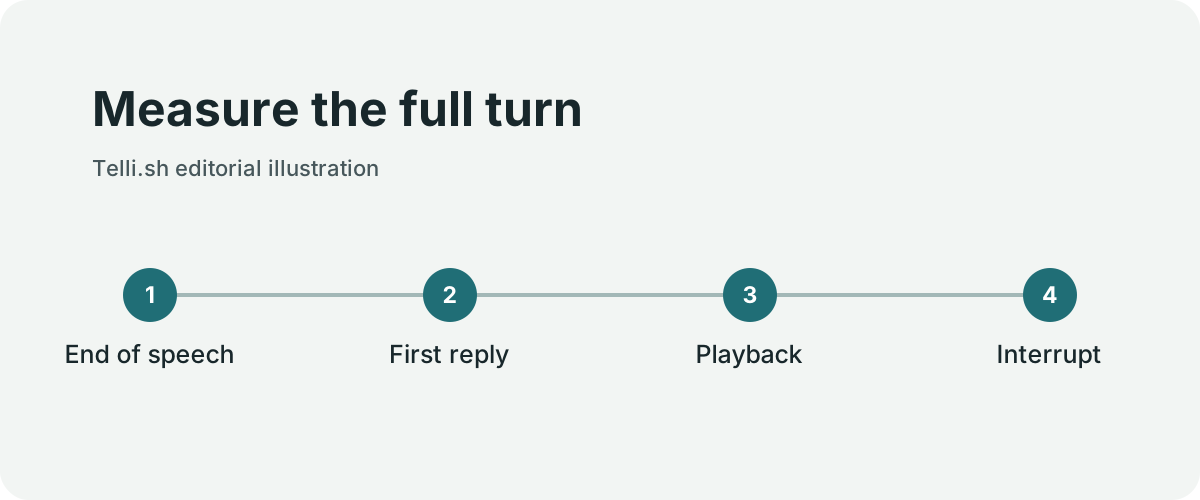
Medición del turno completo. Ilustración original de Telli.sh.
Los autores informan de que el 99,5 % de las sesiones de al menos un segundo superó los 23,5 fotogramas por segundo de media. Importan el denominador y la ventana del promedio. Una sesión puede superar el umbral medio y sufrir un parón visible. Una respuesta también puede llegar pronto y perder fluidez después. El artículo no da a cada comprador la distribución de primeras respuestas para su número previsto de sesiones simultáneas.
Un piloto pequeño debería incluir una conexión de oficina habitual, una conexión móvil limitada y los tipos de dispositivo que utiliza el público. Empieza con una referencia de voz y transcripción. Repite luego las mismas peticiones con el personaje. Compara los casos que terminan, los abandonos y las interrupciones. Mantén estables las respuestas preparadas y las reglas de diálogo para atribuir las diferencias a la interfaz. Registra las respuestas lentas junto a los éxitos.
La configuración del artículo no indica cuánto cuesta una conversación a un comprador. Es útil medir el coste por ejercicio de formación terminado o por pregunta de visitante respondida correctamente. El número de minutos generados importa cuando el equipo sabe cuántos fueron útiles. Una demostración de vídeo muestra el aspecto y el movimiento. Una conversación con mediciones muestra si la aplicación está preparada para su público.
Observa un turno fotograma a fotograma
El artículo publica dos distribuciones de latencia más precisas. En 43 turnos anotados, la mediana desde que terminaba de hablar la persona hasta el audio del avatar en el cliente fue de 2,13 segundos. Los percentiles 10 y 90 fueron de 1,45 y 3,00 segundos. Entre el primer audio del agente y el primer fotograma en que habla, registrados con LiveKit, la mediana fue de 493 milisegundos y los dos percentiles de 421 y 562 milisegundos. La primera medida refleja la pausa hasta la respuesta audible en la prueba. La segunda mide el comienzo del vídeo en el que habla. El público puede percibir las dos.
La tasa de fotogramas procede de otra recogida de datos. Los autores dicen que registraron siete semanas de telemetría de los procesos y explican qué sesiones entraron en la métrica. En un lugar concurrido, un piloto puede buscar cortes justo después de una interrupción o durante una llegada simultánea de visitantes. Registra audio y vídeo del cliente real para incluir el comportamiento de la red y la reproducción.
Para medir una conversación de forma comparable, marca cuándo termina la intervención de la persona, cuándo empieza a contestar el agente y cuándo aparece el primer fotograma en que habla. Repite preguntas cuya respuesta se conozca. Así puedes distinguir una respuesta acertada y lenta de otra rápida que no atendió la petición. Incluye varias interrupciones en el mismo punto de las dos interfaces.
Compara costes por sesión terminada
El centro de ayuda de Runway describe un cargo inicial de 2 créditos y otros 2 por cada 6 segundos de sesión activa. Al precio indicado de 0,01 dólares por crédito antes de impuestos, 60 segundos activos representarían en este ejemplo 22 créditos, o 0,22 dólares. Es un cálculo con el esquema publicado. El gasto depende de la cuenta, el tiempo activo, el precio vigente y los componentes que se facturen por separado.
Al comparar la interfaz con una referencia de voz, el equipo puede medir el coste por intercambio terminado. Algunas personas abandonarán antes de que el avatar concluya. Otras necesitarán otro intento por un problema de red o una respuesta poco clara. Esas sesiones consumen recursos aunque no se complete la tarea original. Incluye los abandonos en el denominador de la tasa de finalización y sus cargos en el gasto.
También puede cambiar el coste de moderación y revisión. Una empresa quizá tenga que comprobar si lo que se dice cumple las reglas, si el presentador sintético puede aparecer en la región prevista y cómo contactar con una persona cuando el sistema no sabe contestar. Prueba esos recorridos con el mismo cuidado que el vídeo. Una alternativa clara puede reducir el impacto de una conexión lenta.
Compara las versiones con puntos de medida
- Elige una interacción aprobada con una respuesta correcta y un resultado esperado claros.
- Prueba una referencia de texto o voz y la versión con avatar con la misma fuente de respuestas y las mismas reglas de diálogo.
- Repite cada petición en los dispositivos y conexiones del público. Incluye una respuesta larga, una interrupción deliberada y un corte breve de conexión.
- Anota el inicio de la respuesta y del vídeo hablado, los huecos de reproducción, las interrupciones logradas y si la persona completó la tarea.
- Revisa los fallos junto con las evidencias de reproducción. Decide si el problema vino del reconocimiento de voz, la respuesta, la sincronización, la red o la interfaz.
- Compara sesiones completas y coste total antes de ampliar a usos más largos o de mayor tráfico.
La prueba muestra cuándo ayuda el canal visual. Un personaje puede aclarar el cambio de turno para un público y añadir una espera innecesaria para otro. Los resultados pertenecen a la interacción, la conexión y los dispositivos en que se midieron.
Examina el cambio de capacidad detrás de las mediciones
Los autores describen un paso de ocho GPU H100 a cuatro para una sesión individual en tiempo real. La configuración de cuatro GPU alcanza 24,5 fotogramas por segundo sin la optimización de fusión posterior, según el artículo. Una configuración concreta de hardware y software cumple así el objetivo en la carga medida. Esto no garantiza una concurrencia distinta ni indica qué hardware se asigna a una cuenta de cliente.
Un comprador puede preguntar qué parte del servicio arranca primero, qué sucede si falta capacidad y cómo se recupera una sesión. Una sala de exposición puede tolerar un corte visual breve si el audio continúa y la pregunta recibe respuesta. Una formación sincronizada quizá deba detenerse, mostrar un estado claro y reanudar en un punto conocido. Repite la acción tras una interrupción y comprueba si la aplicación sabe qué parte escuchó ya la persona.
La disyuntiva importa cuando alguien interrumpe a mitad de frase. Un sistema puede acumular audio o vídeo para que la reproducción sea fluida. Un búfer excesivo puede hacer que el personaje siga hablando cuando la persona intenta tomar la palabra. Uno menor puede ser más sensible a una conexión variable. Mide por separado cuándo se detiene el audio y cuándo empieza la siguiente respuesta audible.
Prueba una recuperación que el visitante pueda entender
En un piloto pequeño, cambia de una conexión normal a otra más lenta mientras se reproduce una respuesta. Anota si se corta el audio, se congela la imagen y qué dice la interfaz. Restablece la conexión y comprueba si el personaje retoma la respuesta, pide repetir la pregunta o ofrece otro canal. Cada resultado tiene consecuencias distintas para quien está ante una pantalla pública.
Si el sistema no se recupera, ofrece una transcripción, una vía escrita accesible o la posibilidad de hablar con alguien si la aplicación lo permite. Una tarea corta puede terminar aunque falle el vídeo. Una actividad larga quizá deba volver a un punto guardado. El comportamiento adecuado depende de cuánto se haya completado.
Una prueba de carga habitual puede empezar con tres patrones de llegada. Compara una sesión larga, varias sesiones cortas independientes y un grupo que empieza al mismo tiempo. Observa la primera respuesta y los casos más lentos. Cumplir la cadencia una vez que arranca el vídeo aún puede dar una mala experiencia si un pico de llegadas retrasa mucho el inicio.
Fuentes
Para conservar un registro en el que puedas buscar las conversaciones y decisiones de tu trabajo, crea una cuenta de Telli.sh.