Robot, który wygrywa na pokazie, może przegrać na twoim stanowisku
Rozproszone testy RoboColosseum na rzeczywistych robotach pokazują, dlaczego wyniki zmieniają się wraz ze sprzętem, zadaniem i dostrajaniem. Zaplanuj pilotaż wokół pracy, którą chcesz wykonać.
Dwa ramiona robotyczne wyglądają równie przekonująco na nagraniach. Jedno ześlizguje się z nieznanego pojemnika. Drugie chwyta go prawidłowo, ale wkłada do niewłaściwego kosza. Zespół wybierający między nimi musi wiedzieć, które błędy występują na jego linii i co trzeba zrobić, by wznowić pracę.
RoboColosseum to projekt badawczy porównujący polityki sterowania na fizycznych robotach w rozproszonych ośrodkach testowych. W wersji arXiv z 2 listopada autorzy opisują 5 699 porównań parami w 124 ośrodkach. Stwierdzają niską zgodność rankingów polityk między platformami sprzętowymi i informują, że ich względna skuteczność może się zmienić po dostrojeniu. Kupujący lub badacz może wykorzystać te dane, by zaprojektować lepszy test, zanim podejmie decyzję na podstawie filmu pokazowego.
Unitree G1 po lewej, jedna z ocenianych platform, podczas Japan Mobility Show 2025. Zdjęcie RuinDig/Yuki Uchida, przeskalowane, CC BY 4.0. Źródło obrazu · Licencja.

Za rankingiem stoją konkretny robot, zadanie i warunki
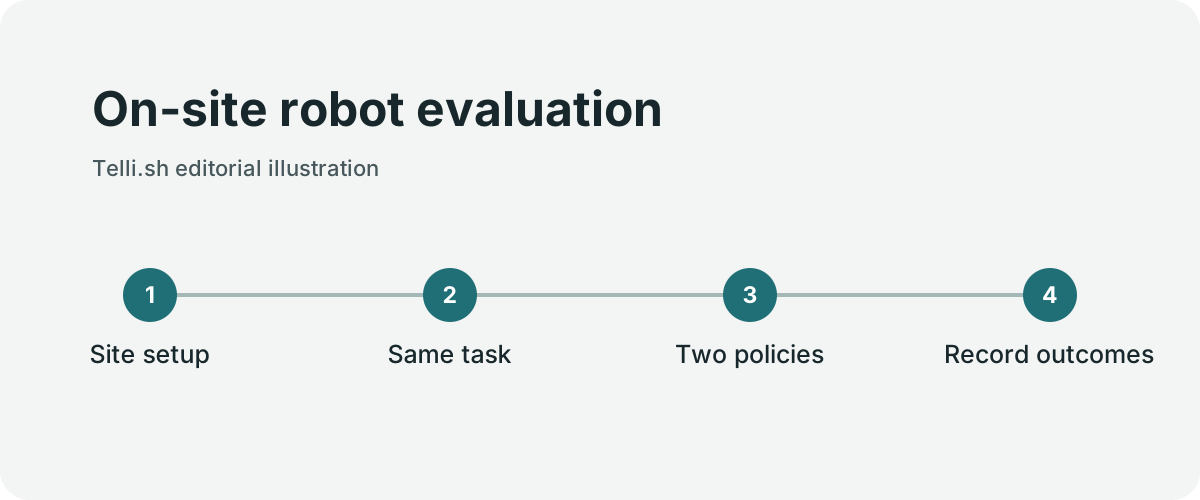
Ocena robota na miejscu. Autorska ilustracja Telli.sh.
Polityka sterowania może działać dobrze dla określonego robota, położenia czujnika i zadania. Wystarczy zmienić chwytak lub miejsce, w którym przedmioty trafiają na stanowisko, by o powodzeniu zdecydowała inna umiejętność. Dostrojona polityka różni się też od tej używanej bez zmian po instalacji. Jej skuteczność zależy od otrzymanych demonstracji i procesu adaptacji.
Badanie porównuje polityki w dopasowanych warunkach lokalnych. W ścieżce otwartej oceniający porównują próby wykonania tego samego zadania, nie wiedząc, który model stoi za daną próbą. Ścieżka dostrajania używa bardziej kontrolowanego zestawu zadań i demonstracji. Pozwala to oddzielić zachowanie po otrzymaniu nowego polecenia od tego, jak dobrze polityka dostosowuje się na podstawie przykładów.
| Czego dotyczy wynik | Co zespół wdrożeniowy nadal powinien wiedzieć |
|---|---|
| Jednej platformy robotycznej | Czy jej sprzęt i czujniki przypominają twoje |
| Jednego rozkładu zadań | Jakie przedmioty, układy i wyjątki obejmują zadania |
| Dostrojonej polityki | Jakich demonstracji, czasu i zasobów obliczeniowych użyto |
| Oceny preferencji lub postępu | Jak często pełny cykl kończy się bez interwencji |
| Jednego okresu oceny | Czy konfiguracja odpowiada wersji planowanej do wdrożenia |
Artykuł opisuje małą zgodność rankingów czterech platform w badaniu. Strona projektu może wymieniać szerszy i nowszy zestaw sprzętu używanego w ocenach. Przy objaśnianiu liczb trzymaj się zakresu badania. Bieżący wykaz publicznej platformy opisuje aktualną ofertę, a publikacja opisuje eksperyment w konkretnym momencie.
Obserwuj, jak dochodzi do niepowodzenia
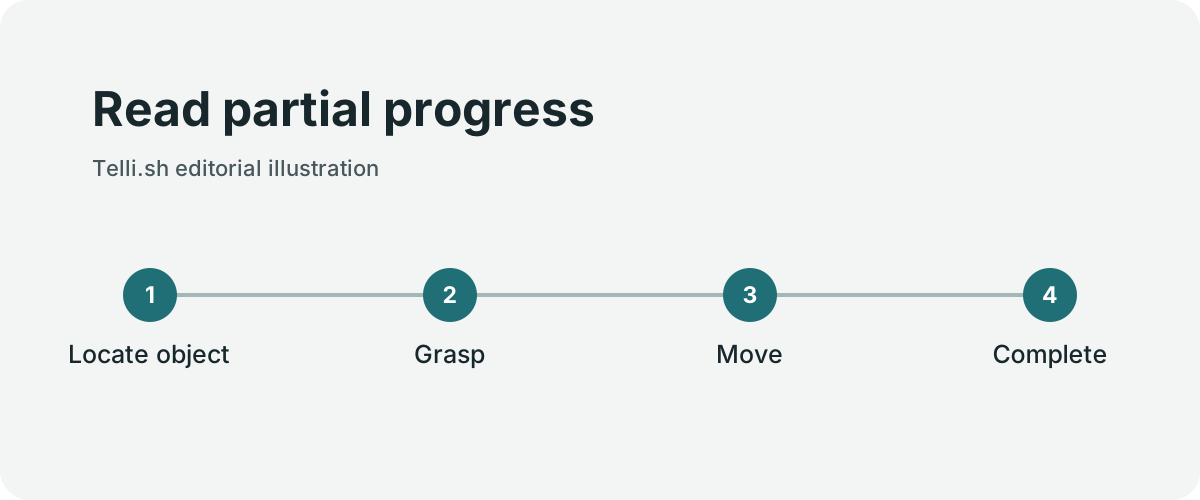
Ocena częściowego postępu. Autorska ilustracja Telli.sh.
Autorzy podają, że żadna z testowanych polityk nie ukończyła pięciu zadań ocenianych w konkretnej konfiguracji Unitree G1. Oceny postępu nadal się różniły. To przydatne rozróżnienie, gdy chcesz ustalić, czy model nie wykonuje już pierwszego kroku, czy zawodzi dopiero pod koniec. Dotyczy tych zadań i polityk w warunkach badania.
Wyobraź sobie sortowanie w pięciu etapach. Robot rozpoznaje przedmiot, zbliża się, chwyta, przenosi i odkłada we właściwe miejsce. Model, który regularnie dociera do odkładania, może być wart dalszej pracy, jeśli ostatni krok jest prosty. Jeśli w razie błędu upuszcza ciężki przedmiot, równie wysoka ocena postępu niewiele daje operatorom. Postęp częściowy wskazuje miejsce do zbadania. Konsekwencja fizyczna wskazuje, czy takie zachowanie można dopuścić na stanowisku.
Na krótkim pokazie ponowienie próby łatwo przeoczyć. Na obciążonej linii zabiera czas i może wymagać od człowieka przywrócenia ustawień stanowiska. Dziesięciosekundowy sukces połączony z minutą odzyskiwania w części cykli może dać gorszą przepustowość niż wolniejsza polityka wymagająca mniej interwencji. Mierz skuteczność i czas przywrócenia pracy przez wystarczającą liczbę cykli, by zaobserwować istotne przerwy.
Pomaga przegląd nagrań. Zachowaj klipy z prób ukończonych, częściowych oraz nieudanych z różnych powodów. Film ucięty tuż po chwycie może pomijać odłożenie. Osoba oceniająca pełną próbę potrafi odróżnić zakończone zadanie od obiecującego ruchu.
Pilotaż na stanowisku może skorzystać z metod badawczych
Pilotaż powinien zacząć się od pracy naprawdę potrzebnej na miejscu. Magazyn może sprawdzić mieszany pojemnik z błyszczącymi paczkami i sporadycznie zgniecionymi kartonami. Laboratorium może potrzebować sekwencji przekazywania małych narzędzi. Dokładny opis zadania, stanu początkowego i oczekiwanego wyniku ułatwia powtórzenie testu i wskazanie dostawcom obszarów do poprawy.
- Wybierz zadanie, którego ukończenie można zaobserwować. Zapisz ustawienie początkowe i warunek zakończenia. Uwzględnij reprezentatywne przedmioty i kilka trudnych, lecz prawidłowych przypadków.
- Zapisz robota, czujniki, efektor końcowy, warunki na miejscu i wersję polityki. Jeśli to możliwe, uruchom konkurencyjne polityki przy tym samym ustawieniu i poleceniach.
- Oddziel próbę bez adaptacji od próby po dostrojeniu. Zapisz liczbę demonstracji, ilość pracy potrzebnej do adaptacji i przykłady odłożone do testu.
- Obserwuj pełne ukończenie, postęp częściowy, czas i interwencje. Zachowaj w wynikach także próby, które kończą się przy przygotowaniu stanowiska lub wymagają jego ponownego ustawienia przez operatora.
- Powtórz test na zmianie lub w lokalizacji, gdzie różni się istotny warunek. Użyj na przykład innego zestawu przedmiotów lub zmierz zachowanie przy rozpoczęciu nieco poza środkiem.
- Oceń zabezpieczenia wdrożenia i bezpieczeństwo fizyczne z wykwalifikowanym personelem i według lokalnych procedur. Test badawczy mierzy zachowanie polityki. Ocena w miejscu pracy musi też obejmować ludzi i sprzęt w pobliżu robota.
Jeżeli zespoły oceniają różnice jakościowe, wypróbuj porównywanie zanonimizowanych nagrań parami. Przekaż oceniającym pisemną definicję dopuszczalnego zachowania i sposób zgłoszenia próby niebezpiecznej lub nieprzydatnej. Zachowaj metadane potrzebne do wyjaśnienia rozbieżności. Ukrycie pochodzenia wyniku ogranicza wpływ marki, a wspólne kryteria pomagają oceniać wyniki tak samo w różnych ośrodkach.
Porównaj metody obu ścieżek przed porównaniem polityk
Open Track i Fine-tune Track zadają pokrewne pytania, ale stosują inne plany eksperymentu. Według preprintu Open Track obejmuje 5 699 porównań parami w 124 ośrodkach. Taki test pokazuje, jak dwie polityki działają przy porównywalnym zadaniu i stanowisku. Nie wynika z tego, że każdy robot był testowany w każdym zadaniu w każdym ośrodku.
Fine-tune Track obejmuje w opisywanej ocenie 100 demonstracji na każde z 20 zadań. Autorzy podają, że Unitree G1 nie ukończył w pełni żadnego z pięciu ocenianych w tej ścieżce zadań, a średnie wyniki postępu wyniosły od 13,3% do 23,2%. Częściowe wyniki mówią o luce więcej niż samo zero w wyniku końcowym. Pokazują, że polityka może osiągać obserwowalny postęp według kryteriów oceny, choć nie kończy zadania.
Autorzy podają współczynnik zgodności Kendalla 0,24 dla rankingów postępu w czterech zestawach zadań przypisanych do sprzętu. To miara zgodności rankingów, a nie odsetek ukończonych zadań. Zestawy różnią się zarówno platformą, jak i zadaniami oraz warunkami. Niska zgodność uzasadnia lokalne sprawdzenie wybranej kombinacji. Nie pozwala uznać konstrukcji robota za jedyną przyczynę różnic w rankingu.
Dopasuj do siebie dwie zmiany w teście terenowym
Załóżmy, że centrum dystrybucyjne chce przenosić tę samą wkładkę opakowania z tacki do kartonu na dwóch zmianach. Operatorzy zauważają, że wieczorna zmiana dostaje inne tacki i ma mniej naturalnego światła. Przeprowadź próbę obu polityk w obu warunkach, zamiast przenosić ją do uporządkowanego laboratorium. Zmieniaj kolejność w obrębie każdej zmiany, aby rozładowująca się bateria, przesunięty uchwyt lub wprawa operatora nie pomagały stale jednemu kandydatowi.
Zapisz położenie początkowe przedmiotu, dopuszczalne ustawienia czujników lub oświetlenia, sposób interwencji pracownika i definicję prawidłowego odłożenia. Zachowaj nagrania nieudanych prób i notatki o interwencjach. Jeśli jedna polityka poprawia się dopiero po przestawieniu tacki, ta interwencja może być ważniejsza dla wdrożenia niż końcowa średnia. Obserwacja może prowadzić do zmiany mocowania lub lepszego doboru przypadków w kolejnym teście.
Dobra karta oceny przyznaje punkty częściowe za widoczne etapy. Chwytak, który znajduje właściwą wkładkę, lecz nie umie jej podnieść, wymaga innej poprawki niż chwytak, który ją podnosi i nie trafia do kartonu. Użyj prostych definicji etapów, aby dwie osoby oceniły tę samą próbę spójnie. Dodaj osobną kategorię bezpiecznego zatrzymania. Przerwanie pracy, gdy ktoś wchodzi na stanowisko, może być poprawnym zachowaniem mimo nieukończenia zadania.
Ustal, jakie dowody pozwalają przejść dalej
Udany pokaz w laboratorium może uzasadnić próbę na miejscu, a udana próba terenowa dłuższy pilotaż. Każdy etap ma własny próg akceptacji. Zespół zakupowy może poprosić o powtarzalność na dwóch typowych zmianach przed rozmową o rozszerzeniu na mniej przewidywalny obszar. Badacz może poprosić o etykiety niepowodzeń i warunki powtórzeń przed stwierdzeniem, że politykę udało się przenieść.
Gdy wyniki się rozchodzą, zapisz, co zmieniło się w warunkach i które działanie zawiodło. Odwrócenie kolejności może ujawnić zadanie, którego pierwotny test nie reprezentował. Pomoże to ustalić, czy potrzebny jest inny robot, inna polityka, zmienione stanowisko czy po prostu bardziej reprezentatywny test.
Przyjrzyj się zmianom kolejności w publikacji
Fine-tune Track pokazuje konkretne przykłady zmian w rankingach czterech zestawów zadań. π0.5 zajmuje pierwsze miejsce w rankingu postępu dla Franka i Bimanual-YAM, a czwarte na G1. GR00T N1.7 prowadzi w zestawie dla SO-101, ale jest czwarty na Franka i Bimanual-YAM. Wyniki odnoszą się do opisanych zestawów i przyjętej miary postępu. Zespół zakupowy może potraktować tę kolejność jako przykład zmian rankingu wraz z zadaniami, warunkami i sprzętem.
Publikacja bada też aktywny wybór porównań. W analizie około 400–500 adaptacyjnie wybranych ocen dało około 90% zgodności z rankingiem na pełnych danych, wobec około 1 000 przy wyborze równomiernym. Wynik dotyczy tego planu oceny. Podsuwa pomysł do lokalnego pilotażu. Poświęć więcej powtórzeń przypadkom, w których trudno rozróżnić najlepszych kandydatów, zachowując stałe minimum reprezentatywnych prób.
Zakład może rozdzielić pierwszą rundę od rundy adaptacyjnej. W pierwszej daj obu kandydatom te same zadania i te same zasady interwencji. W drugiej powtórz warunki, dla których dowody są niejednoznaczne. Zachowaj pierwotne kryterium akceptacji. Jeśli jakieś ustawienie wykluczono z powodów bezpieczeństwa lub praktycznych, zapisz powód. W raporcie końcowym powinno dać się wyjaśnić, jak dodatkowe próby wpłynęły na decyzję.
Zdobądź informacje o najważniejszych zadaniach
Rozproszone oceny obejmują różnorodne warunki, które trudno odtworzyć w pojedynczym laboratorium. Lokalny pilotaż daje szczegółowe informacje o zadaniach twojego zespołu. Te podejścia dobrze się uzupełniają. Użyj szerokich danych, by znaleźć obiecujących kandydatów, a własny test zaprojektuj tak, by ujawnić wyjątki decydujące o przydatności systemu.
Najcenniejsze porównanie możesz powtórzyć po zmianie polityki lub sprzętu. Zachowaj opis zadania, konfigurację i przykłady błędów obok wyniku. Gdy ranking się zmieni, będziesz wiedzieć wystarczająco dużo, by ocenić, czy zmiana pomaga w twojej pracy.
Źródła
Jeśli chcesz przechowywać rozmowy i decyzje związane z pracą w formie, którą można przeszukiwać, załóż konto Telli.sh.