Il robot che vince in video può perdere sul tuo banco di lavoro
Le valutazioni distribuite di RoboColosseum su robot fisici mostrano come le prestazioni cambino con hardware, attività e fine-tuning. Progetta una prova intorno al lavoro che ti serve.
Due bracci robotici sembrano ugualmente convincenti in video. Uno perde la presa su un contenitore che non conosce. L’altro lo afferra bene ma lo posa nel contenitore sbagliato. Un team operativo che deve scegliere ha bisogno di capire quali errori si verificano sulla propria linea e quanto lavoro richiede il recupero.
RoboColosseum è un progetto di ricerca che confronta strategie di controllo, o policy, su robot fisici in siti distribuiti. Nella versione arXiv del 2 novembre, gli autori riportano 5.699 confronti a coppie in 124 siti. Rilevano poco accordo fra le classifiche di robot con configurazioni fisiche diverse e osservano che il fine-tuning può cambiare le prestazioni relative. Chi acquista o fa ricerca può usare questi risultati per progettare una valutazione migliore prima di decidere sulla base dei video.
Un Unitree G1 a sinistra, una delle piattaforme valutate, al Japan Mobility Show 2025. Foto di RuinDig/Yuki Uchida, ridimensionata, CC BY 4.0. Fonte dell’immagine · Licenza.

Una classifica riguarda un robot, un compito e un ambiente
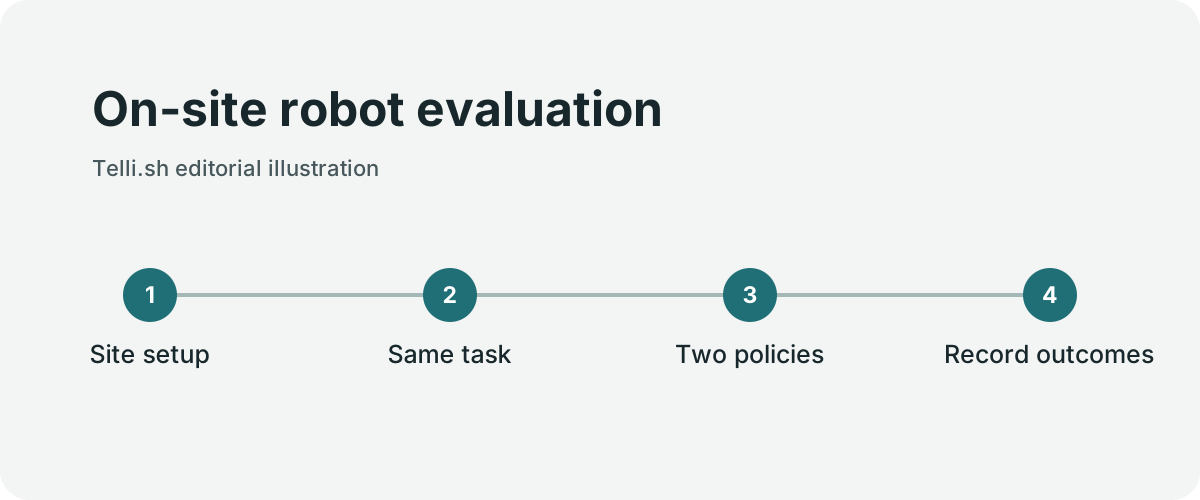
Valutazione del robot sul posto. Illustrazione originale di Telli.sh.
Una policy può funzionare bene con una certa combinazione di robot, posizione dei sensori e compito. Cambia la pinza o il punto da cui gli oggetti entrano nell’area e può diventare decisiva un’abilità diversa. Anche una policy sottoposta a fine-tuning ha caratteristiche diverse da una usata senza modifiche. Le sue prestazioni dipendono dalle dimostrazioni e dal processo di adattamento.
Lo studio confronta le policy a parità di condizioni locali. Nell’Open Track, chi valuta confronta tentativi sullo stesso compito senza sapere quale modello li ha prodotti. Il percorso di fine-tuning usa un insieme più controllato di attività e dimostrazioni. Le due prove aiutano a capire che cosa accade davanti a una nuova istruzione e come la policy si adatta quando riceve esempi.
| Che cosa descrive un risultato | Che cosa deve ancora sapere il team |
|---|---|
| Una configurazione fisica del robot | Se hardware e sensori sono simili ai propri |
| Una distribuzione di compiti | Quali oggetti, disposizioni ed eccezioni contiene |
| Una policy sottoposta a fine-tuning | Quali dimostrazioni, tempo e risorse di calcolo sono serviti |
| Un giudizio di preferenza o di avanzamento | Quanto spesso si completa un ciclo senza interventi |
| Un periodo di valutazione | Se la configurazione corrisponde alla versione da mettere in servizio |
Il lavoro riporta poco accordo nelle classifiche fra quattro configurazioni fisiche considerate nello studio. Il sito del progetto può elencare un insieme di hardware attivo più ampio e recente. Quando spieghi i numeri, mantieni il perimetro dello studio. L’inventario attuale di una piattaforma pubblica descrive ciò che offre oggi, mentre un articolo scientifico descrive l’esperimento di un dato momento.
Osserva come si sviluppa un errore
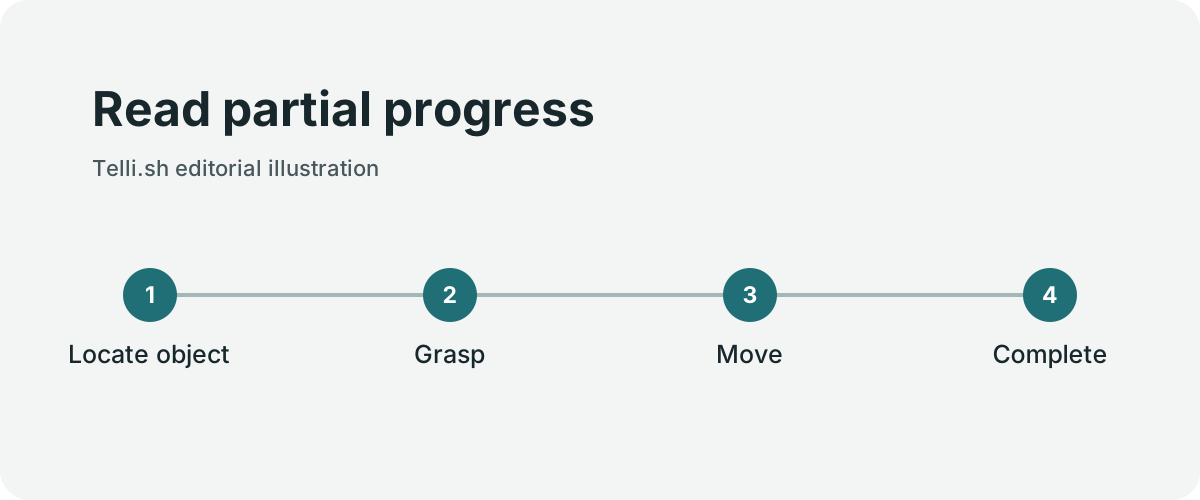
Lettura dell’avanzamento parziale. Illustrazione originale di Telli.sh.
Lo studio riferisce che nessuna policy provata ha completato i cinque compiti valutati su una specifica configurazione di Unitree G1. I punteggi di avanzamento differivano comunque. La distinzione aiuta a capire se un modello sbaglia il primo passo o si ferma vicino alla fine. Riguarda quei compiti e quelle policy nelle condizioni dello studio.
Immagina uno smistamento con cinque tappe. Il robot identifica l’oggetto, si avvicina, lo afferra, lo sposta e lo rilascia nel punto giusto. Può valere la pena migliorare un modello che raggiunge regolarmente il rilascio, se quell’ultimo passaggio è semplice. Se l’errore comporta la caduta di un oggetto pesante, lo stesso punteggio alto rassicura poco sul piano operativo. L’avanzamento parziale dice dove indagare. La conseguenza fisica dice se quel comportamento è accettabile sul lavoro.
In una breve dimostrazione è facile trascurare un nuovo tentativo. Su una linea affollata, riprovare richiede tempo e può servire una persona per riallestire l’area. Un successo in dieci secondi seguito, in alcuni cicli, da un minuto di ripristino può dare una produttività peggiore di una policy più lenta ma con meno interventi. Misura successi e tempi di recupero su un numero di cicli sufficiente a osservare le interruzioni importanti.
La revisione visiva è utile. Conserva i filmati di un campione di successi completi, tentativi parziali ed errori con cause diverse. Un video che finisce subito dopo la presa può escludere il rilascio. Chi vede il tentativo intero può distinguere un lavoro completato da un movimento promettente.
Una prova sul campo può imparare dal confronto di ricerca
La prova dovrebbe partire da ciò che serve davvero al sito. In un magazzino può contare una cassetta con confezioni riflettenti e occasionali scatole schiacciate. In un laboratorio può contare una sequenza di passaggi di piccoli strumenti. Compito, condizione iniziale e risultato atteso rendono il test ripetibile e aiutano i fornitori a capire dove intervenire.
- Scegli un compito il cui successo sia osservabile. Annota la disposizione iniziale e la condizione finale. Includi oggetti rappresentativi e qualche caso difficile ma legittimo.
- Registra robot, sensori, organo terminale, condizioni del sito e versione della policy. Se possibile, esegui policy concorrenti con lo stesso allestimento locale e le stesse istruzioni.
- Separa un’esecuzione senza modifiche da una dopo l’adattamento. Registra il numero di dimostrazioni e il lavoro richiesto, oltre agli esempi tenuti fuori.
- Osserva successi completi, avanzamento parziale, tempo e interventi. Registra anche i tentativi che falliscono durante la preparazione o richiedono il ripristino da parte di un operatore.
- Ripeti il test in un turno o in un luogo che modifichi una condizione importante. Per esempio, cambia l’insieme di oggetti in arrivo o misura il comportamento quando il compito parte leggermente decentrato.
- Valuta i controlli di messa in servizio e la sicurezza fisica con personale qualificato e procedure locali. Il benchmark misura il comportamento della policy. In un luogo di lavoro bisogna considerare anche le persone e le attrezzature vicino al robot.
Se i team devono giudicare differenze qualitative, prova a far confrontare a coppie filmati anonimizzati. Dai ai revisori una definizione scritta del comportamento accettabile e un modo per segnalare tentativi pericolosi o inutilizzabili. Conserva metadati sufficienti a capire i disaccordi. Una prova in cieco può ridurre la preferenza per un marchio, e un criterio comune aiuta persone in siti diversi a valutare allo stesso modo gli stessi esiti.
Confronta i percorsi di prova prima delle policy
Open Track e Fine-tune Track pongono domande simili con disegni sperimentali diversi. Nella prestampa, l’Open Track comprende 5.699 confronti a coppie in 124 siti. Una prova a coppie può mostrare come si comportano due policy quando compito e sito sono comparabili. Da quel numero non segue che ogni robot sia stato provato su ogni attività in tutti i siti.
Nella valutazione riportata dall’articolo, il Fine-tune Track usa 100 dimostrazioni per ciascuno di 20 compiti. Per i cinque compiti valutati su Unitree G1, gli autori riportano zero completamenti e punteggi medi di avanzamento dal 13,3% al 23,2%. I punteggi parziali offrono più informazioni di un semplice zero sul risultato finale. Mostrano che una policy può avanzare secondo i criteri di valutazione pur senza terminare il compito.
Gli autori riportano un coefficiente di concordanza di Kendall di 0,24 per le classifiche di avanzamento su quattro serie di compiti specifiche per hardware. Il coefficiente misura l’accordo fra classifiche. Le serie differiscono per configurazione fisica, compiti e condizioni. Il poco accordo è un motivo per verificare la combinazione scelta sul posto. Lo studio non isola la forma del robot come causa delle differenze.
Rendi comparabili due turni nella prova sul campo
Supponi che un centro di distribuzione voglia spostare lo stesso inserto da imballaggio da un vassoio a una scatola in due turni. Gli operatori notano che di sera arriva un vassoio diverso e c’è meno luce naturale. Esegui entrambe le policy in entrambe le condizioni, sul posto. Alterna l’ordine all’interno di ogni turno, così lo stato della batteria, un supporto spostato o la pratica dell’operatore non favoriscono sempre la stessa candidata.
Annota la posizione iniziale dell’oggetto, le impostazioni consentite per sensori e luci, il modo in cui deve intervenire l’operatore e che cosa conta come posizionamento riuscito. Conserva i video degli errori e le note sugli interventi. Se una policy migliora solo dopo aver spostato il vassoio, quell’intervento può contare più della media finale per la messa in servizio. Può portare a modificare il supporto o a scegliere casi migliori per la prova successiva.
Una scheda utile assegna credito parziale a fasi osservabili. Una pinza che trova l’inserto giusto ma non lo solleva richiede un intervento diverso da una che lo solleva e manca la scatola. Usa una definizione semplice per ogni tappa, così due revisori interpretano la stessa prova in modo coerente. Aggiungi una categoria separata per l’arresto sicuro. Un robot che si ferma quando un operatore entra nell’area può essersi comportato correttamente anche senza terminare il compito.
Decidi quali prove giustificano il passo successivo
Una demo riuscita in laboratorio può giustificare una prova sul posto, e una prova riuscita sul posto può giustificare un pilota più lungo. Ogni decisione ha una soglia di accettazione propria. Chi acquista può chiedere ripetibilità su due turni normali prima di discutere l’estensione a un’area meno prevedibile. Chi fa ricerca può chiedere etichette degli errori e condizioni ripetute prima di concludere che una policy si trasferisce a un nuovo ambiente.
Quando i risultati divergono, registra che cosa è cambiato e quale azione è andata male. Un’inversione di classifica può rivelare un compito assente nel benchmark iniziale. Il team può così decidere se servono un altro robot, una policy diversa, una cella di lavoro modificata o una prova più rappresentativa.
Leggi le inversioni di classifica nell’articolo
Il Fine-tune Track mostra esempi concreti di classifiche che cambiano fra le quattro serie di compiti. π0.5 è prima nella classifica di avanzamento su Franka e Bimanual-YAM e quarta su G1. GR00T N1.7 guida la serie SO-101 e si piazza quarta su Franka e Bimanual-YAM. Gli esiti riguardano quelle serie e il loro indicatore di avanzamento. Per chi deve acquistare, l’ordine mostra come una classifica possa cambiare con la combinazione di compiti, condizioni e hardware.
L’articolo studia anche la selezione attiva dei confronti da eseguire. Nell’analisi, circa 400–500 valutazioni scelte in modo adattivo raggiungono intorno al 90% di accordo con la classifica costruita su tutti i dati, rispetto a circa 1.000 con selezione uniforme. È un risultato di quel disegno sperimentale. Offre un’idea pratica per una prova locale. Dedica più ripetizioni ai casi in cui le candidate migliori sono difficili da distinguere, mantenendo un minimo fisso di casi rappresentativi.
Un impianto può separare una prima fase e una fase adattiva. Nella prima, assegna gli stessi compiti a entrambe le candidate con le stesse regole di intervento. Nella seconda, ripeti le condizioni per le quali i primi dati sono discordanti. Mantieni il criterio di accettazione iniziale. Se escludi una condizione per sicurezza o praticità, annota il motivo. Il rapporto finale dovrebbe spiegare come le prove aggiuntive hanno cambiato la decisione.
Investi in informazioni sui compiti che contano davvero
Le valutazioni distribuite possono raccogliere condizioni difficili da riprodurre in un solo laboratorio. Una prova locale approfondisce il lavoro di cui risponde il tuo team. I due approcci si completano. Usa i dati più ampi per trovare candidate promettenti e progetta una valutazione tua per scoprire le eccezioni che decidono se il sistema sarà utile.
Il confronto più solido è quello che il team sa ripetere dopo una nuova policy o un cambio di hardware. Conserva il compito, la configurazione e gli esempi di errore con il punteggio. Quando cambia la classifica, avrai elementi per decidere se il cambiamento migliora il lavoro.
Fonti
Per conservare e ritrovare le conversazioni e le decisioni che accompagnano il tuo lavoro, crea un account Telli.sh.