Le gagnant d’une démonstration robotique peut perdre sur votre poste de travail
Les évaluations distribuées de RoboColosseum sur des robots réels montrent comment les performances changent avec le matériel, les tâches et l’affinage. Construisez un essai autour du travail que vous devez réaliser.
Deux bras robotisés sont aussi convaincants l’un que l’autre en vidéo. Le premier glisse sur un contenant inhabituel. Le second le saisit correctement et le dépose dans le mauvais bac. L’équipe qui doit les départager a besoin de savoir quelles erreurs surviennent sur sa ligne et ce qu’il faut faire pour reprendre le travail.
RoboColosseum est un projet de recherche qui compare des politiques de commande sur du matériel physique réparti sur plusieurs sites d’évaluation. Dans la version arXiv du 2 novembre, les auteurs rapportent 5 699 comparaisons par paires sur 124 sites. Ils constatent une faible concordance des classements entre morphologies de robots et des changements de performance relative après affinage. Une personne chargée des achats ou de la recherche peut s’appuyer sur ce résultat pour concevoir une évaluation plus utile qu’une compilation de démonstrations.
Un Unitree G1 (à gauche), l’une des plateformes évaluées, au Japan Mobility Show 2025. Photo de RuinDig/Yuki Uchida, redimensionnée, CC BY 4.0. Source de l’image · Licence.

Un classement dépend du robot, de la tâche et du lieu
Évaluation robotique sur site. Illustration originale de Telli.sh.
Une politique de commande peut bien fonctionner avec un robot, une position des capteurs et une tâche donnés. Changez la pince ou la manière dont les objets entrent dans l’espace de travail, et la réussite peut dépendre d’une autre capacité. Une politique affinée présente aussi d’autres caractéristiques qu’une politique utilisée telle quelle. Ses performances dépendent des démonstrations et de la méthode d’adaptation.
L’étude compare les politiques dans les mêmes conditions locales. Dans le volet ouvert, les évaluateurs comparent des tentatives de la même tâche sans savoir quel modèle est à l’origine de chaque essai. Le volet d’affinage utilise un jeu de tâches et de démonstrations plus encadré. Il sépare ainsi deux questions. Que se passe-t-il avec une instruction nouvelle ? Dans quelle mesure la politique s’adapte-t-elle à partir d’exemples ?
| Ce que le résultat décrit | Ce que l’équipe de déploiement doit encore vérifier |
|---|---|
| Une morphologie de robot | La ressemblance de son matériel et de ses capteurs avec ceux du site |
| Une distribution de tâches | Les objets, agencements et exceptions représentés |
| Une politique affinée | Les démonstrations, le temps et le calcul nécessaires |
| Une préférence ou un jugement de progression | La fréquence des cycles complets sans intervention |
| Une période d’évaluation | La correspondance de la configuration avec la version à déployer |
Le papier relève une faible concordance des classements entre les quatre morphologies de l’étude. Le site du projet peut présenter une liste plus large et plus récente du matériel d’évaluation actif. Pour expliquer les chiffres, gardez le périmètre de l’étude. L’inventaire de la plateforme décrit ce qu’elle propose aujourd’hui, alors que le papier décrit une expérience à un moment donné.
Observez comment un échec se produit
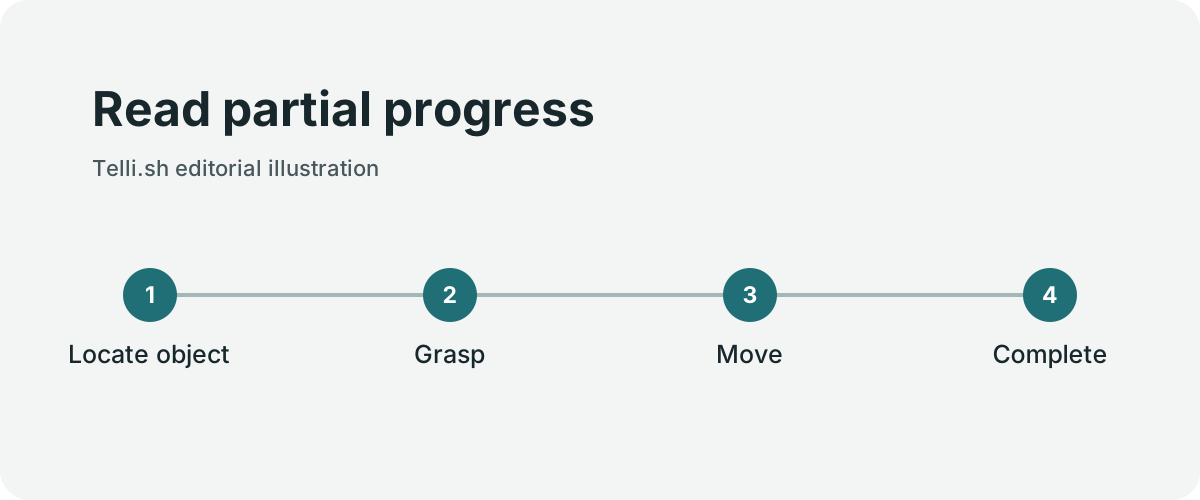
Évaluation de la progression partielle. Illustration originale de Telli.sh.
Selon l’étude, aucune des politiques testées n’a terminé les cinq tâches évaluées sur une configuration particulière du Unitree G1. Les scores de progression différaient malgré tout. Cette distinction aide à déterminer si un modèle rate la première étape ou échoue à la fin. Elle porte sur les tâches et les politiques évaluées dans les conditions de l’étude.
Imaginons une opération de tri en cinq étapes. Il faut identifier l’objet, l’approcher, le saisir, le déplacer et le déposer au bon endroit. Une politique qui arrive régulièrement à la dernière étape peut valoir un travail supplémentaire si le dépôt est simple à corriger. Si l’échec fait tomber un objet lourd, le même score élevé rassure peu dans l’atelier. La progression indique où chercher la cause. La conséquence physique indique si ce comportement est compatible avec le travail sur site.
Dans une courte démonstration, une nouvelle tentative passe facilement inaperçue. Sur une ligne active, elle prend du temps et peut demander à quelqu’un de remettre la scène en place. Une réussite en dix secondes suivie d’une remise en état d’une minute sur certains essais peut donner un débit inférieur à celui d’une politique plus lente mais qui nécessite moins d’interventions. Mesurez à la fois la réussite et le temps de récupération sur assez de cycles pour observer les interruptions qui comptent.
Les images aident à comprendre ce qui s’est passé. Conservez un échantillon de vidéos qui couvre les réussites complètes, les tentatives partielles et les différentes causes d’échec. Une vidéo qui s’arrête aussitôt après la prise peut omettre le dépôt. Une personne qui voit toute la tentative peut distinguer une opération terminée d’un mouvement prometteur.
Un essai sur site peut reprendre les principes du protocole de recherche
Commencez par une tâche dont le site a besoin. Un entrepôt peut choisir un bac mêlant des emballages réfléchissants et quelques cartons écrasés. Un laboratoire peut examiner une suite de transferts de petits outils. Décrire précisément la tâche, son état de départ et le résultat attendu rend le test reproductible et aide les fournisseurs à comprendre quoi améliorer.
- Choisissez une tâche dont vous pouvez observer l’achèvement. Consignez la disposition initiale et la condition de réussite. Incluez des objets représentatifs et quelques cas difficiles mais légitimes.
- Notez le robot, les capteurs, l’outil terminal, les conditions du site et la version de la politique. Quand c’est possible, testez les politiques concurrentes avec la même installation et les mêmes instructions.
- Distinguez un essai sans adaptation d’un essai après adaptation. Consignez le nombre de démonstrations, le travail requis et les exemples laissés de côté.
- Relevez les réussites complètes, les progrès partiels, la durée et les interventions. Conservez dans le dossier les essais qui échouent à la mise en place ou demandent une réinitialisation manuelle.
- Répétez l’essai pendant une autre équipe ou à un autre endroit où une condition change. Utilisez par exemple une autre combinaison d’objets ou vérifiez le comportement lorsque le point de départ est légèrement décentré.
- Évaluez les contrôles de déploiement et la sécurité physique avec du personnel qualifié et selon les procédures locales. Le benchmark mesure le comportement de la politique. L’évaluation en milieu de travail doit aussi tenir compte des personnes et des équipements près du robot.
Lorsque les équipes jugent des différences qualitatives, elles peuvent examiner des vidéos anonymisées par paires. Donnez aux évaluateurs une définition écrite du comportement acceptable et un moyen de signaler les tentatives dangereuses ou inutilisables. Conservez des métadonnées pour comprendre les désaccords. Le fait de masquer le modèle peut limiter les préférences de marque. Une grille commune permet à différents sites d’évaluer les mêmes résultats de manière comparable.
Comparez les volets avant de comparer les politiques
L’Open Track et le Fine-tune Track posent des questions voisines au moyen de protocoles distincts. Le préprint attribue à l’Open Track 5 699 comparaisons par paires sur 124 sites. Un essai par paires permet d’observer les deux politiques dans des tâches et des lieux comparables. Il ne signifie pas que chaque robot a réalisé chaque tâche sur chaque site.
Le Fine-tune Track utilise 100 démonstrations par tâche sur 20 tâches dans l’évaluation rapportée. Les auteurs indiquent qu’aucune des cinq tâches n’a été terminée avec le Unitree G1 et que les scores moyens de progression allaient de 13,3 % à 23,2 %. Les scores partiels précisent l’écart qu’un zéro global ne décrit pas. Une politique peut avancer de manière observable dans la grille d’évaluation sans terminer la tâche.
Les auteurs donnent un coefficient de concordance de Kendall de 0,24 pour les classements de progression dans quatre séries de tâches propres à chaque matériel. Il mesure l’accord entre classements, indépendamment du nombre de tâches terminées. Les séries diffèrent à la fois par la morphologie et par les tâches et les conditions. Ce faible accord donne une raison de valider la combinaison localement. Il ne permet pas d’isoler la forme du robot comme cause des écarts.
Comparez les deux équipes dans un essai de terrain
Supposons qu’un centre de distribution veuille déplacer le même insert d’emballage d’un plateau vers un carton pendant deux plages de travail. Le personnel remarque que l’équipe du soir reçoit un plateau différent et dispose de moins de lumière naturelle. Testez les deux politiques dans les deux conditions. Alternez l’ordre à chaque plage pour éviter qu’une batterie en fin de charge, un support déplacé ou l’habitude de l’opérateur favorise toujours la même politique.
Consignez la position initiale de l’objet, les réglages de capteurs et d’éclairage autorisés, la procédure d’intervention et ce qui constitue un dépôt réussi. Conservez les vidéos des échecs et les notes d’intervention. Si une politique s’améliore seulement après un déplacement du plateau, cet ajustement peut compter plus pour le déploiement que la moyenne finale. L’observation peut conduire à modifier le support ou à choisir de meilleurs cas pour le prochain essai.
Une grille utile attribue des points partiels à des étapes observables. Une pince qui trouve le bon insert sans le soulever exige un autre travail qu’une pince qui le soulève mais manque le carton. Définissez simplement chaque étape pour que deux évaluateurs comprennent l’essai de la même façon. Prévoyez une catégorie séparée pour un arrêt de sécurité. Si le robot s’arrête parce qu’une personne entre dans la zone, le comportement peut être correct même si la tâche n’est pas terminée.
Déterminez quelles preuves justifient l’étape suivante
Une démonstration réussie en laboratoire peut justifier un essai sur site, puis un essai concluant peut justifier un pilote plus long. Chaque décision a son propre seuil d’acceptation. Les achats peuvent demander des résultats reproductibles sur deux plages courantes avant d’envisager une zone moins prévisible. Les chercheurs peuvent demander les catégories d’échec et les conditions de répétition avant d’affirmer que la politique se transfère.
Si les résultats divergent, consignez ce qui a changé entre les environnements et l’action qui a échoué. Une inversion du classement peut faire apparaître une tâche absente du benchmark initial. Cette information aide l’équipe à choisir entre un autre robot, une autre politique, une cellule modifiée ou un essai plus représentatif.
Le papier montre des inversions de classement
Le Fine-tune Track donne des exemples dans les quatre séries de tâches. π0.5 arrive premier pour la progression sur Franka et Bimanual-YAM, et quatrième sur G1. GR00T N1.7 arrive en tête sur SO-101 et quatrième sur Franka et Bimanual-YAM. Ces résultats concernent les séries et la mesure de progression du papier. Les achats peuvent y voir un exemple de classement qui se déplace avec les tâches, les conditions et le matériel.
Le papier étudie aussi la sélection active des comparaisons. Dans cette analyse, environ 400 à 500 évaluations choisies de façon adaptative atteignent près de 90 % de concordance avec le classement issu de toutes les données. Il faut environ 1 000 évaluations pour atteindre ce niveau avec une sélection uniforme. Le résultat porte sur ce protocole. Pour un pilote local, l’idée est de consacrer davantage d’essais aux cas difficiles à départager, tout en gardant un minimum fixe de cas représentatifs.
Un site peut séparer un premier tour d’un tour adaptatif. Au premier, donnez les mêmes tâches aux deux candidats et appliquez les mêmes règles d’intervention. Au second, reprenez les conditions dans lesquelles les premiers résultats sont partagés. Conservez le critère d’acceptation initial. Si un cas a été exclu pour des raisons de sécurité ou de faisabilité, consignez le motif. Le rapport doit expliquer comment les essais supplémentaires ont changé la décision.
Cherchez des preuves sur les tâches qui comptent le plus
Les évaluations distribuées peuvent couvrir des conditions qu’un seul laboratoire reproduit difficilement. Un pilote local apporte des détails sur les tâches dont votre équipe est responsable. Les méthodes se complètent. Utilisez les résultats généraux pour repérer des candidats prometteurs, puis concevez vos propres essais pour découvrir les exceptions qui déterminent si le système est utile.
La comparaison la plus solide est celle que votre équipe peut refaire après une nouvelle politique ou un changement de matériel. Conservez la tâche, la configuration et les exemples d’échec avec le score. Si le classement bouge, vous disposerez d’assez d’éléments pour déterminer si ce changement améliore votre travail.
Sources
Pour retrouver facilement la trace des conversations et décisions liées à votre travail, créez un compte Telli.sh.