El robot que gana una demostración puede perder en tu puesto de trabajo
Las evaluaciones distribuidas de RoboColosseum con robots reales muestran cómo cambia el rendimiento según el hardware, la tarea y el ajuste fino. Diseña una prueba piloto para el trabajo que necesitas.
Dos brazos robóticos resultan igual de convincentes en vídeo. Uno resbala al coger un recipiente poco habitual. El otro lo sujeta bien y lo deja en el contenedor equivocado. El equipo que debe elegir entre los dos necesita saber qué fallos ocurren en su propia línea y qué exige retomar el trabajo.
RoboColosseum es un proyecto de investigación que compara políticas de control en robots físicos repartidos entre distintos centros. En la versión de arXiv del 2 de noviembre, los autores presentan 5.699 comparaciones por pares en 124 centros. Encuentran poca coincidencia entre las clasificaciones de distintas configuraciones físicas y observan que el rendimiento relativo puede cambiar tras el ajuste fino. Compradores e investigadores pueden usar esos resultados para diseñar una evaluación más informativa que una recopilación de demostraciones.
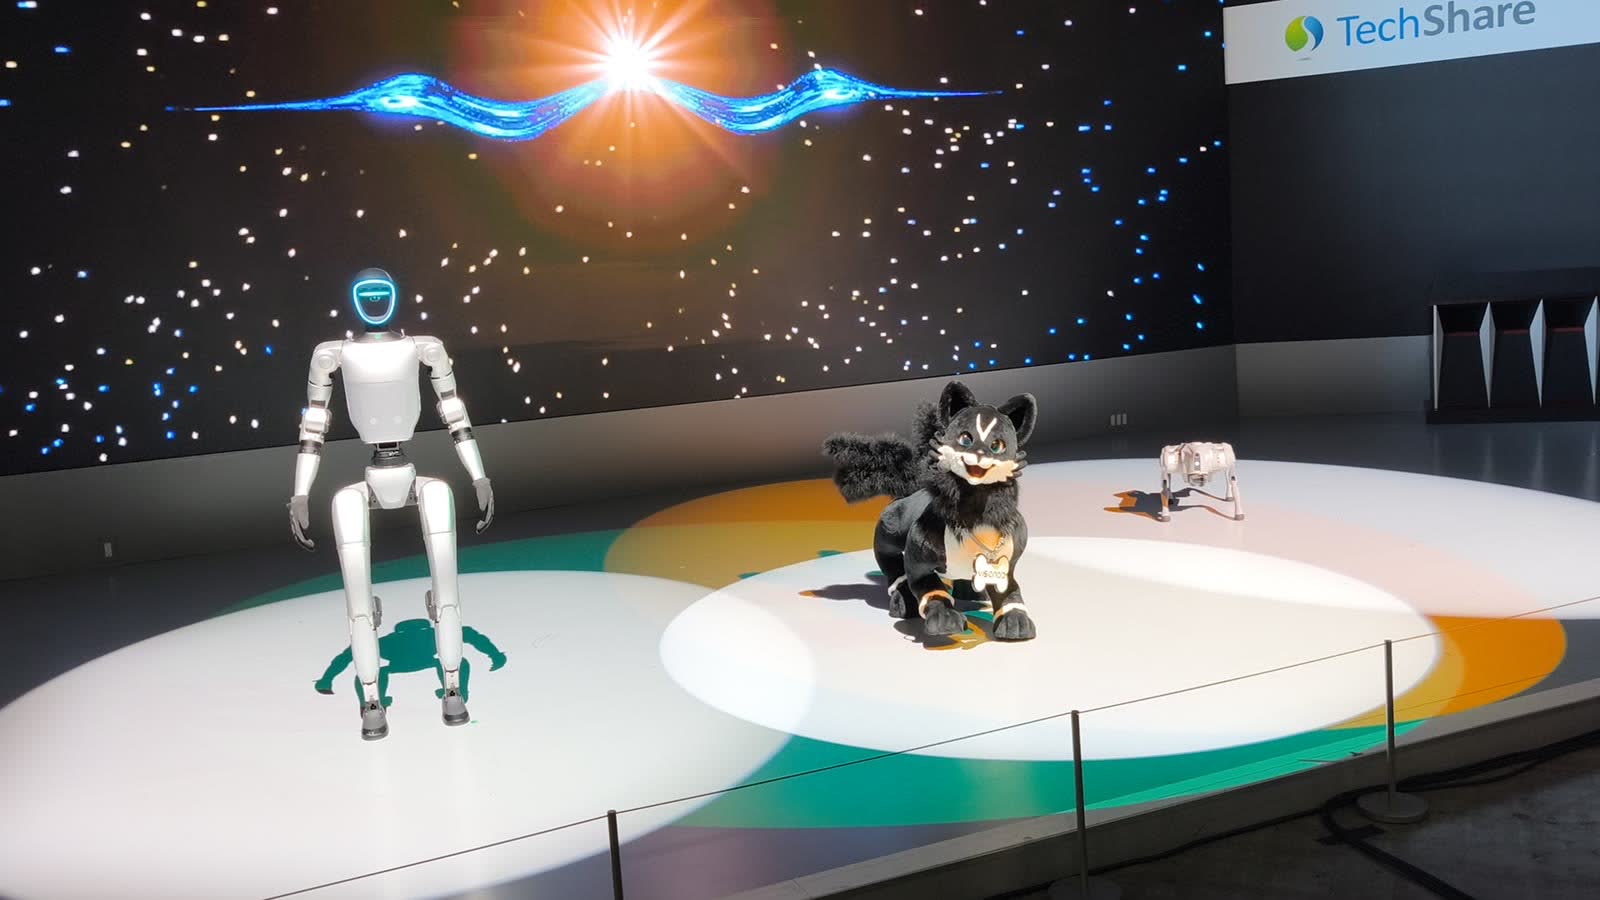
Un Unitree G1 (a la izquierda), una de las plataformas robóticas evaluadas, en el Japan Mobility Show 2025. Foto de RuinDig/Yuki Uchida, redimensionada, CC BY 4.0. Fuente de la imagen · Licencia.

Cada clasificación depende de un robot, una tarea y un entorno
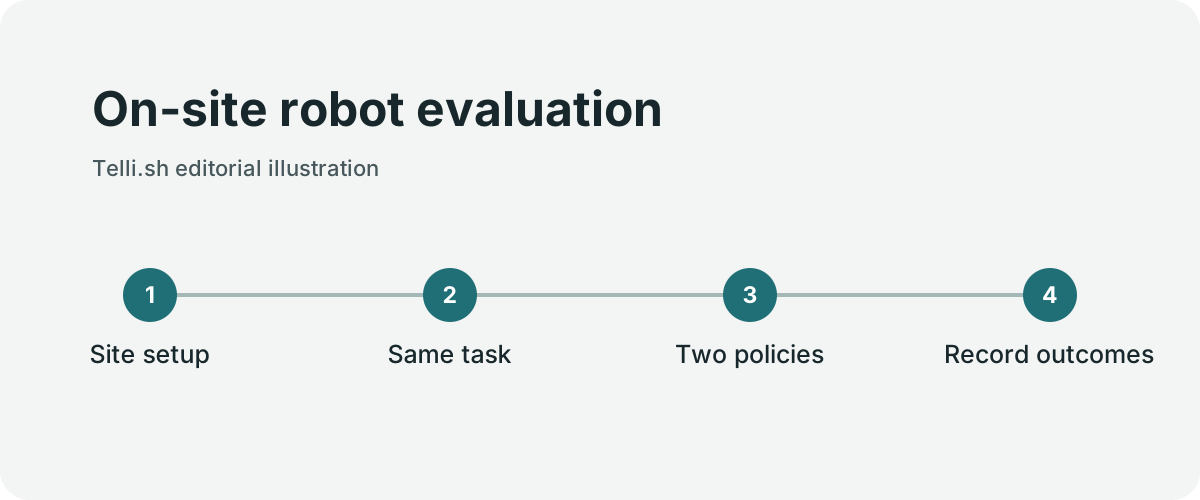
Evaluación robótica en el lugar de trabajo. Ilustración original de Telli.sh.
Una política puede funcionar bien con cierta combinación de robot, posición de los sensores y tarea. Cambiar la pinza o el modo en que entran los objetos en el espacio de trabajo puede hacer que el éxito dependa de otra habilidad. Una política ajustada también difiere de otra que se usa tal como viene. Su rendimiento depende de las demostraciones y del proceso de adaptación.
El estudio compara políticas en las mismas condiciones locales. En la modalidad abierta, el personal evaluador compara intentos de la misma tarea sin saber qué modelo produjo cada uno. La modalidad de ajuste fino usa un conjunto más controlado de tareas y demostraciones. Así separa dos preguntas. ¿Qué ocurre con una instrucción nueva? ¿Cómo se adapta la política cuando recibe ejemplos?
| Qué describe un resultado | Qué debe comprobar aún el equipo de despliegue |
|---|---|
| Una configuración física de robot | Si su hardware y sus sensores se parecen a los propios |
| Una distribución de tareas | Qué objetos, disposiciones y excepciones aparecen |
| Una política ajustada | Qué demostraciones, tiempo y cómputo requirió |
| Una preferencia o valoración del progreso | Con qué frecuencia se completa un ciclo sin intervención |
| Un periodo de evaluación | Si la configuración coincide con la versión que se va a desplegar |
El artículo informa de poca concordancia entre las clasificaciones de las cuatro configuraciones físicas estudiadas. La web del proyecto puede enumerar un conjunto más amplio y reciente de hardware de evaluación activo. Al explicar las cifras, mantén el alcance del estudio. El inventario actual de la plataforma muestra lo que ofrece hoy. El artículo describe un experimento en un momento concreto.
Observa cómo se produce un fallo
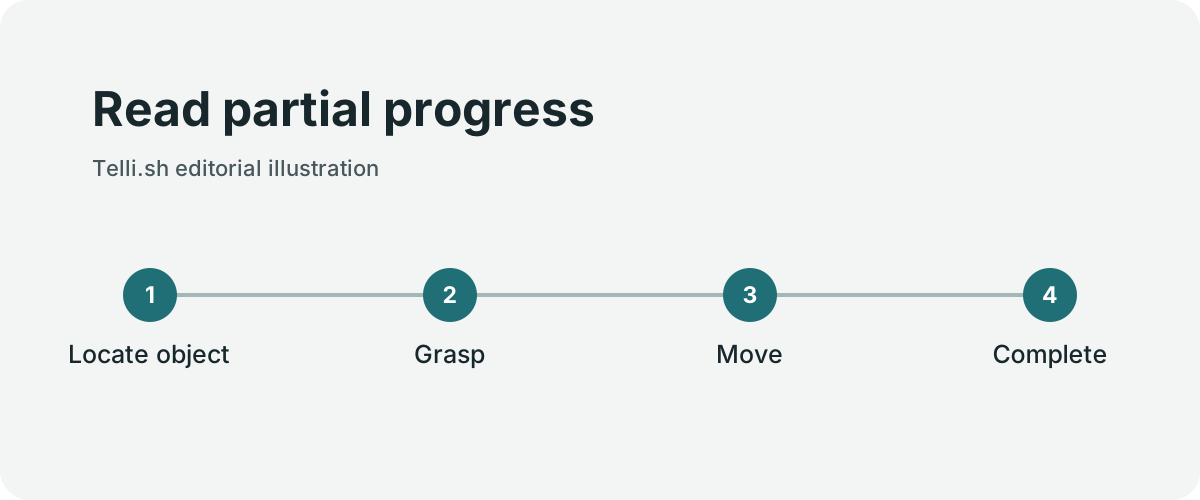
Lectura del progreso parcial. Ilustración original de Telli.sh.
Según el estudio, ninguna política probada completó las cinco tareas evaluadas en una configuración concreta del Unitree G1. Las puntuaciones de progreso sí variaron. Esa diferencia permite saber si un modelo se atasca en el primer paso o falla cerca del final. El resultado corresponde a las tareas y políticas probadas en las condiciones del estudio.
Imagina una tarea de clasificación con cinco etapas. Hay que identificar el objeto, acercarse, agarrarlo, moverlo y soltarlo en el lugar correcto. Puede merecer la pena mejorar un modelo que llega al paso de soltar el objeto con regularidad si lo que falta es sencillo. Si el fallo provoca que caiga un objeto pesado, esa misma puntuación alta tranquiliza poco. El progreso parcial indica dónde investigar. La consecuencia física indica si ese comportamiento tiene cabida en el lugar de trabajo.
En una demostración breve es fácil pasar por alto un reintento. En una línea ocupada lleva tiempo y puede exigir que alguien restablezca el montaje. Un éxito en diez segundos con un minuto de recuperación en algunos intentos puede dar menos rendimiento que una política más lenta con menos intervenciones. Mide tanto el éxito como el tiempo de recuperación durante suficientes ciclos para observar las interrupciones relevantes.
La revisión visual ayuda a entender qué ocurrió. Guarda vídeos de una muestra de éxitos completos, avances parciales y fallos de distinta causa. Un vídeo que termina justo después de agarrar el objeto puede omitir el momento de soltarlo. Quien ve todo el intento puede distinguir un trabajo terminado de un movimiento prometedor.
Una prueba de campo puede aprender del diseño de la investigación
Una prueba piloto debe empezar por un trabajo que el centro necesite de verdad. Un almacén quizá quiera probar un contenedor mixto con envases reflectantes y alguna caja aplastada. Un laboratorio podría examinar una secuencia de traspasos de herramientas pequeñas. La tarea exacta, el estado inicial y el resultado esperado hacen reproducible la prueba y ayudan a los proveedores a saber qué mejorar.
- Elige una tarea cuyo éxito puedas observar. Anota la disposición inicial y la condición de finalización. Incluye objetos representativos y varios casos difíciles pero legítimos.
- Registra el robot, los sensores, el efector final, las condiciones del centro y la versión de la política. Cuando sea posible, ejecuta las políticas rivales con el mismo montaje y las mismas instrucciones.
- Separa la ejecución sin adaptación de la que se realiza después. Registra cuántas demostraciones y cuánto trabajo exigió la adaptación, y qué ejemplos se reservaron.
- Observa los éxitos completos, el progreso parcial, la duración y las intervenciones. Conserva los intentos que fallan durante la preparación o necesitan que alguien restablezca el montaje.
- Repite la prueba en un turno o lugar con una condición relevante distinta. Por ejemplo, usa otra combinación de objetos entrantes o mide qué ocurre cuando la tarea empieza ligeramente descentrada.
- Evalúa los controles del despliegue y la seguridad física con personal cualificado y según los procedimientos locales. La prueba de investigación mide el comportamiento de la política. En el trabajo también cuentan las personas y los equipos que rodean al robot.
Si el equipo valora diferencias cualitativas, puede revisar vídeos anonimizados por pares. Da a quienes evalúan una definición escrita del comportamiento aceptable y una manera de marcar intentos peligrosos o inutilizables. Conserva metadatos suficientes para entender después los desacuerdos. Ocultar el modelo puede reducir las preferencias de marca. Un criterio compartido permite valorar del mismo modo resultados procedentes de distintos centros.
Compara las modalidades antes de comparar las políticas
Open Track y Fine-tune Track hacen preguntas relacionadas con diseños distintos. Según el preprint, Open Track reúne 5.699 comparaciones por pares en 124 centros. Una comparación por pares puede mostrar cómo funcionan dos políticas con tareas y lugares comparables. No implica que cada robot hiciera todas las tareas en cada centro.
Fine-tune Track usa 100 demostraciones por tarea en 20 tareas en la evaluación publicada. Los autores informan de cero tareas completadas en cinco tareas evaluadas con Unitree G1, con puntuaciones medias de progreso de entre el 13,3 % y el 23,2 %. Las puntuaciones parciales describen mejor la distancia al objetivo que un solo cero en el resultado final. Una política puede avanzar de forma observable según los criterios de evaluación y quedarse corta al terminar.
Los autores informan de un coeficiente de concordancia de Kendall de 0,24 para las clasificaciones de progreso de cuatro conjuntos de tareas ligados al hardware. Mide el acuerdo entre clasificaciones y se distingue del porcentaje de tareas completadas. Los conjuntos difieren tanto en la configuración física como en las tareas y sus condiciones. La baja coincidencia es un motivo para validar la combinación elegida en el lugar de trabajo. No aísla la forma del robot como causa de las diferencias.
Compara los dos turnos en la prueba de campo
Supón que un centro de distribución quiere mover el mismo inserto de embalaje de una bandeja a una caja durante dos turnos. El personal observa que el turno de tarde usa una bandeja distinta y tiene menos luz natural. Prueba ambas políticas en ambas condiciones. Alterna el orden dentro de cada turno para que una batería baja, un soporte desplazado o la experiencia de quien opera el equipo no favorezcan siempre a la misma opción.
Anota la posición inicial del objeto, los ajustes permitidos de sensores e iluminación, cómo debe intervenir el personal y qué cuenta como una colocación completa. Conserva los vídeos de fallos y las notas de intervención. Si una política solo mejora cuando se mueve la bandeja, el ajuste puede importar más para el despliegue que la media final. La observación puede llevar a cambiar el soporte o a elegir mejores casos para el próximo ensayo.
Una hoja de evaluación útil asigna puntos parciales a fases observables. Una pinza que localiza el inserto correcto pero no puede levantarlo necesita un trabajo distinto del de otra que lo levanta pero no acierta con la caja. Define cada fase de forma sencilla para que dos personas entiendan igual el ensayo. Añade una categoría propia para la parada segura. Si el robot se detiene porque alguien entra en la zona, puede haber actuado correctamente aunque la tarea no se complete.
Decide qué evidencia justifica el siguiente paso
Una demostración de laboratorio exitosa puede justificar una prueba en el centro. Si esta sale bien, puede justificar un piloto más largo. Cada decisión tiene su propio umbral de aceptación. El equipo de compras puede exigir resultados repetibles en dos turnos habituales antes de plantear una zona menos previsible. El equipo investigador puede pedir categorías de fallos y condiciones de repetición antes de afirmar que la política se transfiere.
Si los resultados discrepan, registra qué cambió entre los entornos y qué acción falló. Una inversión de posiciones puede revelar una tarea que la prueba inicial no representaba. Con esa información, el equipo puede decidir si necesita otro robot, otra política, una célula de trabajo modificada o una prueba más representativa.
El artículo muestra cómo se invierten las clasificaciones
Fine-tune Track ofrece ejemplos concretos en los cuatro conjuntos de tareas. π0.5 ocupa el primer puesto por progreso en Franka y Bimanual-YAM, y el cuarto en G1. GR00T N1.7 lidera en SO-101, pero queda cuarto en Franka y Bimanual-YAM. Los resultados corresponden a los conjuntos y a la métrica de progreso del artículo. Para compras son un ejemplo de cómo cambia la clasificación al cambiar la combinación de tareas, condiciones y hardware.
El estudio también analiza una selección activa de comparaciones. En ese análisis, entre 400 y 500 evaluaciones seleccionadas de forma adaptativa alcanzaron alrededor del 90 % de acuerdo con la clasificación basada en todos los datos. Una selección uniforme necesitó unas 1.000. Es un resultado de ese diseño de evaluación. Para un piloto local, sugiere repetir más los casos en los que resulta difícil distinguir a las opciones principales, conservando un mínimo fijo de casos representativos.
Un centro puede separar una ronda inicial de otra adaptativa. En la primera, da a ambas opciones las mismas tareas con las mismas reglas de intervención. En la segunda, repite las condiciones en que los primeros resultados fueron dispares. Conserva la regla de aceptación original. Si se excluyó una condición por seguridad o viabilidad, anota el motivo. El informe final debe poder explicar cómo cambiaron la decisión los ensayos adicionales.
Busca evidencia sobre los trabajos que más importan
Las evaluaciones distribuidas cubren condiciones que un solo laboratorio difícilmente puede reproducir. Un piloto local aporta detalle sobre el trabajo del equipo. Ambos enfoques se complementan. Usa la evidencia general para localizar candidatos prometedores y diseña una evaluación propia para descubrir las excepciones que determinan si el sistema será útil.
La comparación más sólida es la que el equipo puede repetir cuando cambia una política o el hardware. Conserva la tarea, la configuración y los ejemplos de fallo junto con la puntuación. Si cambia la clasificación, tendrás información suficiente para decidir si el cambio mejora tu trabajo.
Fuentes
Para conservar un registro en el que puedas buscar las conversaciones y decisiones de tu trabajo, crea una cuenta de Telli.sh.