Twój kolejny agent do programowania może działać na Macu: poznaj Flint
Nowy lokalny model Recursive łączy 40B parametrów z niewielką aktywną częścią. Co zmienia dla prywatnych repozytoriów, sprzętu i rzeczywistej pracy programistycznej?
Oficjalny znak modelu Flint z repozytorium Recursive, niezmieniony, na neutralnym tle do identyfikacji redakcyjnej. Nie jest zrzutem działającej instancji ani dowodem wyniku testu.
Asystent kodujący działający na własnym komputerze zmienia znajome pytanie. Zamiast zastanawiać się, czy repozytorium można wysłać do API, możesz pytać, czy maszyna na biurku niezawodnie zakończy zmianę. To użyteczne przesunięcie przy prywatnym kodzie, powtarzanych eksperymentach i niestabilnym połączeniu.
Flint od Recursive konkretyzuje tę propozycję. Ogłoszenie vLLM z 21 października 2026 roku przedstawia obsługę nowego modelu od pierwszego dnia. Recursive opisuje mieszankę ekspertów liczącą około 40 miliardów parametrów, z około 2,5 miliarda aktywnych na token. Zoptymalizowane środowisko Mac prowadzi od pobrania wag do właściwej aplikacji agenta. Ogłoszenie vLLM.
Naszym zdaniem interesujące jest wspólne pojawienie się modelu, oprogramowania serwującego i połączenia z agentem. Nadal trzeba ocenić całą stację roboczą. „2,5B aktywnych” opisuje część obliczeń, a nie możliwość zmieszczenia pełnego modelu na laptopie z małą pamięcią. Ten przewodnik wyjaśnia różnice sprzętowe, trzy początkowe zadania i ocenę lokalnego kodowania bez mylenia szybkiego tekstu z ukończoną naprawą.
Lokalny model zyskuje wartość, gdy współpracuje z narzędziami
Recursive to firma badawcza tworząca Eureka Machine, system automatyzacji badań AI. Flint jest publicznym efektem tej pracy, z wagami do pobrania i osobnym silnikiem inferencji rec. Dla osoby nieznającej firmy najważniejszy początek jest prosty: model tekstowy ma badać kod, proponować zmiany i używać narzędzi przez aplikację programistyczną.
Model i otaczająca go aplikacja wykonują różne zadania. Model generuje odpowiedź lub prosi o działanie narzędzia. Program ustala dostęp do plików, wykonuje polecenia, oddaje wyniki i pokazuje zmiany. Instalacja lokalnego modelu nie tworzy automatycznie użytecznego procesu; połączenie elementów stanowi część produktu.
Dokumentacja Recursive wymienia środowiska lokalne i aplikacje, w tym Pi, OpenCode, Cline i OpenHands. Dzięki temu premiera jest przystępniejsza niż samo udostępnienie wag. Zespół może zachować znajomy edytor, skorzystać z zalecanego launchera albo osobno uruchomić serwer modelu.
Granica lokalnej inferencji jest cenna, ale to tylko jedna granica. Aplikacja agenta nadal może wywołać menedżer pakietów, stronę dokumentacji lub wdrożenie, jeśli ma uprawnienia. Przy prywatnym repozytorium sprawdzaj endpoint modelu i otaczające narzędzia. Lokalny serwer utrzymuje inferencję lokalnie; inne połączenia agenta mają własną konfigurację.
Czterdzieści miliardów parametrów nadal trzeba gdzieś umieścić
Modele mieszanki ekspertów wybierają część wyuczonych komponentów dla każdego tokena. Ogranicza to obliczenia w porównaniu z aktywowaniem całej sieci. Przypomina duży warsztat, w którym bieżące zlecenie używa części narzędzi: pozostałe nadal zajmują miejsce.
Karta Flint, sprawdzona 23 października, podaje 39,8B parametrów ogółem, około 2,5B aktywnych na token oraz wejście i wyjście tekstowe. Opisuje konfigurację kontekstu 262 144 tokenów, wspólną dla promptu i odpowiedzi. Liczby odpowiadają na różne pytania, więc sama etykieta rozmiaru nie wystarczy do planowania.
Proste obliczenie pokazuje problem przechowywania. Przy dokładnie czterech bitach na parametr 39,8 miliarda parametrów zajmuje około 19,9 GB samych bitów parametrów w jednostkach dziesiętnych. Przy 16 bitach wychodzi 79,6 GB. To ilustracyjna arytmetyka, a nie zmierzony rozmiar pobierania lub pełne wymaganie RAM: dochodzą metadane, skale kwantyzacji, alokacje środowiska i pamięć podręczna rozmowy.
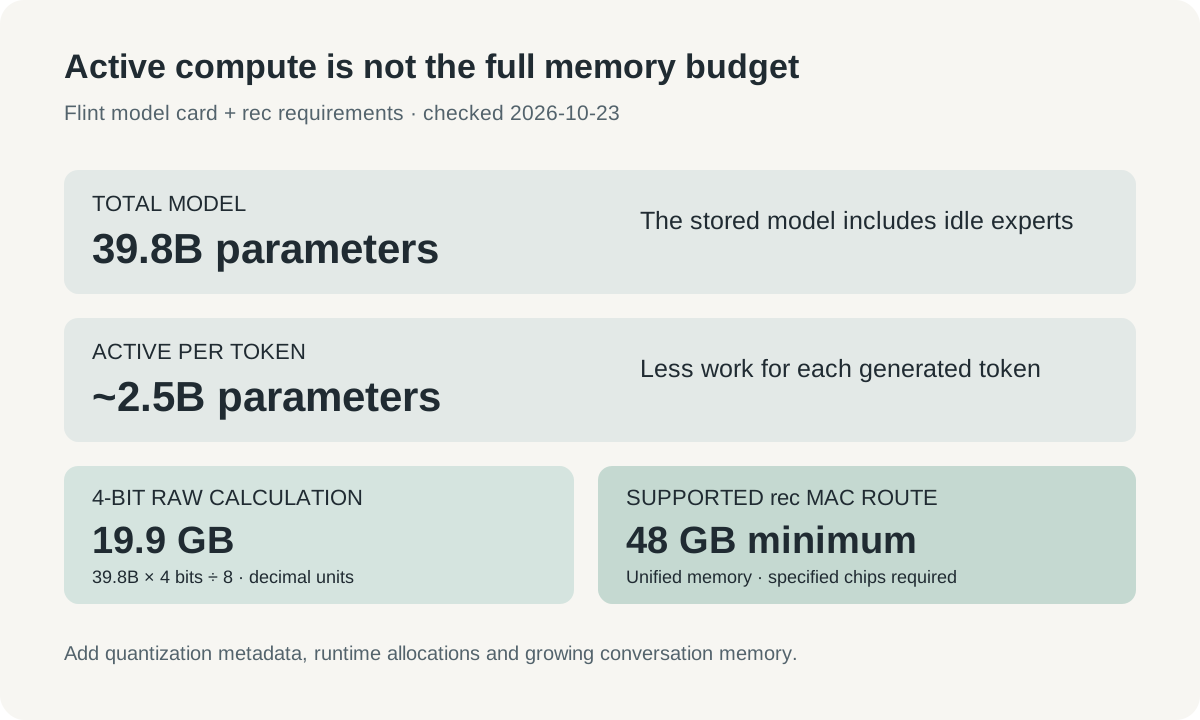
Autorska infografika. Obliczenia bitów są ilustracyjne; aktywne parametry nie określają całej pamięci urządzenia. Dochodzą alokacje środowiska i kontekstu.
Różnica rośnie wraz z rozmową. Pliki, instrukcje, definicje narzędzi, wyniki poleceń i odpowiedzi modelu zużywają kontekst. Wysoki limit pozwala przechować więcej materiału, ale nie gwarantuje jednakowej jakości przy każdej długości ani darmowego przetwarzania długich promptów. Skupiona praca nadal jest dobrą decyzją inżynierską.
Aktualne wymagania rec wskazują Maca z M4 Pro, M5 Pro lub M5 Max, przynajmniej 48 GB pamięci zunifikowanej i około 30 GB wolnego dysku. Dotyczą tej zoptymalizowanej ścieżki, a nie każdego Apple Silicon. Właściciele mniejszych maszyn powinni sprawdzić wymagania innego obsługiwanego środowiska, zamiast wywodzić zgodność z liczby aktywnych parametrów.
Liczba tokenów na sekundę potrzebuje urządzenia i długości kontekstu
Strona premiery Recursive podaje ponad 125 generowanych tokenów na sekundę na M4 Pro MacBook Pro przy krótkim kontekście, z użyciem zoptymalizowanego silnika. To wynik producenta. Przepustowość i pozycja benchmarkowa nie przewidują czasu testów twojej aplikacji. Ogłoszenie Recursive.
Artykuł vLLM opisuje inne warunki: jeden GB200, dekodowanie pojedynczego żądania i kontekst 100K tokenów. Podaje około 485 tokenów na sekundę od początku do końca. Wynik serwerowego GPU i laptopa nie powinny trafiać do jednego wiersza bez warunków: sprzęt i stos inferencji wykonują istotną pracę.
Generowanie tokena różni się też od ukończenia zadania. Model może więcej rozumować, częściej używać narzędzi lub wybrać poprawkę wymagającą kolejnej próby. Szybszy tekst pomaga, gdy to generacja jest wąskim gardłem. Mniej daje, gdy najdłuższy etap to dziesięciominutowy test integracyjny albo seria błędnych zmian.
Na co dzień mierz czas do sprawdzonej zmiany przechodzącej właściwe kontrole. Zapisuj potrzebne poprawki człowieka i naruszenia niezwiązanego zachowania. Prędkość tokenów jest użyteczną diagnostyką, lecz celem był poprawny patch. Szybki asystent stale wybierający złą drogę może zużyć większą część popołudnia.
| Decyzja | Przydatny dowód | Czego nie rozstrzyga |
|---|---|---|
| Czy urządzenie uruchomi model? | Obsługiwany układ, pamięć, środowisko i checkpoint | Czy konkretny projekt zmieści się wygodnie |
| Czy generacja jest responsywna? | Szybkość przy wskazanym kontekście i sprzęcie | Pełnego czasu narzędzi i testów |
| Czy naprawia ten rodzaj problemu? | Sprawdzone wyniki z odtwarzalną kontrolą | Niezawodności w nieznanych kategoriach |
| Czy proces spełnia wymagania prywatności? | Faktyczne endpointy i uprawnienia | Wszystkich działań szeroko uprawnionego agenta |
Zacznij od ograniczonej naprawy zamiast całej migracji
Pierwszy użyteczny scenariusz to zwykły błąd w znanym repozytorium. Wyobraź sobie parser źle obsługujący puste wejście. Poproś Flint o znalezienie odpowiedzialnej funkcji, wyjaśnienie zachowania i dodanie testu regresji przed zmianą implementacji. To propozycja próby, a nie relacja z naszego uruchomienia.
Zadanie ma mały, obserwowalny koniec. Oczekiwane zachowanie jest jawne, plików niewiele, a recenzent może ocenić, czy test sprawdza awarię. Jeśli model zacznie szerokie porządki, odchylenie widać przed powstaniem dużego patcha. Lokalna generacja pozwala iterować bez opłaty za każde żądanie API, ale ograniczenie nadal poprawia pracę.
Drugi scenariusz to poznawanie prywatnego modułu. Poproś o mapę ścieżki żądania z odnośnikami do plików, a kilka z nich sprawdź sam. Następnie zleć wąską zmianę, np. brakującą regułę walidacji. Wartością jest rozmowa oparta na prawdziwym repozytorium, nie ogólne wyjaśnienie oderwane od jego kontraktów.
Trzecim zastosowaniem jest rutynowe utrzymanie testów. Zespół może wypróbować Flint na znanych awariach lub niewielkich lukach, ukrywając oczekiwane odpowiedzi do recenzji. Dodaj przypadek, w którym właściwy wniosek brzmi, że obecne zachowanie jest zamierzone. Powstrzymanie się od zbędnych zmian też należy do jakości programowania, choć wygląda mniej efektownie.
Przypadki celowo dają różne rezultaty: naprawę, wyjaśnienie i decyzję o teście. Sukces jednego powinien kierować następną próbą, a nie dowodzić, że całą pracę można przenieść na jeden lokalny model.
Obsługiwany Mac ma krótką drogę do pierwszego zadania
Poniższa sekwencja korzysta z opublikowanego procesu rec, sprawdzonego 23 października. Zakłada odpowiedniego Maca i repozytorium, do którego masz uprawnienie. Polecenia są instrukcją dla czytelnika, a nie dowodem naszej instalacji lub uruchomienia.
- Sprawdź układ, wolny dysk i pamięć względem aktualnych wymagań. Zacznij w jednorazowej gałęzi lub kopii znanego projektu, aby łatwo ocenić próbę.
- Otwórz oficjalne repozytorium rec, przejrzyj instrukcje i instalator, a potem postępuj zgodnie z dokumentacją. Pierwsze pobranie wymaga sieci, nawet gdy późniejsza inferencja jest lokalna.
- Sprawdź instalację i uruchom zalecane narzędzie z katalogu projektu:
rec doctor
rec launch pi
- Zadaj konkretne polecenie z oczekiwanym zachowaniem, zakresem i komendą weryfikacji. Na przykład: wyjaśnij awarię pustego wejścia, dodaj test i zmień tylko funkcję odpowiedzialną za to zachowanie.
- Przejrzyj różnice i rzeczywisty wynik testów. Po pracy sprawdź serwer i zatrzymaj go, jeśli nie powinien zajmować pamięci:
rec status
rec stop
Warto rozumieć wygodę launchera. Recursive dokumentuje, że serwer może pozostać uruchomiony po zamknięciu narzędzia lub terminala. Zakończenie sesji interaktywnej i zwolnienie modelu to oddzielne czynności. Ma to znaczenie na komputerze używanym jednocześnie do kompilacji, przeglądarki i innych aplikacji.
Zachowuj konfigurację generacji razem z wynikiem
Przewodnik ustawień zaleca początek z temperature 1.0, top-p 0.95 i top-k 20. Wyjaśnia też, że rozumowanie zużywa budżet wyjścia. Zatrzymanie na limicie to inny problem niż błędna, ale ukończona odpowiedź.
Do pierwszej oceny użyj konfiguracji dołączonej do launchera. Zmianę środowiska lub precyzji zapisuj obok wyniku. Inaczej pozorna regresja może wynikać z szablonu rozmowy, ucięcia odpowiedzi lub parsera nierozumiejącego wygenerowanego formatu.
Artykuł vLLM dokumentuje parsery narzędzi i rozumowania w stylu GLM-4.7. To przykład, dlaczego obecność modelu w menu nie oznacza całej integracji. Aplikacja musi zachowywać właściwą strukturę rozmowy i poprawnie wykonywać wywołania. Dobra odpowiedź w czacie nie dowodzi działającej edycji plików.
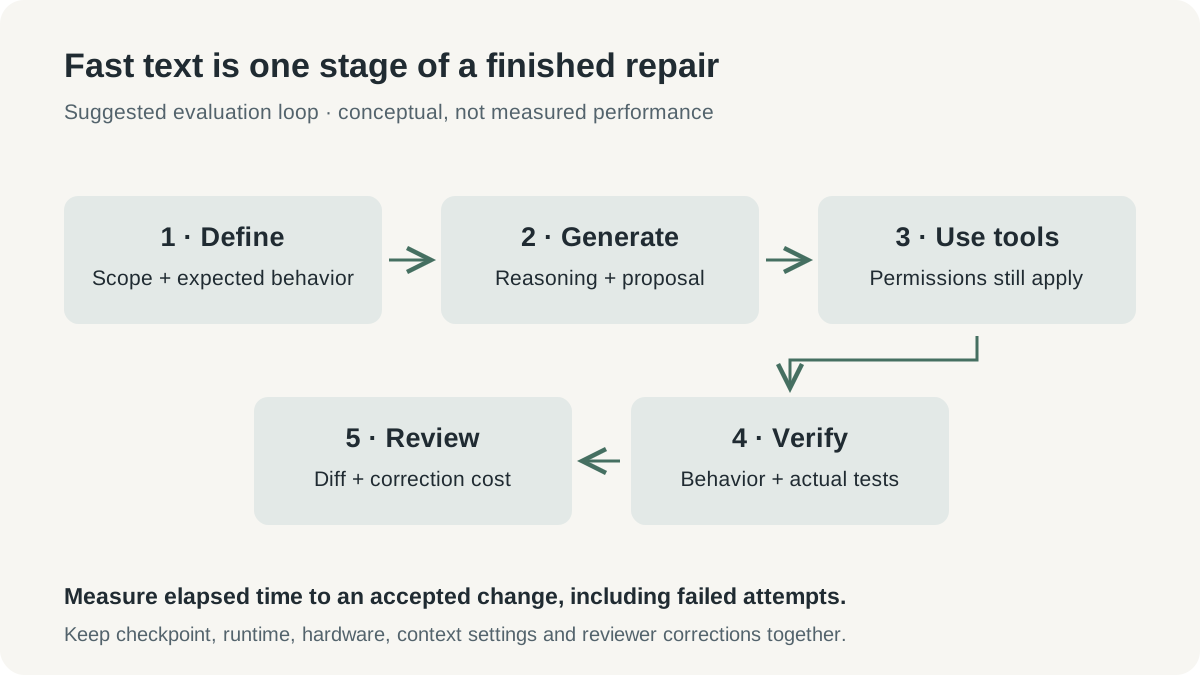
Autorski schemat proponowanego procesu oceny. Nie przedstawia oficjalnej architektury ani zmierzonych rezultatów.
Notatka z oceny może być mała: rewizja wag, wersja środowiska, sprzęt, kontekst, zadanie, czas, testy i poprawki recenzenta. Powtarzanie tych samych zadań po aktualizacji mówi więcej niż porównanie sesji, w których zmieniły się ustawienia i cele. Zachowaj też niepowodzenia, bo koszt odzyskiwania wpływa na użyteczność narzędzia.
Lokalna inferencja zmienia rachunek, ale nie usuwa kosztu
Brak opłaty API może być atrakcyjny przy powtarzalnej pracy na posiadanym sprzęcie. Zespół często zlecający wyjaśnienie kodu lub małe testy może preferować przewidywalną moc lokalną. Porównanie nadal obejmuje instalację, utrzymanie, recenzję i koszt zajętej pamięci.
Zakup nowego laptopa z dużą pamięcią dla jednego wydania to inna kalkulacja niż próba na istniejącej maszynie. Oszacuj prawdziwy zakres pracy, zanim uznasz sprzęt za oszczędność. Uwzględnij zadania, w których większy model hostowany wymaga mniej korekt; podział lokalny i chmurowy może być rozsądny.
Znaczenie ma współbieżność. Dokumentacja rec mówi o jednej generacji naraz, a nakładające się żądania mogą dostać HTTP 429. Dobry proces jednego programisty nie oznacza wspólnego serwera zespołu o tym samym zachowaniu. Kilku agentów tworzy inne obciążenie i może wymagać innego środowiska.
Obiecujące jest to, że lokalne kodowanie staje się pełnym wyborem sposobu pracy. Małe aktywne obliczenia, dostępne wagi i specjalny runtime Flint rozwiązują różne części problemu. Następne potrzebne dowody to ukończone naprawy zwykłych projektów, stabilne wsparcie i zachowanie w długich sesjach. To zmienia demonstrację w niezawodne narzędzie codzienne.
Stacja robocza staje się częścią asystenta kodowania
Flint wymaga oceny czegoś więcej niż punktacji modelu. Pojemność pamięci, uprawnienia, aplikacja agenta i zwyczaje recenzji stają się częścią doświadczenia. To wymagające, ale daje kontrolę: cykl pracy można oglądać i kształtować na własnej maszynie.
Zacznij od zadania, którego wynik umiesz ocenić. Jeśli lokalny cykl wielokrotnie daje dobre zmiany z rozsądną recenzją, masz użyteczne narzędzie. Mocniejsze twierdzenie, że obsłuży następną trudniejszą kategorię, może poczekać na kolejny dowód.
Źródła
- Recursive: Introducing Flint, ogłoszenie; sprawdzone 23 października 2026 roku. Osobna strona nie pokazuje wiarygodnej daty premiery.
- vLLM i Recursive: obsługa Flint od pierwszego dnia, 21 października 2026 roku.
- Oficjalna karta i parametry Flint, sprawdzone 23 października 2026 roku.
- Dokumentacja Recursive, instalacja i wymagania rec, ustawienia generacji, sprawdzone 23 października 2026 roku.
- Oficjalne repozytorium rec, sprawdzone 23 października 2026 roku.
Zachowaj uzasadnienie decyzji technicznej
Jeśli potrzebujesz osobnego miejsca na źródła i własne sprawdzone notatki techniczne, Telli.sh jest jedną z opcji. Otwórz przestrzeń notatek.