Il prossimo agente di programmazione potrebbe girare sul tuo Mac: ecco Flint
Il nuovo modello locale di Recursive combina 40B parametri totali con una piccola parte attiva. Cosa cambia per repository privati, hardware e sviluppo reale.
Marchio ufficiale di Flint dal repository del modello di Recursive, riprodotto senza modifiche su uno sfondo neutro per identificarlo editorialmente. Non è una schermata del modello in esecuzione né una prova di un risultato di benchmark.
Un assistente di programmazione che funziona sul proprio computer cambia una domanda abituale. Invece di chiedersi se un repository possa essere inviato a un'API, ci si può chiedere se il computer sulla scrivania riesca a completare la modifica in modo affidabile. È un cambiamento utile, soprattutto quando si lavora con codice privato, esperimenti ripetuti o una connessione poco stabile.
Flint di Recursive rende concreta questa proposta. Un annuncio di supporto immediato di vLLM datato 21 ottobre 2026 presenta il nuovo modello di programmazione. Recursive lo descrive come un mixture-of-experts da circa 40 miliardi di parametri, con circa 2,5 miliardi di parametri attivi per token. Il runtime ottimizzato per Mac offre un percorso dal download del modello all'utilizzo effettivo in un'applicazione per agenti di programmazione.
La nostra lettura: Flint è interessante perché modello, software di inferenza e collegamento all'agente arrivano insieme. La decisione d'acquisto importante riguarda comunque l'intera postazione. «2,5B attivi» descrive parte del calcolo; non significa che un portatile con poca memoria possa contenere il modello completo. Questa guida spiega la distinzione hardware, tre attività iniziali utili e un modo per valutare la programmazione locale senza confondere testo veloce e correzione completata.
Un modello locale diventa utile quando lavora con i tuoi strumenti
Recursive è un'azienda di ricerca sull'AI che sviluppa Eureka Machine, un sistema di ricerca automatizzata. Flint è un risultato pubblico di questo lavoro, con pesi scaricabili e un motore di inferenza dedicato chiamato rec. Per chi non conosce l'azienda, il punto di partenza pratico è semplice: è un modello testuale pensato per esaminare codice, proporre modifiche e usare strumenti tramite un'applicazione di programmazione.
La distinzione tra modello e applicazione che lo gestisce conta. Il modello produce una risposta o richiede un'azione a uno strumento. Il programma circostante decide quali file può leggere, esegue i comandi, restituisce i risultati e mostra le modifiche. Installare un modello locale non fornisce automaticamente un flusso di sviluppo utile: collegare questi elementi fa parte dell'esperienza del prodotto.
La documentazione di configurazione di Recursive elenca opzioni di runtime locale insieme ad applicazioni come Pi, OpenCode, Cline e OpenHands. Flint diventa così più accessibile rispetto a una pubblicazione composta soltanto dai pesi. Il team ha anche diverse possibilità: mantenere un editor familiare, usare il launcher consigliato oppure servire il modello separatamente.
Il confine dell'inferenza locale è prezioso, ma non è l'unico. Se i permessi lo consentono, l'applicazione dell'agente può ancora richiamare un gestore di pacchetti, contattare un sito di documentazione o eseguire un comando di distribuzione. Per un repository privato, esamina sia l'endpoint del modello sia gli strumenti circostanti. Un server locale mantiene locale l'inferenza; le altre connessioni dell'agente seguono le rispettive configurazioni.
Quaranta miliardi di parametri devono comunque risiedere da qualche parte
I modelli mixture-of-experts selezionano per ogni token un sottoinsieme dei propri componenti appresi. Questo riduce il calcolo necessario rispetto all'attivazione dell'intera rete. È come una grande officina in cui il lavoro attuale usa soltanto alcuni utensili: l'attrezzatura inattiva ha comunque bisogno di spazio.
La scheda del modello Flint, consultata il 23 ottobre, specifica 39,8B parametri totali, circa 2,5B attivi per token e input e output testuali. Riporta una configurazione di contesto documentata di 262.144 token, condivisa tra prompt e output generato. Questi numeri rispondono a domande diverse: una sola etichetta «dimensione del modello» non basta per pianificare.
Un calcolo semplice rende visibile il problema dello spazio. Con esattamente quattro bit per parametro, 39,8 miliardi di parametri contengono circa 19,9 GB di bit dei parametri in unità decimali. Con 16 bit, lo stesso calcolo dà 79,6 GB. Sono calcoli illustrativi di basso livello, non dimensioni misurate del download né requisiti RAM completi: metadati, scale di quantizzazione, allocazioni del runtime e cache della conversazione aumentano il totale.
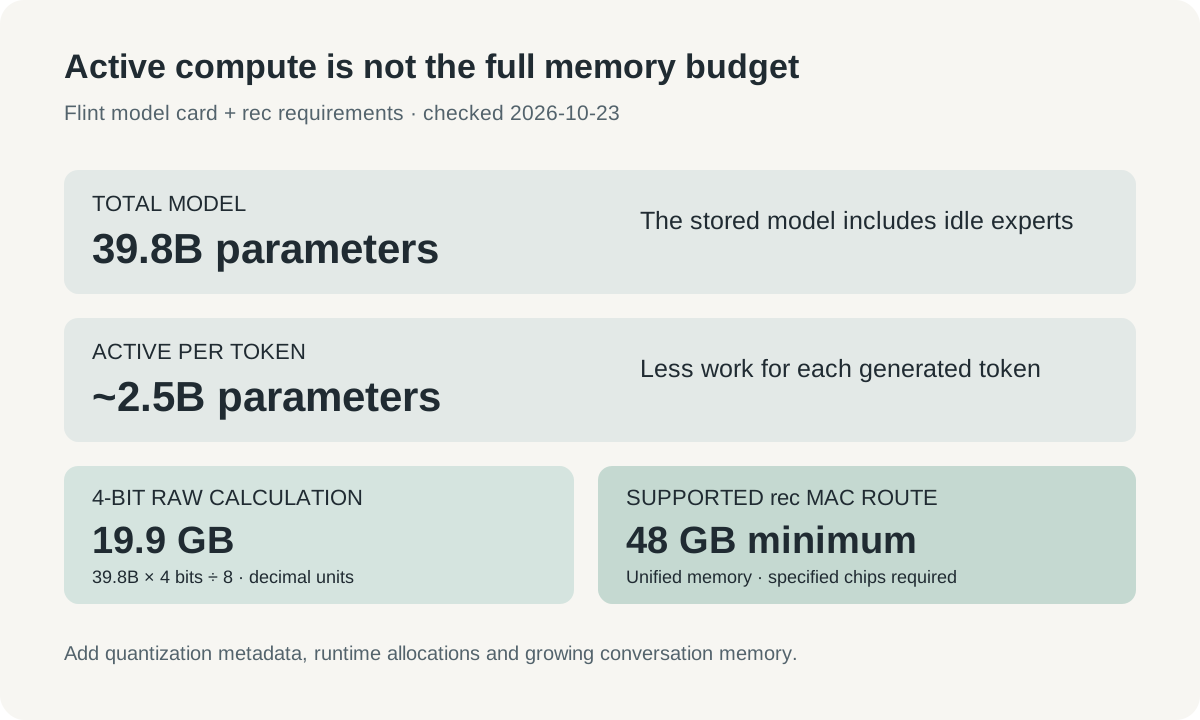
Infografica originale. Il calcolo dei bit dei parametri è illustrativo; i parametri attivi non specificano la memoria totale del dispositivo. Le allocazioni di runtime e contesto si aggiungono.
La distinzione diventa ancora più importante con l'allungarsi della conversazione. File sorgente, istruzioni, definizioni degli strumenti, output dei comandi e risposte del modello consumano tutti contesto. Un massimo generoso permette alla sessione di contenere più materiale, ma non garantisce la stessa qualità a ogni lunghezza né rende gratuita l'elaborazione di prompt lunghi. Mantenere l'attività focalizzata resta una scelta ingegneristica utile.
I requisiti attuali di rec indicano un Mac M4 Pro, M5 Pro o M5 Max, almeno 48 GB di memoria unificata e circa 30 GB di spazio libero. Sono requisiti di quel percorso ottimizzato, non una promessa valida per ogni macchina Apple Silicon. Chi possiede un computer più piccolo dovrebbe verificare i requisiti di un altro runtime supportato, senza interpretare il numero di parametri attivi come indicazione di compatibilità.
I numeri di velocità richiedono un dispositivo e una lunghezza del contesto
La pagina di lancio di Recursive riporta più di 125 token generati al secondo su un MacBook Pro M4 Pro con contesti brevi, usando il motore ottimizzato. È un risultato di inferenza dichiarato dall'azienda. La pagina presenta anche valutazioni di programmazione, ma né il throughput né la posizione in un benchmark prevedono la velocità della suite di test della tua applicazione. Annuncio di lancio di Recursive.
L'articolo di lancio di vLLM descrive un ambiente diverso: una singola GB200, decodifica con batch uno e un contesto da 100K token. Riporta circa 485 token al secondo da un capo all'altro in quella configurazione. Un risultato su GPU server e uno su portatile non dovrebbero comparire nella stessa riga di confronto senza le rispettive condizioni: hardware e software di inferenza contribuiscono in modo sostanziale.
C'è poi una differenza tra generare un token e completare un'attività. Un modello può produrre più ragionamento, richiamare strumenti più spesso o scegliere una correzione che richiede un altro tentativo. Un output più rapido aiuta quando la generazione è il collo di bottiglia. Aiuta meno quando il passaggio più lungo è un test d'integrazione di dieci minuti o una sequenza di modifiche sbagliate.
Per una valutazione quotidiana, misura il tempo fino a quando una modifica revisionata supera i controlli appropriati. Annota quante correzioni umane ha richiesto e se ha alterato comportamenti estranei al compito. La velocità in token resta un dato diagnostico utile, ma il risultato desiderato era una patch corretta. Un assistente rapido che imbocca ripetutamente la strada sbagliata può consumare una parte maggiore del pomeriggio.
| Decisione | Evidenza utile | Cosa non chiarisce |
|---|---|---|
| Il dispositivo può eseguire il modello? | Chip, memoria, runtime e checkpoint supportati | Se una specifica base di codice entra comodamente in memoria |
| La generazione è reattiva? | Throughput con contesto e hardware dichiarati | Tempo totale negli strumenti e nei test |
| Sa correggere questa classe di problemi? | Risultati revisionati con un controllo riproducibile | Affidabilità su categorie di attività sconosciute |
| Il flusso soddisfa le esigenze di riservatezza? | Endpoint effettivi e permessi degli strumenti | Ogni azione possibile in un'applicazione con permessi ampi |
Inizia da una correzione circoscritta, prima di un'intera migrazione
Il primo scenario utile è un normale bug in un repository che conosci già. Immagina un parser che gestisca male un input vuoto. Chiedi a Flint di individuare la funzione responsabile, spiegarne il comportamento e aggiungere un test di regressione prima di modificare l'implementazione. È una prova illustrativa, non il resoconto di una nostra esecuzione.
Questa attività offre all'assistente un traguardo piccolo e osservabile. Il comportamento atteso è esplicito, i file coinvolti sono limitati e un revisore può verificare se il test riproduce il problema. Se il modello si allarga a una pulizia generale, puoi riconoscere lo scostamento prima che diventi una grande patch. La generazione locale permette iterazioni senza una fattura API per richiesta, ma il vincolo continua a migliorare il lavoro.
Un secondo scenario è capire un modulo privato. Chiedi una mappa del percorso della richiesta con riferimenti ai file e verificane alcuni di persona. Prosegui con una richiesta ristretta, come aggiungere una regola di validazione mancante. Il valore è una conversazione fondata sul repository reale, anziché una spiegazione generica scollegata dai suoi contratti.
Un terzo scenario è la normale manutenzione dei test. Un team può provare Flint su errori già compresi o piccole lacune, nascondendo i risultati attesi fino alla revisione. Includi un'attività in cui la risposta corretta sia che il comportamento attuale è intenzionale. La capacità di evitare modifiche inutili fa parte della qualità dello sviluppo, anche se è meno spettacolare di una grande funzionalità generata.
Questi casi producono deliberatamente risultati diversi: una correzione, una spiegazione e una decisione sui test. Il successo in uno dovrebbe guidare l'esperimento successivo, senza diventare una prova che ogni attività di sviluppo possa passare allo stesso modello locale.
Su un Mac supportato, il primo compito è vicino
La sequenza seguente usa il flusso rec pubblicato, consultato il 23 ottobre. Presuppone un Mac supportato e un repository che sei autorizzato a esaminare. I comandi sono istruzioni per i lettori, non prove che abbiamo installato o eseguito il modello.
- Verifica chip, spazio libero e memoria rispetto ai requisiti attuali. Parti da un branch usa e getta o da una copia di un progetto familiare, per rendere semplice la revisione iniziale.
- Apri il repository ufficiale di rec, esamina istruzioni e programma d'installazione, quindi segui il percorso documentato. Il primo download del modello richiede una connessione anche se l'inferenza successiva è locale.
- Controlla l'installazione, poi avvia l'applicazione suggerita dalla directory del progetto:
rec doctor
rec launch pi
- Assegna un compito concreto con comportamento atteso, ambito pertinente e comando di verifica. Per esempio: spiega perché fallisce un test sull'input vuoto, aggiungi una regressione mirata e cambia soltanto la funzione che gestisce quel comportamento.
- Esamina il diff e l'output effettivo dei test. Alla fine, controlla lo stato del server e arresta il runtime se non deve più occupare memoria:
rec status
rec stop
Vale la pena capire la comodità del launcher. Recursive documenta che il server del modello può restare attivo dopo la chiusura dell'applicazione o del terminale. Interrompere la sessione interattiva e liberare il modello locale sono azioni distinte. Questo conta su un computer usato anche per compilazioni, browser e altre applicazioni quotidiane.
Conserva la configurazione di generazione insieme al risultato
La guida alle impostazioni di generazione consiglia di iniziare con temperature 1.0, top-p 0.95 e top-k 20. Spiega inoltre che il ragionamento consuma il budget di output. Se una risposta termina perché ha raggiunto il limite, una risposta incompleta è un problema diverso da una risposta completa ma sbagliata.
Per la prima valutazione usa la configurazione inclusa nel launcher. Se in seguito cambi runtime o precisione, registra la modifica insieme al risultato. Altrimenti, un'apparente regressione del modello può dipendere da un template di chat incompatibile, una risposta troncata o un parser degli strumenti che non comprende il formato generato.
L'articolo di vLLM documenta parser di strumenti e ragionamento in stile GLM-4.7 per quel percorso. È un esempio concreto del perché la presenza del modello in un menu non completi l'integrazione. L'applicazione deve conservare la struttura pertinente della conversazione ed eseguire correttamente le chiamate previste. Una risposta di chat valida, da sola, non dimostra che la modifica dei file funzioni.
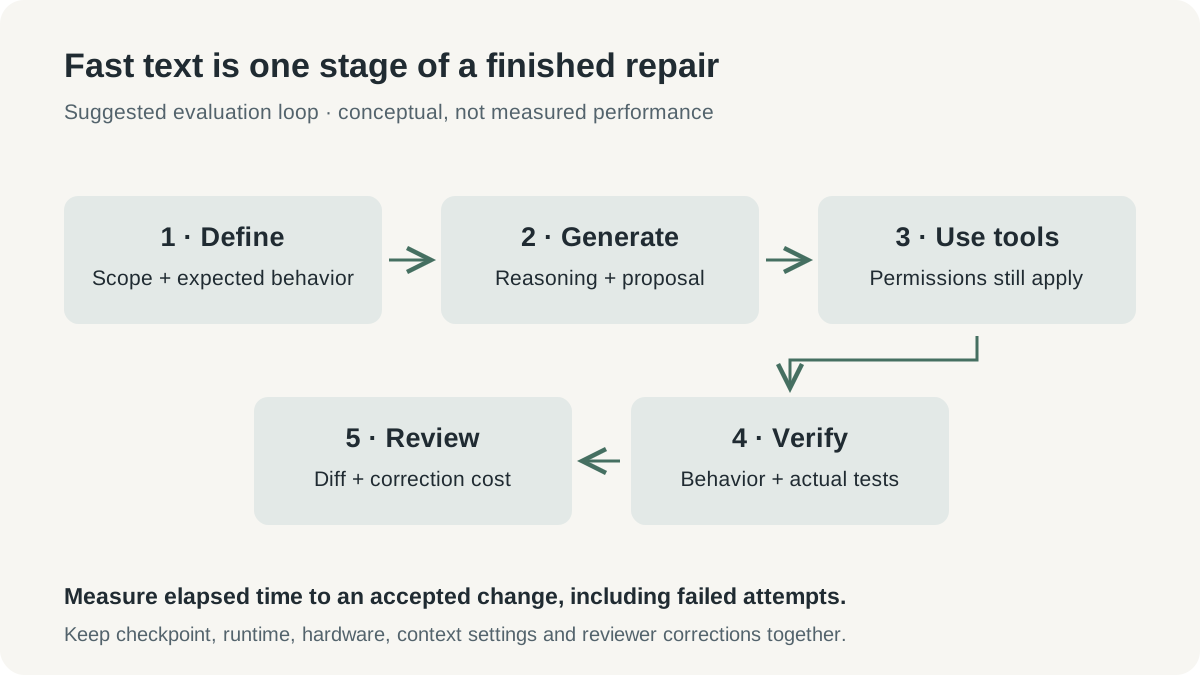
Flusso concettuale originale. Il controllo finale riguarda il risultato revisionato del compito; il diagramma non rappresenta prestazioni misurate né un'installazione completata.
Una nota di valutazione può essere breve: revisione del checkpoint, versione del runtime, hardware, impostazione del contesto, compito, tempo trascorso, risultato dei test e correzioni del revisore. Ripetere gli stessi compiti circoscritti dopo un aggiornamento informa più del confronto tra sessioni con impostazioni e obiettivi entrambi diversi. Conserva anche i tentativi falliti: il costo del recupero influisce sull'utilità dello strumento.
L'inferenza locale cambia la fattura, non elimina i costi
Evitare una tariffa API può essere interessante per lavori ripetuti su hardware già posseduto. Un team che chiede spesso spiegazioni del codice o piccoli test può preferire una capacità locale prevedibile. Il confronto comprende comunque il tempo per installare, mantenere e revisionare il sistema, oltre al costo opportunità della memoria occupata.
Comprare un nuovo portatile con molta memoria soltanto per una pubblicazione è un calcolo diverso dal provare un modello su una macchina supportata già disponibile. Stima il carico reale prima di considerare l'hardware un risparmio. Includi attività in cui un modello remoto più grande completa il lavoro con meno correzioni: una combinazione locale e remota può essere ragionevole quando strumenti diversi servono lavori diversi.
Anche la concorrenza richiede attenzione. La documentazione attuale di rec dice che il motore gestisce una generazione alla volta, e richieste sovrapposte possono ricevere HTTP 429. Una buona esperienza per un singolo sviluppatore non implica quindi un server condiviso dal team con lo stesso comportamento. Servire più agenti introduce un altro carico e può richiedere un runtime diverso.
Lo sviluppo promettente è che la programmazione locale sta diventando una scelta di flusso completa. Il piccolo calcolo attivo di Flint, i pesi accessibili e il runtime dedicato affrontano parti diverse del problema. Il passo successivo dovrebbe essere una base più ampia di risultati su correzioni completate in progetti ordinari, supporto stabile del runtime e comportamento chiaro nelle sessioni lunghe. Sono questi miglioramenti a trasformare una demo notevole in uno strumento quotidiano affidabile.
La postazione diventa parte dell'assistente di programmazione
Flint chiede agli sviluppatori di valutare più di un punteggio. Capacità di memoria, permessi degli strumenti, applicazione dell'agente e abitudini di revisione diventano parte dell'assistente effettivamente utilizzato. È una proposta impegnativa, ma dà anche più controllo: il ciclo di sviluppo può essere esaminato e modellato su un computer proprio.
Inizia con un compito di cui sai giudicare l'esito. Se il ciclo locale produce ripetutamente una buona modifica con una revisione gestibile, hai trovato uno strumento utile. La pretesa più forte, che debba gestire anche la prossima categoria più difficile, può aspettare la prossima evidenza.
Fonti
- Recursive: Introducing Flint, annuncio di lancio; consultato il 23 ottobre 2026. La pagina autonoma non mostra una data di lancio affidabile.
- vLLM e Recursive: Day-0 Support for Flint, 21 ottobre 2026.
- Scheda e specifiche ufficiali di Flint, consultate il 23 ottobre 2026.
- Recursive: documentazione Flint, configurazione e requisiti di rec e impostazioni di generazione, consultate il 23 ottobre 2026.
- Repository ufficiale di rec, consultato il 23 ottobre 2026.
Conserva il ragionamento dietro una decisione tecnica
Se vuoi uno spazio separato per link alle fonti e appunti tecnici revisionati, Telli.sh è una possibilità. Apri il tuo spazio per gli appunti.