Et si votre prochain agent de code tournait sur votre Mac ? Découvrez Flint
Le nouveau modèle local de Recursive associe 40 milliards de paramètres à une petite fraction active. Ce que cela change pour les dépôts privés, le matériel et le travail de développement.
Marque officielle du modèle Flint issue du dépôt de modèles de Recursive, présentée sans modification avec une marge neutre pour l’identification éditoriale. Ce n’est ni une capture d’un modèle en fonctionnement ni une preuve de performance.
Un assistant de code qui fonctionne sur votre machine change une question familière. Au lieu de demander si un dépôt peut être envoyé à une API, vous pouvez demander si l’ordinateur sur votre bureau peut terminer la modification de façon fiable. C’est un changement utile, particulièrement pour du code privé, des expériences répétées ou une connexion peu fiable.
Flint, de Recursive, concrétise cette proposition. Une annonce de prise en charge dès le lancement par vLLM, datée du 21 octobre 2026, présente ce nouveau modèle de code. Recursive décrit un modèle à mélange d’experts d’environ 40 milliards de paramètres, dont quelque 2,5 milliards sont actifs par token. Son moteur d’exécution optimisé pour Mac offre une voie entre le téléchargement du modèle et un véritable environnement d’agent de code.
Notre avis : l’intérêt de Flint tient à l’arrivée conjointe du modèle, du logiciel de service et de la connexion à l’agent. La décision d’achat concerne toujours le poste de travail complet. « 2,5 milliards actifs » décrit une partie du calcul ; cela ne signifie pas qu’un portable avec peu de mémoire peut contenir tout le modèle. Ce guide explique cette distinction matérielle, trois tâches de départ utiles et une méthode d’évaluation qui ne confond pas texte rapide et réparation terminée.
Un modèle local devient utile lorsqu’il travaille avec vos outils
Recursive est une entreprise de recherche en IA qui développe l’Eureka Machine, un système de recherche automatisée. Flint est un produit public de cet effort, avec des poids téléchargeables et un moteur d’inférence dédié appelé rec. Pour les développeurs qui découvrent l’entreprise, le point de départ est simple : c’est un modèle textuel destiné à examiner du code, proposer des modifications et utiliser des outils via une application de programmation.
La distinction entre le modèle et son environnement d’agent est importante. Le modèle produit une réponse ou demande une action d’outil. Le programme qui l’entoure décide quels fichiers il peut lire, exécute les commandes, renvoie leurs résultats et vous présente les modifications. Installer un modèle local ne lui donne pas automatiquement un processus de développement utile ; relier ces éléments fait partie de l’expérience produit.
La documentation de configuration de Recursive répertorie des moteurs locaux et des applications de code, notamment Pi, OpenCode, Cline et OpenHands. Flint est ainsi plus accessible qu’une publication limitée au téléchargement des poids. Une équipe dispose aussi de plusieurs choix : conserver son éditeur habituel, employer le lanceur conseillé ou servir le modèle séparément.
La frontière de l’inférence locale est précieuse, mais ce n’est qu’une frontière. L’environnement de l’agent peut encore invoquer un gestionnaire de paquets, contacter un site de documentation ou lancer un déploiement si ses autorisations le permettent. Pour un dépôt privé, examinez le point d’accès du modèle et ses outils périphériques. Un serveur d’inférence local garde l’inférence locale ; les autres connexions de l’agent suivent leur propre configuration.
Quarante milliards de paramètres doivent toujours résider quelque part
Les modèles à mélange d’experts sélectionnent une partie de leurs composants appris pour chaque token. Cela réduit le calcul nécessaire à sa génération par rapport à l’activation du réseau entier. C’est comparable à un grand atelier dont le travail du moment n’utilise que certains outils : les équipements inactifs ont toujours besoin d’être rangés.
La fiche du modèle Flint, vérifiée le 23 octobre, indique 39,8 milliards de paramètres au total, environ 2,5 milliards actifs par token, avec entrée et sortie textuelles. Elle documente une configuration de contexte de 262 144 tokens, partagée entre le prompt et la sortie générée. Ces chiffres répondent à des questions différentes : une seule étiquette de « taille du modèle » ne suffit pas à planifier.
Un calcul simple rend le stockage tangible. À exactement quatre bits par paramètre, 39,8 milliards de paramètres représentent environ 19,9 Go de bits bruts, en unités décimales. À 16 bits, le même calcul donne 79,6 Go. Ce sont des illustrations arithmétiques à bas niveau, pas des tailles de téléchargement mesurées ni des besoins complets en RAM : métadonnées, échelles de quantification, allocations d’exécution et cache de conversation s’ajoutent au total.
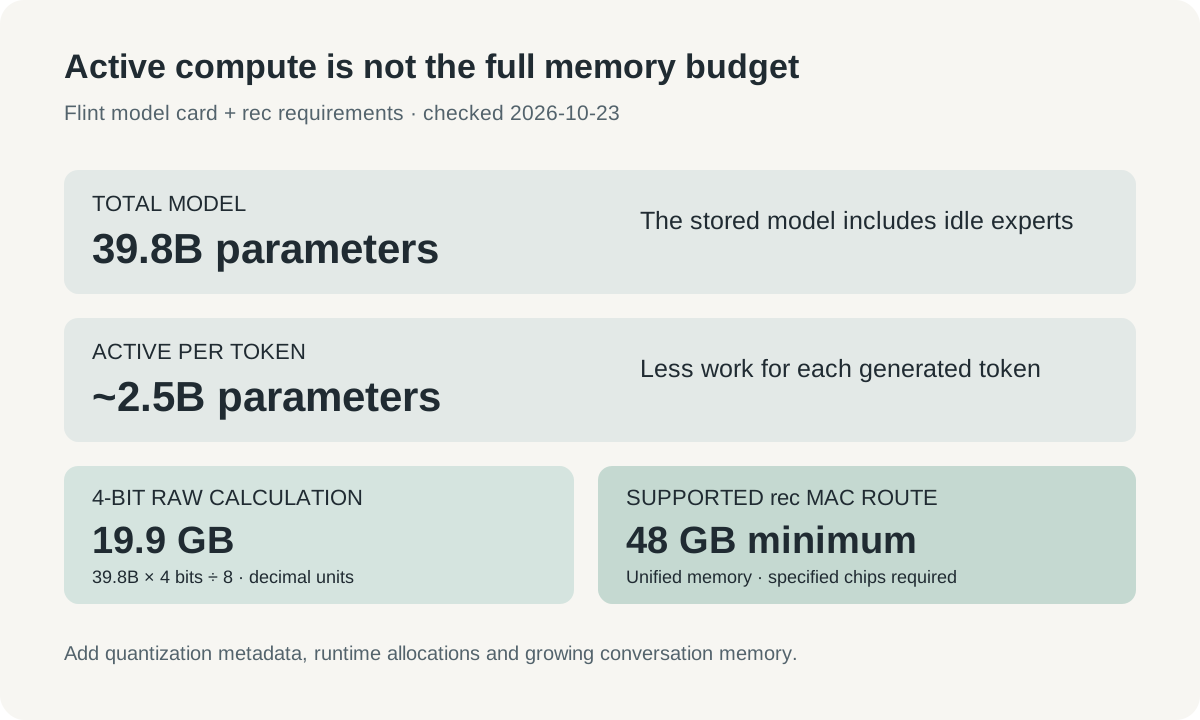
Infographie originale. Le calcul des bits de paramètres est illustratif ; les paramètres actifs ne définissent pas la mémoire totale de l’appareil. Les allocations du moteur et du contexte s’ajoutent.
La distinction devient plus importante lorsque la conversation s’allonge. Fichiers source, instructions, définitions d’outils, sorties de commandes et réponses du modèle consomment tous du contexte. Un maximum généreux permet de transporter davantage de documents, mais ne garantit pas une qualité égale à toutes les longueurs et ne rend pas les longs prompts gratuits à traiter. Garder la tâche ciblée reste un bon choix technique.
Les exigences actuelles de rec précisent un Mac M4 Pro, M5 Pro ou M5 Max, au moins 48 Go de mémoire unifiée et environ 30 Go de stockage libre. Il s’agit des exigences de cette voie optimisée, pas d’une promesse pour toutes les machines Apple Silicon. Les propriétaires de machines plus modestes doivent examiner les exigences d’un autre moteur pris en charge plutôt que déduire la compatibilité du nombre de paramètres actifs.
Un chiffre de vitesse a besoin d’un appareil et d’une longueur de contexte
La page de lancement de Recursive annonce plus de 125 tokens générés par seconde sur un MacBook Pro M4 Pro avec des contextes courts, grâce à son moteur optimisé. C’est un résultat d’inférence rapporté par l’entreprise. La page présente aussi des évaluations de programmation, mais ni un débit ni une position dans un classement ne prédisent la vitesse d’exécution des tests de votre application. Annonce de Recursive.
L’article de vLLM décrit un autre environnement : un seul GB200, un décodage par lot de taille un et un contexte de 100 000 tokens. Il annonce environ 485 tokens par seconde de bout en bout dans cette configuration. Un résultat sur GPU serveur et un résultat sur portable ne doivent pas figurer sur la même ligne sans leurs conditions ; le matériel et la pile d’inférence jouent un rôle déterminant.
Générer un token et terminer une tâche sont également deux choses différentes. Un modèle peut produire davantage de raisonnement, appeler plus d’outils ou choisir une réparation nécessitant une nouvelle tentative. Une sortie plus rapide aide lorsque la génération est le goulot d’étranglement. Elle aide moins si l’étape la plus longue est un test d’intégration de dix minutes ou une série de modifications erronées.
Pour une évaluation quotidienne, mesurez le temps jusqu’à une modification révisée qui passe les bons contrôles. Consignez les corrections humaines nécessaires et les éventuelles perturbations de comportements sans rapport. La vitesse des tokens reste un diagnostic utile, mais l’objectif était un correctif juste. Un assistant rapide qui emprunte souvent la mauvaise voie peut consommer davantage de votre après-midi.
| Décision | Preuve utile | Ce qu’elle ne résout pas |
|---|---|---|
| L’appareil peut-il exécuter le modèle ? | Puce, mémoire, moteur et poids pris en charge | Si un dépôt particulier tient confortablement |
| La génération paraît-elle réactive ? | Débit avec contexte et matériel précisés | Le temps total des outils et des tests |
| Peut-il réparer cette catégorie de problème ? | Résultats révisés avec contrôle reproductible | La fiabilité dans des catégories inconnues |
| Le processus respecte-t-il les besoins de confidentialité ? | Points d’accès et autorisations réels des outils | Toutes les actions possibles d’un environnement permissif |
Commencez par une réparation bornée plutôt qu’une migration complète
Le premier scénario utile est un bogue ordinaire dans un dépôt que vous connaissez. Imaginez un analyseur qui gère mal une entrée vide. Demandez à Flint d’identifier la fonction responsable, d’expliquer le comportement actuel et d’ajouter un test de non-régression avant de modifier l’implémentation. C’est une proposition d’essai, pas le compte rendu de notre exécution.
Cette tâche donne à l’assistant une petite ligne d’arrivée observable. Le comportement attendu est explicite, les fichiers pertinents sont limités et le réviseur peut déterminer si le test reproduit l’échec. Si le modèle part dans un grand nettoyage, l’écart est visible avant qu’il devienne un gros correctif. La génération locale permet d’itérer sans facture d’API par requête, mais la contrainte améliore toujours le travail.
Un deuxième scénario est la découverte d’un module privé. Demandez une carte du parcours d’une requête avec des références aux fichiers, puis vérifiez vous-même quelques références. Poursuivez par une demande étroite, par exemple ajouter une règle de validation manquante. La valeur est une conversation ancrée dans le dépôt réel plutôt qu’une explication générique détachée de ses contrats.
Le troisième scénario est la maintenance courante des tests. Une équipe peut essayer Flint sur des échecs déjà compris ou de petites lacunes, en gardant les résultats attendus cachés jusqu’à la révision. Incluez une tâche où la bonne réponse est que le comportement actuel est intentionnel. S’abstenir de modifications inutiles fait partie de la qualité du développement, même si cela impressionne moins qu’une grande fonction générée.
Ces cas ont volontairement des sorties différentes : une réparation, une explication et une décision de test. Une réussite dans l’un doit orienter l’essai suivant, sans devenir la preuve que toute activité de développement peut passer au même modèle local.
Sur un Mac pris en charge, le chemin vers la première tâche est court
La séquence suivante suit le processus publié de rec, vérifié le 23 octobre. Elle suppose un Mac pris en charge et un dépôt que vous êtes autorisé à examiner. Ces commandes sont des instructions pour les lecteurs ; elles ne prouvent pas que nous avons installé ou exécuté le modèle.
- Vérifiez la puce, le stockage libre et la mémoire dans les exigences actuelles. Commencez sur une branche temporaire ou une copie d’un projet connu pour faciliter la révision du premier essai.
- Ouvrez le dépôt officiel de rec, examinez les instructions et le programme d’installation, puis suivez la voie documentée. Le premier téléchargement du modèle exige une connexion, même si l’inférence ultérieure est locale.
- Vérifiez l’installation, puis lancez l’environnement conseillé depuis le répertoire du projet :
rec doctor
rec launch pi
- Confiez-lui une tâche concrète avec comportement attendu, périmètre pertinent et commande de vérification. Par exemple : expliquer pourquoi le test d’entrée vide échoue, ajouter une régression ciblée et ne modifier que la fonction responsable.
- Révisez les différences et les sorties réelles des tests. Une fois terminé, vérifiez l’état du serveur et arrêtez le moteur s’il ne doit plus occuper de mémoire :
rec status
rec stop
La commodité du lanceur mérite d’être comprise. Recursive documente que le serveur du modèle peut rester actif après fermeture de l’agent ou du terminal. Arrêter la session interactive et libérer le modèle local sont deux actions distinctes. C’est important sur une machine utilisée aussi pour les compilations, le navigateur et les applications quotidiennes.
Gardez la configuration de génération avec le résultat
Le guide des paramètres de génération recommande de commencer avec une température de 1,0, top-p à 0,95 et top-k à 20. Il explique aussi que le raisonnement consomme le budget de sortie. Lorsqu’une réponse s’arrête parce que la limite est atteinte, cette réponse inachevée constitue un problème différent d’une réponse complète mais incorrecte.
Employez la configuration fournie par le lanceur pour la première évaluation. Si vous changez ensuite de moteur ou de précision, notez-le avec le résultat. Sinon, une régression apparente du modèle peut venir d’un gabarit de conversation incompatible, d’une réponse tronquée ou d’un analyseur d’outils qui ne comprend pas le format généré.
L’article de vLLM documente des analyseurs d’outils et de raisonnement de type GLM-4.7 pour cette voie de service. C’est un exemple concret de ce qu’un nom dans un menu ne couvre pas. L’application doit préserver la structure pertinente de la conversation et exécuter correctement les appels d’outils prévus. Une bonne réponse de chat ne démontre pas à elle seule des modifications de fichiers fonctionnelles.
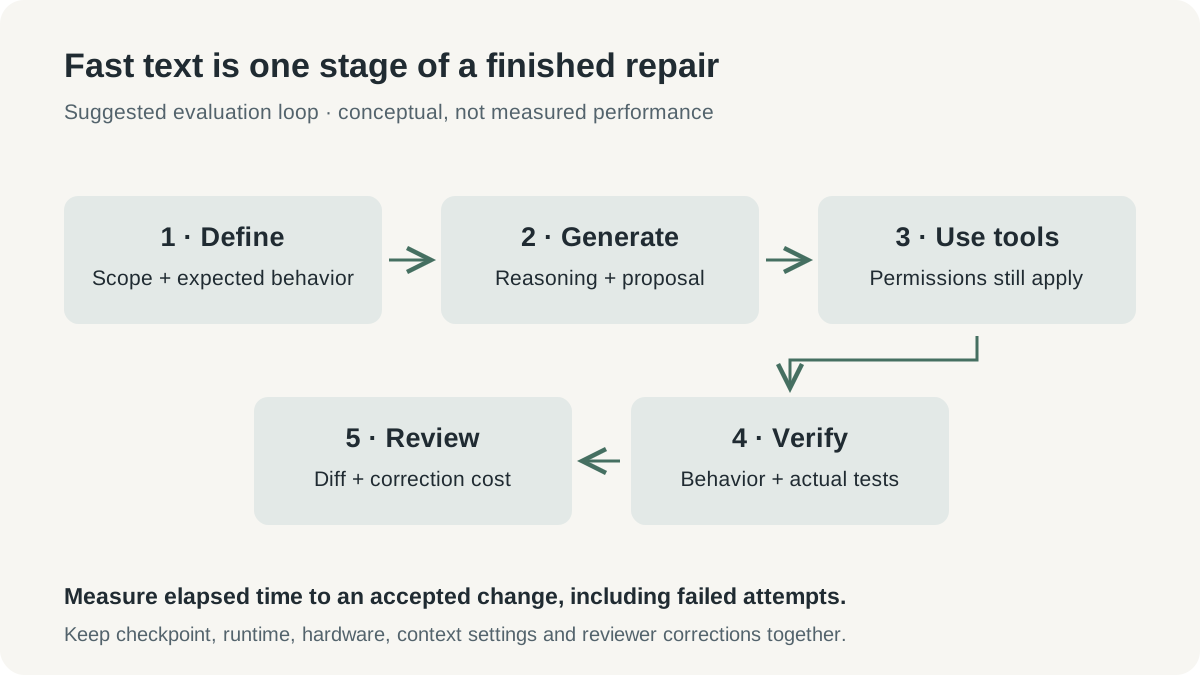
Processus conceptuel original. Le contrôle final porte sur un résultat de tâche révisé ; le schéma ne représente ni des performances mesurées ni une installation réalisée.
Une note d’évaluation peut rester courte : révision des poids, version du moteur, matériel, réglage du contexte, tâche, durée, résultat des tests et corrections du réviseur. Rejouer les mêmes tâches bornées après une mise à jour apprend davantage que comparer deux sessions dont les réglages et les objectifs ont changé. Gardez les échecs : leur coût de récupération influence l’utilité de l’outil.
L’inférence locale change la facture, pas l’existence d’un coût
Éviter les frais d’une API d’inférence peut être attractif pour un usage répété sur du matériel déjà possédé. Une équipe qui demande souvent des explications de code ou de petits tests peut préférer une capacité locale prévisible. La comparaison inclut toujours le temps d’installation, de maintenance et de révision, ainsi que le coût d’opportunité de la mémoire occupée.
Acheter un nouveau portable à grande mémoire uniquement pour une publication est un calcul différent d’essayer un modèle sur une machine compatible existante. Estimez la charge réelle avant de considérer le matériel comme une économie. Incluez les tâches qu’un plus grand modèle hébergé termine avec moins de corrections ; une répartition entre local et hébergé peut être raisonnable selon le travail.
La concurrence des requêtes mérite aussi l’attention. La documentation actuelle de rec indique que son moteur gère une génération à la fois, les requêtes qui se chevauchent pouvant recevoir HTTP 429. Une bonne expérience pour un développeur ne présage donc pas d’un serveur partagé par une équipe. Servir plusieurs agents est une autre charge et peut nécessiter un autre moteur.
L’évolution prometteuse est que le code local devient un choix de processus complet. Le calcul actif réduit de Flint, ses poids accessibles et son moteur dédié abordent différentes parties du problème. La suite attendue est davantage de preuves sur les réparations terminées dans des projets ordinaires, une prise en charge stable et un comportement clair lors de longues sessions. Ce sont ces progrès qui transforment une démonstration impressionnante en outil quotidien fiable.
Le poste de travail devient une partie de l’assistant de code
Flint demande aux développeurs d’évaluer plus qu’un score. Votre capacité mémoire, les autorisations des outils, l’environnement de l’agent et vos pratiques de révision composent l’assistant réellement vécu. La proposition est exigeante mais donne aussi du pouvoir : la boucle de développement peut être inspectée et façonnée sur une machine que vous contrôlez.
Commencez par une tâche dont vous pouvez juger le résultat. Si la boucle locale produit régulièrement une bonne modification avec une révision gérable, vous avez trouvé un outil utile. L’affirmation plus forte selon laquelle il doit prendre en charge la prochaine catégorie, plus difficile, peut attendre une preuve supplémentaire.
Sources
- Recursive : présentation de Flint, annonce de lancement ; vérifiée le 23 octobre 2026. La page autonome n’affiche pas de date de lancement fiable.
- vLLM et Recursive : prise en charge de Flint dès le lancement, 21 octobre 2026.
- Fiche officielle et caractéristiques de Flint, vérifiées le 23 octobre 2026.
- Documentation Flint de Recursive, installation et exigences de rec et paramètres de génération, vérifiés le 23 octobre 2026.
- Dépôt officiel de rec, vérifié le 23 octobre 2026.
Conserver le raisonnement derrière une décision technique
Si vous souhaitez un espace distinct pour les liens sources et vos notes techniques révisées, Telli.sh est une possibilité. Ouvrir votre espace de notes.