¿Y si tu próximo agente de programación viviera en tu Mac? Conoce Flint
El nuevo modelo local de Recursive combina 40.000 millones de parámetros totales con una pequeña parte activa. Qué cambia para repositorios privados, hardware y desarrollo real.
Marca oficial de Flint del repositorio de modelos de Recursive, mostrada sin cambios con márgenes neutros para identificación editorial. No es una captura del modelo funcionando ni evidencia de un resultado de rendimiento.
Un asistente de programación que funciona en tu propia máquina cambia una pregunta habitual. En vez de preguntar si un repositorio puede enviarse a una API, puedes preguntar si el ordenador de tu mesa puede terminar el cambio con fiabilidad. Es un cambio útil, sobre todo con código privado, experimentos repetidos o una conexión poco fiable.
Flint, de Recursive, concreta esa propuesta. Un anuncio de compatibilidad desde el primer día de vLLM, fechado el 21 de octubre de 2026, presenta el nuevo modelo de programación. Recursive describe un modelo de mezcla de expertos de unos 40.000 millones de parámetros, con aproximadamente 2.500 millones activos por token. Su motor optimizado para Mac ofrece un camino desde descargar los pesos hasta utilizarlos en un entorno real de agente de programación.
Nuestra valoración: Flint interesa porque llegan juntos el modelo, el software que lo sirve y la conexión con el agente. La decisión de compra sigue siendo la estación de trabajo completa. «2.500 millones activos» describe una parte del cálculo; no significa que un portátil con poca memoria pueda alojar todo el modelo. Esta guía explica la distinción de hardware, tres tareas iniciales útiles y una forma de evaluar programación local sin confundir texto rápido con una reparación terminada.
Un modelo local resulta útil cuando trabaja con tus herramientas
Recursive es una empresa de investigación en IA que desarrolla Eureka Machine, un sistema de investigación automatizada. Flint es un producto público de ese esfuerzo, con pesos descargables y un motor de inferencia dedicado llamado rec. Para desarrolladores que no conozcan la empresa, el punto de partida es sencillo: es un modelo de texto pensado para inspeccionar código, proponer cambios y utilizar herramientas mediante una aplicación de programación.
Importa distinguir entre el modelo y el entorno del agente. El modelo produce una respuesta o solicita una acción de herramienta. El programa que lo rodea decide qué archivos puede leer, ejecuta comandos, devuelve resultados y presenta los cambios. Instalar un modelo local no le proporciona automáticamente un proceso de desarrollo útil; conectar esas piezas forma parte de la experiencia del producto.
La documentación de configuración de Recursive enumera opciones de ejecución local junto con aplicaciones de programación, entre ellas Pi, OpenCode, Cline y OpenHands. Eso hace Flint más accesible que una publicación limitada a descargar pesos. También da opciones: conservar un editor conocido, usar el lanzador sugerido o servir el modelo por separado.
La frontera de inferencia local tiene valor, pero solo es una frontera. El entorno puede invocar un gestor de paquetes, contactar con una web de documentación o ejecutar un despliegue si sus permisos lo permiten. Para un repositorio privado, examina el endpoint del modelo y sus herramientas. Un servidor de inferencia local mantiene local la inferencia; las demás conexiones del agente siguen su propia configuración.
Cuarenta mil millones de parámetros siguen necesitando espacio
Los modelos de mezcla de expertos seleccionan una parte de sus componentes aprendidos para cada token. Esto reduce el cálculo necesario para generarlo frente a activar toda la red. Se parece a un gran taller cuyo trabajo actual solo usa algunas herramientas: el equipo inactivo sigue necesitando almacenamiento.
La ficha de Flint, consultada el 23 de octubre, especifica 39.800 millones de parámetros totales, unos 2.500 millones activos por token, y entrada y salida de texto. Documenta una configuración de contexto de 262.144 tokens, compartida entre el prompt y la salida generada. Las cifras responden a preguntas distintas, de modo que una sola etiqueta de «tamaño del modelo» no basta para planificar.
Un cálculo sencillo hace visible el almacenamiento. A exactamente cuatro bits por parámetro, 39.800 millones de parámetros contienen unos 19,9 GB de bits brutos en unidades decimales. A 16 bits, el cálculo da 79,6 GB. Son cálculos ilustrativos de bajo nivel, no tamaños de descarga medidos ni requisitos completos de RAM: metadatos, escalas de cuantización, asignaciones del motor y caché de conversación se suman al total.
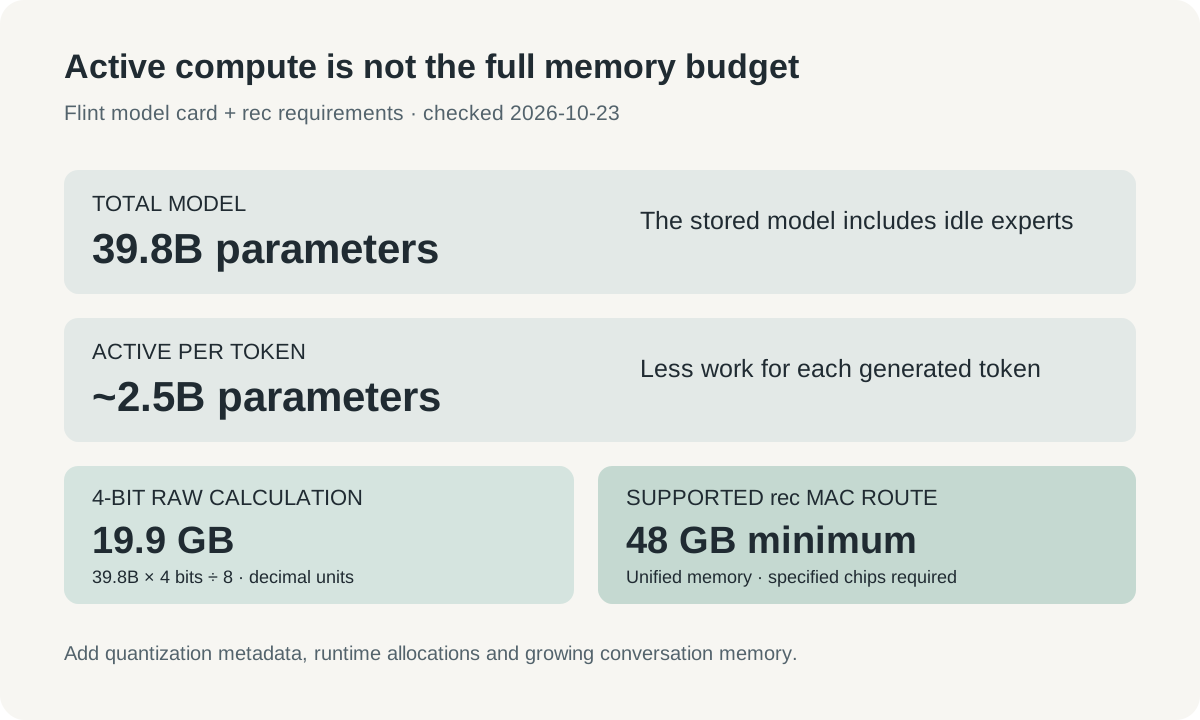
Infografía original. La aritmética de bits de parámetros es ilustrativa; los parámetros activos no especifican la memoria total del dispositivo. Las asignaciones del motor y del contexto son adicionales.
La distinción crece en importancia con la conversación. Archivos fuente, instrucciones, definiciones de herramientas, salidas de comandos y respuestas del modelo consumen contexto. Un máximo generoso permite llevar más material, pero no garantiza la misma calidad a cualquier longitud ni hace gratuito procesar prompts largos. Mantener la tarea centrada sigue siendo una decisión técnica útil.
Los requisitos actuales de rec especifican un Mac M4 Pro, M5 Pro o M5 Max, al menos 48 GB de memoria unificada y unos 30 GB de disco libre. Son requisitos de esa vía optimizada, no una promesa para cualquier Apple Silicon. Quien tenga una máquina menor debe revisar las exigencias de otro motor compatible, en vez de interpretar los parámetros activos como consejo de compatibilidad.
Una cifra de velocidad necesita un dispositivo y una longitud de contexto
La página de lanzamiento de Recursive anuncia más de 125 tokens generados por segundo en un MacBook Pro M4 Pro con contextos cortos, utilizando su motor optimizado. Es un resultado de inferencia comunicado por la empresa. La página también presenta evaluaciones de programación, pero ni el rendimiento ni una posición en una prueba predicen cuánto tardará la batería de tests de tu aplicación. Anuncio de Recursive.
El artículo de vLLM describe otro entorno: una sola GB200, decodificación con lote de uno y un contexto de 100.000 tokens. Anuncia unos 485 tokens por segundo de extremo a extremo en esa configuración. Un resultado de GPU de servidor y otro de portátil no deben compartir fila sin sus condiciones; el hardware y la pila de inferencia hacen un trabajo decisivo.
También hay diferencia entre generar un token y terminar una tarea. Un modelo puede producir más razonamiento, llamar más herramientas o elegir una reparación que requiere otro intento. La salida rápida ayuda cuando la generación es el cuello de botella. Ayuda menos cuando la fase más larga es un test de integración de diez minutos o una secuencia de cambios equivocados.
Para una evaluación cotidiana, mide el tiempo hasta que un cambio revisado supera los controles adecuados. Registra cuánta corrección humana necesitó y si alteró comportamientos ajenos. La velocidad de tokens sigue siendo información de diagnóstico, pero el resultado buscado era un parche correcto. Un asistente rápido que toma repetidamente el camino equivocado puede consumir más tarde de trabajo.
| Decisión | Evidencia útil | Qué no resuelve |
|---|---|---|
| ¿Puede el dispositivo ejecutar el modelo? | Chip, memoria, motor y pesos compatibles | Si un código concreto cabe con holgura |
| ¿La generación parece ágil? | Rendimiento con contexto y hardware especificados | Tiempo total en herramientas y tests |
| ¿Puede reparar este tipo de problema? | Resultados revisados con comprobación reproducible | Fiabilidad en categorías desconocidas |
| ¿Cumple el proceso las necesidades de privacidad? | Endpoints reales y permisos de herramientas | Todas las acciones de un entorno permisivo |
Empieza con una reparación acotada en vez de una migración completa
El primer escenario útil es un fallo normal en un repositorio que ya conoces. Imagina un analizador que maneja mal una entrada vacía. Pide a Flint que identifique la función responsable, explique su comportamiento y añada un test de regresión antes de modificar la implementación. Es una prueba propuesta, no un informe de ejecución propia.
La tarea da al asistente una meta pequeña y observable. El comportamiento esperado es explícito, los archivos pertinentes son pocos y el revisor puede comprobar si el test reproduce el fallo. Si el modelo deriva hacia una limpieza amplia, reconocerás la desviación antes de que se convierta en un parche grande. La generación local permite iterar sin factura de API por petición, pero la limitación sigue mejorando el trabajo.
Un segundo escenario es aprender un módulo privado. Pide un mapa del recorrido de una petición con referencias a archivos y verifica algunas por tu cuenta. Después haz una solicitud estrecha, como añadir una regla de validación ausente. El valor es una conversación basada en el repositorio real, en vez de una explicación genérica separada de sus contratos.
Un tercer escenario es el mantenimiento habitual de tests. Un equipo puede probar Flint con fallos ya comprendidos o pequeñas lagunas, manteniendo ocultos los resultados esperados hasta la revisión. Incluye una tarea cuya respuesta correcta sea que el comportamiento actual es intencional. Abstenerse de cambios innecesarios forma parte de la calidad del desarrollo, aunque impresione menos que una función generada grande.
Los casos difieren deliberadamente en sus resultados: una reparación, una explicación y una decisión sobre tests. El éxito en uno debe orientar el siguiente experimento, no convertirse en prueba de que toda actividad de desarrollo puede pasar al mismo modelo local.
Un Mac compatible tiene un camino corto hasta la primera tarea
La siguiente secuencia utiliza el proceso publicado de rec, consultado el 23 de octubre. Supone un Mac compatible y un repositorio que tengas permiso para inspeccionar. Son instrucciones para lectores, no evidencia de que hayamos instalado o ejecutado el modelo.
- Comprueba chip, almacenamiento libre y memoria frente a los requisitos actuales. Empieza en una rama desechable o copia de un proyecto conocido para facilitar la revisión del primer experimento.
- Abre el repositorio oficial de rec, inspecciona instrucciones e instalador y sigue la instalación documentada. La primera descarga necesita conexión aunque la inferencia posterior sea local.
- Comprueba la instalación y lanza el entorno sugerido desde el directorio del proyecto:
rec doctor
rec launch pi
- Dale una tarea concreta con comportamiento esperado, alcance pertinente y comando de verificación. Por ejemplo: explicar por qué falla un test de entrada vacía, añadir una regresión focalizada y cambiar solo la función responsable.
- Revisa las diferencias y la salida real de los tests. Al terminar, comprueba el estado del servidor y detén el motor si ya no debe ocupar memoria:
rec status
rec stop
Conviene entender la comodidad del lanzador. Recursive documenta que el servidor del modelo puede seguir funcionando al cerrar el entorno del agente o el terminal. Detener la sesión interactiva y liberar el modelo local son acciones separadas. Importa en una máquina que también se usa para compilar, navegar y trabajar con otras aplicaciones.
Conserva la configuración de generación junto al resultado
La guía de ajustes de generación recomienda empezar con temperatura 1,0, top-p 0,95 y top-k 20. Explica también que el razonamiento consume el presupuesto de salida. Cuando una respuesta se detiene por alcanzar el límite, el resultado incompleto es un problema distinto de una respuesta terminada pero incorrecta.
Usa la configuración incluida en el lanzador para la primera evaluación. Si después cambias de motor o precisión, regístralo junto al resultado. De lo contrario, una aparente regresión puede deberse a una plantilla de chat incompatible, una respuesta truncada o un analizador de herramientas que no entiende el formato generado.
El artículo de vLLM documenta analizadores de herramientas y razonamiento de estilo GLM-4.7 para esa vía. Es un ejemplo concreto de por qué ver un modelo en un desplegable no completa la integración. La aplicación debe conservar la estructura pertinente de la conversación y ejecutar correctamente las llamadas previstas. Una respuesta de chat correcta no demuestra por sí sola que la edición de archivos funcione.
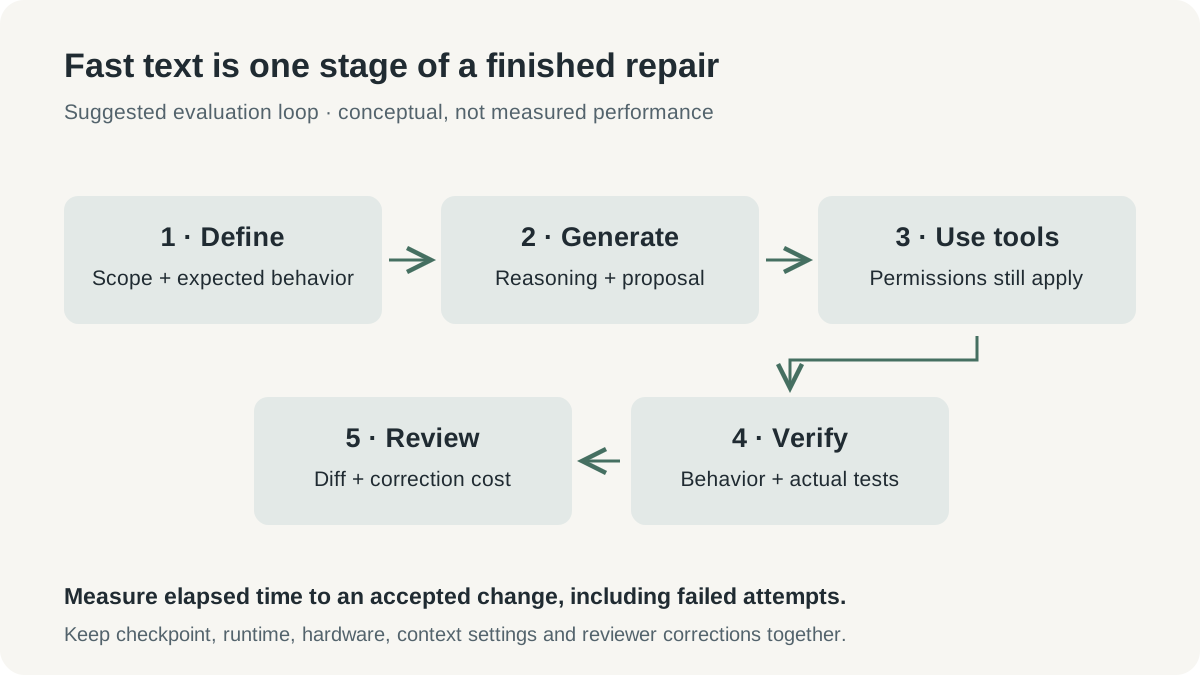
Proceso conceptual original. La comprobación final es un resultado de tarea revisado; el diagrama no representa rendimiento medido ni una instalación completada.
La nota de evaluación puede ser breve: revisión de los pesos, versión del motor, hardware, contexto, tarea, duración, resultado de tests y correcciones del revisor. Repetir las mismas tareas acotadas tras una actualización informa más que comparar dos sesiones cuyos ajustes y objetivos cambiaron. Conserva los intentos fallidos, porque su coste de recuperación influye en la utilidad de la herramienta.
La inferencia local cambia la factura, no la existencia de costes
Evitar una tarifa de API puede resultar atractivo para trabajo repetido en hardware que ya tienes. Un equipo que pide a menudo explicaciones de código o tests pequeños puede preferir capacidad local previsible. La comparación sigue incluyendo instalación, mantenimiento, revisión y el coste de oportunidad de ocupar la memoria de la máquina.
Comprar un portátil nuevo de gran memoria solo por un lanzamiento es un cálculo distinto a probar el modelo en una máquina compatible existente. Estima la carga real antes de considerar el hardware un ahorro. Incluye tareas que un modelo alojado mayor complete con menos correcciones; repartir entre local y alojado puede ser razonable cuando distintos trabajos aprovechan herramientas diferentes.
La concurrencia también merece atención. La documentación actual de rec dice que el motor gestiona una generación cada vez, y las peticiones simultáneas pueden recibir HTTP 429. Una buena experiencia individual no implica un servidor compartido para un equipo con el mismo comportamiento. Servir a varios agentes es otra carga y puede exigir otro motor.
La evolución prometedora es que la programación local se está convirtiendo en una opción de proceso completo. El cálculo activo reducido de Flint, los pesos accesibles y el motor dedicado abordan partes distintas del problema. Lo siguiente debería ser más evidencia sobre reparaciones terminadas en proyectos normales, soporte estable del motor y comportamiento claro en sesiones largas. Esas mejoras convierten una demostración impresionante en una herramienta diaria fiable.
La estación de trabajo se está convirtiendo en parte del asistente
Flint pide evaluar más que una puntuación. La capacidad de memoria, los permisos de herramientas, el entorno del agente y los hábitos de revisión forman parte del asistente que realmente experimentas. Es una propuesta exigente, pero también da control: puedes inspeccionar y configurar el ciclo de desarrollo en una máquina propia.
Empieza con una tarea cuyo resultado puedas juzgar. Si el ciclo local produce repetidamente un cambio bueno con una revisión manejable, has encontrado una herramienta útil. La afirmación más fuerte de que debe encargarse de la siguiente categoría, más difícil, puede esperar a la próxima evidencia.
Fuentes
- Recursive: presentación de Flint, anuncio de lanzamiento; consultado el 23 de octubre de 2026. La página independiente no muestra una fecha de lanzamiento fiable.
- vLLM y Recursive: compatibilidad con Flint desde el primer día, 21 de octubre de 2026.
- Ficha oficial y especificaciones de Flint, consultadas el 23 de octubre de 2026.
- Documentación de Flint de Recursive, configuración y requisitos de rec y ajustes de generación, consultados el 23 de octubre de 2026.
- Repositorio oficial de rec, consultado el 23 de octubre de 2026.
Conserva el razonamiento de una decisión técnica
Si quieres un espacio separado para enlaces de fuentes y notas técnicas revisadas, Telli.sh es una opción. Abre tu espacio de notas.