Một tệp 16,5 GB giờ đã vượt mô hình đóng mạnh nhất hồi tháng Hai
Ba năm trước, mô hình tải về tốt nhất thua GPT-4 tới 37 điểm trên HumanEval và cần hai card đồ họa mới chạy nổi. Tuần trước, một mô hình trọng số mở 27B đạt 52,0 trên chỉ số trí tuệ của Artificial Analysis, còn Claude Opus 4.6 Max là 44,9 — với một phần chín giá tiền, từ một tệp 16,5 GB. Bài so sánh trước và sau, kèm bảng benchmark, đường cong giá và ý nghĩa của độ trễ đuổi kịp đã rút xuống 162 ngày.
Một người trên Hacker News đang chạy mô hình ngôn ngữ thuộc hàng đầu ngành trên card đồ họa 16 GB, ở tốc độ 50–60 token mỗi giây, với cửa sổ ngữ cảnh 128.000 token. Mô hình đó là Qwen3.8-27B, phát hành ngày 14 tháng 8 năm 2026. Trên chỉ số trí tuệ của Artificial Analysis, nó đạt 52,0 — cao hơn Claude Opus 4.6 Max, mô hình độc quyền mạnh nhất thị trường cho tới tận tháng Hai, vốn chỉ đạt 44,9.
Năm 2023, câu vừa rồi là khoa học viễn tưởng. Mà không phải loại vui vẻ.
Bài này là phần so sánh trước và sau. Không phải tin tức về đợt phát hành — chúng tôi đã viết bài đó rồi — mà là so sánh xuyên suốt ba năm: mô hình tải về tốt nhất đạt bao nhiêu điểm trước mô hình tiên phong khi đó và bây giờ, mua một mức trí tuệ nhất định tốn bao nhiêu khi đó và bây giờ, và cần phần cứng gì để tự chạy. Mỗi con số dưới đây đều có nguồn và ngày tháng. Xu hướng chúng vẽ ra là một trong những điều lạc quan thật lòng nhất đang diễn ra trong ngành phần mềm.
Tóm tắt:
- Khoảng cách đã khép lại, và ta ghi được ngày tháng. Tháng 7 năm 2023, mô hình mở tốt nhất thua GPT-4 17,5 điểm ở MMLU và 37,1 điểm ở HumanEval. Tháng 8 năm 2026, một mô hình mở 27B thắng kỳ hạm độc quyền của tháng Hai ở 15 trong 19 benchmark mà cả hai bên đều công bố, và thắng cả trên một chỉ số tổng hợp độc lập.
- Giá giảm khoảng 208 lần trong 23 tháng, theo phép đo của Epoch AI ở ngưỡng năng lực cố định. Mô hình mở 27B hiện có giá pha trộn 1,09 đô la mỗi triệu token, so với 10,00 đô la của Opus 4.6 Max — và bằng không nếu bạn tự chạy.
- Nó không phải mô hình tiên phong, và chúng tôi nói thẳng. Claude Opus 5 Max đạt 63,1 và GPT-5.6 Sol Max đạt 60,9. Ở khả năng suy luận dựa trên kiến thức rộng, 27B thua Opus 4.6 khá xa: 30,8 so với 40,0 trên HLE.
Ảnh: Steve Jurvetson, Wikimedia Commons, CC BY 2.0. Phần đấu nối của một chiếc Cray Y-MP, khoảng năm 1988. Sức tính toán nghiêm túc từng là một căn phòng mà bạn phải bước vào.
«Trước đây» thực sự trông như thế nào
Vặn đồng hồ về ngày 18 tháng 7 năm 2023, ngày Meta công bố Llama 2. Đó là mô hình tải về tốt nhất thế giới, và chính bài báo của nó in bảng điểm đối đầu với mô hình đóng hàng đầu mà không né tránh.
Llama 2 70B đạt 68,9 ở MMLU trong khi GPT-4 đạt 86,4. Ở GSM8K là 56,8 so với 92,0. Ở HumanEval, benchmark lập trình, là 29,9 so với 67,0 — chưa được một nửa. Bài báo tự tổng kết: «Vẫn còn một khoảng cách hiệu năng lớn giữa Llama 2 70B với GPT-4 và PaLM-2-L». Đó là kỳ hạm của phe trọng số mở năm 2023, bằng chính lời nó.
Giờ đến phần cứng. Bản dựng cộng đồng 4 bit của TheBloke — cách người ta thực sự chạy Llama 2 70B — là một tệp 41,4 GB, đăng ngày 4 tháng 9 năm 2023. Muốn tốc độ dùng được, bạn cần hai card 24 GB hoặc một máy Mac 64 GB. Mô hình thực sự nhét vừa một chiếc laptop bình thường là Llama 2 13B: tệp 7,9 GB, đạt 54,8 ở MMLU, kém GPT-4 tới 31,6 điểm, và gần như chỉ dùng để trình diễn.
Vậy thỏa thuận của năm 2023 là: trả tiền cho một phòng thí nghiệm hàng đầu, hoặc chạy thứ kém hơn hẳn trên phần cứng mà phần lớn mọi người không có. Chính vì thế lập luận «cứ dùng API đi» đã thắng áp đảo suốt hai năm. Nó đúng.
Bây giờ đặt lại câu hỏi đó cho tháng 8 năm 2026
Alibaba công bố Qwen3.8-27B ngày 14 tháng 8 năm 2026 theo giấy phép Apache 2.0, kèm bảng đối đầu trực tiếp với Claude Opus 4.6 Max ngay trên thẻ mô hình. Chúng tôi đếm mọi dòng mà cả hai mô hình đều có số.
Qwen3.8-27B thắng 15 trong 19 dòng đó và thua 4. Trong số thắng có SWE-bench Pro (61,7 so với 53,4), tuân thủ chỉ dẫn ở IFBench (79,5 so với 62,5), lập trình thi đấu ở LiveCodeBench v6 (90,3 so với 88,8), điều khiển máy tính ở OSWorld-Verified (84,3 so với 72,7), tác vụ tác tử trên di động ở AndroidWorld (81,9 so với 62,0), rồi một loạt benchmark đa phương thức mà khoảng cách chẳng hề sít sao: 90,0 so với 65,5 ở MathVision, 83,7 so với 66,0 ở phân tích biểu đồ trong CharXiv, 65,5 so với 40,8 ở suy luận nhập thể trong ERQA.
Bốn lần thua quan trọng hơn mười lăm lần thắng, vì chúng cho biết một mô hình 27 tỷ tham số vẫn chưa làm được gì. Nó thua ở Terminal Bench 2.1 (73,0 so với 78,2), ở sinh mã quy mô kho mã trong NL2Repo-Bench (42,3 so với 47,6), thua sát nút ở GPQA Diamond (89,2 so với 91,3), và thua đậm ở HLE, benchmark suy luận đa ngành diện rộng: 30,8 so với 40,0. Con số cuối chính là hình dạng của toàn bộ giới hạn này. Bạn không thể nén tri thức của thế giới vào một tệp 16,5 GB; nhưng bạn nén được một lượng kỹ năng khổng lồ.
Có một dòng cần dấu hoa thị: kết quả 79,0 so với 63,8 đến từ QwenSWEBench, một benchmark do chính Qwen xây dựng. Nhà cung cấp tự chạy trên benchmark của chính mình là bằng chứng yếu nhất trong bất kỳ thẻ mô hình nào, và chúng tôi không dựa vào nó.
Bảng điểm độc lập cũng nói điều tương tự
Bảng của nhà cung cấp thì vẫn là bảng của nhà cung cấp, nên hãy xem bên thứ ba. Artificial Analysis, đơn vị tự chạy đánh giá thay vì in lại số của người khác, giờ đã đo 27B. Tính đến ngày 21 tháng 8 năm 2026, họ cho Qwen3.8-27B chỉ số trí tuệ 52,0, đứng đầu trong 135 mô hình thuộc hạng trọng số mở từ 4 đến 40 tỷ tham số, so với 44,9 của Claude Opus 4.6 Max. Đó là 7,1 điểm nghiêng về mô hình mở, do một bên không có lợi ích trong kết quả đo, 190 ngày sau khi Opus 4.6 ra mắt.
Lần ngược phép so sánh đó theo thời gian, và đó mới là câu chuyện. Tháng 7 năm 2023, mô hình mở tốt nhất dưới 40 tỷ tham số đạt 2,6 trên cùng chỉ số. Tháng 7 năm 2024 là 7,4. Tháng 3 năm 2025 là 13,4. Tháng 2 năm 2026 là 34,6. Tuần trước là 52,0.
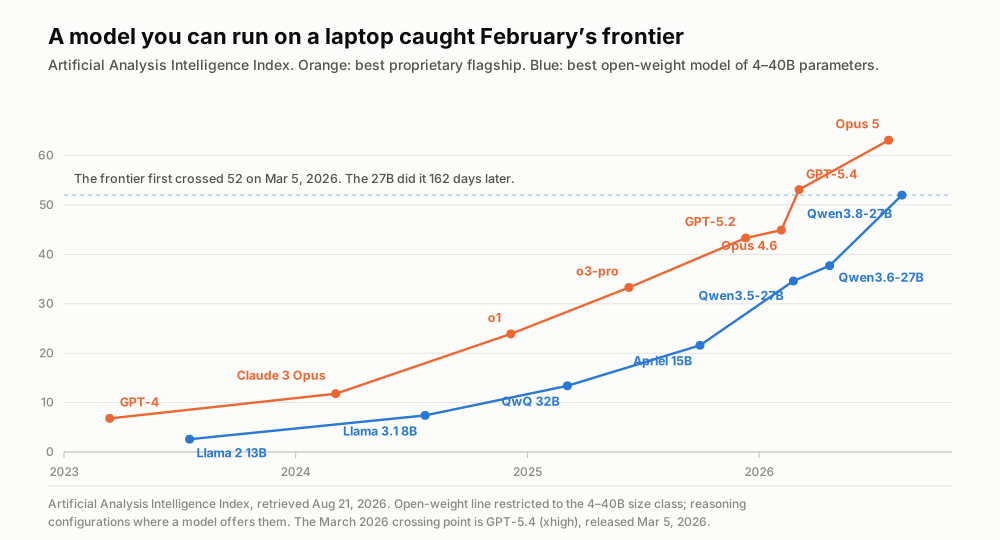
Cả hai đường đều đi lên; đại lượng đáng chú ý là khoảng cách ngang giữa chúng. Chỉ số trí tuệ Artificial Analysis, truy xuất ngày 21 tháng 8 năm 2026.
Đây là con số xứng đáng có tên gọi. Nhóm tiên phong lần đầu vượt mốc 52 vào ngày 5 tháng 3 năm 2026, khi GPT-5.4 ở mức nỗ lực suy luận cao nhất đạt 53,1. Một mô hình đủ nhỏ để chạy trên máy cá nhân chạm mốc đó vào ngày 14 tháng 8 — 162 ngày sau. Hãy gọi đó là độ trễ đuổi kịp: khoảng thời gian giữa lúc một năng lực xuất hiện ở nhóm tiên phong và lúc nó xuất hiện trên phần cứng của bạn.
Độ trễ ấy từng dài hơn nhiều. Llama 3.1 8B mất 260 ngày để chạm mức mà GPT-4 Turbo đã đạt. GLM-4.7-Flash mất 410 ngày để ngang o1. Ba đợt phát hành cỡ laptop gần nhất lần lượt là 201, 155 và 162 ngày. Nhóm tiên phong không hề chậm lại — Opus 5 Max hôm nay ở mức 63,1 — nhưng mép sau đang thu hẹp khoảng cách nhanh gấp khoảng hai lần so với hai năm trước.
Giá không giảm, mà sụp
Năng lực chỉ là một nửa của phép so sánh. Nửa còn lại là hóa đơn.
Epoch AI công bố phép đo sạch sẽ nhất về chuyện này vào tháng 3 năm 2025, và phương pháp rất đáng hiểu: cố định một điểm số benchmark, rồi theo dõi theo thời gian mô hình rẻ nhất đạt được điểm đó. Đặt ngưỡng ở mức 86 điểm MMLU của GPT-4, cái thang giá sẽ là 37,50 đô la mỗi triệu token vào tháng 3 năm 2023, 15,00 vào tháng 11 năm 2023, 7,50 vào tháng 5 năm 2024, 2,19 vào cuối chính tháng đó, và 0,18 vào tháng 2 năm 2025. Điểm số y nguyên. Rẻ hơn 208 lần trong 23 tháng.
Phát hiện chính của Epoch là tốc độ này chênh lệch rất lớn tùy tác vụ — từ 9 đến 900 lần mỗi năm tùy vào năng lực được cố định — trong đó giá cho hiệu năng cỡ GPT-4 ở các câu hỏi khoa học trình độ tiến sĩ giảm khoảng 40 lần mỗi năm. Chỉ có hướng đi là không bao giờ đổi.
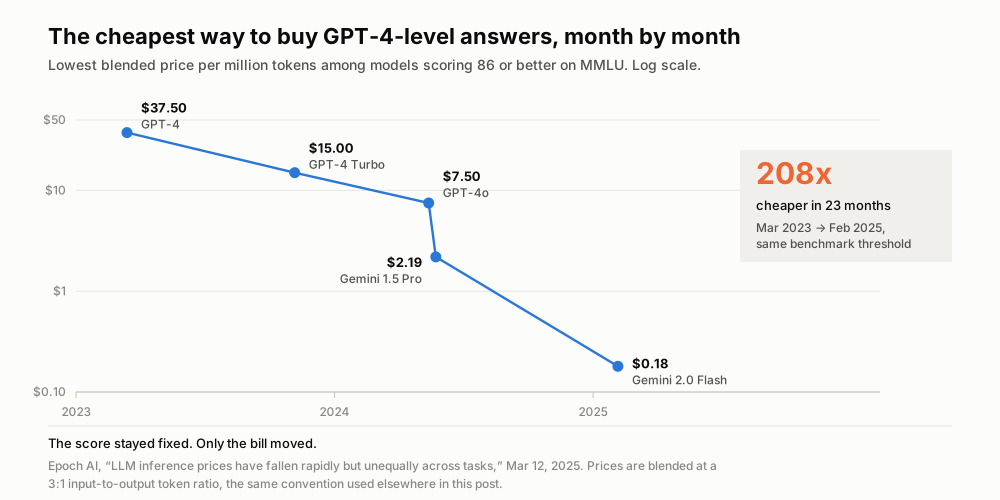
Ở mọi điểm trên đường này, điểm benchmark đều được giữ cố định. Epoch AI, ngày 12 tháng 3 năm 2025.
Kéo dài chuỗi đó tới giá hôm nay thì xu hướng vẫn tiếp diễn. Trên danh mục OpenRouter ngày 21 tháng 8 năm 2026, Qwen3.8-27B có giá 0,45 đô la mỗi triệu token đầu vào và 3,20 đô la mỗi triệu token đầu ra; Claude Opus 4.6 là 5,00 và 25,00. Pha trộn theo tỷ lệ 3:1 mà Epoch dùng, ta có 1,09 so với 10,00 đô la — mô hình mở rẻ hơn 9,1 lần và cao hơn 7,1 điểm chỉ số so với kỳ hạm đóng của sáu tháng trước.
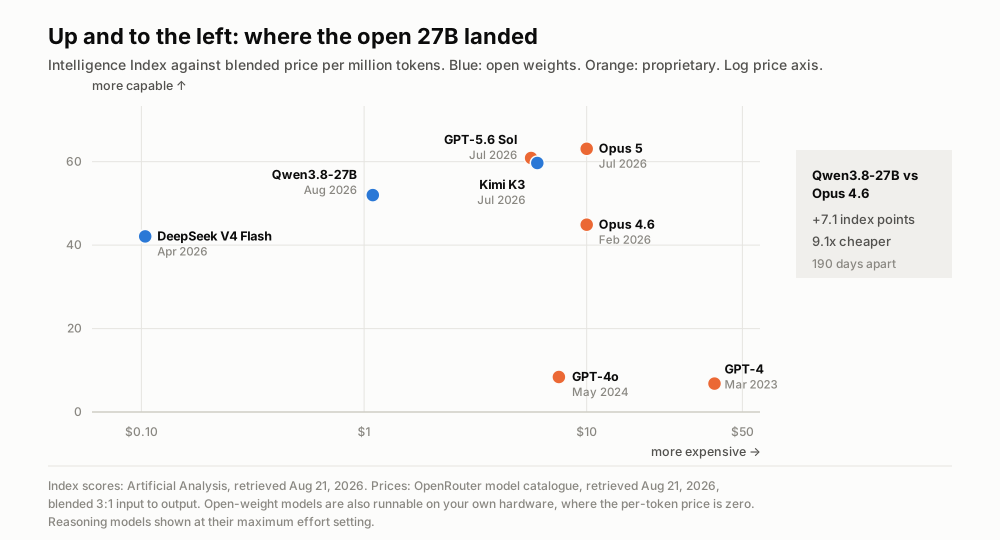
Mọi mô hình đáng kể đều đang dịch về góc trên bên trái. Điểm số từ Artificial Analysis, giá từ OpenRouter, đều truy xuất ngày 21 tháng 8 năm 2026.
Và còn một lựa chọn hoàn toàn không có giá theo token. Chạy 27B trên chiếc RTX 4090 của bạn ở mức khoảng 48 token mỗi giây mà người dùng báo cáo trong luồng thảo luận phát hành, giả định công suất danh định 450 watt của card, rồi áp giá điện sinh hoạt trung bình tại Mỹ là 18,44 xu mỗi kilowatt giờ (EIA, tháng 5 năm 2026), tiền điện rơi vào khoảng 0,48 đô la mỗi triệu token đầu ra — chưa tính tiền card, và đã hết tính lợi nhuận của bất kỳ ai. Đây là ước tính có tính toán với đầy đủ giả định đặt lên bàn, không phải tuyên bố của nhà cung cấp.
Trước và sau, từng dòng một
| Tháng 7/2023 | Tháng 8/2026 | |
|---|---|---|
| Mô hình tải về tốt nhất | Llama 2 70B (Meta, 18/7/2023) | Qwen3.8-27B (Alibaba, 14/8/2026) |
| Tham số | 70 tỷ | 27 tỷ |
| Bản dựng cộng đồng 4 bit tiêu chuẩn | 41,4 GB | 16,5 GB |
| Bản dựng nhỏ nhất còn dùng được | 7,9 GB (13B, MMLU 54,8) | 9,8 GB (2 bit, ngữ cảnh 128K trên card 16 GB) |
| Phần cứng thực tế | hai GPU 24 GB hoặc một Mac 64 GB | một GPU phổ thông 16 GB |
| Mô hình tiên phong thời điểm đó | GPT-4 (14/3/2023) | Claude Opus 4.6 Max (5/2/2026) |
| Kết quả đối đầu | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | thắng 15 trong 19 benchmark công bố, +7,1 điểm chỉ số |
| Giá pha trộn của mô hình tiên phong đó | 37,50 $ mỗi triệu token | 10,00 $ mỗi triệu token |
| Giá pha trộn của mô hình mở | không có nguồn cung quy mô lớn | 1,09 $ mỗi triệu token |
| Giấy phép | Llama 2 Community License | Apache 2.0 |
Nguồn cho từng ô nằm ở cuối bài. Dòng mà chúng tôi cứ quay lại là dòng áp chót: giá của chính nhóm tiên phong giảm 3,75 lần trong ba năm, trong khi lựa chọn mở xuất hiện bên dưới, ở mức khoảng một phần mười. Cả hai đều đã xảy ra. Điều làm thay đổi chuyện ai được phép xây dựng là điều thứ hai.
Những gì vẫn chưa đúng
Sự phấn khích quanh đợt phát hành này vượt trước bằng chứng ở bốn điểm cụ thể. Hãy đánh dấu chúng.
Nó không phải nhóm tiên phong. Trên cùng chỉ số, Claude Opus 5 Max đạt 63,1 và GPT-5.6 Sol Max đạt 60,9, đều bỏ xa mức 52,0. Nếu công việc của bạn phụ thuộc vào khả năng suy luận khó nhất hiện có, nhóm tiên phong vẫn là một sản phẩm khác, và vẫn đóng.
So với kích thước thì nó không hề rẻ. Chính phần tóm tắt của Artificial Analysis gọi Qwen3.8-27B là «đặc biệt đắt khi so với các mô hình trọng số mở cùng cỡ»: trung vị của hạng này là 0,05 đô la mỗi triệu token đầu vào, còn Qwen là 0,43. Bạn đang trả tiền cho năng lực, không phải cho số tham số.
Nó dài dòng, và dài dòng nghĩa là tốn tiền. Khi chạy bộ đánh giá chỉ số trí tuệ, 27B sinh ra 160 triệu token đầu ra, trong khi trung vị là 45 triệu. Một người dùng đưa cho nó câu lệnh hai chữ trên chiếc Mac mini 64 GB và ngồi xem nó nghĩ suốt 17 phút 12 giây. Mô hình suy luận tính tiền bằng thời gian thực, ngay cả khi token miễn phí.
Và điểm benchmark thuộc về mô hình ở độ chính xác đầy đủ. Bản 2 bit nặng 9,8 GB vừa với card của bạn không phải là mô hình đã đạt 52,0. Lượng tử hóa mạnh làm mất độ chính xác, nhất là ở ngữ cảnh dài. Mọi tuyên bố kiểu «chạy được trên laptop», kể cả của chúng tôi, đều đi kèm dấu hoa thị đó.
Vì sao độ trễ sẽ tiếp tục co lại
Từ đây trở đi là quan điểm của chúng tôi, và chúng tôi đánh dấu rõ bước ngoặt: mọi thứ phía trên là đo lường, phần sau là suy luận từ đó.
Cơ chế kéo độ trễ đuổi kịp xuống không có gì bí ẩn. Các kỹ thuật huấn luyện hậu kỳ được công bố ở nhóm tiên phong sẽ được tái hiện trong các phòng thí nghiệm mở chỉ sau vài tháng. Việc điều chỉnh mức nỗ lực suy luận, mười tám tháng trước còn là mẹo độc quyền, nay xuất hiện như một tham số có tài liệu trên chính thẻ mô hình này. Việc lượng tử hóa của cộng đồng hoàn tất trước cả khi tài liệu của phòng thí nghiệm gốc ngừng thay đổi. Không vòng phản hồi nào trong ba vòng đó có lý do chậm lại, và hai trong số đó còn nhanh hơn khi càng nhiều người tham gia.
Vậy kỳ vọng hợp lý cho thế hệ tiếp theo không phải là mô hình mở vượt mặt nhóm tiên phong. Mà là con số 162 ngày tiếp tục nén lại trong khi năng lực tuyệt đối ở cả hai đầu đều tăng. Khi đó, ngưỡng đáng quan tâm không còn là «mô hình mở có thắng được không» mà là «nhóm tiên phong phải mới đến mức nào thì khác biệt mới hết quan trọng với công việc của tôi». Với gỡ băng cuộc họp, dịch thuật, tóm tắt và phần lớn công việc tài liệu, ngưỡng đó đã bị vượt qua từ lâu. Với nghiên cứu tiên phong và kỹ thuật tác tử khó nhất thì chưa.
Đó là một thế giới tốt hơn hẳn thế giới năm 2023, và điều này đáng được nói thẳng. Chi phí để trao cho máy tính khả năng hiểu ngôn ngữ ở mức thành thạo đã giảm hai bậc độ lớn trong ba năm và vẫn đang giảm. Người hưởng lợi nhiều nhất là những người từng bị giá cả gạt ra ngoài: lập trình viên đơn độc, các nhóm ở những quốc gia mà 10 đô la mỗi triệu token không phải sai số làm tròn, nhà nghiên cứu có tài trợ chứ không có ngân sách, và bất kỳ ai cần dữ liệu ở lại trên máy của mình vì lý do pháp lý.
Chốt lại: nhóm tiên phong không còn là một nơi chốn, mà là một mốc ngày
Câu hỏi cũ là bạn có quyền dùng phòng thí nghiệm nào. Câu hỏi mới là bạn chấp nhận đi sau nhóm tiên phong bao nhiêu tháng, khi giá chỉ bằng một phần chín và chạy trên phần cứng của chính bạn.
Với ngày càng nhiều công việc, câu trả lời trung thực là: khoảng năm tháng, và đang ngắn dần.
Telli.sh đứng ở đâu: tất cả những điều trên chính là lý do chúng tôi xây trên mô hình mở thay vì bám quanh một nhà cung cấp duy nhất. Telli.sh vốn đã dùng một mô hình Qwen mở trong luồng tóm tắt, nên mỗi bậc đi xuống trên đường cong này đến tay bạn dưới dạng biên bản họp tốt hơn, chứ không phải một thông báo tăng giá. Việc chúng tôi làm là phần mà không bản tải nào đưa cho bạn: thu trọn một giờ âm thanh mà không đứt quãng, tách bạch người nói, dịch trực tiếp qua 15 ngôn ngữ, và biến tất cả thành ghi chú mà nhiều tháng sau bạn vẫn tìm được.
Nguồn
- Thẻ mô hình và bảng benchmark Qwen3.8-27B, Hugging Face — số liệu đối đầu với Opus 4.6 Max, truy xuất ngày 21 tháng 8 năm 2026
- Artificial Analysis: phân tích trí tuệ, hiệu năng và giá của Qwen3.8 27B — chỉ số trí tuệ 52,0, giá và mức dài dòng, truy xuất ngày 21 tháng 8 năm 2026
- Artificial Analysis: trang mô hình Claude Opus 4.6 — chỉ số trí tuệ 44,9 ở mức nỗ lực suy luận cao nhất, truy xuất ngày 21 tháng 8 năm 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», ngày 12 tháng 3 năm 2025 — thang giá ở ngưỡng cố định và biên độ 9 đến 900 lần mỗi năm
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), ngày 18 tháng 7 năm 2023 — bảng 4, Llama 2 70B đối đầu GPT-4
- Danh sách tệp TheBloke/Llama-2-70B-Chat-GGUF — bản Q4_K_M 41,4 GB, đăng ngày 4 tháng 9 năm 2023
- Danh sách tệp unsloth/Qwen3.8-27B-GGUF — các bản 16,5 GB và 9,8 GB, số lượt tải truy xuất ngày 21 tháng 8 năm 2026
- Danh mục mô hình OpenRouter — giá theo token của Qwen3.8-27B, Claude Opus 4.6 và Claude Opus 5, truy xuất ngày 21 tháng 8 năm 2026
- Thảo luận trên Hacker News về đợt phát hành Qwen3.8-27B, ngày 14 tháng 8 năm 2026 — báo cáo thông lượng thực tế trên card 16 và 24 GB
- Cơ quan Thông tin Năng lượng Hoa Kỳ, Electric Power Monthly, bảng 5.3 — 18,44 xu mỗi kilowatt giờ, trung bình hộ gia đình, tháng 5 năm 2026
- Bài viết trước của chúng tôi về đợt công bố trọng số mở Qwen3.8 và về làn sóng trọng số mở rộng hơn
- Trang Wikimedia Commons của bức ảnh Cray Y-MP
