Cuộc bứt tốc ba tuần của trọng số mở Trung Quốc: Kimi K3, Qwen3.8-Max và bước ngoặt có thể chấm dứt tất cả
Trong ba tuần, các phòng lab AI lớn nhất Trung Quốc đã phát hành hoặc hé lộ những mô hình trọng số mở cấp tiên phong — Kimi K3, Qwen3.8-Max và DeepSeek V4 ở trạng thái phát hành chính thức. Một hướng dẫn bằng ngôn ngữ dễ hiểu: mỗi mô hình là gì, điều gì thực sự ra mắt và điều gì vẫn là lời hứa, và vì sao Bắc Kinh giờ có thể siết lại chính làn sóng mà họ tạo ra.
Từ ngày 16 đến 26 tháng 7, ba trong số các phòng lab AI lớn nhất Trung Quốc đã đặt lên bàn những mô hình mở cấp tiên phong. Moonshot AI công bố Kimi K3 vào ngày 16 tháng 7 và phát hành trọng số vào ngày 26 tháng 7. Alibaba ra mắt Qwen3.8-Max ngày 19 tháng 7 tại WAIC ở Thượng Hải. Dòng V4 của DeepSeek đạt trạng thái phát hành chính thức (GA) vào khoảng ngày 20 tháng 7. Ba phòng lab, khoảng ba tuần.
Khuôn mẫu này khó mà bỏ qua, và nó không phải là thứ đã làm nên danh tiếng của giới mô hình mở Trung Quốc. Các phòng lab này vốn nổi tiếng với những mô hình nhỏ, nhanh, rẻ nhưng đấm trên hạng cân của mình. Làn sóng này là canh bạc ngược lại: những hệ thống nghìn tỷ tham số, được phát hành hoặc hứa hẹn dưới dạng trọng số mở.
Đây là một góc nhìn thẳng thắn về làn sóng ấy: điều gì thực sự ra mắt, điều gì vẫn còn là bản xem trước hay lời hứa, và bước ngoặt đến kèm theo nó — chính phủ đã khiến các đợt phát hành này thành hiện thực nay đang cân nhắc có nên siết lại hay không. Chúng tôi sẽ hạn chế thuật ngữ ở mức tối thiểu và giải thích phần còn lại dọc đường, để bạn theo dõi được câu chuyện ngay cả khi "trọng số mở" và "mixture-of-experts" còn mới mẻ. Nếu bạn đã đọc bài tổng hợp tháng 7 của chúng tôi, thì đây là phần tiếp theo, và một trong những nút thắt bỏ ngỏ khi đó đã được gỡ.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Trước tiên, năm ý niệm giúp mọi thứ trở nên sáng tỏ
Nếu bạn mới đến góc này của AI, năm thuật ngữ gánh phần lớn câu chuyện, và đáng bỏ ra một phút bằng ngôn ngữ dễ hiểu trước khi bước vào các mô hình.
"Trọng số mở" (open weights) chính là toàn bộ lý do khiến làn sóng này quan trọng. Trọng số của một mô hình là tấm lưới khổng lồ các con số mà nó học được trong quá trình huấn luyện — thực chất là bộ não đã hoàn thiện. Khi một phòng lab phát hành trọng số, bạn có thể tải tệp đó về, chạy mô hình trên phần cứng của mình, chỉnh sửa nó và xây sản phẩm trên đó mà không cần xin phép ai hay trả tiền theo lượt gọi. Cách còn lại là mô hình đóng, như hầu hết các chatbot thương mại, nơi trọng số bị khóa trên máy chủ của nhà cung cấp và bạn thuê quyền truy cập qua một API trả phí. Trọng số mở biến một mô hình từ dịch vụ bạn đi thuê thành thứ bạn sở hữu một bản sao, và chính sự khác biệt đó khiến cả một ngành dỏng tai lên khi một mô hình tốt xuất hiện.
"Tham số" (parameters) là những con số đã học ấy, và số lượng của chúng là chỉ dấu thô cho biết một mô hình có thể chứa được bao nhiêu. Một mô hình "2,8 nghìn tỷ tham số" có 2,8 nghìn tỷ con số đó. Lớn hơn không tự động là tốt hơn, nhưng ở biên giới, nó thường có nghĩa là nhiều dư địa để suy luận hơn — và, quan trọng không kém, cần nhiều phần cứng hơn để chạy. Đó là lúc "mixture-of-experts" (MoE) bước vào. Thay vì kích hoạt mọi tham số cho từng từ, một mô hình MoE được chia thành nhiều mạng con chuyên biệt gọi là chuyên gia, và một bộ định tuyến chỉ chọn một nhúm cho mỗi token. Vậy nên khi bạn thấy "tổng 2,8 nghìn tỷ, hoạt động 104 tỷ", nghĩa là mô hình khổng lồ nhưng tại một thời điểm chỉ khoảng 104 tỷ tham số thực sự làm việc — như một bệnh viện có hàng nghìn bác sĩ chuyên khoa nhưng mỗi bệnh nhân chỉ được vài người liên quan khám. Con số tổng gợi ý nó có thể mạnh đến đâu; con số hoạt động cho biết phục vụ nó tốn kém ra sao. Khoảng cách ấy là con số đơn lẻ hữu ích nhất để đánh giá chi phí.
"Cửa sổ ngữ cảnh" (context window) là lượng văn bản mô hình có thể giữ trong đầu cùng một lúc, đếm bằng token — và một token bằng khoảng ba phần tư một từ. Cửa sổ một triệu token không phải là thông số trừu tượng: nó là vài cuốn tiểu thuyết dài, hoặc hàng chục bản ghi cuộc họp dài một giờ, trong một lượt. Đó là khác biệt giữa tóm tắt một email và suy luận trên cả một quý email.
Cuối cùng là giấy phép — và đây là phần mà người làm nghề nên đọc trước tiên, trước cả các benchmark. Giấy phép là dòng chữ pháp lý nhỏ nói bạn được làm gì với trọng số. MIT là chuẩn vàng: dùng, sửa, đưa vào sản phẩm thương mại, chẳng nợ ai gì. Một giấy phép riêng có thể trông có vẻ mở nhưng lại khoét đi đúng cái công dụng bạn đang nhắm tới — chẳng hạn tính phí bạn một khi doanh nghiệp xây trên nó lớn lên. Hai mô hình có thể cùng là "trọng số mở" mà cách xa nhau một trời một vực về những gì bạn được phép làm theo luật. Vậy nên đọc dòng này trước khi phải lòng một điểm số là điều đáng làm. Nắm trong tay năm ý niệm này, làn sóng đọc lên rõ ràng.
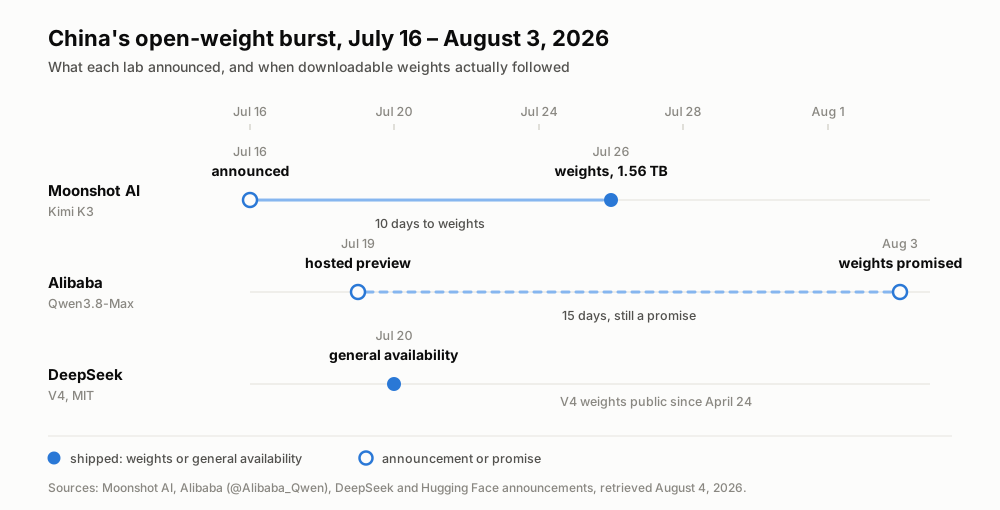
Ba phòng thí nghiệm, ba tuần — và trong năm thời điểm này chỉ hai lần thực sự đưa trọng số vào tay người khác. Ngày lấy từ thông báo của chính các phòng thí nghiệm, kiểm tra ngày 4/8/2026.
Kimi K3 mới là thứ thực sự ra mắt
Hãy bắt đầu với Moonshot AI, phòng lab ở Bắc Kinh đứng sau trợ lý Kimi, đã dành cả năm qua gây dựng danh tiếng bằng những mô hình mở lớn và có năng lực. Khi chúng tôi viết về Kimi K3 hồi tháng 7, trọng số vẫn chỉ là một lời hứa — Moonshot từng nói "trước ngày 27 tháng 7". Chúng đã đến vào ngày 26 tháng 7: 1,56 terabyte chia thành 96 phân mảnh trên Hugging Face, dưới moonshotai/Kimi-K3. Đó mới là tin tức. Một thông báo là bản tin báo chí; trọng số tải về được là một sự thật mà bạn có thể dựng đồ lên trên.
Nói mộc mạc, K3 là một trong những mô hình mở lớn nhất từng được phát hành — một hệ mixture-of-experts với 2,8 nghìn tỷ tham số tổng cộng và khoảng 104 tỷ tham số hoạt động trên mỗi token, định tuyến chừng 16 trong số 896 chuyên gia qua một cơ chế mà Moonshot gọi là Kimi Delta Attention, với cửa sổ ngữ cảnh một triệu token và mức tăng hiệu quả mở rộng được báo cáo khoảng 2,5x so với tiền nhiệm K2. Cởi bỏ ngôn ngữ bảng thông số: nó rất lớn, chạy tương đối tiết kiệm so với cỡ của nó vì mỗi token chỉ một phần được kích hoạt, và có thể nuốt trọn một lượt những đầu vào dài như cả cuốn sách.
Những con số đó cũng cho biết ai mới thực sự chạy nó. 1,56 terabyte trong 96 phân mảnh không phải thứ tải về máy tính xách tay; nó là một hiện vật cỡ trung tâm dữ liệu, chỉ để nạp lên đã cần cả một cụm bộ tăng tốc cao cấp. Trên thực tế gần như không cá nhân nào tự host K3 — họ tiếp cận nó qua các nhà cung cấp vốn đã có sẵn phần cứng, và thị trường đó đến ngay ngày đầu tiên: Together AI và Modal đều dựng endpoint lưu trữ Kimi K3 vào đúng lúc trọng số đáp xuống. Đó cũng là cách một độc giả tò mò thử nó hôm nay — không phải tải 1,56 TB, mà gọi một trong những endpoint lưu trữ đó hoặc dùng ứng dụng Kimi. "Mở" ở đây nghĩa là trọng số được công khai và bất kỳ ai có phần cứng đều có thể phục vụ chúng, và chính điều đó giữ cho giá cả cạnh tranh; nó không có nghĩa là bạn sẽ tự chạy nó trên bàn làm việc của mình.
Nó có tốt không? Theo con số độc lập duy nhất mà chúng tôi tin tưởng vòng này, có. Trong bảng xếp hạng của Artificial Analysis, nó đứng thứ 4 trong 189 mô hình — sau Claude Fable 5 và hai cấu hình GPT-5.6 "Sol", trên Opus 4.8 và GPT-5.5. Với một mô hình mở mà bạn có thể tải về, chỉ riêng việc có mặt trong nhóm đó đã là câu chuyện.
Rồi hãy đọc giấy phép, vì đây là nơi "mở" bị gắn một dấu sao. Kimi K3 không phải MIT. Nó phát hành dưới giấy phép riêng "Kimi K3 License", không được OSI phê duyệt và kèm điều khoản ngưỡng doanh thu: vận hành K3 làm động cơ cho một doanh nghiệp Model-as-a-Service lớn thì cần một thỏa thuận riêng với Moonshot. Với một lập trình viên đơn lẻ, hay một công ty bình thường dùng nội bộ, điều đó chẳng đổi thay gì. Nhưng với bất kỳ ai xây một sản phẩm lưu trữ quy mô lớn, "trọng số mở" và "giấy phép mở" là hai câu hỏi khác nhau — và ở đây, chỉ câu đầu tiên mới là một cái "có" rõ ràng.
Qwen3.8-Max là bản xem trước, không phải bản tải về
Qwen là dòng mô hình của Alibaba, và đội ngũ của nó nằm trong số những nơi ra mô hình mở nhiều nhất thế giới — và chính lịch sử ấy khiến bản mới nhất trở nên khó hiểu. Ra mắt ngày 19 tháng 7 tại WAIC ở Thượng Hải, Qwen3.8-Max là dòng tít lớn nhất của làn sóng, và cũng mềm nhất. Đây là một MoE thưa 2,4 nghìn tỷ tham số — số tham số hoạt động chưa công bố — và là Qwen đầu tiên vượt mốc một nghìn tỷ tham số đạt đa phương thức, tức nhận đầu vào không chỉ văn bản mà cả hình ảnh, video và tài liệu.
Đây là cái bẫy mà người mới cần được chỉ rõ: bất chấp sự rình rang, bạn không thể tải nó về. Ngay lúc này nó chỉ tồn tại như một "bản xem trước được lưu trữ" — qwen3.8-max-preview, tiếp cận qua chính dịch vụ của Alibaba (Token Plan và công cụ Qoder của họ) ở mức khoảng 10% giá tiêu chuẩn. Bản xem trước được lưu trữ nghĩa là Alibaba chạy mô hình trên máy chủ của họ và cho bạn gọi; đó là mô hình API đi thuê, không phải mô hình sở hữu một bản sao. Gọi nó hôm nay là một đợt phát hành trọng số mở là quá sớm.
Bức tranh đó đã thay đổi vào ngày 3 tháng 8. Tài khoản Qwen chính thức trên X, @Alibaba_Qwen, đăng rằng trọng số mở của Qwen3.8-Max sẽ đến "tuần tới" — và một Qwen3.8-27B nhỏ hơn cũng sẽ chuyển sang trọng số mở. Vậy nên 27B không phải tin đồn, dù trước đó có bàn tán gì đi nữa: đó là một cam kết chính thức, giấy trắng mực đen, từ chính tài khoản của Alibaba. Và kích thước mới là điều cốt lõi. Trong khi Max 2,4 nghìn tỷ tham số, giống K3, là thứ chỉ trung tâm dữ liệu mới chạy nổi, thì 27B đủ nhỏ để phục vụ trên một cỗ máy cao cấp đơn lẻ — đúng cỡ mà một cá nhân hay một nhóm nhỏ thực sự có thể tự host. Điều đó thực sự làm dịu bức tranh "hứa mà không có chi tiết": giờ đã có kích thước và một mốc thời gian đại khái.
Dù vậy, những lời cảnh báo thành thật vẫn còn nguyên. "Tuần tới" là một hướng đi, không phải ngày giao hàng, và tính đến lúc viết bài này, ngày 4 tháng 8, chưa có gì xuất hiện trên tổ chức Qwen tại Hugging Face — các mô hình mới nhất ở đó là từ tháng 6. Giấy phép trọng số mở cũng chưa được công bố, và những người đọc điều khoản bản xem trước sớm đã nêu khả năng có hạn chế theo khu vực, chưa xác nhận cho tới khi giấy phép thật xuất hiện — đúng bài học "giấy phép trước tiên" từ phần vỡ lòng. Tuyên bố của Alibaba rằng mô hình "chỉ xếp sau Fable 5" vẫn là một khẳng định tự thân không có con số bên thứ ba, nên hãy coi đó là câu tiếp thị của nhà cung cấp cho đến khi ai đó bên ngoài Alibaba đo đạc. Nếu muốn thử mô hình hôm nay, bản xem trước được lưu trữ là cánh cửa duy nhất — nhưng lần đầu tiên, thời gian chờ trọng số tải về được đo bằng "tuần tới", chứ không phải "một ngày nào đó".
DeepSeek V4 lặng lẽ đạt phát hành chính thức
DeepSeek là phòng lab có mô hình R1 giúp châm ngòi cuộc đua mô hình mở hiện nay hồi đầu năm 2025, và đúng phong cách, lần này họ phô trương ít nhất mà giao ra thứ dùng được nhất. Dòng V4 của họ, phát hành từ ngày 24 tháng 4, là dòng bạn có thể áp dụng suôn sẻ nhất, vì nó đến dưới giấy phép mà phần vỡ lòng đã gọi là chuẩn vàng.
V4 có hai kích cỡ, cả hai đều cấp phép MIT. V4-Pro là mẫu đầu bảng với 1,6 nghìn tỷ tổng và 49 tỷ tham số hoạt động; V4-Flash là mẫu nhẹ với 284 tỷ tổng và 13 tỷ hoạt động. Hãy nhớ con số hoạt động nghĩa là gì: V4-Flash chỉ kích hoạt 13 tỷ tham số mỗi token, khiến nó rẻ và nhanh khi phục vụ, và đó chính là điều biến nó thành lựa chọn tiết kiệm cho công việc khối lượng lớn — kiểu tải "gỡ băng và tóm tắt" mà chi phí trên mỗi token quyết định tất cả. Cả hai đều có cửa sổ ngữ cảnh một triệu token và có thể tạo tới 384K token đầu ra trong một phản hồi, đủ để soạn một báo cáo dài chứ không chỉ một đoạn văn. Khoảng ngày 20 tháng 7, V4 đạt phát hành chính thức với cách tính giá theo thời gian, và chính điều đó kéo một đợt ra mắt mùa xuân vào cùng khung ba tuần với K3 và Qwen.
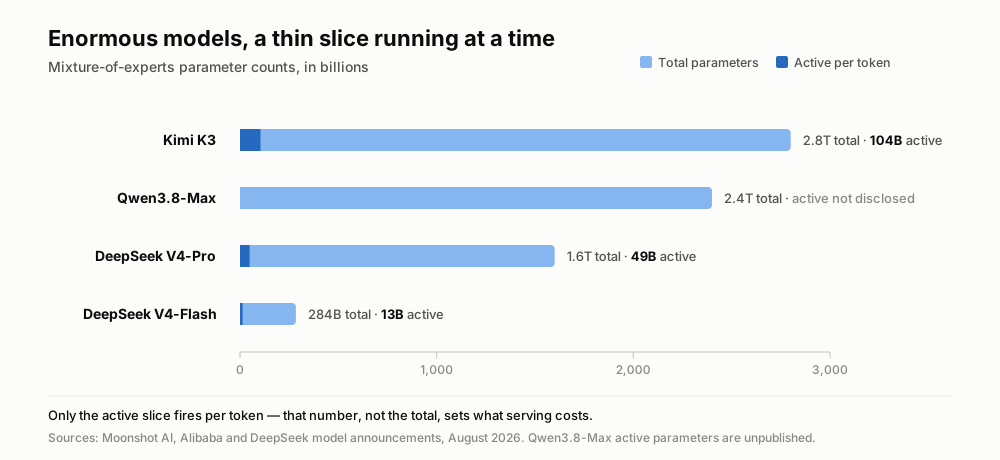
Cột nhạt là độ lớn của mô hình; đoạn đậm là phần thực sự chạy trên mỗi token. Alibaba chưa công bố số tham số hoạt động của Qwen3.8-Max.
Vì là MIT, V4 là dòng mà người áp dụng có thể xây trên đó với ít luật sư nhất: lấy trọng số (hoặc dùng một nhà cung cấp lưu trữ), chạy, phát hành thương mại, chẳng nợ ai gì và chẳng phải hỏi ai. Và để rõ ràng về số phiên bản, vì cối xay tin đồn rất chuộng chúng — không có R2, không có V5, không có V4.1. Chỉ có dòng V4 chín muồi thành thứ mà các nhóm có thể dựa vào.
Khoảng cách thu hẹp nhanh hơn những gì bảng xếp hạng thừa nhận
Lùi lại một bước, độ dốc quan trọng hơn từng đợt phát hành riêng lẻ. Theo cách nhìn của Nathan Lambert, khoảng cách giữa những mô hình mở tốt nhất và mô hình đóng tốt nhất đã nén lại từ chừng sáu đến chín tháng xuống còn ba đến năm — "mô hình mở chưa từng gần biên giới đến thế kể từ DeepSeek R1". Nói mộc: những mô hình tải về miễn phí giờ chỉ còn kém vài tháng so với những mô hình tốt nhất mà tiền có thể thuê, trong khi một năm trước chúng bị bỏ lại một vòng thong thả.
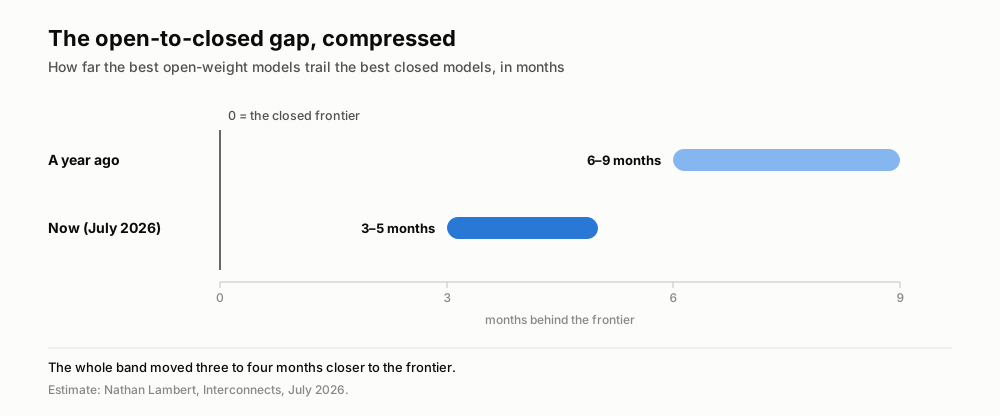
Ước tính của Lambert vẽ đúng tỷ lệ: phe mở không chỉ tiến gần hơn, cả dải khoảng cách cũng hẹp lại.
Dữ liệu sử dụng cũng chỉ về cùng một hướng. Trên OpenRouter, một chợ phân bổ yêu cầu cho nhiều mô hình, thị phần token của các mô hình gốc Mỹ rơi từ khoảng 70% vào tháng 6 năm 2025 xuống còn khoảng 30% một năm sau, trong khi các mô hình gốc Trung Quốc nay thường xuyên vượt 30%. Giá là một phần lớn lý do: mô hình mở Trung Quốc thường rẻ hơn 60% đến 90% mỗi token, và dịch vụ lưu trữ xuất hiện ngay tức thì, như những endpoint K3 ngày đầu đã cho thấy rõ.
Sự dịch chuyển thầm lặng hơn là về quy mô. Thương hiệu của mô hình mở Trung Quốc từng là nhỏ, nhanh, rẻ. K3 với 2,8 nghìn tỷ tham số và Qwen3.8-Max với 2,4 nghìn tỷ là điều ngược lại hoàn toàn — một canh bạc rằng đi lớn trong thế giới mở giờ đây đáng giá. GLM-5.2 của Z.ai, phát hành ngày 16 tháng 6 dưới MIT và dẫn đầu hạng mục trọng số mở của Artificial Analysis Index với điểm 51, là cùng một thông điệp từ phòng lab thứ tư.
Bước ngoặt: chính phủ đã tạo ra điều này có thể siết lại nó
Rồi gió đổi chiều. Vào khoảng ngày 22 đến 25 tháng 7, Financial Times và Reuters đưa tin Bộ Thương mại Trung Quốc đang cân nhắc kiểm soát xuất khẩu đối với các mô hình AI — bao gồm cả LLM trọng số mở — với Alibaba, ByteDance và Z.ai được cho là có mặt trong các cuộc trao đổi. Khung được đưa ra là phân tầng: nghĩa vụ khai báo cho mô hình yếu hơn, rà soát an ninh cho mô hình mạnh hơn, và khả năng cấm phát hành công khai những mô hình mạnh nhất. Chưa có gì thành luật. Nhưng chiều hướng thì đáng chú ý: làn sóng có lẽ đang lên đỉnh đúng vào lúc chính phủ của chính nó bắt đầu coi những mô hình này như hàng xuất khẩu chiến lược thay vì đóng góp mở.
Kết lại: khi cái mở trở thành tài sản chiến lược
Câu chuyện gọn ghẽ là "Trung Quốc đã bắt kịp". Câu chuyện chính xác hơn là: trọng số mở trở thành tài sản chiến lược nhanh đến mức một chính phủ giờ muốn đặt tay lên vòi. Trong ba tuần, các mô hình mở đi từ chỗ tụt sau biên giới hai đến ba quý xuống chỉ còn một — và từ nhỏ và rẻ thành một trong những mô hình lớn nhất từng được công bố ở bất kỳ hình thức nào. Biên giới mở không chỉ dịch chuyển. Nó dịch tới một nơi mà những người tạo ra nó có thể không còn tự do tiếp tục xuất đi.
Với các nhóm xây dựng trên những mô hình này, kết luận thực tiễn không đổi mà sắc hơn một chút. Telli.sh vốn đã chạy một mô hình mở, Qwen3, trong lớp tóm tắt, nên mỗi bước tiến về chất lượng và giá của mô hình mở đều chảy thẳng vào việc gỡ băng, dịch và tóm tắt cuộc họp. Mục mới là nguồn cung: nếu các quy định xuất khẩu của Trung Quốc thành hình như báo chí gợi ý, thì việc mô hình mở nào còn được tải về tự do là điều cần theo dõi chứ không nên mặc định. Việc các mô hình nuôi lớp này ngày một tốt hơn là xu hướng; còn những mô hình ấy được phép đến từ đâu mới là điều cần để mắt.
Nguồn
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
