Qwen3.8-27B open weights: dung lượng, Q4_K_M và tốc độ thực trên 4090/Mac
Qwen3.8-27B phát hành theo giấy phép Apache 2.0. Bản GGUF Q4_K_M nặng 17,1 GB, vừa laptop 32 GB; bản FP8 là 30,9 GB. Đo thực tế: 48 token/giây trên RTX 4090 và 12,75 trên Mac mini M4 Pro.
Ngày 3 tháng 8, tài khoản Qwen của Alibaba nói rằng trọng số mở sẽ có «tuần sau». Đó đúng là loại câu mà ngành AI đã dạy mọi người nghe với một mức chiết khấu. Mười hai ngày sau, không còn gì để chiết khấu nữa: trọng số của Qwen3.8-Max, mô hình 2,4 nghìn tỉ tham số, xuất hiện trên Hugging Face ngày 12 tháng 8, và mô hình nhỏ hơn — Qwen3.8-27B, kèm một giấy phép Apache 2.0 hết sức bình thường — theo sau vào ngày 14.
Rồi phần thú vị mới xảy ra. Ngay trong cùng một giờ Qwen hoàn tất đăng thẻ mô tả của 27B, ba nhóm cộng đồng khác nhau đã chuyển đổi xong nó sang các định dạng chạy được trên máy tính cá nhân. Hai ngày sau, những bản chuyển đổi đó vượt mốc một triệu lượt tải.
Con số ấy mới là tin, không phải bảng điểm chuẩn. Một mô hình 27 tỉ tham số từ một trong những phòng thí nghiệm AI hàng đầu thế giới đi từ «được công bố» tới «đang chạy trên chừng một triệu chiếc bàn làm việc» trong khoảng 48 giờ. Bài này giải thích bằng ngôn ngữ dễ hiểu điều đó thực sự nghĩa là gì: đã phát hành những gì và theo giấy phép nào, cần gì để chạy 27B trên phần cứng bạn đã có, ba năm qua đã đi được bao xa, và phần mà hầu hết bài viết bỏ qua — một mô hình 27B chạy tại chỗ vẫn chưa làm được gì.
Tóm tắt nhanh:
- Lời hứa đã được giữ. Qwen3.8-Max (2,4 nghìn tỉ tổng / 95 tỉ kích hoạt) ra ngày 12/8, Qwen3.8-27B ra ngày 14/8. Cả hai đều tải về được thật, không phải bản xem trước chạy trên máy chủ của hãng.
- Giấy phép của hai mô hình khác nhau, và khác biệt đó nặng ký hơn điểm số. Bản 27B dùng Apache 2.0: không ngưỡng, không điều khoản, dùng thương mại thoải mái mà không nợ ai gì. Qwen3.8-Max dùng giấy phép riêng, có điều kiện kích hoạt theo doanh thu cho các doanh nghiệp cung cấp mô hình như một dịch vụ.
- Kích thước quyết định ai chạy được gì: Max là bản tải 4.892 GB; bản 27B nén xuống 4 bit chỉ 17,1 GB, vừa với máy 32 GB. Các bản 4 bit của cộng đồng vượt 1,07 triệu lượt tải trong hai ngày.
Ảnh: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Tự chạy mô hình của một phòng thí nghiệm hàng đầu nghĩa là cỗ máy — và việc bảo trì nó — cũng thành của bạn.
Lời hứa có kèm ngày, và ngày đó đã đứng vững
Ngày 4 tháng 8 chúng tôi đã viết về chính thông báo ấy và nói rằng thời gian chờ được đo bằng «tuần sau», chứ không phải «một ngày nào đó». Đó là giới hạn mà bằng chứng khi ấy cho phép. Kết cục diễn ra gọn ghẽ.
Qwen3.8-2.4T-A95B — được tiếp thị dưới tên Qwen3.8-Max — xuất hiện cùng tệp giấy phép vào ngày 12 tháng 8. Qwen3.8-27B và một biến thể FP8 tối ưu hiệu năng đến vào ngày 14. Cả hai mốc đều nằm trong khung mà «tuần sau» chỉ tới. Trong một ngành mà các mô hình được công bố thường xuyên chẳng bao giờ ra mắt, việc một phòng thí nghiệm giữ đúng hạn nói miệng từ chín ngày trước tự nó đã đáng ghi nhận.
Phản ứng đến ngay lập tức và rất lớn. Chủ đề trên Hacker News về 27B thu 1.351 điểm và 769 bình luận trong một ngày. Chỉ vài giờ sau, giới chuyên môn đã đăng những cấu hình triển khai chạy được cho từng loại phần cứng cụ thể; có người chia sẻ thiết lập cho cả NVIDIA DGX Spark lẫn card đồ họa phổ thông RTX 4090. Hai năm trước ngành không đón các bản phát hành mở như vậy — khi đó chỉ riêng việc làm một kiến trúc mới chạy được đã là một dự án cuối tuần.
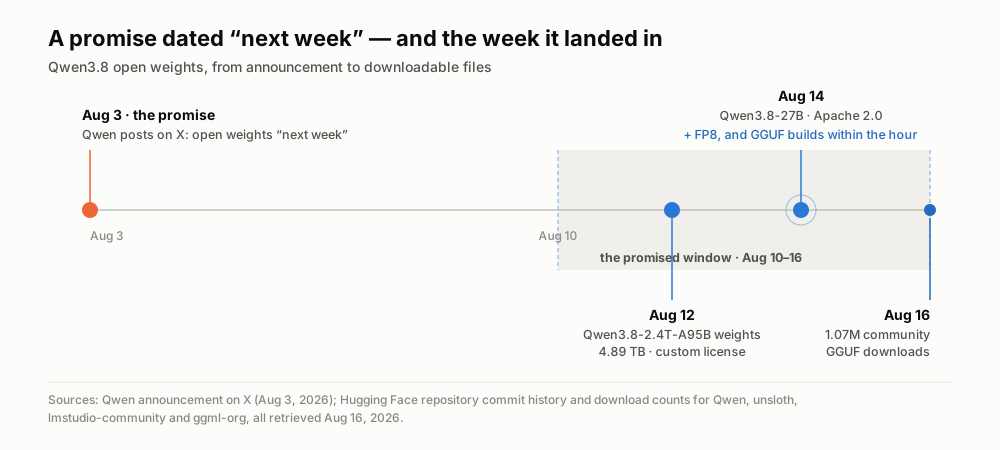
Một lời hứa có ngày tháng, và hai lần giao hàng rơi đúng vào trong. Ngày lấy từ lịch sử commit của kho lưu trữ Hugging Face, truy xuất ngày 16 tháng 8 năm 2026.
Năm thuật ngữ, nhắm vào câu hỏi «tôi chạy nổi không?»
Nếu bạn đến từ các bài trước của chúng tôi, bạn đã biết trọng số mở là gì: phòng thí nghiệm công bố lưới số khổng lồ đã học được vốn tạo nên mô hình hoàn chỉnh, và bạn có thể tải về, chạy trên phần cứng của mình, xây sản phẩm trên đó mà không trả tiền theo từng lượt gọi. Ở đây chúng ta quan tâm câu hỏi tiếp theo, hoàn toàn thực dụng: chạy nó tốn bao nhiêu phần cứng?
Tham số chính là những con số đã học ấy, và số lượng của chúng ấn định kích thước thô của mô hình. Quy tắc ước lượng đơn giản đến tàn nhẫn: ở độ chính xác mà các phòng thí nghiệm dùng để huấn luyện, mỗi tỉ tham số chiếm khoảng 2 GB trên ổ đĩa, và bạn cần chừng ấy bộ nhớ để giữ mô hình trong lúc chạy. Vậy mô hình 27 tỉ tham số là bản tải 55 GB. Mô hình 2,4 nghìn tỉ gần 5 terabyte. Đó là lý do một bên là câu chuyện của laptop, còn bên kia là câu chuyện của trung tâm dữ liệu.
Lượng tử hóa là thứ khép lại khoảng cách đó, và là ý tưởng hữu ích nhất cho ai muốn chạy mô hình tại nhà. Tham số thường được lưu ở độ chính xác 16 bit. Lượng tử hóa làm tròn chúng xuống ít bit hơn — 8, 4, đôi khi 2 — và tệp co lại gần đúng theo tỉ lệ ấy. Lượng tử hóa 4 bit biến bản tải 55 GB kia thành khoảng 17 GB. Bạn mất một chút độ chính xác và được đổi lấy khả năng chạy được nó. GGUF chỉ đơn giản là định dạng tệp mà các bản nén này dùng; đó là thứ mà llama.cpp, Ollama hay LM Studio đọc. Khi thấy «Q4_K_M», hãy đọc là «bản 4 bit mà phần lớn mọi người dùng».
Mô hình dày đặc so với hỗn hợp chuyên gia quyết định tốc độ một khi mô hình đã vừa bộ nhớ. Qwen3.8-27B là mô hình dày đặc: cả 27 tỉ tham số đều kích hoạt cho mỗi từ nó tạo ra. Qwen3.8-Max là mô hình hỗn hợp chuyên gia — tổng cộng 2,4 nghìn tỉ tham số, nhưng một bộ định tuyến chỉ chọn khoảng 95 tỉ cho mỗi token, trải trên 512 mạng con chuyên biệt. Con số tổng cho biết hóa đơn lưu trữ; con số kích hoạt cho biết hóa đơn tính toán. Sự phân biệt này có một hệ quả thực tế rất sắc, chúng ta sẽ quay lại.
Cửa sổ ngữ cảnh là lượng nội dung mô hình có thể cân nhắc cùng một lúc. Bản 27B xử lý tự nhiên 262.144 token — cỡ một chồng biên bản họp dài một tiếng — và có thể kéo lên một triệu bằng một thay đổi cấu hình.
Giấy phép là thứ nên đọc trước tiên
Đây là phát hiện gánh phần lớn bài viết, và nó đi ngược giả định rằng một dòng mô hình thì dùng chung một dòng điều khoản.
Qwen3.8-27B dùng Apache 2.0. Đó là đầu thoáng nhất của phổ giấy phép: dùng, sửa, tinh chỉnh, đưa vào sản phẩm thương mại, dựng cả doanh nghiệp trên đó, không nợ gì ai và không phải xin phép ai. Không ngưỡng doanh thu, không bắt buộc hiển thị tên trên giao diện, không loại trừ lĩnh vực sử dụng.
Qwen3.8-Max thì không. Nó ra kèm một «Qwen3.8-Max License» riêng, mở đầu giống MIT rồi gắn thêm hai điều kiện. Nếu sản phẩm của bạn vượt 100 triệu người dùng hoạt động hằng tháng hoặc 20 triệu đô la doanh thu mỗi tháng, bạn phải hiển thị tên mô hình trên giao diện. Và nếu bạn vận hành doanh nghiệp cung cấp mô hình như một dịch vụ hoặc trợ lý công việc bằng AI với doanh thu vượt 50 triệu đô la trong bất kỳ mười hai tháng liên tiếp nào, bạn cần một thỏa thuận riêng với Qwen trước khi dùng vào mục đích thương mại.
Với một lập trình viên đơn lẻ hay một công ty dùng nội bộ, không điều khoản nào cắn tới. Nhưng đây chính là dấu sao mà chúng tôi từng nêu khi Kimi K3 ra mắt với giấy phép riêng thay vì MIT, và bài học lặp lại: «trọng số mở» và «giấy phép mở» là hai câu hỏi tách biệt, và một phòng thí nghiệm có thể trả lời khác nhau cho hai mô hình phát hành cách nhau hai ngày. Hãy đọc giấy phép trước khi phải lòng một điểm số.
| Mô hình | Tổng tham số | Kích hoạt mỗi token | Dung lượng tải | Giấy phép | Nơi chạy thực tế |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2,4 nghìn tỉ | 95 tỉ | 4.892 GB | Riêng, ngưỡng doanh thu | Một cụm máy tăng tốc |
| Qwen3.8-Max, FP8 | 2,4 nghìn tỉ | 95 tỉ | 2.496 GB | Riêng, ngưỡng doanh thu | Một cụm máy tăng tốc |
| Qwen3.8-27B | 27 tỉ, dày đặc | 27 tỉ | 55,6 GB | Apache 2.0 | Máy trạm nhiều GPU |
| Qwen3.8-27B, FP8 | 27 tỉ, dày đặc | 27 tỉ | 30,9 GB | Apache 2.0 | Một GPU cao cấp |
| Qwen3.8-27B, Q4_K_M GGUF | 27 tỉ, dày đặc | 27 tỉ | 17,1 GB | Apache 2.0 | Laptop 32 GB hoặc một chiếc 4090 |
Chạy 27B thực sự cần những gì
Câu trả lời trung thực: ít hơn bạn đoán, và nhiều hơn những gì các tiêu đề gợi ý.
Bậc thấp nhất là một dòng lệnh. Bản 27B nằm trong thư viện của Ollama; ollama run qwen3.8 kéo về bản dựng 18 GB với cửa sổ ngữ cảnh 256K và đầu vào hình ảnh, trong số mười hai biến thể, kể cả một bản tinh chỉnh cho chip Apple. LM Studio, thứ cho bạn cửa sổ trò chuyện thay vì một terminal, đã có bản dựng riêng chỉ vài phút sau khi phát hành. Cả hai đều không đòi bạn phải hiểu phần trước đó.
Rồi thực tế chen vào dưới dạng số token mỗi giây. Các phép đo giới chuyên môn đăng trong chủ đề phát hành rơi gần đúng nơi phần cứng dự báo. Trên RTX 4090 chạy bản 4 bit, một người đo được khoảng 48 token mỗi giây — nhanh hơn tốc độ đọc của bạn khá nhiều. Trên Mac mini M4 Pro với 64 GB bộ nhớ, người khác được 12,75 token mỗi giây: dùng được, nhưng bạn sẽ ngồi nhìn nó gõ. Còn trên một chiếc laptop dùng AMD 7840U và 64 GB DDR5 thường, cũng bản 4 bit ấy cho khoảng 4 token mỗi giây — về kỹ thuật là chạy, còn thực tế là một tác vụ theo lô mà bạn khởi động rồi bỏ đi.
Chính con số cuối cùng đó cho thấy giá trị của phân biệt dày đặc và hỗn hợp chuyên gia. Cũng người ấy đo trên cùng chiếc laptop một mô hình hỗn hợp chuyên gia đời cũ, trên danh nghĩa lớn hơn, và được khoảng 20 token mỗi giây — nhanh gấp năm lần mô hình dày đặc nhỏ hơn, bởi mỗi từ chỉ kích hoạt một phần tham số. Nếu bạn đang tìm thứ để chạy trên CPU, con số cần so là tham số kích hoạt, không phải tổng tham số. Đó là bài học phản trực giác nhất và hữu ích nhất của AI chạy tại chỗ.
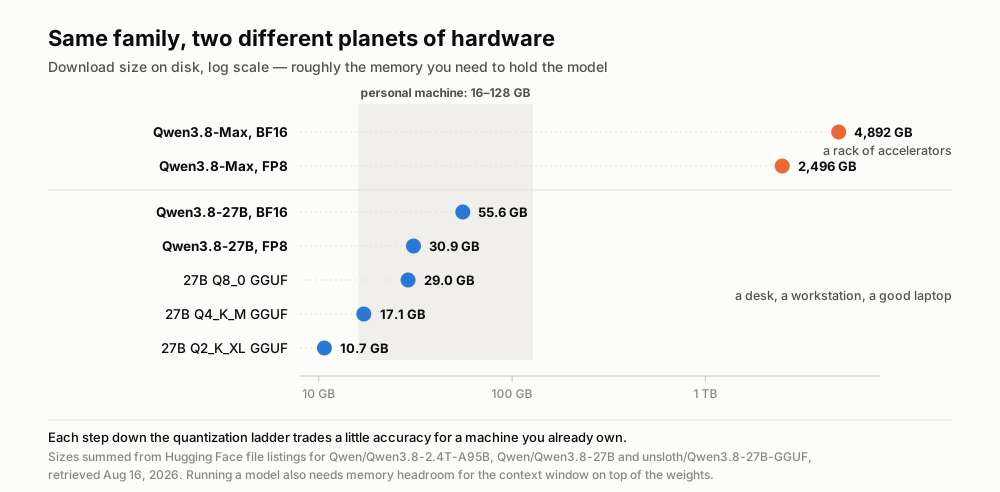
Hai thành viên cùng một dòng mô hình, cách nhau 290 lần về dung lượng tải. Dung lượng cộng từ danh sách tệp trên Hugging Face, truy xuất ngày 16 tháng 8 năm 2026.
Ba năm trước, việc này cần một vụ rò rỉ và một kỳ cuối tuần
Muốn thấy bước nhảy lớn cỡ nào, hãy đặt nó cạnh điểm khởi đầu của các mô hình chạy tại chỗ.
Tháng 2 năm 2023, Meta chỉ phát hành trọng số LLaMA đời đầu cho các nhà nghiên cứu được duyệt. Chúng rò rỉ trong khoảng một tuần, và toàn bộ cộng đồng nghiệp dư về mô hình chạy tại chỗ được dựng lên trên một tệp mà lẽ ra không ai được có. Ngày 10 tháng 3 năm 2023, một lập trình viên công bố llama.cpp, một chương trình C++ nhỏ với tiết mục tủ là chạy mô hình 7 tỉ tham số trên MacBook. Kho mã đó nay có 124.000 sao và là tổ tiên của gần như mọi công cụ «chạy tại chỗ» đang dùng hôm nay.
Hãy so hai ngày phát hành. Năm 2023: một bản 7B bị rò rỉ, không có giấy phép đúng nghĩa, cả tuần công sức cộng đồng mới cho nó chạy, và một mô hình thú vị hơn là hữu dụng. Năm 2026: một bản 27B từ phòng thí nghiệm hàng đầu, chủ động phát hành theo Apache 2.0, có đầu vào ảnh và video, cửa sổ ngữ cảnh 262K, và các bản dựng cộng đồng hoàn thành trước khi tài liệu của chính phòng thí nghiệm ngừng thay đổi. Commit đầu tiên của bản chuyển đổi unsloth rơi vào 14 giờ 56 UTC ngày 14 tháng 8 — sớm hơn bốn phút so với lần Qwen cập nhật thẻ mô tả lần cuối.
Các con số sử dụng nói điều tương tự một cách thẳng thừng hơn. Tính đến ngày 16 tháng 8, các bản 4 bit của cộng đồng cho 27B đạt 867.963 lượt tải ở một nhà phát hành, 171.518 ở nhà thứ hai và 34.520 ở nhà thứ ba: 1,07 triệu trong hai ngày. Các kho chính thức của chính Qwen cho 27B cộng thêm 215.000 lượt nữa. Qwen3.8-Max, mô hình mạnh hơn nhiều, dừng ở 17.126 trên cả hai kho.
Hãy đọc lại tỉ lệ đó. Mô hình cỡ tiên phong nhận được khoảng 1,6% sự chú ý dành cho mô hình cỡ laptop. Thứ thị trường đi tìm không phải năng lực. Là tầm với.
Một bản 27B chạy tại chỗ vẫn chưa làm được gì
Giờ là phần đính chính, bởi sự phấn khích luôn vượt bằng chứng theo những cách có thể đoán trước.
Bảng điểm chuẩn do chính Alibaba công bố cho thấy 27B vượt Opus 4.6 Max ở vài thước đo về lập trình tác tử và tuân thủ chỉ dẫn — 61,7 so với 53,4 ở SWE-bench Pro, 79,5 so với 62,5 ở IFBench — trong khi thua ở những thước đo khác, gồm 30,8 so với 40,0 ở HLE, bài kiểm tra kiến thức rộng. Mọi con số ấy đều do chính nhà cung cấp tự báo cáo. Tại thời điểm viết bài, Artificial Analysis, đơn vị đánh giá độc lập mà chúng tôi dựa vào, chưa hề có mục nào cho 27B; họ có xếp Qwen3.8-Max hạng 10 trên 188 mô hình với điểm trí tuệ 58, một thành tích xuất sắc và cũng là một mô hình khác.
Giới chuyên môn sắc sảo hơn bảng tính. Ý kiến phản bác được ủng hộ nhiều nhất trong chủ đề, từ một người tự nhận là người dùng mô hình mở lâu năm, nói thẳng: trong công việc thực tế chúng không thắng được các mô hình chạy trên máy chủ hàng đầu; chúng «đủ tốt» cho rất nhiều tác vụ và chạy được trên phần cứng vừa túi tiền — đó là một khẳng định khác, khiêm tốn hơn. Một bình luận khác đặt trần giới hạn bằng ngôn ngữ vật lý: không thể nén toàn bộ tri thức nhân loại vào một tệp 30 GB, nên các mô hình nhỏ vẫn tương đối yếu ở việc nhớ lại những sự kiện ít phổ biến, dù chúng có sắc bén đến đâu ở lập trình hay dùng công cụ.
Còn hai giới hạn nữa chỉ lộ ra khi bạn thật sự chạy. Lượng tử hóa không miễn phí: mô hình nén mạnh dễ mất mạch ở ngữ cảnh dài và có thể rơi vào vòng lặp lặp lại — đó là lý do ai dư bộ nhớ đều được khuyên dùng bản đầy đủ độ chính xác. Và thế hệ Qwen này mặc định suy nghĩ rất kỹ: một người dùng đưa cho 27B trên chiếc Mac mini 64 GB đúng hai từ «svg owl» rồi ngồi xem nó sinh ra 21.769 token suy luận trong 17 phút 12 giây trước khi trả lời. Con cú làm ra rất đẹp. Cũng làm ra một hóa đơn tính bằng thời gian thực mà không API chạy trên máy chủ nào tính cả.
Rồi còn khoản chẳng ai đếm: vận hành giờ là của bạn. Cập nhật mô hình, chọn mức lượng tử hóa, khoảng dư bộ nhớ, phiên bản driver, tiếng quạt của máy. Cái API chạy trên máy chủ mà bạn muốn né cũng chính là một đội người giữ cho thứ gì đó chạy được.
Kết luận: hào nước đã dịch xuống dưới trong ngăn xếp
Đây là điểm mấu chốt, và nó lớn hơn một lần phát hành.
Một phòng thí nghiệm hàng đầu công bố một mô hình 27B có năng lực vào thứ Năm. Đến thứ Bảy, hơn một triệu bản sao của các phiên bản nén bởi cộng đồng đã nằm trên máy của mọi người, nó chỉ cách một dòng lệnh trong Ollama, và về mặt pháp lý được tự do dựng doanh nghiệp trên đó. Bất kể lợi thế mà mô hình ấy đại diện là gì, nó mất khoảng hai ngày để trở nên sẵn có cho mọi đối thủ cùng lúc. Hãy gọi đó là hào nước hai ngày: một lợi thế mô hình giờ có chu kỳ bán rã chừng 48 giờ.
Đây không phải dự đoán. Đây là một phép đo, thực hiện trong tuần này, trên lần phát hành này.
Và nó định nghĩa lại việc xây dựng một sản phẩm AI. Khi lớp mô hình trở thành hàng hóa mà ai cũng thay được trong một buổi chiều, mô hình thôi là thứ bạn cạnh tranh. Cái sống sót là tất cả những gì bao quanh nó: độ tin cậy khi máy chủ suy luận sập lúc ba giờ sáng; các đường ống dữ liệu thu thập, làm sạch và truy hồi đúng ngữ cảnh; việc đánh giá cho bạn biết nó có chạy trên dữ liệu của bạn hay chỉ trên dữ liệu của bài kiểm tra; một giao diện mà người ta thật sự dùng; và những thỏa thuận về niềm tin — quyền riêng tư, thời hạn lưu trữ, ai được thấy gì — vốn quyết định liệu có ai chịu giao bản ghi cuộc họp của họ cho bạn hay không.
Không thứ nào trong đó thành hàng hóa trong hai ngày. Không thứ nào có nút tải về.
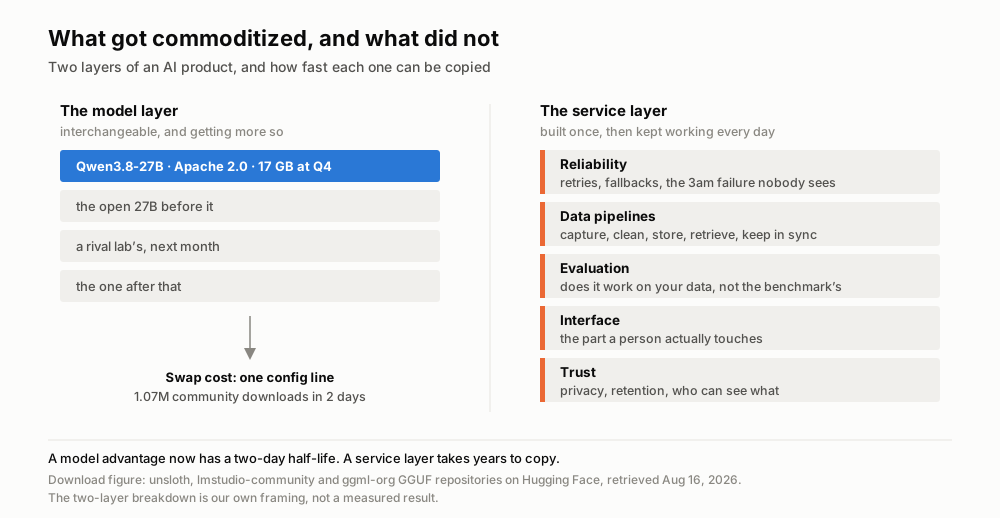
Lớp đã trở nên rẻ trong tuần này, và lớp thì không. Số liệu tải về lấy từ Hugging Face, truy xuất ngày 16 tháng 8 năm 2026; cách chia hai lớp là góc nhìn của chúng tôi.
Vậy nên phản ứng đúng trước việc một mô hình mở xuất sắc đến với laptop không phải là «các công ty mô hình đã thắng» hay «các công ty sản phẩm đã thua». Mà là phần việc thú vị đã dịch xuống một tầng trong ngăn xếp — tới nơi khó sao chép hơn nhiều và cũng ít giật tít hơn nhiều.
Telli.sh đứng ở đâu: chúng tôi xây dựng đúng lớp dịch vụ đó, trên nền các mô hình mở. Telli.sh vốn đã dùng một mô hình Qwen mở trong khâu tóm tắt, nghĩa là mỗi bước nhảy về chất lượng của mô hình mở — kể cả lần này — chảy thẳng vào ghi chép, dịch và tóm tắt cuộc họp mà giá phía bạn không đổi. Thời gian của chúng tôi dồn vào phần không đến trong một tệp GGUF: thu âm thanh một cách đáng tin cậy, không lẫn lộn người nói, biến bản ghi 60 phút thành ghi chú bạn còn tìm được sau nhiều tháng, và nói rõ dữ liệu của bạn nằm ở đâu.
Nguồn
- Thẻ mô hình và giấy phép Qwen3.8-27B, Hugging Face
- Thẻ mô hình và giấy phép Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: các bản lượng tử hóa và số lượt tải
- Qwen3.8 trong thư viện mô hình của Ollama
- Thảo luận trên Hacker News về việc phát hành Qwen3.8-27B (14 tháng 8 năm 2026)
- Trang mô hình Qwen3.8 Max trên Artificial Analysis
- Thông báo trọng số mở của Qwen (@Alibaba_Qwen) trên X (3 tháng 8 năm 2026)
- Kho mã llama.cpp, tạo ngày 10 tháng 3 năm 2023
- Trang ảnh trên Wikimedia Commons
