ไฟล์ขนาด 16.5 GB ทำคะแนนแซงโมเดลปิดที่เก่งที่สุดของเดือนกุมภาพันธ์แล้ว
สามปีก่อน โมเดลที่ดาวน์โหลดได้ดีที่สุดแพ้ GPT-4 อยู่ 37 คะแนนบน HumanEval และต้องใช้การ์ดจอสองใบถึงจะรันไหว สัปดาห์ที่แล้ว โมเดลน้ำหนักเปิดขนาด 27B ทำได้ 52.0 บนดัชนีความฉลาดของ Artificial Analysis ขณะที่ Claude Opus 4.6 Max อยู่ที่ 44.9 ในราคาเพียงหนึ่งในเก้า จากไฟล์ขนาด 16.5 GB บทความเปรียบเทียบก่อนและหลัง พร้อมตารางเบนช์มาร์ก เส้นโค้งราคา และความหมายของช่วงเวลาไล่ตามที่ลดเหลือ 162 วัน
มีคนบน Hacker News กำลังรันโมเดลภาษาระดับแนวหน้าบนการ์ดจอที่มีหน่วยความจำ 16 GB ที่ความเร็ว 50 ถึง 60 โทเคนต่อวินาที พร้อมหน้าต่างบริบท 128,000 โทเคน โมเดลนั้นคือ Qwen3.8-27B ซึ่งเปิดตัวเมื่อวันที่ 14 สิงหาคม 2026 บนดัชนีความฉลาดของ Artificial Analysis มันทำได้ 52.0 สูงกว่า Claude Opus 4.6 Max ที่เพิ่งเป็นโมเดลปิดที่เก่งที่สุดในตลาดเมื่อเดือนกุมภาพันธ์ ซึ่งอยู่ที่ 44.9
ถ้าเป็นปี 2023 ประโยคข้างบนคือนิยายวิทยาศาสตร์ และไม่ใช่แบบสนุก ๆ ด้วย
บทความนี้คือการเปรียบเทียบก่อนและหลัง ไม่ใช่ข่าวการเปิดตัว — เราเขียนไปแล้ว — แต่เป็นการเทียบข้ามสามปีว่า โมเดลที่ดาวน์โหลดได้ดีที่สุดทำคะแนนสู้โมเดลแนวหน้าได้แค่ไหนเมื่อก่อนกับตอนนี้ ค่าใช้จ่ายในการซื้อความฉลาดระดับหนึ่งเป็นเท่าไรเมื่อก่อนกับตอนนี้ และต้องมีฮาร์ดแวร์แบบไหนถึงจะรันเองได้ ทุกตัวเลขข้างล่างมีแหล่งอ้างอิงและวันที่กำกับ แนวโน้มที่ตัวเลขเหล่านี้วาดออกมาถือเป็นหนึ่งในเรื่องที่น่ามองโลกในแง่ดีที่สุดในวงการซอฟต์แวร์ตอนนี้
สรุป:
- ช่องว่างปิดลงแล้ว และเราระบุวันได้ เดือนกรกฎาคม 2023 โมเดลเปิดที่ดีที่สุดแพ้ GPT-4 อยู่ 17.5 คะแนนบน MMLU และ 37.1 คะแนนบน HumanEval พอถึงเดือนสิงหาคม 2026 โมเดลเปิดขนาด 27B ชนะเรือธงโมเดลปิดของเดือนกุมภาพันธ์ใน 15 จาก 19 เบนช์มาร์กที่ทั้งคู่เผยแพร่ตัวเลข และชนะบนดัชนีรวมของหน่วยงานอิสระด้วย
- ราคาลดลงราว 208 เท่าในเวลา 23 เดือน ตามการวัดของ Epoch AI ที่ตรึงเกณฑ์ความสามารถไว้คงที่ โมเดลเปิด 27B วันนี้มีราคาผสมอยู่ที่ 1.09 ดอลลาร์ต่อล้านโทเคน เทียบกับ 10.00 ดอลลาร์ของ Opus 4.6 Max และเป็นศูนย์ต่อโทเคนถ้ารันเอง
- มันยังไม่ใช่แนวหน้า และเราพูดตรง ๆ Claude Opus 5 Max ได้ 63.1 ส่วน GPT-5.6 Sol Max ได้ 60.9 ในการให้เหตุผลบนความรู้กว้าง 27B แพ้ Opus 4.6 ค่อนข้างขาด คือ 30.8 ต่อ 40.0 บน HLE
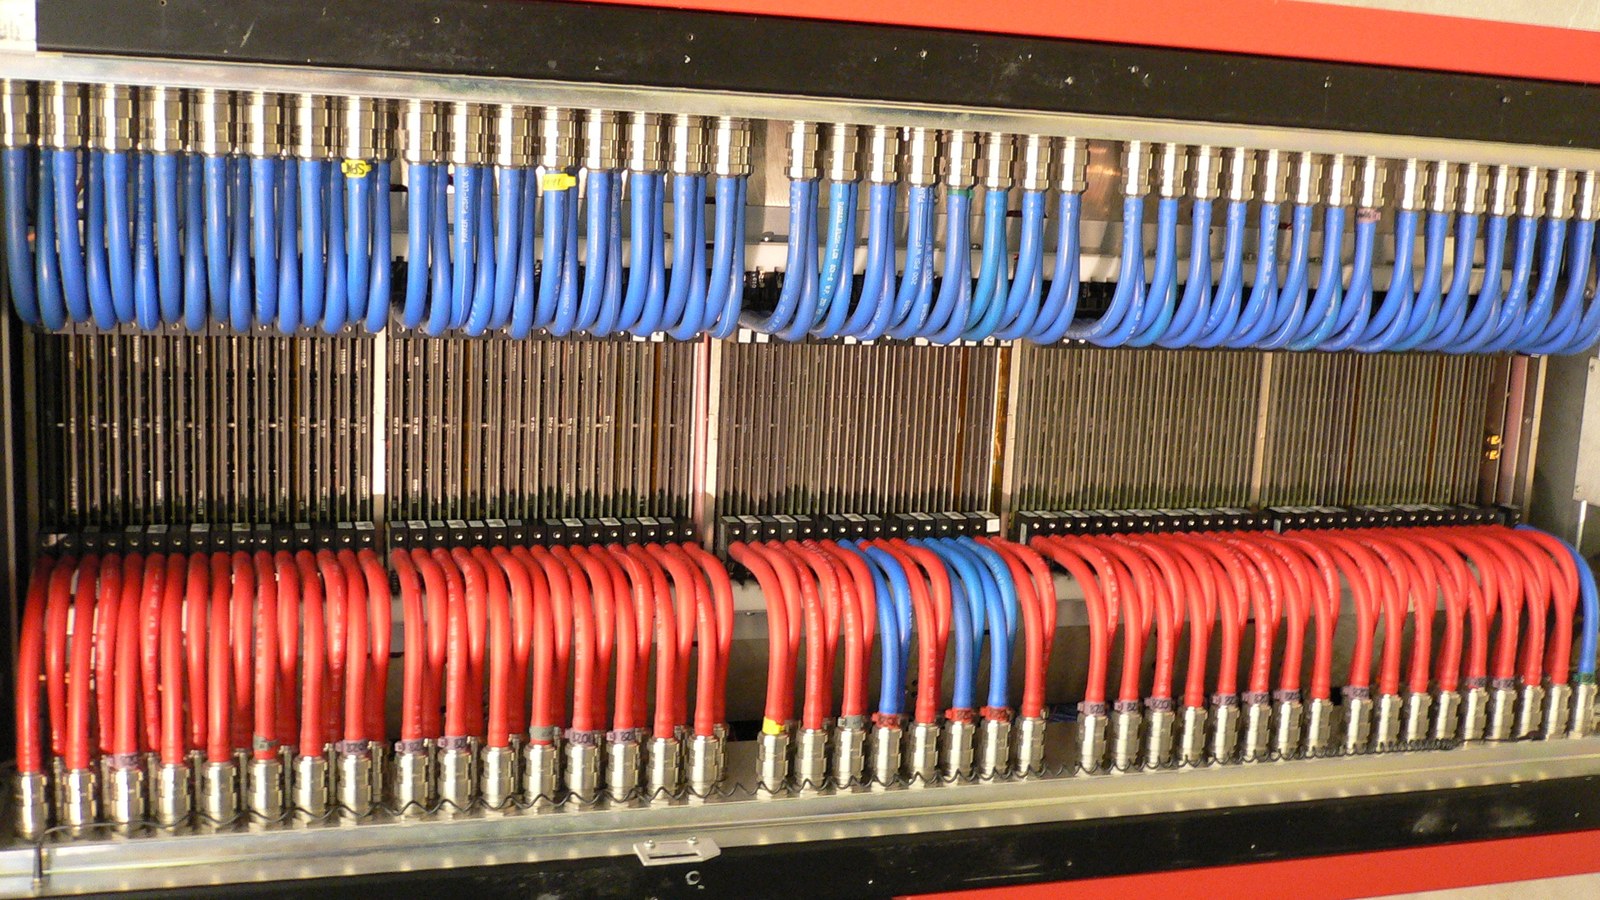
ภาพ: Steve Jurvetson, Wikimedia Commons, CC BY 2.0 ส่วนเชื่อมต่อของ Cray Y-MP ราวปี 1988 พลังประมวลผลจริงจังเคยมีสภาพเป็นห้องที่คนต้องเดินเข้าไป
«ก่อนหน้านี้» หน้าตาเป็นแบบนี้จริง ๆ
หมุนนาฬิกากลับไปวันที่ 18 กรกฎาคม 2023 วันที่ Meta เผยแพร่ Llama 2 มันคือโมเดลที่ดาวน์โหลดได้ดีที่สุดในโลกตอนนั้น และเปเปอร์ของมันเองก็พิมพ์ตารางคะแนนเทียบกับโมเดลปิดแนวหน้าออกมาแบบไม่หลบเลี่ยง
Llama 2 70B ทำได้ 68.9 บน MMLU ขณะที่ GPT-4 ได้ 86.4 บน GSM8K คือ 56.8 ต่อ 92.0 ส่วนบน HumanEval ซึ่งเป็นเบนช์มาร์กด้านการเขียนโค้ด คือ 29.9 ต่อ 67.0 ไม่ถึงครึ่งด้วยซ้ำ บทสรุปในเปเปอร์เขียนไว้เองว่า «ยังคงมีช่องว่างด้านสมรรถนะที่กว้างระหว่าง Llama 2 70B กับ GPT-4 และ PaLM-2-L» นี่คือเรือธงของฝั่งน้ำหนักเปิดในปี 2023 ในถ้อยคำของตัวเอง
ทีนี้มาดูฮาร์ดแวร์ บิลด์ชุมชนแบบ 4 บิตของ TheBloke ซึ่งเป็นวิธีที่คนใช้รัน Llama 2 70B กันจริง ๆ เป็นไฟล์ขนาด 41.4 GB เผยแพร่เมื่อวันที่ 4 กันยายน 2023 ถ้าอยากได้ความเร็วพอใช้งาน คุณต้องมีการ์ดจอ 24 GB สองใบ หรือ Mac ที่มีแรม 64 GB โมเดลที่ลงโน้ตบุ๊กธรรมดาได้จริงคือ Llama 2 13B ไฟล์ขนาด 7.9 GB ทำคะแนน MMLU ได้ 54.8 ต่ำกว่า GPT-4 อยู่ 31.6 คะแนน และแทบใช้ทำอะไรไม่ได้นอกจากสาธิต
ดังนั้นข้อเสนอของปี 2023 คือ จ่ายเงินให้ห้องแล็บแนวหน้า หรือรันของที่ด้อยกว่าอย่างเห็นได้ชัดบนฮาร์ดแวร์ที่คนส่วนใหญ่ไม่มี นี่แหละเหตุผลที่ข้อโต้แย้งว่า «ใช้ API ไปเถอะ» ชนะขาดลอยมาสองปี เพราะมันถูกต้อง
ทีนี้ลองถามคำถามเดิมในเดือนสิงหาคม 2026
Alibaba เผยแพร่ Qwen3.8-27B เมื่อวันที่ 14 สิงหาคม 2026 ภายใต้สัญญาอนุญาต Apache 2.0 พร้อมพิมพ์ตารางเทียบตรงกับ Claude Opus 4.6 Max ไว้บนการ์ดโมเดล เรานับทุกแถวที่ทั้งสองโมเดลมีตัวเลขกำกับ
Qwen3.8-27B ชนะ 15 จาก 19 แถวนั้น และแพ้ 4 แถว ฝั่งที่ชนะได้แก่ SWE-bench Pro (61.7 ต่อ 53.4) การทำตามคำสั่งบน IFBench (79.5 ต่อ 62.5) การเขียนโค้ดแข่งขันบน LiveCodeBench v6 (90.3 ต่อ 88.8) การควบคุมคอมพิวเตอร์บน OSWorld-Verified (84.3 ต่อ 72.7) งานเอเจนต์บนมือถือใน AndroidWorld (81.9 ต่อ 62.0) และเบนช์มาร์กหลายรูปแบบอีกยาวเหยียดที่ระยะห่างไม่ได้สูสีเลย เช่น 90.0 ต่อ 65.5 บน MathVision, 83.7 ต่อ 66.0 ในการวิเคราะห์แผนภูมิของ CharXiv และ 65.5 ต่อ 40.8 ในการให้เหตุผลเชิงกายภาพของ ERQA
สี่แถวที่แพ้สำคัญกว่าสิบห้าแถวที่ชนะ เพราะมันบอกว่าโมเดล 27 พันล้านพารามิเตอร์ยังทำอะไรไม่ได้ มันแพ้บน Terminal Bench 2.1 (73.0 ต่อ 78.2) แพ้ในการสร้างโค้ดระดับทั้งรีโปบน NL2Repo-Bench (42.3 ต่อ 47.6) แพ้แบบเฉียดฉิวบน GPQA Diamond (89.2 ต่อ 91.3) และแพ้ขาดบน HLE ซึ่งเป็นเบนช์มาร์กการให้เหตุผลข้ามสาขาแบบกว้าง คือ 30.8 ต่อ 40.0 ตัวเลขสุดท้ายนี้คือรูปร่างของข้อจำกัดทั้งหมด คุณอัดความรู้ของทั้งโลกลงไฟล์ขนาด 16.5 GB ไม่ได้ แต่คุณอัดทักษะจำนวนมหาศาลลงไปได้
มีอยู่แถวหนึ่งที่ต้องติดดอกจัน ตัวเลข 79.0 ต่อ 63.8 มาจาก QwenSWEBench ซึ่งเป็นเบนช์มาร์กที่ Qwen สร้างเอง ผลที่ผู้ผลิตรันเองบนเบนช์มาร์กของตัวเองคือหลักฐานที่อ่อนที่สุดในการ์ดโมเดลใด ๆ และเราไม่ได้พึ่งพามัน
ตารางคะแนนของหน่วยงานอิสระก็บอกแบบเดียวกัน
ตารางของผู้ผลิตก็คือตารางของผู้ผลิต เรามาดูฝ่ายที่สามกัน Artificial Analysis ซึ่งรันการประเมินเองแทนที่จะพิมพ์ซ้ำตัวเลขของคนอื่น ได้วัด 27B เรียบร้อยแล้ว ณ วันที่ 21 สิงหาคม 2026 พวกเขาให้ดัชนีความฉลาดของ Qwen3.8-27B ไว้ที่ 52.0 เป็นอันดับหนึ่งจาก 135 โมเดลในกลุ่มน้ำหนักเปิดขนาด 4 ถึง 40 พันล้านพารามิเตอร์ เทียบกับ 44.9 ของ Claude Opus 4.6 Max นั่นคือห่างกัน 7.1 คะแนนโดยโมเดลเปิดเป็นฝ่ายนำ วัดโดยผู้ที่ไม่มีส่วนได้เสียกับผลลัพธ์ และเกิดขึ้น 190 วันหลัง Opus 4.6 ออกสู่ตลาด
ย้อนการเปรียบเทียบนี้กลับไปตามเวลาแล้วจะเห็นเรื่องราวทั้งหมด เดือนกรกฎาคม 2023 โมเดลเปิดที่ดีที่สุดขนาดต่ำกว่า 40 พันล้านพารามิเตอร์ทำได้ 2.6 บนดัชนีเดียวกัน เดือนกรกฎาคม 2024 ได้ 7.4 เดือนมีนาคม 2025 ได้ 13.4 เดือนกุมภาพันธ์ 2026 ได้ 34.6 และสัปดาห์ที่แล้วได้ 52.0
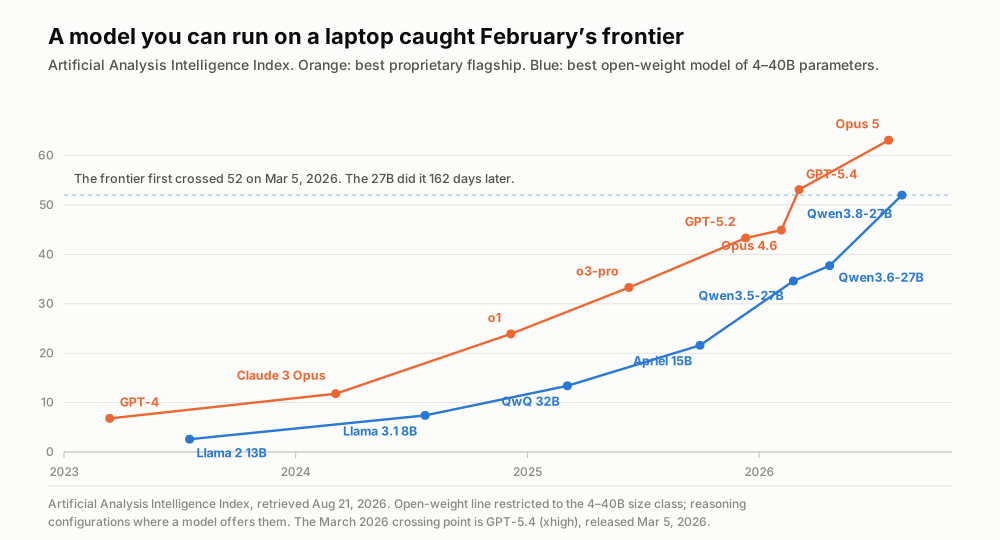
เส้นทั้งสองไต่ขึ้นทั้งคู่ สิ่งที่น่าสนใจคือระยะห่างในแนวนอนระหว่างสองเส้น ดัชนีความฉลาดของ Artificial Analysis ดึงข้อมูลวันที่ 21 สิงหาคม 2026
นี่คือตัวเลขที่ควรมีชื่อเรียก ฝั่งแนวหน้าข้ามระดับ 52 บนดัชนีความฉลาดครั้งแรกเมื่อวันที่ 5 มีนาคม 2026 ตอนที่ GPT-5.4 ที่ระดับความพยายามในการให้เหตุผลสูงสุดทำได้ 53.1 ส่วนโมเดลที่เล็กพอจะรันบนเครื่องส่วนตัวไปถึงจุดนั้นเมื่อวันที่ 14 สิงหาคม ช้ากว่า 162 วัน เราขอเรียกมันว่า ช่วงเวลาไล่ตาม คือระยะเวลาระหว่างที่ความสามารถหนึ่งปรากฏขึ้นที่แนวหน้ากับตอนที่มันมาปรากฏบนฮาร์ดแวร์ของคุณเอง
ช่วงเวลานี้เคยยาวกว่านี้มาก Llama 3.1 8B ใช้เวลา 260 วันกว่าจะไปถึงระดับที่ GPT-4 Turbo เคยทำไว้ GLM-4.7-Flash ใช้เวลา 410 วันกว่าจะเทียบเท่า o1 ส่วนสามรุ่นล่าสุดในขนาดที่โน้ตบุ๊กรันได้อยู่ที่ 201, 155 และ 162 วัน ฝั่งแนวหน้าไม่ได้ช้าลงเลย Opus 5 Max วันนี้อยู่ที่ 63.1 แต่ขอบที่ตามมาไล่ตามเร็วขึ้นราวสองเท่าเมื่อเทียบกับสองปีก่อน
ราคาไม่ได้ลดลง แต่ถล่มลงมา
ความสามารถเป็นเพียงครึ่งเดียวของการเปรียบเทียบ อีกครึ่งคือใบเสร็จ
Epoch AI เผยแพร่การวัดเรื่องนี้ที่สะอาดที่สุดเมื่อเดือนมีนาคม 2025 และวิธีการก็ควรค่าแก่การทำความเข้าใจ คือตรึงคะแนนเบนช์มาร์กไว้ แล้วติดตามตามเวลาว่าโมเดลที่ถูกที่สุดซึ่งทำคะแนนนั้นได้คือรุ่นใด ถ้าตรึงเกณฑ์ไว้ที่ 86 คะแนน MMLU ของ GPT-4 บันไดราคาจะไล่จาก 37.50 ดอลลาร์ต่อล้านโทเคนในเดือนมีนาคม 2023 เป็น 15.00 ในเดือนพฤศจิกายน 2023 เป็น 7.50 ในเดือนพฤษภาคม 2024 เป็น 2.19 ในเดือนเดียวกันนั้นเอง และเหลือ 0.18 ในเดือนกุมภาพันธ์ 2025 คะแนนเท่าเดิมทั้งหมด ถูกลง 208 เท่าในเวลา 23 เดือน
ข้อค้นพบหลักของ Epoch คืออัตราการลดลงต่างกันมหาศาลตามชนิดของงาน อยู่ระหว่าง 9 ถึง 900 เท่าต่อปีขึ้นกับว่าตรึงความสามารถแบบไหนไว้ โดยราคาของสมรรถนะระดับ GPT-4 บนคำถามวิทยาศาสตร์ระดับปริญญาเอกลดลงราว 40 เท่าต่อปี ส่วนทิศทางนั้นไม่เคยเปลี่ยนเลย
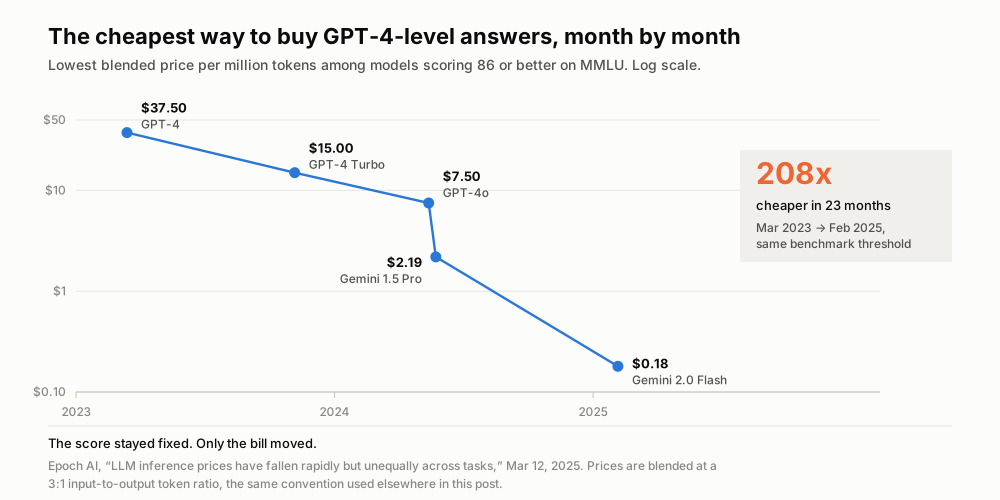
ทุกจุดบนเส้นนี้ตรึงคะแนนเบนช์มาร์กไว้เท่ากันหมด Epoch AI วันที่ 12 มีนาคม 2025
ต่อชุดข้อมูลนี้มาถึงราคาปัจจุบันแล้วแนวโน้มก็ยังเดินหน้าต่อ บนแค็ตตาล็อก OpenRouter ณ วันที่ 21 สิงหาคม 2026 Qwen3.8-27B คิดค่าอินพุต 0.45 ดอลลาร์ต่อล้านโทเคน และเอาต์พุต 3.20 ดอลลาร์ต่อล้านโทเคน ส่วน Claude Opus 4.6 คิด 5.00 และ 25.00 ดอลลาร์ เมื่อผสมตามสัดส่วนอินพุตต่อเอาต์พุต 3 ต่อ 1 แบบที่ Epoch ใช้ จะได้ 1.09 เทียบกับ 10.00 ดอลลาร์ นั่นคือ โมเดลเปิดถูกกว่า 9.1 เท่า และดีกว่าเรือธงโมเดลปิดของเมื่อหกเดือนก่อนอยู่ 7.1 คะแนนดัชนี
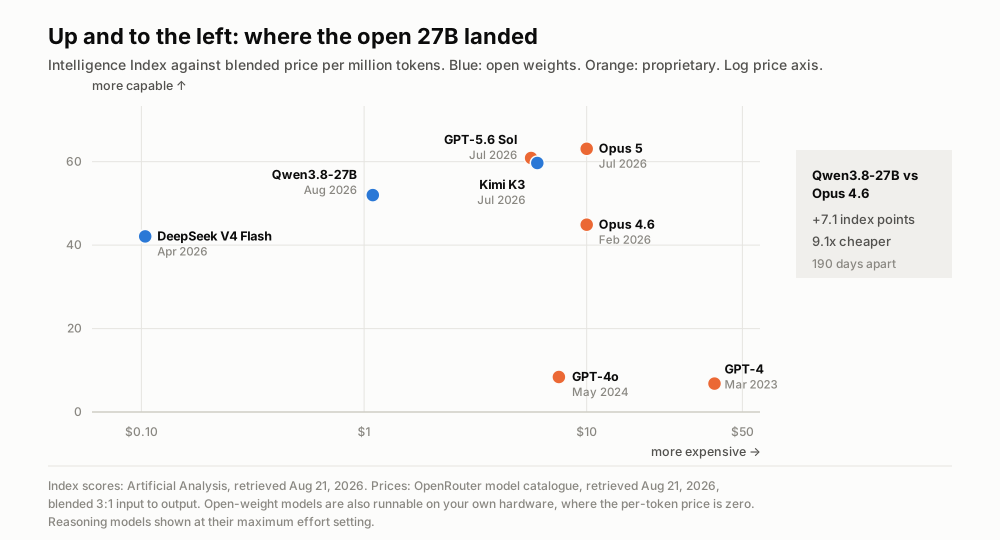
ทุกโมเดลที่มีความหมายกำลังเคลื่อนไปทางมุมบนซ้าย คะแนนจาก Artificial Analysis ราคาจาก OpenRouter ดึงข้อมูลทั้งคู่วันที่ 21 สิงหาคม 2026
แล้วยังมีทางเลือกที่ไม่มีราคาต่อโทเคนเลยด้วยซ้ำ ลองรัน 27B บน RTX 4090 ของคุณเองที่ราว 48 โทเคนต่อวินาทีตามที่ผู้ใช้รายงานในกระทู้เปิดตัว สมมติกำลังไฟตามสเปกของการ์ดที่ 450 วัตต์ แล้วใช้ราคาไฟฟ้าครัวเรือนเฉลี่ยของสหรัฐฯ ที่ 18.44 เซนต์ต่อกิโลวัตต์ชั่วโมง (EIA พฤษภาคม 2026) ค่าไฟจะตกราว 0.48 ดอลลาร์ต่อล้านโทเคนเอาต์พุต ยังไม่นับค่าการ์ด แต่ก็ไม่ต้องนับกำไรของใครแล้วเช่นกัน นี่คือค่าประมาณจากการคำนวณที่วางสมมติฐานไว้บนโต๊ะครบถ้วน ไม่ใช่คำกล่าวอ้างของผู้ผลิต
ก่อนและหลัง ทีละบรรทัด
| กรกฎาคม 2023 | สิงหาคม 2026 | |
|---|---|---|
| โมเดลที่ดาวน์โหลดได้ดีที่สุด | Llama 2 70B (Meta, 18 ก.ค. 2023) | Qwen3.8-27B (Alibaba, 14 ส.ค. 2026) |
| พารามิเตอร์ | 7 หมื่นล้าน | 2.7 หมื่นล้าน |
| บิลด์ชุมชน 4 บิตมาตรฐาน | 41.4 GB | 16.5 GB |
| บิลด์เล็กสุดที่ยังใช้งานได้ | 7.9 GB (13B, MMLU 54.8) | 9.8 GB (2 บิต, บริบท 128K บนการ์ด 16 GB) |
| ฮาร์ดแวร์ที่เป็นไปได้จริง | การ์ด 24 GB สองใบ หรือ Mac 64 GB | การ์ดผู้บริโภค 16 GB หนึ่งใบ |
| โมเดลแนวหน้าในยุคนั้น | GPT-4 (14 มี.ค. 2023) | Claude Opus 4.6 Max (5 ก.พ. 2026) |
| ผลการเทียบกับโมเดลนั้น | MMLU −17.5, GSM8K −35.2, HumanEval −37.1 | ชนะ 15 จาก 19 เบนช์มาร์กที่เผยแพร่, ดัชนี +7.1 |
| ราคาผสมของโมเดลแนวหน้านั้น | 37.50 ดอลลาร์ต่อล้านโทเคน | 10.00 ดอลลาร์ต่อล้านโทเคน |
| ราคาผสมของโมเดลเปิด | ไม่มีบริการในระดับกว้าง | 1.09 ดอลลาร์ต่อล้านโทเคน |
| สัญญาอนุญาต | Llama 2 Community License | Apache 2.0 |
แหล่งอ้างอิงของทุกช่องอยู่ท้ายบทความ บรรทัดที่เราย้อนกลับไปดูบ่อยที่สุดคือบรรทัดรองสุดท้าย ราคาของฝั่งแนวหน้าเองลดลง 3.75 เท่าในสามปี ขณะที่ทางเลือกฝั่งเปิดโผล่ขึ้นมาอยู่ใต้เส้นนั้นที่ราวหนึ่งในสิบ ทั้งสองอย่างเกิดขึ้นจริง แต่สิ่งที่เปลี่ยนว่าใครมีสิทธิ์ลงมือสร้างคืออย่างที่สอง
สิ่งที่ยังไม่จริง
ความตื่นเต้นรอบการเปิดตัวครั้งนี้ล้ำหน้าหลักฐานอยู่สี่จุด เรามาทำเครื่องหมายไว้
มันไม่ใช่แนวหน้า บนดัชนีเดียวกัน Claude Opus 5 Max ได้ 63.1 และ GPT-5.6 Sol Max ได้ 60.9 สูงกว่า 52.0 อยู่พอสมควร ถ้างานของคุณขึ้นอยู่กับการให้เหตุผลที่ยากที่สุดเท่าที่หาได้ แนวหน้าก็ยังเป็นสินค้าคนละตัว และยังเป็นของปิดอยู่
เทียบกับขนาดแล้วมันก็ไม่ได้ถูก บทสรุปของ Artificial Analysis เองเรียก Qwen3.8-27B ว่า «แพงเป็นพิเศษเมื่อเทียบกับโมเดลน้ำหนักเปิดขนาดใกล้เคียงกัน» ค่ามัธยฐานของกลุ่มนี้อยู่ที่ 0.05 ดอลลาร์ต่อล้านโทเคนอินพุต ส่วน Qwen อยู่ที่ 0.43 คุณกำลังจ่ายเงินให้ความสามารถ ไม่ใช่ให้จำนวนพารามิเตอร์
มันพูดมาก และการพูดมากคือค่าใช้จ่าย ระหว่างรันชุดประเมินดัชนีความฉลาด 27B สร้างโทเคนเอาต์พุตออกมา 160 ล้านโทเคน เทียบกับค่ามัธยฐาน 45 ล้าน ผู้ใช้รายหนึ่งป้อนพรอมป์ต์สองคำบน Mac mini ขนาด 64 GB แล้วนั่งดูมันคิดอยู่ 17 นาที 12 วินาที โมเดลที่ให้เหตุผลจะเก็บเงินคุณเป็นเวลาบนนาฬิกา แม้โทเคนจะฟรีก็ตาม
และคะแนนเบนช์มาร์กเป็นของโมเดลที่ความละเอียดเต็ม บิลด์ 2 บิตขนาด 9.8 GB ที่ลงการ์ดจอของคุณได้นั้นไม่ใช่โมเดลตัวที่ทำได้ 52.0 การควอนไทซ์แบบหนักแลกมาด้วยความแม่นยำ โดยเฉพาะบนบริบทยาว ทุกคำกล่าวว่า «รันบนโน้ตบุ๊กได้» รวมถึงของเราเอง มีดอกจันตัวนี้ติดอยู่เสมอ
ทำไมช่วงเวลาไล่ตามน่าจะสั้นลงอีก
จากตรงนี้คือความเห็นของเรา และเราจะทำเครื่องหมายจุดเปลี่ยนให้ชัด ทุกอย่างข้างบนคือการวัด ส่วนที่ตามมาคือการอนุมานจากการวัดนั้น
กลไกที่กดช่วงเวลาไล่ตามให้ลดลงไม่ได้ลึกลับอะไร เทคนิคการฝึกหลังการเทรนที่เผยแพร่จากฝั่งแนวหน้าถูกทำซ้ำในห้องแล็บฝั่งเปิดภายในไม่กี่เดือน การควบคุมระดับความพยายามในการให้เหตุผลซึ่งเมื่อปีครึ่งก่อนยังเป็นเทคนิคเฉพาะของเจ้าของ วันนี้มาพร้อมเป็นพารามิเตอร์ที่มีเอกสารกำกับบนการ์ดโมเดลตัวนี้ การควอนไทซ์โดยชุมชนเสร็จก่อนที่เอกสารของห้องแล็บต้นทางจะหยุดแก้ด้วยซ้ำ ไม่มีวงจรป้อนกลับใดในสามวงจรนี้ที่มีเหตุผลให้ช้าลง และสองในนั้นยิ่งเร็วขึ้นเมื่อมีคนเข้าร่วมมากขึ้น
ดังนั้นความคาดหวังที่สมเหตุสมผลสำหรับรุ่นถัดไปไม่ใช่ว่าโมเดลเปิดจะแซงแนวหน้า แต่คือ 162 วันนี้จะถูกบีบให้สั้นลงเรื่อย ๆ ในขณะที่ความสามารถสัมบูรณ์ของทั้งสองฝั่งยังไต่ขึ้น เมื่อเป็นเช่นนั้น เกณฑ์ที่น่าสนใจจึงไม่ใช่ «โมเดลเปิดจะชนะได้ไหม» แต่เป็น «แนวหน้าต้องใหม่แค่ไหน ความต่างถึงจะเลิกสำคัญกับงานของฉัน» สำหรับการถอดเทปประชุม การแปล การสรุป และงานเอกสารส่วนใหญ่ เกณฑ์นั้นถูกข้ามไปนานแล้ว ส่วนงานวิจัยระดับแนวหน้าและงานวิศวกรรมเอเจนต์ที่ยากที่สุดยังไม่ถึง
นี่คือโลกที่ดีกว่าโลกของปี 2023 มาก และควรพูดออกมาตรง ๆ ต้นทุนในการทำให้คอมพิวเตอร์เข้าใจภาษาได้อย่างมีฝีมือลดลงสองระดับขนาดในเวลาสามปี และยังลดต่อไป คนที่ได้ประโยชน์มากที่สุดคือคนที่เคยถูกราคากันออกไป ได้แก่ นักพัฒนาเดี่ยว ทีมงานในประเทศที่ค่าใช้จ่าย 10 ดอลลาร์ต่อล้านโทเคนไม่ใช่เศษทศนิยม นักวิจัยที่มีทุนวิจัยแทนที่จะมีงบประมาณ และทุกคนที่จำเป็นต้องเก็บข้อมูลไว้บนเครื่องตัวเองด้วยเหตุผลทางกฎหมาย
สรุป: แนวหน้าเลิกเป็นสถานที่ และกลายเป็นวันที่
คำถามเดิมคือคุณเข้าถึงห้องแล็บไหนได้บ้าง คำถามใหม่คือคุณยอมตามหลังแนวหน้ากี่เดือน ในเมื่อมันถูกกว่าเก้าเท่าและรันบนฮาร์ดแวร์ที่คุณเป็นเจ้าของอยู่แล้ว
สำหรับงานจำนวนมากขึ้นเรื่อย ๆ คำตอบที่ซื่อสัตย์คือ ราวห้าเดือน และกำลังสั้นลง
Telli.sh อยู่ตรงไหน: ทุกอย่างข้างต้นคือเหตุผลที่เราสร้างบนโมเดลเปิดแทนที่จะยึดติดกับผู้ให้บริการรายเดียว Telli.sh ใช้โมเดล Qwen แบบเปิดในเส้นทางการสรุปอยู่แล้ว ทุกก้าวที่เส้นโค้งนี้ลดลงจึงมาถึงคุณในรูปของบันทึกการประชุมที่ดีขึ้น ไม่ใช่ประกาศขึ้นราคา สิ่งที่เราทุ่มเวลาให้คือส่วนที่ไม่มีไฟล์ดาวน์โหลดใดมอบให้ได้ นั่นคือการเก็บเสียงยาวหนึ่งชั่วโมงได้ครบถ้วน แยกแยะผู้พูดได้ถูกคน แปลสดข้าม 15 ภาษา และเปลี่ยนทั้งหมดนั้นเป็นบันทึกที่ยังค้นหาเจอในอีกหลายเดือนถัดมา
แหล่งอ้างอิง
- การ์ดโมเดลและตารางเบนช์มาร์กของ Qwen3.8-27B, Hugging Face — ตัวเลขเทียบตรงกับ Opus 4.6 Max ดึงข้อมูลวันที่ 21 สิงหาคม 2026
- Artificial Analysis: วิเคราะห์ความฉลาด สมรรถนะ และราคาของ Qwen3.8 27B — ดัชนีความฉลาด 52.0 ราคาและปริมาณเอาต์พุต ดึงข้อมูลวันที่ 21 สิงหาคม 2026
- Artificial Analysis: หน้าโมเดล Claude Opus 4.6 — ดัชนีความฉลาด 44.9 ที่ระดับความพยายามในการให้เหตุผลสูงสุด ดึงข้อมูลวันที่ 21 สิงหาคม 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 มีนาคม 2025 — บันไดราคาที่ตรึงเกณฑ์ และช่วง 9 ถึง 900 เท่าต่อปี
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 กรกฎาคม 2023 — ตารางที่ 4, Llama 2 70B เทียบกับ GPT-4
- รายการไฟล์ของ TheBloke/Llama-2-70B-Chat-GGUF — บิลด์ Q4_K_M ขนาด 41.4 GB เผยแพร่วันที่ 4 กันยายน 2023
- รายการไฟล์ของ unsloth/Qwen3.8-27B-GGUF — บิลด์ขนาด 16.5 GB และ 9.8 GB ยอดดาวน์โหลดดึงข้อมูลวันที่ 21 สิงหาคม 2026
- แค็ตตาล็อกโมเดลของ OpenRouter — ราคาต่อโทเคนของ Qwen3.8-27B, Claude Opus 4.6 และ Claude Opus 5 ดึงข้อมูลวันที่ 21 สิงหาคม 2026
- กระทู้ Hacker News เรื่องการเปิดตัว Qwen3.8-27B, 14 สิงหาคม 2026 — รายงานความเร็วจากผู้ใช้จริงบนการ์ด 16 และ 24 GB
- สำนักงานสารสนเทศพลังงานสหรัฐฯ, Electric Power Monthly, ตารางที่ 5.3 — 18.44 เซนต์ต่อกิโลวัตต์ชั่วโมง ค่าเฉลี่ยครัวเรือน พฤษภาคม 2026
- บทความก่อนหน้าของเราเรื่องการเปิดน้ำหนัก Qwen3.8 และ เรื่องคลื่นน้ำหนักเปิดในภาพกว้าง
- หน้า Wikimedia Commons ของภาพถ่าย Cray Y-MP
