Qwen3.8-27B open weights: ขนาดไฟล์ Q4_K_M และความเร็วจริงบน 4090/Mac
Qwen3.8-27B ใช้สัญญาอนุญาต Apache 2.0 ไฟล์ GGUF แบบ Q4_K_M ขนาด 17.1 GB ใส่โน้ตบุ๊ก 32 GB ได้ ส่วน FP8 อยู่ที่ 30.9 GB วัดจริงได้ 48 โทเคน/วินาที บน RTX 4090 และ 12.75 บน Mac mini M4 Pro
วันที่ 3 สิงหาคม บัญชี Qwen ของ Alibaba บอกว่าน้ำหนักโมเดลแบบเปิดจะมา «สัปดาห์หน้า» ซึ่งเป็นประโยคชนิดที่วงการ AI สอนให้ทุกคนฟังแบบหักส่วนลดไว้ก่อน สิบสองวันต่อมา ไม่เหลืออะไรให้หักอีกแล้ว น้ำหนักของ Qwen3.8-Max ขนาด 2.4 ล้านล้านพารามิเตอร์ ปรากฏบน Hugging Face เมื่อวันที่ 12 สิงหาคม และรุ่นเล็ก คือ Qwen3.8-27B ภายใต้สัญญาอนุญาต Apache 2.0 ธรรมดา ๆ ตามมาในวันที่ 14
จากนั้นส่วนที่น่าสนใจจริง ๆ ก็เกิดขึ้น ภายในชั่วโมงเดียวกับที่ Qwen เขียนการ์ดโมเดลของ 27B เสร็จ กลุ่มชุมชนสามกลุ่มที่ต่างกันได้แปลงมันเป็นรูปแบบที่รันบนคอมพิวเตอร์ส่วนตัวได้เรียบร้อยแล้ว อีกสองวันถัดมา เวอร์ชันแปลงเหล่านั้นมียอดดาวน์โหลดทะลุหนึ่งล้านครั้ง
ตัวเลขนี้ต่างหากคือข่าว ไม่ใช่ตารางคะแนนเปรียบเทียบ โมเดลขนาด 27 พันล้านพารามิเตอร์จากห้องปฏิบัติการ AI ชั้นนำของโลก เดินทางจาก «ประกาศแล้ว» ไปสู่ «กำลังรันอยู่บนโต๊ะทำงานราวหนึ่งล้านตัว» ภายในราว 48 ชั่วโมง บทความนี้อธิบายด้วยภาษาง่าย ๆ ว่านั่นหมายความว่าอย่างไรจริง ๆ ปล่อยอะไรออกมาภายใต้สัญญาอนุญาตแบบไหน ต้องใช้อะไรบ้างจึงจะรัน 27B บนฮาร์ดแวร์ที่คุณมีอยู่แล้ว สามปีที่ผ่านมาไปได้ไกลแค่ไหน และส่วนที่รายงานส่วนใหญ่ข้ามไป นั่นคือสิ่งที่ 27B บนเครื่องตัวเองยังทำไม่ได้
สรุปสั้น ๆ
- คำสัญญาถูกรักษาไว้ Qwen3.8-Max รวม 2.4 ล้านล้าน ทำงานจริง 95 พันล้าน มาถึงเมื่อ 12 สิงหาคม ส่วน Qwen3.8-27B มาถึงเมื่อ 14 สิงหาคม ทั้งคู่ดาวน์โหลดได้จริง ไม่ใช่ตัวอย่างที่รันบนเซิร์ฟเวอร์ผู้ผลิต
- สัญญาอนุญาตของทั้งสองไม่เหมือนกัน และความต่างนั้นสำคัญกว่าคะแนน รุ่น 27B ใช้ Apache 2.0 ไม่มีเกณฑ์ ไม่มีเงื่อนไข ใช้เชิงพาณิชย์ได้โดยไม่ติดค้างใคร ส่วน Qwen3.8-Max ใช้สัญญาอนุญาตของตัวเอง พร้อมเงื่อนไขรายได้สำหรับธุรกิจที่ให้บริการโมเดล
- ขนาดคือสิ่งที่ตัดสินว่าใครรันอะไรได้ Max คือไฟล์ดาวน์โหลด 4,892 GB ส่วน 27B ที่บีบอัดเหลือ 4 บิต มีขนาด 17.1 GB ซึ่งพอดีกับเครื่องที่มีหน่วยความจำ 32 GB เวอร์ชัน 4 บิตจากชุมชนทะลุ 1.07 ล้านครั้งดาวน์โหลดภายในสองวัน
ภาพ: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0 การรันโมเดลจากห้องปฏิบัติการชั้นนำด้วยตัวเอง หมายถึงเครื่องและการดูแลรักษามันกลายเป็นของคุณด้วย
คำสัญญามาพร้อมวันที่ และวันที่นั้นก็อยู่ได้
วันที่ 4 สิงหาคม เราเขียนถึงการประกาศครั้งนั้นและระบุว่า การรอคอยวัดกันเป็น «สัปดาห์หน้า» ไม่ใช่ «สักวันหนึ่ง» นั่นคือขอบเขตไกลสุดที่หลักฐานตอนนั้นพาไปได้ และเรื่องก็จบลงอย่างเรียบร้อย
Qwen3.8-2.4T-A95B ซึ่งทำตลาดในชื่อ Qwen3.8-Max ปรากฏพร้อมไฟล์สัญญาอนุญาตเมื่อวันที่ 12 สิงหาคม ส่วน Qwen3.8-27B และรุ่น FP8 ที่ปรับให้ประหยัดกว่ามาถึงในวันที่ 14 ทั้งสองวันตกอยู่ในกรอบเวลาที่คำว่า «สัปดาห์หน้า» ชี้ไว้ ในวงการที่โมเดลซึ่งประกาศแล้วมักไม่เคยออกมาจริง การที่ห้องปฏิบัติการรักษากำหนดที่พูดไว้เมื่อเก้าวันก่อนได้ ก็นับว่าน่าสนใจในตัวมันเอง
การตอบรับมาทันทีและมีขนาดใหญ่ กระทู้บน Hacker News เรื่อง 27B เก็บได้ 1,351 คะแนน และ 769 ความเห็นภายในวันเดียว ภายในไม่กี่ชั่วโมง ผู้ปฏิบัติงานเริ่มโพสต์การตั้งค่าสำหรับรันจริงบนฮาร์ดแวร์เฉพาะรุ่น มีคนหนึ่งแบ่งปันการตั้งค่าทั้งสำหรับ NVIDIA DGX Spark และการ์ดจอผู้บริโภค RTX 4090 สองปีก่อนวงการไม่ได้ต้อนรับการปล่อยโมเดลเปิดแบบนี้ ตอนนั้นแค่ทำให้สถาปัตยกรรมใหม่รันได้ก็เป็นงานทั้งสุดสัปดาห์แล้ว
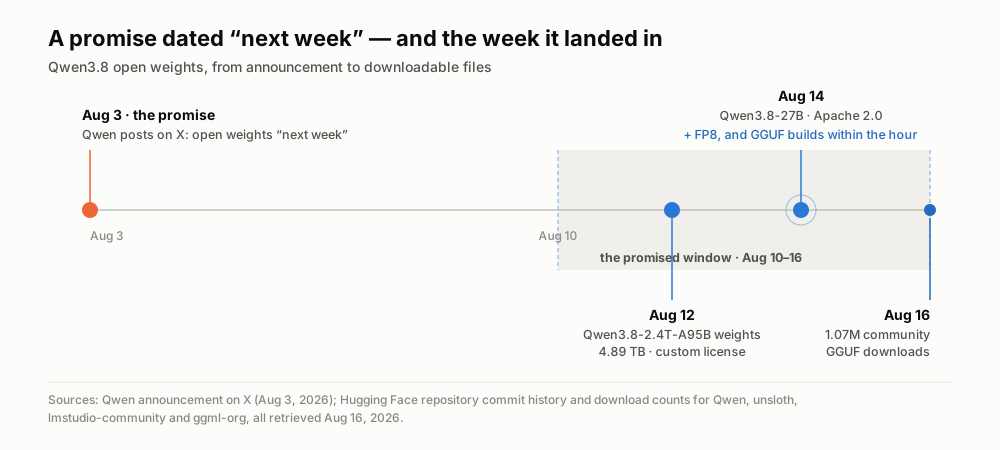
คำสัญญาที่มีวันที่กำกับ และการส่งมอบสองครั้งที่ตกอยู่ภายในกรอบ วันที่จากประวัติคอมมิตของคลังเก็บบน Hugging Face สืบค้นเมื่อ 16 สิงหาคม 2026
ห้าคำศัพท์ ที่เล็งไปที่คำถามว่า «ฉันรันมันได้ไหม»
ถ้าคุณมาจากบทความก่อนหน้าของเรา คุณรู้อยู่แล้วว่าน้ำหนักโมเดลแบบเปิดคืออะไร ห้องปฏิบัติการเผยแพร่ตารางตัวเลขมหาศาลที่โมเดลเรียนรู้มา ซึ่งก็คือตัวโมเดลที่เสร็จแล้ว และคุณดาวน์โหลดมันมารันบนฮาร์ดแวร์ของตัวเอง แล้วสร้างของบนนั้นได้โดยไม่ต้องจ่ายรายครั้ง ที่นี่เราสนใจคำถามถัดไป ซึ่งเป็นเรื่องปฏิบัติล้วน ๆ นั่นคือการรันมันคิดเป็นฮาร์ดแวร์เท่าไร
พารามิเตอร์ คือตัวเลขที่เรียนรู้มาเหล่านั้น และจำนวนของมันกำหนดขนาดดิบของโมเดล กฎคร่าว ๆ เรียบง่ายอย่างโหดร้าย ที่ความละเอียดซึ่งห้องปฏิบัติการใช้ฝึก ทุก ๆ หนึ่งพันล้านพารามิเตอร์กินพื้นที่ราว 2 GB บนดิสก์ และคุณต้องมีหน่วยความจำประมาณเท่านั้นเพื่ออุ้มโมเดลไว้ระหว่างทำงาน ดังนั้นโมเดล 27 พันล้านพารามิเตอร์คือไฟล์ดาวน์โหลด 55 GB ส่วนโมเดล 2.4 ล้านล้านเกือบ 5 เทระไบต์ นี่คือเหตุผลที่ตัวหนึ่งเป็นเรื่องของแล็ปท็อป และอีกตัวเป็นเรื่องของศูนย์ข้อมูล
การควอนไทซ์ คือสิ่งที่ปิดช่องว่างนั้น และเป็นแนวคิดที่มีประโยชน์ที่สุดสำหรับใครก็ตามที่อยากรันโมเดลที่บ้าน ปกติพารามิเตอร์ถูกเก็บด้วยความละเอียด 16 บิต การควอนไทซ์ปัดมันลงเหลือบิตน้อยลง เป็น 8 เป็น 4 บางครั้งเหลือ 2 และไฟล์ก็หดลงในสัดส่วนใกล้เคียงกัน การควอนไทซ์แบบ 4 บิตเปลี่ยนไฟล์ 55 GB นั้นให้เหลือราว 17 GB คุณเสียความแม่นยำไปนิดหน่อย และได้ความสามารถที่จะรันมันได้จริงกลับมา GGUF คือรูปแบบไฟล์ที่เวอร์ชันบีบอัดเหล่านี้ใช้เท่านั้นเอง เป็นสิ่งที่เครื่องมืออย่าง llama.cpp, Ollama และ LM Studio อ่าน เมื่อเห็นคำว่า «Q4_K_M» ให้อ่านว่า «เวอร์ชัน 4 บิตที่คนส่วนใหญ่ใช้»
โมเดลหนาแน่นกับโมเดลผสมผู้เชี่ยวชาญ เป็นตัวตัดสินความเร็วเมื่อโมเดลลงเครื่องได้แล้ว Qwen3.8-27B เป็นแบบหนาแน่น พารามิเตอร์ทั้ง 27 พันล้านทำงานทุกครั้งที่สร้างคำหนึ่งคำ ส่วน Qwen3.8-Max เป็นแบบผสมผู้เชี่ยวชาญ มีพารามิเตอร์รวม 2.4 ล้านล้าน แต่ตัวจัดเส้นทางเลือกใช้เพียงราว 95 พันล้านต่อโทเคน กระจายอยู่ในเครือข่ายย่อยเฉพาะทาง 512 ชุด ตัวเลขรวมบอกค่าใช้จ่ายด้านพื้นที่เก็บ ส่วนตัวเลขที่ทำงานจริงบอกค่าใช้จ่ายด้านการประมวลผล ความต่างนี้มีผลเชิงปฏิบัติที่คมมาก และเราจะกลับมาที่มันอีกครั้ง
หน้าต่างบริบท คือปริมาณที่โมเดลพิจารณาได้ในคราวเดียว รุ่น 27B รองรับ 262,144 โทเคนโดยพื้นฐาน ราวกับบันทึกการประชุมความยาวหนึ่งชั่วโมงหลายฉบับซ้อนกัน และขยายได้ถึงหนึ่งล้านด้วยการปรับการตั้งค่า
สัญญาอนุญาตคือสิ่งที่ควรอ่านก่อน
นี่คือข้อค้นพบที่แบกน้ำหนักของบทความนี้ไว้ และมันขัดกับข้อสมมติที่ว่าโมเดลตระกูลเดียวกันย่อมใช้เงื่อนไขตระกูลเดียวกัน
Qwen3.8-27B ใช้ Apache 2.0 นั่นคือปลายด้านที่ผ่อนปรนที่สุดของสเปกตรัม ใช้ได้ แก้ได้ ปรับจูนได้ ใส่ลงในผลิตภัณฑ์เชิงพาณิชย์ได้ สร้างธุรกิจบนมันได้ โดยไม่ติดค้างอะไรและไม่ต้องขออนุญาตใคร ไม่มีเกณฑ์รายได้ ไม่มีข้อบังคับให้แสดงชื่อบนหน้าจอ ไม่มีการกันขอบเขตการใช้งาน
Qwen3.8-Max ไม่ใช่แบบนั้น มันมาพร้อม «Qwen3.8-Max License» ของตัวเอง ซึ่งเริ่มต้นคล้าย MIT แล้วผนวกสองเงื่อนไขเข้าไป ถ้าผลิตภัณฑ์ของคุณมีผู้ใช้งานประจำเดือนเกิน 100 ล้านคน หรือรายได้ต่อเดือนเกิน 20 ล้านดอลลาร์สหรัฐ คุณต้องแสดงชื่อโมเดลบนหน้าจอ และถ้าคุณทำธุรกิจให้บริการโมเดล หรือผู้ช่วยทำงานด้วย AI ที่มีรายได้เกิน 50 ล้านดอลลาร์ในช่วงสิบสองเดือนติดต่อกันช่วงใดก็ตาม คุณต้องทำข้อตกลงแยกต่างหากกับ Qwen ก่อนใช้งานเชิงพาณิชย์
สำหรับนักพัฒนาคนเดียว หรือบริษัทที่ใช้ภายในองค์กร ไม่มีข้อไหนกัดเลย แต่นี่คือดอกจันตัวเดียวกับที่เราชี้ไว้ ตอนที่ Kimi K3 ออกมาด้วยสัญญาอนุญาตของตัวเองแทนที่จะเป็น MIT และบทเรียนก็ซ้ำเดิม «น้ำหนักเปิด» กับ «สัญญาอนุญาตเปิด» เป็นคนละคำถาม และห้องปฏิบัติการเดียวกันอาจตอบต่างกันสำหรับโมเดลสองตัวที่ปล่อยห่างกันสองวัน อ่านสัญญาอนุญาตก่อนจะตกหลุมรักคะแนน
| โมเดล | พารามิเตอร์รวม | ทำงานจริงต่อโทเคน | ขนาดดาวน์โหลด | สัญญาอนุญาต | ที่รันตามจริง |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2.4 ล้านล้าน | 95 พันล้าน | 4,892 GB | ของตัวเอง มีเกณฑ์รายได้ | คลัสเตอร์ตัวเร่งการคำนวณ |
| Qwen3.8-Max, FP8 | 2.4 ล้านล้าน | 95 พันล้าน | 2,496 GB | ของตัวเอง มีเกณฑ์รายได้ | คลัสเตอร์ตัวเร่งการคำนวณ |
| Qwen3.8-27B | 27 พันล้าน หนาแน่น | 27 พันล้าน | 55.6 GB | Apache 2.0 | เวิร์กสเตชันหลายการ์ดจอ |
| Qwen3.8-27B, FP8 | 27 พันล้าน หนาแน่น | 27 พันล้าน | 30.9 GB | Apache 2.0 | การ์ดจอระดับสูงหนึ่งใบ |
| Qwen3.8-27B, Q4_K_M GGUF | 27 พันล้าน หนาแน่น | 27 พันล้าน | 17.1 GB | Apache 2.0 | แล็ปท็อป 32 GB หรือการ์ด 4090 |
การรัน 27B ต้องใช้อะไรจริง ๆ
คำตอบตรงไปตรงมาคือ น้อยกว่าที่คุณคิด และมากกว่าที่พาดหัวข่าวชวนให้เข้าใจ
ขั้นต่ำสุดคือคำสั่งเดียว รุ่น 27B อยู่ในคลังของ Ollama คำสั่ง ollama run qwen3.8 จะดึงเวอร์ชัน 18 GB ที่มีหน้าต่างบริบท 256K และรับภาพเป็นอินพุต มีทั้งหมดสิบสองรุ่นย่อย รวมถึงรุ่นที่ปรับสำหรับชิปของ Apple ส่วน LM Studio ที่ให้หน้าต่างแชทแทนเทอร์มินัล ก็มีเวอร์ชันของตัวเองขึ้นภายในไม่กี่นาทีหลังการปล่อย ทั้งสองอย่างไม่ได้เรียกร้องให้คุณเข้าใจหัวข้อก่อนหน้านี้เลย
จากนั้นความจริงก็แทรกเข้ามาในรูปของจำนวนโทเคนต่อวินาที ตัวเลขที่ผู้ปฏิบัติงานรายงานในกระทู้เปิดตัวตกอยู่ราว ๆ ตรงที่ฮาร์ดแวร์ทำนายไว้ บน RTX 4090 ที่รันเวอร์ชัน 4 บิต มีคนวัดได้ราว 48 โทเคนต่อวินาที เร็วกว่าที่คุณอ่านทันอย่างสบาย ๆ บน Mac mini M4 Pro ที่มีหน่วยความจำ 64 GB อีกคนได้ 12.75 โทเคนต่อวินาที ใช้งานได้ แต่คุณจะนั่งดูมันพิมพ์ และบนแล็ปท็อปที่ใช้ AMD 7840U กับ DDR5 ธรรมดา 64 GB เวอร์ชัน 4 บิตเดียวกันให้ราว 4 โทเคนต่อวินาที ในทางเทคนิคคือรันได้ ในทางปฏิบัติคืองานแบบชุดที่คุณสั่งแล้วเดินจากไป
ตัวเลขสุดท้ายนี่แหละคือจุดที่ความต่างระหว่างหนาแน่นกับผสมผู้เชี่ยวชาญคุ้มค่า คนเดียวกันวัดโมเดลผสมผู้เชี่ยวชาญรุ่นเก่ากว่าซึ่งบนกระดาษใหญ่กว่าบนแล็ปท็อปเครื่องเดียวกัน ได้ราว 20 โทเคนต่อวินาที เร็วกว่าโมเดลหนาแน่นที่เล็กกว่าถึงห้าเท่า เพราะแต่ละคำมีพารามิเตอร์ทำงานเพียงเศษเสี้ยว ถ้าคุณกำลังหาอะไรมารันบนซีพียู ตัวเลขที่ควรใช้เปรียบเทียบคือพารามิเตอร์ที่ทำงานจริง ไม่ใช่พารามิเตอร์รวม นี่คือบทเรียนที่ขัดสัญชาตญาณที่สุดและมีประโยชน์ที่สุดของ AI บนเครื่องตัวเอง
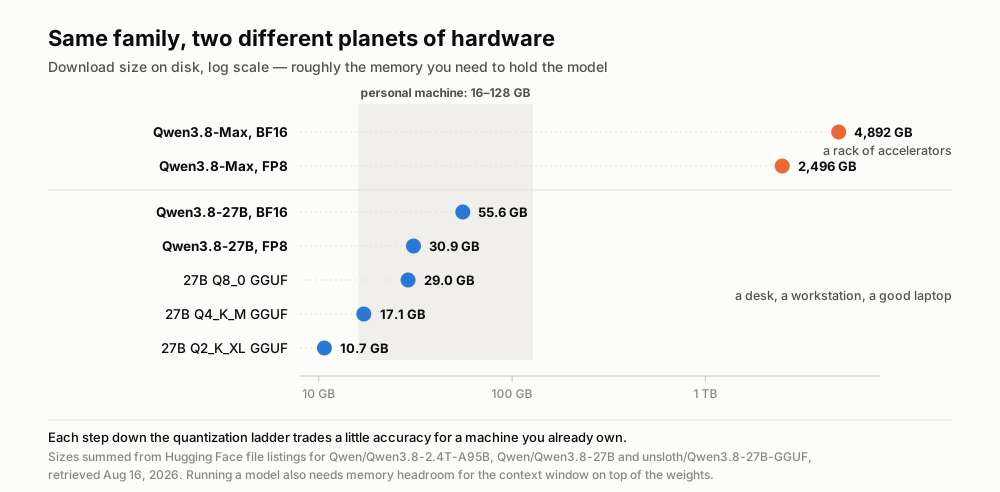
สองสมาชิกจากโมเดลตระกูลเดียวกัน ต่างกันถึง 290 เท่าในขนาดดาวน์โหลด ขนาดรวมจากรายการไฟล์บน Hugging Face สืบค้นเมื่อ 16 สิงหาคม 2026
สามปีก่อน เรื่องนี้ต้องอาศัยข้อมูลรั่วกับสุดสัปดาห์หนึ่ง
ถ้าอยากเห็นว่าก้าวกระโดดนี้ใหญ่แค่ไหน ให้วางมันข้างจุดเริ่มต้นของโมเดลที่รันบนเครื่องตัวเอง
เดือนกุมภาพันธ์ 2023 Meta ปล่อยน้ำหนักของ LLaMA รุ่นแรกให้เฉพาะนักวิจัยที่ได้รับอนุมัติเท่านั้น มันรั่วออกมาภายในราวหนึ่งสัปดาห์ และวงการสมัครเล่นเรื่องโมเดลรันเองทั้งวงการก็ถูกสร้างขึ้นบนไฟล์ที่คนทั่วไปไม่ควรมี วันที่ 10 มีนาคม 2023 นักพัฒนาคนหนึ่งเผยแพร่ llama.cpp โปรแกรมภาษา C++ ขนาดเล็กที่มีลูกเล่นเด่นคือรันโมเดล 7 พันล้านพารามิเตอร์บน MacBook ได้ คลังเก็บนั้นวันนี้มีดาว 124,000 ดวง และเป็นบรรพบุรุษของเครื่องมือ «รันบนเครื่องตัวเอง» แทบทุกตัวที่ใช้กันอยู่
ลองเทียบวันปล่อยทั้งสองครั้ง ปี 2023 คือ 7B ที่รั่วออกมา ไม่มีสัญญาอนุญาตที่พูดถึงได้ ต้องใช้เวลาชุมชนหนึ่งสัปดาห์กว่าจะรันได้ และเป็นโมเดลที่น่าสนใจมากกว่าจะมีประโยชน์ ปี 2026 คือ 27B จากห้องปฏิบัติการชั้นนำ เผยแพร่โดยตั้งใจภายใต้ Apache 2.0 รับภาพและวิดีโอเป็นอินพุต มีหน้าต่างบริบท 262K และเวอร์ชันจากชุมชนเสร็จก่อนที่เอกสารของห้องปฏิบัติการเองจะหยุดเปลี่ยนแปลงเสียอีก คอมมิตแรกของเวอร์ชันแปลงโดย unsloth อยู่ที่เวลา 14:56 UTC ของวันที่ 14 สิงหาคม เร็วกว่าการแก้ไขการ์ดโมเดลครั้งสุดท้ายของ Qwen ถึงสี่นาที
ตัวเลขการใช้งานบอกเรื่องเดียวกันอย่างห้วนกว่า ณ วันที่ 16 สิงหาคม เวอร์ชัน 4 บิตจากชุมชนของ 27B มียอดดาวน์โหลด 867,963 ครั้งจากผู้เผยแพร่รายหนึ่ง 171,518 ครั้งจากรายที่สอง และ 34,520 ครั้งจากรายที่สาม รวม 1.07 ล้านครั้งในสองวัน คลังทางการของ Qwen เองสำหรับ 27B เพิ่มอีก 215,000 ครั้ง ส่วน Qwen3.8-Max ซึ่งเก่งกว่ามาก อยู่ที่ 17,126 ครั้งรวมทั้งสองคลัง
ลองอ่านสัดส่วนนั้นอีกครั้ง โมเดลระดับแนวหน้าได้รับความสนใจราว 1.6 เปอร์เซ็นต์ของที่โมเดลระดับแล็ปท็อปได้รับ สิ่งที่ตลาดออกไปคว้ามาไม่ใช่ความสามารถ แต่คือการเข้าถึง
สิ่งที่ 27B บนเครื่องตัวเองยังทำไม่ได้
ตอนนี้ถึงคราวแก้ไข เพราะความตื่นเต้นแซงหน้าหลักฐานในรูปแบบที่คาดเดาได้
ตารางเปรียบเทียบของ Alibaba เองวาง 27B ไว้เหนือ Opus 4.6 Max ในหลายมาตรวัดด้านการเขียนโปรแกรมแบบตัวแทนและการทำตามคำสั่ง คือ 61.7 ต่อ 53.4 บน SWE-bench Pro และ 79.5 ต่อ 62.5 บน IFBench ขณะที่แพ้ในมาตรวัดอื่น รวมถึง 30.8 ต่อ 40.0 บน HLE ซึ่งวัดความรู้กว้าง ตัวเลขทุกตัวเหล่านั้นผู้ผลิตรายงานเอง ณ เวลาที่เขียนบทความนี้ Artificial Analysis ซึ่งเป็นผู้ประเมินอิสระที่เราอ้างอิง ยังไม่มีรายการสำหรับ 27B เลย แต่จัดอันดับ Qwen3.8-Max ไว้ที่ 10 จาก 188 โมเดล ด้วยคะแนนความฉลาด 58 ซึ่งยอดเยี่ยม และก็เป็นคนละโมเดล
ผู้ปฏิบัติงานคมกว่าตารางคำนวณ ข้อโต้แย้งที่ได้คะแนนสูงสุดในกระทู้ มาจากคนที่บอกว่าตัวเองใช้โมเดลเปิดมานาน และพูดตรง ๆ ว่าโมเดลเหล่านี้ไม่ได้เอาชนะโมเดลบนเซิร์ฟเวอร์ระดับท็อปในการใช้งานจริง มันแค่ «ดีพอ» สำหรับงานจำนวนมาก และรันได้บนฮาร์ดแวร์ราคาจับต้องได้ ซึ่งเป็นคำกล่าวอ้างคนละแบบและถ่อมตัวกว่า อีกความเห็นหนึ่งวางเพดานไว้ในเชิงกายภาพ คุณบีบอัดความรู้ทั้งหมดของมนุษย์ลงในไฟล์ 30 GB ไม่ได้ ดังนั้นโมเดลเล็กจึงยังอ่อนกว่าโดยเปรียบเทียบในการนึกข้อเท็จจริงที่ไม่ค่อยมีคนรู้ ไม่ว่ามันจะคมแค่ไหนในการเขียนโค้ดหรือใช้เครื่องมือ
ยังมีข้อจำกัดอีกสองข้อที่โผล่มาเมื่อรันจริงเท่านั้น การควอนไทซ์ไม่ได้ฟรี โมเดลที่บีบอัดหนักมักหลุดประเด็นในบริบทยาว และอาจตกเข้าวงวนพูดซ้ำ นี่คือเหตุผลที่ใครมีหน่วยความจำเหลือจะได้รับคำแนะนำให้ใช้เวอร์ชันความละเอียดเต็ม และ Qwen รุ่นนี้คิดหนักโดยค่าเริ่มต้น ผู้ใช้คนหนึ่งป้อนคำสองคำคือ «svg owl» ให้ 27B บน Mac mini ขนาด 64 GB แล้วนั่งดูมันสร้างโทเคนการให้เหตุผล 21,769 โทเคน กินเวลา 17 นาที 12 วินาที ก่อนจะตอบ นกฮูกที่ได้ออกมาสวยดี และบิลที่คิดเป็นเวลานาฬิกาจริงก็ออกมาด้วย ซึ่ง API บนเซิร์ฟเวอร์เจ้าไหนก็คงไม่เรียกเก็บ
แล้วยังมีรายการที่ไม่มีใครนับ นั่นคือการดูแลระบบเป็นของคุณแล้ว การอัปเดตโมเดล การเลือกระดับควอนไทซ์ หน่วยความจำที่เหลือ เวอร์ชันไดรเวอร์ ไปจนถึงเสียงพัดลมของเครื่อง API บนเซิร์ฟเวอร์ที่คุณพยายามเลี่ยงนั้น ก็คือทีมคนกลุ่มหนึ่งที่คอยประคองบางอย่างให้ทำงานอยู่เช่นกัน
บทสรุป: คูเมืองเลื่อนลงไปข้างล่างของกองซ้อน
นี่คือประเด็น และมันใหญ่กว่าการปล่อยโมเดลครั้งเดียว
ห้องปฏิบัติการชั้นนำปล่อยโมเดล 27B ที่มีความสามารถในวันพฤหัสบดี พอถึงวันเสาร์ สำเนาเวอร์ชันที่ชุมชนบีบอัดกว่าหนึ่งล้านชุดอยู่บนเครื่องของผู้คนแล้ว มันอยู่ห่างออกไปแค่คำสั่งเดียวใน Ollama และการสร้างธุรกิจบนมันก็เสรีทางกฎหมาย ไม่ว่าความได้เปรียบที่โมเดลนั้นแทนอยู่จะเป็นอะไร มันใช้เวลาราวสองวันในการกลายเป็นของที่คู่แข่งทุกรายเข้าถึงได้พร้อมกัน เรียกมันว่าคูเมืองสองวัน ความได้เปรียบด้านโมเดลที่วันนี้มีครึ่งชีวิตราว 48 ชั่วโมง
นี่ไม่ใช่คำทำนาย นี่คือการวัดผล ที่ทำในสัปดาห์นี้ กับการปล่อยครั้งนี้
และมันนิยามใหม่ว่าการสร้างผลิตภัณฑ์ AI หมายถึงอะไร เมื่อชั้นของโมเดลกลายเป็นสินค้าโภคภัณฑ์ที่ใครก็สลับได้ในบ่ายเดียว ตัวโมเดลก็เลิกเป็นสิ่งที่คุณใช้แข่งขัน สิ่งที่อยู่รอดคือทุกอย่างที่ห่อหุ้มมันไว้ ความเสถียรตอนเซิร์ฟเวอร์ประมวลผลล้มตอนตีสาม ท่อข้อมูลที่เก็บ ทำความสะอาด และดึงบริบทที่ถูกต้องกลับมา การประเมินที่บอกคุณว่ามันได้ผลกับข้อมูลของคุณหรือแค่กับข้อมูลของชุดทดสอบ หน้าจอที่คนจะใช้จริง และข้อตกลงเรื่องความไว้วางใจ ทั้งความเป็นส่วนตัว ระยะเวลาเก็บข้อมูล และใครเห็นอะไรได้บ้าง ซึ่งเป็นตัวตัดสินว่าจะมีใครยอมส่งไฟล์บันทึกการประชุมมาให้คุณตั้งแต่แรกหรือเปล่า
ไม่มีอะไรในนั้นกลายเป็นสินค้าโภคภัณฑ์ได้ในสองวัน และไม่มีอะไรในนั้นมีปุ่มดาวน์โหลด
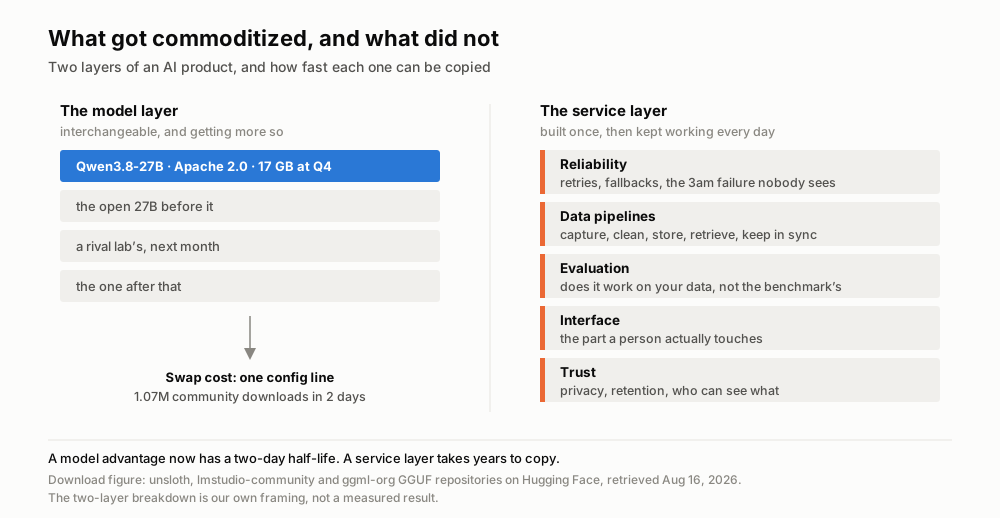
ชั้นที่ราคาถูกลงในสัปดาห์นี้ และชั้นที่ไม่ ตัวเลขดาวน์โหลดจาก Hugging Face สืบค้นเมื่อ 16 สิงหาคม 2026 การแบ่งเป็นสองชั้นเป็นกรอบคิดของเราเอง
ดังนั้นปฏิกิริยาที่ถูกต้องต่อการที่โมเดลเปิดชั้นเยี่ยมมาถึงแล็ปท็อป จึงไม่ใช่ «บริษัทโมเดลชนะแล้ว» หรือ «บริษัทผลิตภัณฑ์แพ้แล้ว» แต่คืองานที่น่าสนใจได้เลื่อนลงไปหนึ่งชั้นในกองซ้อน ไปยังที่ซึ่งลอกเลียนได้ยากกว่ามาก และเขียนเป็นพาดหัวได้สนุกน้อยกว่ามาก
Telli.sh อยู่ตรงไหน เราสร้างชั้นของบริการนั้นพอดี บนโมเดลเปิด Telli.sh ใช้โมเดล Qwen แบบเปิดในเส้นทางการสรุปอยู่แล้ว นั่นหมายความว่าทุกครั้งที่คุณภาพของโมเดลเปิดก้าวกระโดด รวมถึงครั้งนี้ ผลดีจะไหลตรงเข้าสู่การถอดเสียง การแปล และการสรุปการประชุม โดยราคาฝั่งคุณไม่เปลี่ยน เวลาของเราหมดไปกับส่วนที่ไม่ได้มาในไฟล์ GGUF คือการเก็บเสียงอย่างเชื่อถือได้ ไม่สับสนว่าใครพูด เปลี่ยนไฟล์บันทึก 60 นาทีให้เป็นโน้ตที่คุณค้นเจอในอีกหลายเดือนถัดมา และบอกให้ชัดว่าข้อมูลของคุณอยู่ที่ไหน
แหล่งอ้างอิง
- การ์ดโมเดลและสัญญาอนุญาต Qwen3.8-27B บน Hugging Face
- การ์ดโมเดลและสัญญาอนุญาต Qwen3.8-2.4T-A95B บน Hugging Face
- unsloth/Qwen3.8-27B-GGUF เวอร์ชันควอนไทซ์และจำนวนดาวน์โหลด
- Qwen3.8 ในคลังโมเดลของ Ollama
- การสนทนาบน Hacker News เรื่องการปล่อย Qwen3.8-27B (14 สิงหาคม 2026)
- หน้าโมเดล Qwen3.8 Max บน Artificial Analysis
- ประกาศน้ำหนักโมเดลเปิดของ Qwen (@Alibaba_Qwen) บน X (3 สิงหาคม 2026)
- คลังเก็บ llama.cpp สร้างเมื่อ 10 มีนาคม 2023
- หน้าภาพบน Wikimedia Commons
