การพุ่งทะยานสามสัปดาห์ของโมเดลเปิดน้ำหนักจากจีน: Kimi K3, Qwen3.8-Max และจุดพลิกที่อาจยุติทุกอย่าง
ภายในสามสัปดาห์ ห้องแล็บ AI รายใหญ่ที่สุดของจีนปล่อยหรือเปรยถึงโมเดลเปิดน้ำหนักระดับแนวหน้า — Kimi K3, Qwen3.8-Max และ DeepSeek V4 ที่พร้อมใช้งานทั่วไป คู่มือฉบับภาษาเข้าใจง่าย: แต่ละโมเดลคืออะไร อะไรออกมาจริงและอะไรยังเป็นแค่คำสัญญา และเหตุใดปักกิ่งอาจจำกัดคลื่นลูกที่ตนเองก่อขึ้น
ระหว่างวันที่ 16 ถึง 26 กรกฎาคม ห้องแล็บ AI รายใหญ่ที่สุดของจีนสามแห่งนำโมเดลเปิดระดับแนวหน้าออกมาวางบนโต๊ะ Moonshot AI ประกาศ Kimi K3 เมื่อวันที่ 16 กรกฎาคม และปล่อยน้ำหนักในวันที่ 26 กรกฎาคม Alibaba เปิดตัว Qwen3.8-Max เมื่อวันที่ 19 กรกฎาคมในงาน WAIC ที่เซี่ยงไฮ้ ส่วนสายผลิตภัณฑ์ V4 ของ DeepSeek ก้าวสู่การพร้อมใช้งานทั่วไป (GA) ราววันที่ 20 กรกฎาคม สามห้องแล็บ ราวสามสัปดาห์
รูปแบบนี้ยากจะมองข้าม และมันไม่ใช่รูปแบบที่วงการโมเดลเปิดของจีนใช้สร้างชื่อเสียงมา ห้องแล็บเหล่านี้เคยขึ้นชื่อเรื่องโมเดลที่เล็ก เร็ว ถูก แต่ต่อยเหนือรุ่นน้ำหนักของตัวเอง คลื่นลูกนี้คือการเดิมพันในทางตรงข้าม: ระบบระดับล้านล้านพารามิเตอร์ที่ปล่อยออกมาหรือรับปากว่าจะปล่อยในรูปแบบน้ำหนักเปิด
นี่คือบทวิเคราะห์อย่างตรงไปตรงมาต่อคลื่นลูกนั้น: อะไรออกมาจริง อะไรยังเป็นเพียงตัวอย่างหรือคำสัญญา และจุดพลิกที่มาพร้อมกัน — รัฐบาลชุดเดียวกันที่ทำให้การปล่อยเหล่านี้เป็นไปได้ กำลังชั่งใจว่าจะจำกัดมันหรือไม่ เราจะใช้ศัพท์เทคนิคให้น้อยที่สุดและอธิบายส่วนที่เหลือไปตามทาง เพื่อให้คุณตามเรื่องได้แม้ "น้ำหนักเปิด" และ "mixture-of-experts" จะเป็นของใหม่ หากคุณอ่านบทสรุปเดือนกรกฎาคมของเราแล้ว นี่คือภาคต่อ และปมที่ค้างไว้ปมหนึ่งได้คลี่คลายลงแล้ว
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
ก่อนอื่น ห้าแนวคิดที่ทำให้เรื่องนี้เข้าใจได้
หากคุณเพิ่งเข้ามาในมุมนี้ของ AI มีห้าคำที่แบกเรื่องราวไว้เกือบทั้งหมด และคุ้มค่าที่จะใช้เวลาสักนาทีอธิบายด้วยภาษาเข้าใจง่ายก่อนไปถึงตัวโมเดล
"น้ำหนักเปิด" (open weights) คือเหตุผลทั้งหมดที่คลื่นลูกนี้สำคัญ น้ำหนักของโมเดลคือกริดตัวเลขมหึมาที่มันเรียนรู้ระหว่างการฝึก — พูดง่าย ๆ คือสมองที่ปั้นเสร็จแล้ว เมื่อห้องแล็บปล่อยน้ำหนักออกมา คุณสามารถดาวน์โหลดไฟล์นั้น รันโมเดลบนฮาร์ดแวร์ของคุณเอง ปรับแต่ง และสร้างผลิตภัณฑ์บนมันได้โดยไม่ต้องขออนุญาตใครหรือจ่ายเป็นรายคำขอ อีกทางเลือกคือโมเดลปิด อย่างแชตบอตเชิงพาณิชย์ส่วนใหญ่ ที่น้ำหนักถูกล็อกไว้บนเซิร์ฟเวอร์ของผู้ให้บริการ และคุณเช่าสิทธิ์เข้าถึงผ่าน API แบบเสียเงิน น้ำหนักเปิดเปลี่ยนโมเดลจาก "บริการที่คุณเช่า" เป็น "สิ่งที่คุณมีสำเนาเป็นของตัวเอง" และความต่างนี้เองที่ทำให้ทั้งอุตสาหกรรมเงี่ยหูฟังเมื่อมีโมเดลดี ๆ ออกมา
"พารามิเตอร์" (parameters) คือตัวเลขที่เรียนรู้มาเหล่านั้น และจำนวนของมันคือตัวชี้วัดคร่าว ๆ ว่าโมเดลบรรจุอะไรได้มากแค่ไหน โมเดล "2.8 ล้านล้านพารามิเตอร์" ก็มีตัวเลขเหล่านั้น 2.8 ล้านล้านตัว ใหญ่กว่าไม่ได้แปลว่าดีกว่าโดยอัตโนมัติ แต่ที่แนวหน้ามันมักหมายถึงมีพื้นที่ให้ใช้เหตุผลมากขึ้น — และที่สำคัญไม่แพ้กัน คือต้องใช้ฮาร์ดแวร์มากขึ้นในการรัน ตรงนี้เองที่ "mixture-of-experts" (MoE) เข้ามา แทนที่จะจุดพารามิเตอร์ทั้งหมดสำหรับทุกคำ โมเดล MoE ถูกแบ่งเป็นเครือข่ายย่อยเฉพาะทางจำนวนมากที่เรียกว่าผู้เชี่ยวชาญ และตัวจัดเส้นทางจะเลือกมาเพียงหยิบมือสำหรับแต่ละโทเคน ดังนั้นเมื่อคุณเห็น "รวม 2.8 ล้านล้าน ทำงาน 104 พันล้าน" หมายความว่าโมเดลใหญ่มหึมา แต่ ณ ขณะหนึ่งมีเพียงราว 104 พันล้านพารามิเตอร์ที่ทำงานจริง — เหมือนโรงพยาบาลที่มีแพทย์เฉพาะทางหลายพันคน แต่ผู้ป่วยแต่ละรายพบเพียงไม่กี่คนที่เกี่ยวข้อง ตัวเลขรวมบอกใบ้ว่ามันเก่งได้แค่ไหน ตัวเลขที่ทำงานบอกว่าให้บริการมันแพงแค่ไหน ช่องว่างนี้คือตัวเลขเดี่ยว ๆ ที่มีประโยชน์ที่สุดในการตัดสินต้นทุน
"หน้าต่างบริบท" (context window) คือปริมาณข้อความที่โมเดลจำไว้ในหัวได้พร้อมกัน นับเป็นโทเคน — และหนึ่งโทเคนเท่ากับราวสามในสี่ของหนึ่งคำ หน้าต่างหนึ่งล้านโทเคนไม่ใช่สเปกนามธรรม: มันคือนวนิยายยาวหลายเล่ม หรือบันทึกการประชุมหนึ่งชั่วโมงหลายสิบไฟล์ ในครั้งเดียว นี่คือความต่างระหว่างการสรุปอีเมลฉบับเดียว กับการใช้เหตุผลกับอีเมลทั้งไตรมาส
สุดท้ายคือสัญญาอนุญาต — และนี่คือส่วนที่ผู้ปฏิบัติงานควรอ่านก่อน ก่อนดูเบนช์มาร์ก สัญญาอนุญาตคือตัวอักษรกฎหมายตัวเล็กที่บอกว่าคุณทำอะไรกับน้ำหนักได้บ้าง MIT คือมาตรฐานทองคำ: ใช้ ดัดแปลง ใส่ในผลิตภัณฑ์เชิงพาณิชย์ ไม่เป็นหนี้ใคร สัญญาอนุญาตแบบกำหนดเองอาจดูเปิด แต่กลับเจาะจงตัดการใช้งานที่คุณคิดไว้ทิ้งไป — เช่น เก็บเงินคุณเมื่อธุรกิจที่สร้างบนมันเติบโตขึ้น สองโมเดลอาจเป็น "น้ำหนักเปิด" เหมือนกัน แต่ต่างกันคนละโลกในสิ่งที่กฎหมายอนุญาตให้คุณทำ ดังนั้นการอ่านบรรทัดนี้ก่อนจะหลงรักคะแนนจึงคุ้มค่า มีห้าแนวคิดนี้อยู่ในมือ คลื่นลูกนี้ก็อ่านออกชัดเจน
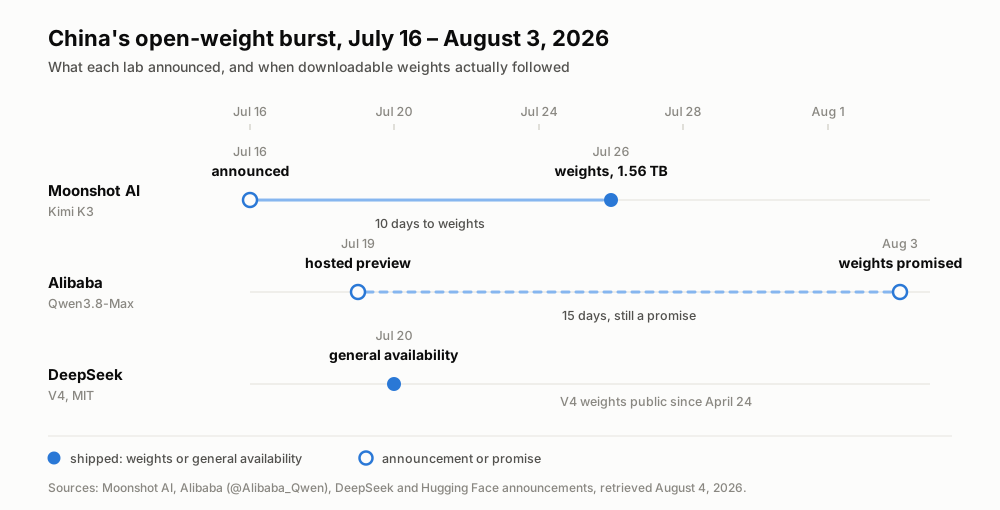
สามแล็บ สามสัปดาห์ — และในห้าจังหวะนี้ มีเพียงสองครั้งที่ส่งน้ำหนักถึงมือคนอื่นจริง ๆ วันที่อ้างจากประกาศของแต่ละแล็บ ตรวจสอบเมื่อ 4 สิงหาคม 2026
Kimi K3 คืออะไร และทำไมมันคือของที่ออกมาจริง
เริ่มที่ Moonshot AI ห้องแล็บในปักกิ่งเบื้องหลังผู้ช่วย Kimi ซึ่งใช้เวลาปีที่ผ่านมาสร้างชื่อจากโมเดลเปิดขนาดใหญ่ที่มีความสามารถ ตอนที่เราเขียนถึง Kimi K3 ในเดือนกรกฎาคม น้ำหนักยังเป็นเพียงคำสัญญา — Moonshot เคยบอกว่า "ภายในวันที่ 27 กรกฎาคม" มันมาถึงในวันที่ 26 กรกฎาคม: 1.56 เทราไบต์ แบ่งเป็น 96 ชาร์ดบน Hugging Face ภายใต้ moonshotai/Kimi-K3 นี่แหละคือข่าว การประกาศคือข่าวประชาสัมพันธ์ แต่น้ำหนักที่ดาวน์โหลดได้คือข้อเท็จจริงที่คุณสร้างต่อยอดได้
พูดแบบง่าย ๆ K3 เป็นหนึ่งในโมเดลเปิดที่ใหญ่ที่สุดเท่าที่เคยปล่อยออกมา — ระบบ mixture-of-experts ที่มี 2.8 ล้านล้านพารามิเตอร์รวม และราว 104 พันล้านที่ทำงานต่อโทเคน โดยกำหนดเส้นทางราว 16 จาก 896 ผู้เชี่ยวชาญผ่านกลไกที่ Moonshot เรียกว่า Kimi Delta Attention มีหน้าต่างบริบทหนึ่งล้านโทเคน และมีรายงานว่าประสิทธิภาพการสเกลเพิ่มขึ้นราว 2.5 เท่าเมื่อเทียบกับ K2 รุ่นก่อนหน้า ถอดออกจากภาษาสเปก: มันใหญ่มาก รันได้ค่อนข้างประหยัดเมื่อเทียบกับขนาดเพราะแต่ละโทเคนจุดขึ้นเพียงส่วนหนึ่ง และกลืนอินพุตยาวเท่าหนังสือทั้งเล่มได้ในทีเดียว
ตัวเลขเหล่านี้ยังบอกด้วยว่าใครจะรันมันจริง ๆ 1.56 เทราไบต์ใน 96 ชาร์ดไม่ใช่ของที่ดาวน์โหลดลงแล็ปท็อป มันคือสิ่งประดิษฐ์ระดับดาต้าเซ็นเตอร์ที่แค่จะโหลดขึ้นก็ต้องใช้คลัสเตอร์ตัวเร่งระดับสูง ในทางปฏิบัติแทบไม่มีบุคคลใดโฮสต์ K3 เอง — พวกเขาจะเข้าถึงมันผ่านผู้ให้บริการที่มีฮาร์ดแวร์อยู่แล้ว และตลาดนั้นมาถึงตั้งแต่วันแรก: ทั้ง Together AI และ Modal ตั้ง endpoint โฮสต์ Kimi K3 ในวินาทีที่น้ำหนักลงจอด นั่นก็เป็นวิธีที่ผู้อ่านช่างสงสัยลองมันในวันนี้เช่นกัน — ไม่ใช่การดาวน์โหลด 1.56 TB แต่เป็นการเรียก endpoint โฮสต์เหล่านั้นหรือใช้แอป Kimi "เปิด" ตรงนี้หมายความว่าน้ำหนักเป็นสาธารณะและใครก็ตามที่มีฮาร์ดแวร์ก็ให้บริการมันได้ ซึ่งนั่นแหละที่รักษาการแข่งขันด้านราคาไว้ ไม่ได้แปลว่าคุณจะรันมันบนโต๊ะทำงานเอง
มันดีไหม? ด้วยตัวเลขอิสระเพียงตัวเดียวที่เราไว้ใจในรอบนี้ ดี ในการจัดอันดับของ Artificial Analysis มันอยู่อันดับ 4 จาก 189 โมเดล — ตามหลัง Claude Fable 5 และคอนฟิก GPT-5.6 "Sol" สองแบบ แต่นำหน้า Opus 4.8 และ GPT-5.5 สำหรับโมเดลเปิดที่ดาวน์โหลดได้ การได้อยู่ในกลุ่มนั้นก็คือเรื่องราวในตัวมันเองแล้ว
จากนั้นอ่านสัญญาอนุญาต เพราะนี่คือจุดที่ "เปิด" ถูกกำกับดอกจัน Kimi K3 ไม่ใช่ MIT มันปล่อยภายใต้สัญญาอนุญาตของตัวเองที่ชื่อ "Kimi K3 License" ซึ่งไม่ได้รับการรับรองจาก OSI และมีข้อกำหนดเรื่องเกณฑ์รายได้: หากจะรัน K3 เป็นเครื่องยนต์ของธุรกิจ Model-as-a-Service ขนาดใหญ่ คุณต้องมีข้อตกลงแยกต่างหากกับ Moonshot สำหรับนักพัฒนาเดี่ยว หรือบริษัททั่วไปที่ใช้ภายใน นั่นไม่เปลี่ยนอะไร แต่สำหรับใครก็ตามที่สร้างผลิตภัณฑ์แบบโฮสต์ในระดับใหญ่ "น้ำหนักเปิด" กับ "สัญญาอนุญาตเปิด" คือสองคำถามที่ต่างกัน — และในที่นี้มีเพียงข้อแรกเท่านั้นที่เป็น "ใช่" อย่างชัดเจน
Qwen3.8-Max เป็นตัวอย่าง ไม่ใช่ของที่ดาวน์โหลดได้
Qwen คือตระกูลโมเดลของ Alibaba และทีมของมันเป็นหนึ่งในผู้ปล่อยโมเดลเปิดที่ผลิตงานมากที่สุดในโลก — และประวัตินี้เองที่ทำให้รุ่นใหม่ล่าสุดชวนสับสน เปิดตัวเมื่อวันที่ 19 กรกฎาคมในงาน WAIC ที่เซี่ยงไฮ้ Qwen3.8-Max คือพาดหัวที่ใหญ่ที่สุดของคลื่นลูกนี้ และนุ่มที่สุดด้วย มันคือ MoE แบบเบาบางขนาด 2.4 ล้านล้านพารามิเตอร์ — ไม่เปิดเผยจำนวนพารามิเตอร์ที่ทำงาน — และเป็น Qwen ตัวแรกที่เกินหนึ่งล้านล้านพารามิเตอร์ซึ่งเป็นมัลติโมดัล กล่าวคือรับอินพุตไม่เพียงข้อความ แต่ยังมีภาพ วิดีโอ และเอกสาร
นี่คือกับดักที่มือใหม่ต้องได้รับการชี้ให้ชัด: แม้จะครึกโครม คุณดาวน์โหลดมันไม่ได้ ตอนนี้มันมีอยู่แค่ในรูป "ตัวอย่างแบบโฮสต์" — qwen3.8-max-preview เข้าถึงได้ผ่านบริการของ Alibaba เอง (Token Plan และเครื่องมือ Qoder) ที่ราว 10% ของราคามาตรฐาน ตัวอย่างแบบโฮสต์หมายความว่า Alibaba รันโมเดลบนเซิร์ฟเวอร์ของตัวเองและให้คุณเรียกใช้ นี่คือโมเดลแบบเช่า API ไม่ใช่โมเดลแบบมีสำเนาเป็นของตัวเอง การเรียกมันว่าการเปิดตัวน้ำหนักเปิดในวันนี้จึงเร็วเกินไป
ภาพนี้เปลี่ยนไปเมื่อวันที่ 3 สิงหาคม บัญชี X อย่างเป็นทางการของ Qwen คือ @Alibaba_Qwen โพสต์ว่าน้ำหนักเปิดของ Qwen3.8-Max จะมา "สัปดาห์หน้า" — และ Qwen3.8-27B ที่เล็กกว่าก็จะเปิดน้ำหนักไปด้วย ดังนั้น 27B จึงไม่ใช่ข่าวลือ ไม่ว่าก่อนหน้านี้จะมีการพูดถึงอย่างไร นี่คือคำมั่นที่บันทึกไว้เป็นลายลักษณ์อักษรจากบัญชีของ Alibaba เอง และขนาดนี่แหละคือหัวใจ ในขณะที่ Max ขนาด 2.4 ล้านล้านพารามิเตอร์เหมือน K3 เป็นของที่มีแต่ดาต้าเซ็นเตอร์เท่านั้นที่รันได้ 27B เล็กพอจะให้บริการบนเครื่องระดับสูงเพียงเครื่องเดียว — ระดับที่บุคคลหรือทีมเล็ก ๆ โฮสต์เองได้จริง สิ่งนี้ช่วยลดทอนภาพ "สัญญาโดยไม่มีรายละเอียด" ลงจริง ๆ ตอนนี้มีทั้งขนาดและกรอบเวลาคร่าว ๆ แล้ว
อย่างไรก็ตาม ข้อแม้ที่ตรงไปตรงมายังคงอยู่ "สัปดาห์หน้า" เป็นทิศทาง ไม่ใช่วันจัดส่ง และ ณ ตอนที่เขียนบทความนี้ วันที่ 4 สิงหาคม ยังไม่มีอะไรปรากฏบนองค์กร Qwen ที่ Hugging Face — โมเดลล่าสุดที่นั่นยังเป็นของเดือนมิถุนายน สัญญาอนุญาตน้ำหนักเปิดก็ยังไม่เผยแพร่ และผู้ที่อ่านข้อกำหนดพรีวิวก่อนได้ชี้ถึงความเป็นไปได้ของข้อจำกัดตามภูมิภาค ซึ่งยังไม่ได้รับการยืนยันจนกว่าสัญญาอนุญาตจริงจะออกมา — ตรงกับบทเรียน "อ่านสัญญาอนุญาตก่อน" จากพื้นฐานข้างต้นพอดี คำกล่าวอ้างของ Alibaba ที่ว่าโมเดล "เป็นรองแค่ Fable 5" ก็ยังเป็นคำกล่าวอ้างของบริษัทเองที่ไม่มีตัวเลขจากบุคคลที่สาม จงถือว่ามันเป็นถ้อยคำการตลาดของผู้ขายจนกว่าจะมีใครนอก Alibaba วัดผล หากอยากลองโมเดลนี้วันนี้ ตัวอย่างแบบโฮสต์คือประตูเดียว — แต่เป็นครั้งแรกที่การรอน้ำหนักที่ดาวน์โหลดได้วัดกันด้วย "สัปดาห์หน้า" ไม่ใช่ "สักวันหนึ่ง"
DeepSeek V4 ก้าวสู่การพร้อมใช้งานทั่วไปอย่างเงียบ ๆ
DeepSeek คือห้องแล็บที่โมเดล R1 ของมันช่วยจุดชนวนการแข่งขันโมเดลเปิดในปัจจุบันเมื่อต้นปี 2025 และตามสไตล์ของมัน รอบนี้ประกาศน้อยที่สุดแต่ส่งมอบสิ่งที่ใช้งานได้มากที่สุด สาย V4 ซึ่งปล่อยตั้งแต่วันที่ 24 เมษายน เป็นสายที่นำไปใช้ได้ตรงไปตรงมาที่สุด เพราะมันมาพร้อมสัญญาอนุญาตที่พื้นฐานข้างต้นชี้ว่าเป็นมาตรฐานทองคำ
V4 มาสองขนาด ทั้งคู่ใช้สัญญาอนุญาต MIT V4-Pro คือรุ่นเรือธง 1.6 ล้านล้านรวมและ 49 พันล้านพารามิเตอร์ที่ทำงาน ส่วน V4-Flash คือรุ่นเบา 284 พันล้านรวมและ 13 พันล้านที่ทำงาน นึกถึงความหมายของตัวเลขที่ทำงาน: V4-Flash จุดขึ้นเพียง 13 พันล้านพารามิเตอร์ต่อโทเคน ทำให้ให้บริการได้ถูกและเร็ว และนั่นคือสิ่งที่ทำให้มันเป็นตัวเลือกประหยัดสำหรับงานปริมาณมาก — งานประเภทถอดเสียงและสรุปที่ต้นทุนต่อโทเคนเป็นตัวชี้ขาดทุกอย่าง ทั้งคู่มีหน้าต่างบริบทหนึ่งล้านโทเคนและผลิตเอาต์พุตได้สูงสุด 384K โทเคนในการตอบครั้งเดียว เพียงพอจะร่างรายงานยาว ไม่ใช่แค่ย่อหน้า ราววันที่ 20 กรกฎาคม V4 ก้าวสู่การพร้อมใช้งานทั่วไปด้วยการคิดราคาตามเวลา ซึ่งดึงการเปิดตัวในฤดูใบไม้ผลิเข้ามาอยู่ในกรอบสามสัปดาห์เดียวกับ K3 และ Qwen
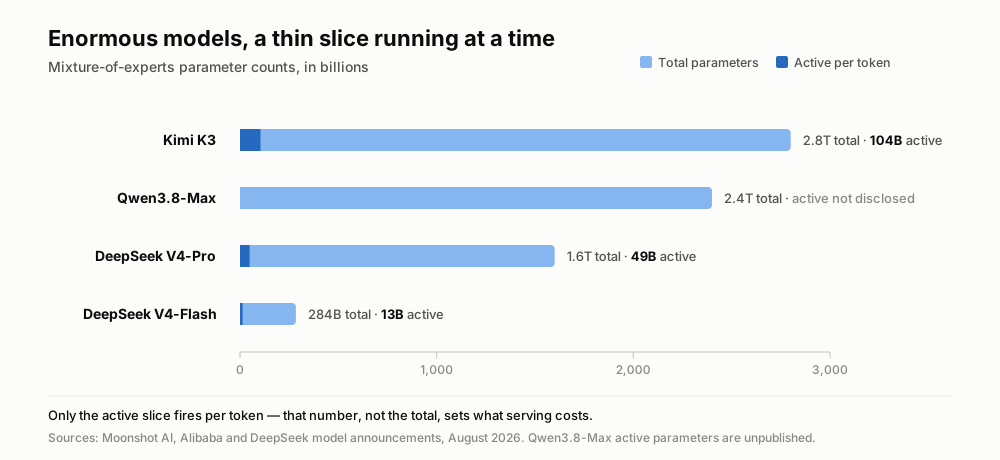
แท่งสีอ่อนคือขนาดของโมเดล ส่วนสีเข้มสั้น ๆ คือส่วนที่ทำงานจริงในแต่ละโทเคน อาลีบาบายังไม่เปิดเผยพารามิเตอร์ที่ทำงานของ Qwen3.8-Max
เพราะเป็น MIT V4 จึงเป็นตัวที่ผู้นำไปใช้สร้างต่อได้โดยแทบไม่ต้องพึ่งทนาย: เอาน้ำหนักมา (หรือใช้ผู้ให้บริการโฮสต์) รัน ปล่อยเชิงพาณิชย์ ไม่เป็นหนี้ใครและไม่ต้องขอใคร และเพื่อให้ชัดเรื่องหมายเลขเวอร์ชัน เพราะโรงสีข่าวลือชอบนัก — ไม่มี R2 ไม่มี V5 ไม่มี V4.1 มีเพียงตระกูล V4 ที่สุกงอมจนกลายเป็นสิ่งที่ทีมพึ่งพาได้
ช่องว่างแคบลงเร็วกว่าที่กระดานจัดอันดับยอมรับ
ถอยออกมามองภาพรวม ความชันสำคัญกว่าการปล่อยแต่ละครั้ง Nathan Lambert อ่านว่าระยะห่างระหว่างโมเดลเปิดที่ดีที่สุดกับโมเดลปิดที่ดีที่สุดได้บีบตัวจากราวหกถึงเก้าเดือนเหลือสามถึงห้าเดือน — "โมเดลเปิดไม่เคยใกล้แนวหน้าเท่านี้นับตั้งแต่ DeepSeek R1" พูดง่าย ๆ: โมเดลที่ดาวน์โหลดฟรีตอนนี้ตามหลังโมเดลที่ดีที่สุดที่เช่าได้ด้วยเงินเพียงไม่กี่เดือน ในขณะที่ปีก่อนยังตามหลังอยู่หนึ่งรอบสบาย ๆ
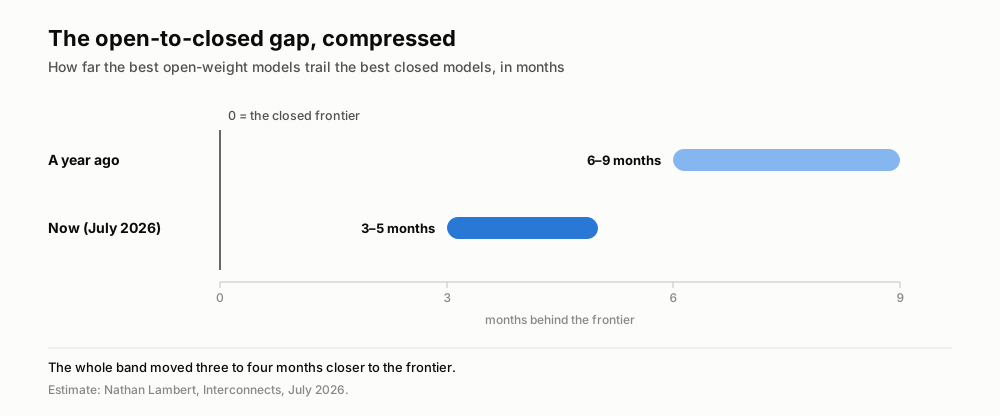
ประมาณการของ Lambert วาดตามสเกลจริง ฝั่งเปิดไม่ได้แค่ขยับเข้าใกล้ แต่ทั้งช่วงแคบลงด้วย
ข้อมูลการใช้งานก็ชี้ไปทางเดียวกัน บน OpenRouter ตลาดที่กระจายคำขอไปยังหลายโมเดล ส่วนแบ่งโทเคนของโมเดลสัญชาติอเมริกันร่วงจากราว 70% ในเดือนมิถุนายน 2025 เหลือราว 30% หนึ่งปีถัดมา ขณะที่โมเดลสัญชาติจีนตอนนี้ทะลุ 30% เป็นประจำ ราคาเป็นเหตุผลใหญ่: โมเดลเปิดของจีนมักถูกกว่า 60% ถึง 90% ต่อโทเคน และบริการโฮสต์ก็มาทันที ดังที่ endpoint ของ K3 ในวันแรกได้แสดงให้เห็นชัด
การเปลี่ยนแปลงที่เงียบกว่าคือเรื่องขนาด แบรนด์ของโมเดลเปิดจีนเคยคือ เล็ก เร็ว ถูก แต่ K3 ที่ 2.8 ล้านล้านพารามิเตอร์และ Qwen3.8-Max ที่ 2.4 ล้านล้าน กลับตรงกันข้ามพอดี — เป็นการเดิมพันว่าการไปตัวใหญ่ในโลกเปิดตอนนี้คุ้มค่าแล้ว GLM-5.2 ของ Z.ai ซึ่งปล่อยเมื่อวันที่ 16 มิถุนายนภายใต้ MIT และนำหน้าหมวดน้ำหนักเปิดของ Artificial Analysis Index ด้วยคะแนน 51 ก็เป็นสารเดียวกันจากห้องแล็บที่สี่
จุดพลิก: รัฐบาลที่ทำให้สิ่งนี้เกิดขึ้น อาจจำกัดมัน
จากนั้นลมก็เปลี่ยนทิศ ราววันที่ 22 ถึง 25 กรกฎาคม Financial Times และ Reuters รายงานว่ากระทรวงพาณิชย์ของจีนกำลังชั่งใจเรื่องการควบคุมการส่งออกโมเดล AI — รวมถึง LLM น้ำหนักเปิด — โดยมี Alibaba, ByteDance และ Z.ai อยู่ในวงหารือด้วย กรอบที่ถูกหยิบยกมาเป็นแบบหลายชั้น: หน้าที่แจ้งสำหรับโมเดลที่อ่อนกว่า การตรวจสอบด้านความมั่นคงสำหรับโมเดลที่แข็งกว่า และความเป็นไปได้ที่จะห้ามเผยแพร่ต่อสาธารณะสำหรับโมเดลที่ทรงพลังที่สุด ยังไม่มีอะไรเป็นกฎหมาย แต่ทิศทางนั้นน่าสังเกต: คลื่นลูกนี้อาจกำลังขึ้นถึงจุดสูงสุดในจังหวะเดียวกับที่รัฐบาลของตัวเองเริ่มมองโมเดลเหล่านี้เป็นสินค้าส่งออกเชิงยุทธศาสตร์ ไม่ใช่การมีส่วนร่วมแบบเปิด
บทสรุป: เมื่อสิ่งที่เปิดกลายเป็นสินทรัพย์เชิงยุทธศาสตร์
เรื่องเล่าที่เรียบร้อยคือ "จีนไล่ทัน" แต่เรื่องที่แม่นยำกว่าคือ น้ำหนักเปิดกลายเป็นสินทรัพย์เชิงยุทธศาสตร์เร็วพอจนรัฐบาลอยากวางมือไว้ที่ก๊อกน้ำ ในสามสัปดาห์ โมเดลเปิดขยับจากการตามหลังแนวหน้าสองถึงสามไตรมาสเหลือเพียงหนึ่ง — และจากเล็กและถูก กลายเป็นหนึ่งในโมเดลที่ใหญ่ที่สุดเท่าที่เคยเผยแพร่ในรูปแบบใด ๆ แนวหน้าแบบเปิดไม่ได้แค่ขยับ มันขยับไปยังที่ที่ผู้สร้างอาจไม่มีอิสระที่จะส่งออกต่อไป
สำหรับทีมที่สร้างต่อยอดบนโมเดลเหล่านี้ บทสรุปเชิงปฏิบัติยังคงเดิมและคมขึ้นเล็กน้อย Telli.sh รันโมเดลเปิดอย่าง Qwen3 ในชั้นสรุปอยู่แล้ว ดังนั้นทุกก้าวของคุณภาพและราคาโมเดลเปิดจึงไหลตรงเข้าสู่การถอดเสียง การแปล และการสรุปการประชุม รายการใหม่คือ "อุปทาน": หากกฎการส่งออกของจีนลงตัวตามที่ข่าวชี้ คำถามว่าโมเดลเปิดใดจะยังดาวน์โหลดได้อย่างอิสระคือสิ่งที่ต้องเฝ้าดู ไม่ใช่ตั้งสมมติเอาเอง การที่โมเดลป้อนชั้นนี้ดีขึ้นคือแนวโน้ม ส่วนโมเดลเหล่านั้นจะได้รับอนุญาตให้มาจากที่ไหน คือสิ่งที่ต้องคอยจับตา
แหล่งอ้างอิง
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
