Fail bersaiz 16.5 GB kini mengatasi model tertutup terbaik bulan Februari
Tiga tahun lalu, model terbaik yang boleh dimuat turun tewas 37 mata kepada GPT-4 pada HumanEval dan memerlukan dua kad grafik untuk berjalan. Minggu lepas sebuah model pemberat terbuka 27B mencatat 52.0 pada indeks kecerdasan Artificial Analysis, manakala Claude Opus 4.6 Max pada 44.9 — dengan satu persembilan harga, daripada fail 16.5 GB. Perbandingan sebelum dan selepas berserta jadual penanda aras, lengkung harga, dan maksud jeda mengejar yang menyusut kepada 162 hari.
Seseorang di Hacker News sedang menjalankan model bahasa kelas terdepan pada kad grafik bermemori 16 GB, pada kelajuan 50 hingga 60 token sesaat, dengan tetingkap konteks 128,000 token. Modelnya ialah Qwen3.8-27B, dikeluarkan pada 14 Ogos 2026. Pada indeks kecerdasan Artificial Analysis ia mencatat 52.0 — lebih tinggi daripada Claude Opus 4.6 Max, yang sehingga Februari masih merupakan model proprietari terbaik di pasaran, pada 44.9.
Pada tahun 2023, ayat itu ialah fiksyen sains. Dan bukan jenis yang menyeronokkan.
Tulisan ini ialah perbandingan sebelum dan selepas. Bukan laporan pelancarannya — itu sudah kami tulis — tetapi perbandingan merentas tiga tahun: berapa markah model terbaik yang boleh dimuat turun berbanding barisan hadapan dahulu dan kini, berapa kosnya untuk membeli satu tahap kecerdasan dahulu dan kini, serta perkakasan apa yang perlu dimiliki untuk menjalankannya sendiri. Setiap angka di bawah mempunyai sumber dan tarikh. Aliran yang digambarkannya tergolong antara perkara paling jujur-jujur optimistik yang sedang berlaku dalam dunia perisian.
Ringkasan:
- Jurangnya sudah tertutup, dan kami boleh menyatakan tarikhnya. Julai 2023 model terbuka terbaik tewas 17.5 mata pada MMLU dan 37.1 mata pada HumanEval kepada GPT-4. Ogos 2026, sebuah 27B terbuka menewaskan kapal utama proprietari bulan Februari dalam 15 daripada 19 penanda aras yang diterbitkan kedua-dua pihak, dan juga pada satu indeks komposit bebas.
- Harga jatuh kira-kira 208 kali ganda dalam 23 bulan, menurut ukuran Epoch AI pada ambang keupayaan tetap. Model 27B terbuka kini berharga 1.09 dolar bagi setiap juta token dalam tarif campuran, berbanding 10.00 dolar Opus 4.6 Max — dan sifar setiap token jika anda menjalankannya sendiri.
- Ia bukan barisan hadapan, dan kami menyatakannya. Claude Opus 5 Max mencatat 63.1 dan GPT-5.6 Sol Max 60.9. Dalam penaakulan berasaskan pengetahuan luas, 27B tewas agak jauh kepada Opus 4.6: 30.8 berbanding 40.0 pada HLE.
Gambar: Steve Jurvetson, Wikimedia Commons, CC BY 2.0. Bahagian sambungan sebuah Cray Y-MP, sekitar 1988. Pengkomputeran serius dahulu berupa sebuah bilik yang perlu dimasuki.
Rupa sebenar «sebelum ini»
Putar jam kembali ke 18 Julai 2023, hari Meta menerbitkan Llama 2. Ia model terbaik yang boleh dimuat turun secara bebas di dunia, dan kertas kerjanya sendiri mencetak papan markah berbanding barisan hadapan tertutup tanpa berselindung.
Llama 2 70B mencatat 68.9 pada MMLU berbanding 86.4 milik GPT-4. Pada GSM8K, 56.8 berbanding 92.0. Pada HumanEval, penanda aras pengaturcaraan, 29.9 berbanding 67.0 — kurang daripada separuh. Rumusan kertas kerja itu sendiri berbunyi: «Masih wujud jurang prestasi yang besar antara Llama 2 70B dengan GPT-4 dan PaLM-2-L.» Itulah kapal utama pemberat terbuka pada 2023, dengan kata-katanya sendiri.
Sekarang perkakasannya. Binaan komuniti 4 bit oleh TheBloke — cara orang benar-benar menjalankan Llama 2 70B — ialah fail bersaiz 41.4 GB yang diterbitkan pada 4 September 2023. Untuk kelajuan yang munasabah, anda memerlukan dua kad grafik 24 GB atau sebuah Mac 64 GB. Model yang benar-benar muat pada komputer riba biasa ialah Llama 2 13B: fail 7.9 GB dengan markah MMLU 54.8, ketinggalan 31.6 mata daripada GPT-4, dan hampir tiada gunanya selain demonstrasi.
Jadi tawaran tahun 2023 begini: bayar makmal barisan hadapan, atau jalankan sesuatu yang jelas lebih lemah pada perkakasan yang kebanyakan orang tidak miliki. Itulah sebabnya hujah «guna sahaja API» menang dengan begitu meyakinkan selama dua tahun. Hujah itu betul.
Kini ajukan soalan yang sama untuk Ogos 2026
Alibaba menerbitkan Qwen3.8-27B pada 14 Ogos 2026 di bawah Apache 2.0, lengkap dengan jadual perbandingan terus dengan Claude Opus 4.6 Max pada kad modelnya. Kami mengira setiap baris yang mempunyai angka bagi kedua-dua model.
Qwen3.8-27B menang dalam 15 daripada 19 baris itu dan kalah 4. Kemenangannya termasuk SWE-bench Pro (61.7 berbanding 53.4), kepatuhan arahan pada IFBench (79.5 berbanding 62.5), pengaturcaraan pertandingan pada LiveCodeBench v6 (90.3 berbanding 88.8), kawalan komputer pada OSWorld-Verified (84.3 berbanding 72.7), tugas ejen mudah alih pada AndroidWorld (81.9 berbanding 62.0), serta rentetan panjang penanda aras multimodal yang jurangnya langsung tidak rapat: 90.0 berbanding 65.5 pada MathVision, 83.7 berbanding 66.0 pada analisis carta dalam CharXiv, 65.5 berbanding 40.8 pada penaakulan terjelma dalam ERQA.
Empat kekalahan itu lebih penting daripada kemenangannya, kerana ia memberitahu apa yang model 27 bilion parameter masih tidak mampu lakukan. Ia kalah pada Terminal Bench 2.1 (73.0 berbanding 78.2), pada penjanaan kod berskala repositori dalam NL2Repo-Bench (42.3 berbanding 47.6), tipis pada GPQA Diamond (89.2 berbanding 91.3), dan teruk pada HLE, penanda aras penaakulan merentas disiplin yang luas: 30.8 berbanding 40.0. Angka terakhir itulah bentuk keseluruhan batasannya. Anda tidak boleh memampatkan pengetahuan dunia ke dalam fail 16.5 GB; tetapi anda boleh memampatkan kemahiran dalam jumlah yang amat besar.
Satu baris perlu diberi tanda bintang: keputusan 79.0 berbanding 63.8 datang daripada QwenSWEBench, penanda aras yang dibina oleh Qwen sendiri. Vendor yang menguji dirinya pada penanda aras buatannya sendiri ialah bukti paling lemah dalam mana-mana kad model, dan kami tidak bergantung padanya.
Papan markah bebas menyatakan perkara yang sama
Jadual vendor tetap jadual vendor, jadi mari lihat pihak ketiga. Artificial Analysis, yang menjalankan penilaiannya sendiri dan bukan mencetak semula angka orang lain, kini telah mengukur 27B tersebut. Sehingga 21 Ogos 2026 mereka memberi Qwen3.8-27B indeks kecerdasan 52.0, tempat pertama daripada 135 model dalam kelas pemberat terbuka 4 hingga 40 bilion parameter, berbanding 44.9 milik Claude Opus 4.6 Max. Itu jurang 7.1 mata memihak kepada model terbuka, diukur oleh pihak yang tiada kepentingan dalam keputusan itu, 190 hari selepas Opus 4.6 dilancarkan.
Jejak perbandingan itu ke belakang dan di situlah ceritanya. Julai 2023, model terbuka terbaik di bawah 40 bilion parameter mencatat 2.6 pada indeks yang sama. Julai 2024, 7.4. Mac 2025, 13.4. Februari 2026, 34.6. Minggu lepas, 52.0.
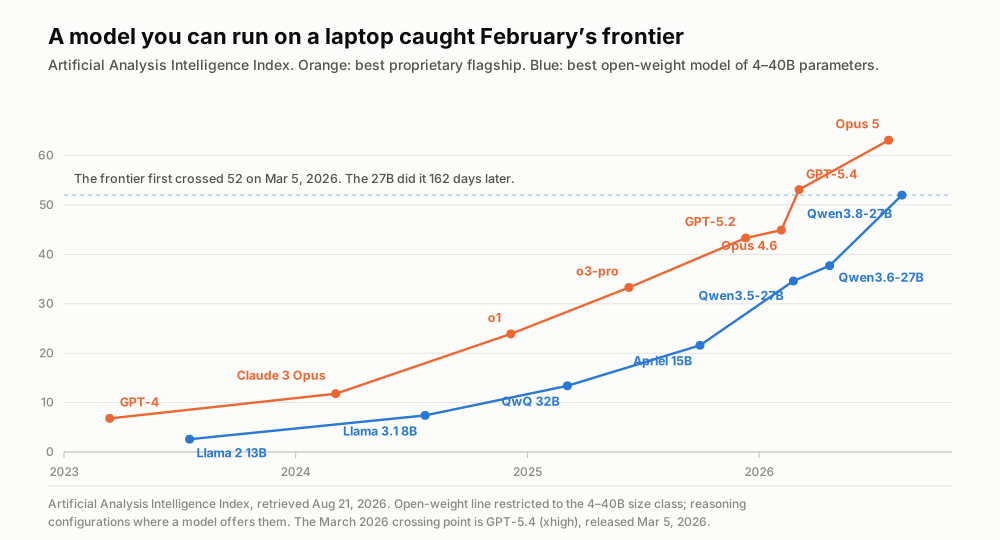
Kedua-dua garis menaik; kuantiti yang menarik ialah jarak mendatar antara keduanya. Indeks kecerdasan Artificial Analysis, dicapai pada 21 Ogos 2026.
Inilah angka yang wajar diberi nama. Barisan hadapan mula-mula melepasi indeks 52 pada 5 Mac 2026, apabila GPT-5.4 pada tahap usaha penaakulan tertinggi mencatat 53.1. Sebuah model yang cukup kecil untuk berjalan pada mesin peribadi sampai ke situ pada 14 Ogos — 162 hari kemudian. Panggil ia jeda mengejar: tempoh antara munculnya sesuatu keupayaan di barisan hadapan dengan kemunculannya pada perkakasan anda sendiri.
Jeda itu dahulu jauh lebih panjang. Llama 3.1 8B mengambil 260 hari untuk mencapai tahap yang telah disentuh GPT-4 Turbo. GLM-4.7-Flash mengambil 410 hari untuk menyamai o1. Tiga pelancaran bersaiz komputer riba terkini mencatat 201, 155 dan 162 hari. Barisan hadapan tidak perlahan — Opus 5 Max hari ini pada 63.1 — tetapi pinggir yang mengejar merapat kira-kira dua kali lebih pantas berbanding dua tahun lalu.
Harga bukan turun, tetapi runtuh
Keupayaan hanyalah separuh daripada perbandingan ini. Separuh lagi ialah bil.
Epoch AI menerbitkan ukuran paling bersih mengenainya pada Mac 2025, dan kaedahnya berbaloi difahami: kunci satu markah penanda aras, kemudian jejaki dari semasa ke semasa model termurah yang mencapainya. Kunci ambangnya pada markah MMLU 86 milik GPT-4 dan tangganya berbunyi 37.50 dolar bagi setiap juta token pada Mac 2023, 15.00 pada November 2023, 7.50 pada Mei 2024, 2.19 pada bulan yang sama, dan 0.18 pada Februari 2025. Markahnya kekal sama. 208 kali lebih murah dalam 23 bulan.
Penemuan utama Epoch ialah kadarnya berbeza dengan amat ketara mengikut tugas — antara 9 hingga 900 kali setahun bergantung pada keupayaan yang dikunci — dengan harga prestasi setaraf GPT-4 pada soalan sains peringkat kedoktoran jatuh kira-kira 40 kali setahun. Arahnya pula tidak pernah berubah.
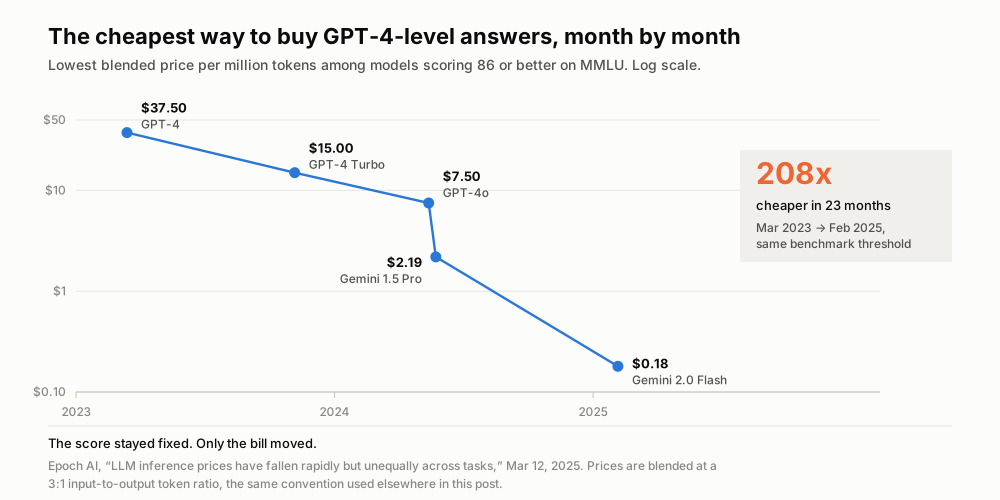
Markah penanda aras adalah malar pada setiap titik garis ini. Epoch AI, 12 Mac 2025.
Panjangkan siri itu ke harga hari ini dan geraknya berterusan. Pada katalog OpenRouter setakat 21 Ogos 2026, Qwen3.8-27B berharga 0.45 dolar bagi setiap juta token input dan 3.20 bagi setiap juta token output; Claude Opus 4.6 berharga 5.00 dan 25.00. Dicampur mengikut nisbah 3 berbanding 1 yang digunakan Epoch, hasilnya 1.09 berbanding 10.00 dolar — model terbuka itu 9.1 kali lebih murah dan 7.1 mata indeks lebih baik daripada kapal utama tertutup enam bulan lalu.
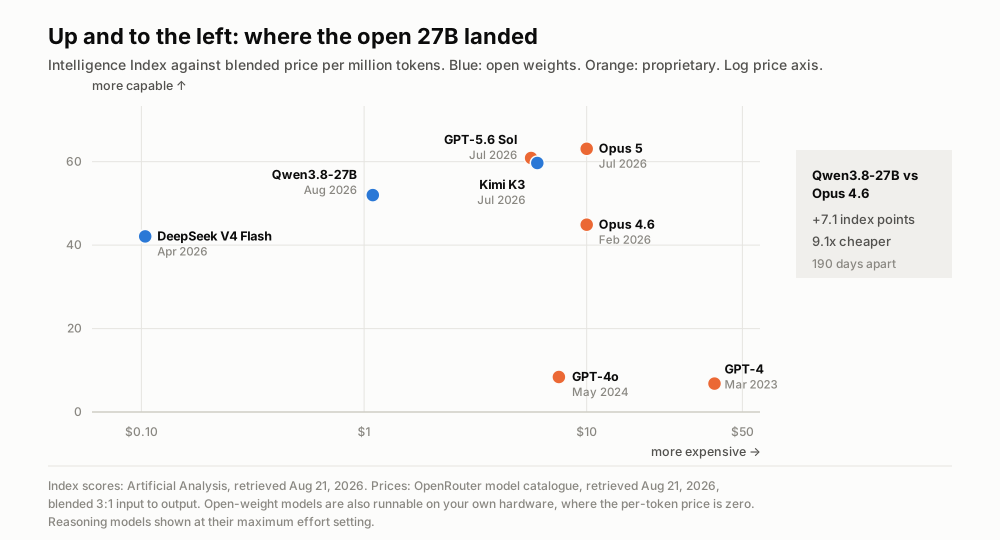
Setiap model yang bermakna sedang beralih ke penjuru kiri atas. Markah daripada Artificial Analysis, harga daripada OpenRouter, kedua-duanya dicapai pada 21 Ogos 2026.
Kemudian ada pilihan yang langsung tiada harga setiap token. Jalankan 27B pada RTX 4090 anda sendiri pada kira-kira 48 token sesaat seperti yang dilaporkan pengguna dalam bebenang pelancaran, andaikan kuasa terkadar kad itu 450 watt, dan pada harga purata elektrik kediaman Amerika Syarikat sebanyak 18.44 sen bagi setiap kilowatt jam (EIA, Mei 2026), kos elektriknya sekitar 0.48 dolar bagi setiap juta token output — sebelum mengira kad itu sendiri, dan selepas berhenti mengira margin sesiapa pun. Ini anggaran terkira dengan semua andaiannya terbuka, bukan dakwaan vendor.
Sebelum dan selepas, baris demi baris
| Julai 2023 | Ogos 2026 | |
|---|---|---|
| Model terbaik yang boleh dimuat turun | Llama 2 70B (Meta, 18 Julai 2023) | Qwen3.8-27B (Alibaba, 14 Ogos 2026) |
| Parameter | 70 bilion | 27 bilion |
| Binaan komuniti 4 bit standard | 41.4 GB | 16.5 GB |
| Binaan terkecil yang masih berguna | 7.9 GB (13B, MMLU 54.8) | 9.8 GB (2 bit, konteks 128K pada kad 16 GB) |
| Perkakasan realistik | dua GPU 24 GB atau Mac 64 GB | satu GPU pengguna 16 GB |
| Model barisan hadapan ketika itu | GPT-4 (14 Mac 2023) | Claude Opus 4.6 Max (5 Februari 2026) |
| Keputusan menentangnya | −17.5 MMLU, −35.2 GSM8K, −37.1 HumanEval | menang 15 daripada 19 penanda aras diterbitkan, +7.1 mata indeks |
| Harga campuran model barisan hadapan itu | 37.50 $ bagi setiap juta token | 10.00 $ bagi setiap juta token |
| Harga campuran model terbuka | tiada tawaran berskala besar | 1.09 $ bagi setiap juta token |
| Lesen | Llama 2 Community License | Apache 2.0 |
Sumber bagi setiap sel ada di bahagian akhir. Baris yang sentiasa kami tinjau semula ialah baris kedua dari bawah: harga barisan hadapan itu sendiri jatuh 3.75 kali dalam tiga tahun, manakala alternatif terbuka muncul di bawahnya pada kira-kira satu persepuluh angka itu. Kedua-duanya benar-benar berlaku. Yang mengubah siapa yang boleh membina ialah yang kedua.
Apa yang masih tidak benar
Keghairahan sekitar pelancaran ini mendahului bukti pada empat titik tertentu. Mari kita tandakan.
Ia bukan barisan hadapan. Pada indeks yang sama, Claude Opus 5 Max mencatat 63.1 dan GPT-5.6 Sol Max 60.9, kedua-duanya jauh mengatasi 52.0. Jika kerja anda bergantung pada penaakulan tersukar yang ada, barisan hadapan tetap produk yang berbeza, dan tetap tertutup.
Berbanding saiznya, ia tidak murah. Rumusan Artificial Analysis sendiri menyifatkan Qwen3.8-27B sebagai «amat mahal jika dibandingkan dengan model pemberat terbuka lain bersaiz serupa»: median dalam kelasnya ialah 0.05 dolar bagi setiap juta token input, manakala Qwen 0.43. Anda membayar untuk keupayaan, bukan untuk bilangan parameter.
Ia meleret, dan meleret itu bil. Semasa menjalankan penilaian indeks kecerdasan, 27B ini menghasilkan 160 juta token output berbanding median 45 juta. Seorang pengguna memberinya gesaan dua patah perkataan pada Mac mini 64 GB lalu memerhatikannya berfikir selama 17 minit 12 saat. Model penaakulan mengenakan bayaran mengikut masa jam dinding, walaupun tokennya percuma.
Dan markah penanda aras itu milik model pada ketepatan penuh. Binaan 2 bit bersaiz 9.8 GB yang muat pada kad grafik anda bukan model yang mencatat 52.0. Pengkuantuman berat mengorbankan ketepatan, terutamanya pada konteks panjang. Setiap dakwaan «boleh berjalan pada komputer riba», termasuk dakwaan kami, membawa tanda bintang itu.
Mengapa jeda itu sepatutnya terus mengecil
Bermula di sini ialah pandangan kami, dan kami menandakan peralihannya dengan jelas: semua di atas ialah ukuran, yang berikutnya ialah kesimpulan daripadanya.
Mekanisme yang menekan jeda mengejar tidak misteri. Teknik pascalatihan yang diterbitkan di barisan hadapan dihasilkan semula di makmal terbuka dalam beberapa bulan. Kawalan tahap usaha penaakulan, lapan belas bulan lalu masih helah proprietari, kini hadir sebagai parameter berdokumentasi pada kad model ini. Pengkuantuman komuniti selesai sebelum dokumentasi makmal asalnya berhenti berubah. Tiada satu pun daripada tiga gelung maklum balas itu mempunyai sebab untuk perlahan, dan dua daripadanya menjadi lebih pantas apabila lebih ramai menyertainya.
Maka jangkaan munasabah bagi generasi seterusnya bukanlah model terbuka memintas barisan hadapan. Sebaliknya, jeda 162 hari itu terus memampat sementara keupayaan mutlak di kedua-dua hujung terus meningkat. Dengan itu, ambang yang menarik bukan lagi «bolehkah model terbuka menang», tetapi «sebaru mana barisan hadapan perlu supaya perbezaannya berhenti bermakna bagi tugas saya». Bagi transkripsi mesyuarat, terjemahan, peringkasan dan kebanyakan kerja dokumen, ambang itu sudah lama dilepasi. Bagi penyelidikan terdepan dan kejuruteraan ejen yang paling sukar, belum.
Ini dunia yang jauh lebih baik daripada dunia 2023, dan itu wajar dinyatakan secara terus terang. Kos untuk memberi komputer pemahaman bahasa yang cekap telah jatuh dua darjah magnitud dalam tiga tahun dan masih terus jatuh. Yang paling beroleh manfaat ialah mereka yang dahulu tersingkir oleh harga: pembangun bersendirian, pasukan di negara yang 10 dolar bagi setiap juta token bukan ralat pembundaran, penyelidik yang punya geran dan bukan bajet, serta sesiapa yang datanya perlu kekal pada mesin sendiri atas sebab undang-undang.
Kesimpulannya: barisan hadapan berhenti menjadi tempat dan menjadi tarikh
Soalan lamanya ialah makmal mana yang anda boleh capai. Soalan barunya ialah berapa bulan anda sanggup ketinggalan di belakang barisan hadapan, memandangkan kosnya satu persembilan dan ia berjalan pada perkakasan milik anda sendiri.
Bagi semakin banyak jenis kerja, jawapan jujurnya: kira-kira lima bulan, dan terus mengecil.
Di mana Telli.sh berdiri: semua di atas ialah sebab kami membina di atas model terbuka dan bukan mengelilingi satu vendor tunggal. Telli.sh sudah menggunakan model Qwen terbuka dalam laluan peringkasannya, jadi setiap langkah menurun pada lengkung ini sampai kepada anda sebagai minit mesyuarat yang lebih baik, bukan sebagai pengumuman kenaikan harga. Kerja kami terletak pada bahagian yang tiada muat turun mampu berikan: merakam audio sejam tanpa terputus, membezakan penutur, menterjemah secara langsung dalam 15 bahasa, dan menukar semuanya menjadi nota yang masih boleh dicari berbulan-bulan kemudian.
Mulakan nota AI secara langsung
Sumber
- Kad model dan jadual penanda aras Qwen3.8-27B, Hugging Face — angka perbandingan terus dengan Opus 4.6 Max, dicapai 21 Ogos 2026
- Artificial Analysis: analisis kecerdasan, prestasi dan harga Qwen3.8 27B — indeks kecerdasan 52.0, harga dan tahap keleretan, dicapai 21 Ogos 2026
- Artificial Analysis: halaman model Claude Opus 4.6 — indeks kecerdasan 44.9 pada usaha penaakulan maksimum, dicapai 21 Ogos 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 Mac 2025 — tangga harga pada ambang tetap dan julat 9 hingga 900 kali setahun
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 Julai 2023 — jadual 4, Llama 2 70B menentang GPT-4
- Senarai fail TheBloke/Llama-2-70B-Chat-GGUF — binaan Q4_K_M 41.4 GB, diterbitkan 4 September 2023
- Senarai fail unsloth/Qwen3.8-27B-GGUF — binaan 16.5 GB dan 9.8 GB, jumlah muat turun dicapai 21 Ogos 2026
- Katalog model OpenRouter — harga setiap token bagi Qwen3.8-27B, Claude Opus 4.6 dan Claude Opus 5, dicapai 21 Ogos 2026
- Perbincangan Hacker News mengenai pelancaran Qwen3.8-27B, 14 Ogos 2026 — laporan pemprosesan pengguna pada kad 16 dan 24 GB
- US Energy Information Administration, Electric Power Monthly, jadual 5.3 — 18.44 sen bagi setiap kilowatt jam purata kediaman, Mei 2026
- Liputan kami sebelum ini mengenai pelancaran pemberat terbuka Qwen3.8 dan mengenai gelombang pemberat terbuka yang lebih luas
- Halaman Wikimedia Commons bagi foto Cray Y-MP
