Pecutan tiga minggu berat terbuka China: Kimi K3, Qwen3.8-Max, dan kelokan yang mungkin menamatkannya
Dalam tiga minggu, makmal AI terbesar China melancarkan atau membayangkan model berat terbuka bertaraf frontier — Kimi K3, Qwen3.8-Max, dan DeepSeek V4 yang sudah tersedia umum. Panduan bahasa mudah: apa itu setiap model, apa yang benar-benar keluar dan apa yang masih janji, dan mengapa Beijing kini mungkin mengekang gelombang yang dicetuskannya sendiri.
Antara 16 dan 26 Julai, tiga daripada makmal AI terbesar China meletakkan model terbuka bertaraf frontier di atas meja. Moonshot AI mengumumkan Kimi K3 pada 16 Julai dan melancarkan beratnya pada 26 Julai. Alibaba memperkenalkan Qwen3.8-Max pada 19 Julai di WAIC Shanghai. Barisan V4 DeepSeek mencapai ketersediaan umum (GA) sekitar 20 Julai. Tiga makmal, lebih kurang tiga minggu.
Coraknya sukar dilepaskan pandang, dan ia bukan corak yang membina reputasi dunia model terbuka China selama ini. Makmal-makmal ini terkenal dengan model yang kecil, pantas dan murah, tetapi menumbuk melebihi kelasnya. Gelombang ini ialah pertaruhan sebaliknya: sistem bertriliun parameter yang dilancarkan, atau dijanjikan, sebagai berat terbuka.
Ini ialah bacaan jujur terhadap gelombang itu: apa yang benar-benar keluar, apa yang masih pratonton atau janji, dan kelokan yang datang bersamanya — kerajaan yang sama yang memungkinkan pelancaran ini kini menimbang sama ada perlu mengekangnya. Kami akan mengehadkan jargon seminimum mungkin dan menjelaskan selebihnya sepanjang jalan, supaya anda boleh mengikuti kisah ini walaupun "berat terbuka" dan "mixture-of-experts" masih baharu. Jika anda membaca rumusan Julai kami, inilah sekuelnya, dan salah satu benang yang tergantung kini terungkai.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Mula-mula, lima idea yang membuat semua ini masuk akal
Jika anda baharu di sudut AI ini, lima istilah memikul sebahagian besar kisahnya, dan berbaloi diberi seminit dalam bahasa mudah sebelum kita sampai ke model.
"Berat terbuka" (open weights) ialah keseluruhan sebab gelombang ini penting. Berat sesebuah model ialah grid nombor gergasi yang dipelajarinya semasa latihan — pada dasarnya otak yang sudah siap. Apabila sebuah makmal melepaskan berat, anda boleh memuat turun fail itu, menjalankan model pada perkakasan anda sendiri, mengubahnya, dan membina produk di atasnya tanpa meminta izin sesiapa atau membayar setiap permintaan. Alternatifnya ialah model tertutup, seperti kebanyakan chatbot komersial, di mana berat terkunci pada pelayan vendor dan anda menyewa akses melalui API berbayar. Berat terbuka menukar model daripada perkhidmatan yang anda sewa kepada sesuatu yang salinannya anda miliki, dan perbezaan itulah yang membuatkan satu industri penuh menajamkan telinga apabila sebuah model yang baik muncul.
"Parameter" ialah nombor-nombor yang dipelajari itu, dan bilangannya ialah petunjuk kasar berapa banyak yang boleh ditampung sesebuah model. Model "2.8 trilion parameter" mempunyai 2.8 trilion nombor itu. Lebih besar tidak secara automatik lebih baik, tetapi di frontier ia biasanya bermakna lebih banyak ruang untuk menaakul — dan, sama pentingnya, lebih banyak perkakasan untuk menjalankannya. Di sinilah "mixture-of-experts" (MoE) masuk. Daripada menyalakan setiap parameter untuk setiap perkataan, model MoE dibahagikan kepada banyak sub-rangkaian khusus yang dipanggil pakar, dan sebuah penghala hanya memilih segelintir untuk setiap token. Jadi apabila anda melihat "jumlah 2.8 trilion, aktif 104 bilion", ia bermaksud modelnya gergasi tetapi pada satu ketika hanya kira-kira 104 bilion parameter yang bekerja — seperti sebuah hospital dengan beribu pakar di mana setiap pesakit hanya dilihat oleh beberapa yang berkaitan. Jumlah keseluruhan membayangkan sejauh mana ia berupaya; bilangan aktif memberitahu berapa mahal untuk menyajikannya. Jurang itu ialah satu nombor paling berguna untuk menilai kos.
"Tetingkap konteks" (context window) ialah berapa banyak teks yang boleh disimpan model dalam fikiran serentak, dikira dalam token — dan satu token bersamaan lebih kurang tiga perempat perkataan. Tetingkap sejuta token bukan spesifikasi abstrak: ia beberapa novel panjang, atau berpuluh transkrip mesyuarat sejam, dalam satu laluan. Itulah beza antara meringkaskan satu e-mel dan menaakul ke atas satu suku tahun penuh e-mel.
Akhir sekali, lesen — dan inilah bahagian yang patut dibaca dahulu oleh pengamal, sebelum penanda aras. Lesen ialah cetakan halus undang-undang yang menyatakan apa yang boleh anda lakukan dengan berat. MIT ialah piawai emas: guna, ubah suai, masukkan ke dalam produk komersial, tak berhutang apa-apa. Lesen tersendiri boleh kelihatan terbuka sambil mengecualikan tepat-tepat kegunaan yang anda niatkan — contohnya mengenakan bayaran kepada anda sebaik perniagaan yang anda bina di atasnya membesar. Dua model boleh sama-sama "berat terbuka" tetapi berbeza seperti langit dan bumi dalam hal yang dibenarkan dari segi undang-undang. Maka berbaloi membaca baris ini sebelum anda jatuh cinta pada sesuatu skor. Dengan lima idea ini di tangan, gelombangnya terbaca jelas.
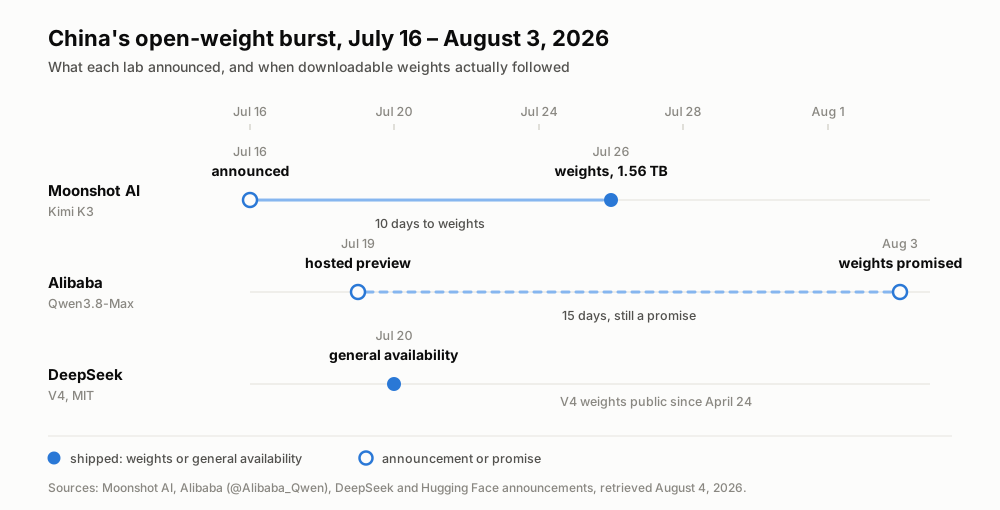
Tiga makmal, tiga minggu — dan daripada lima detik ini hanya dua yang benar-benar menyerahkan berat ke tangan orang lain. Tarikh daripada pengumuman setiap makmal, disemak 4 Ogos 2026.
Kimi K3 ialah yang benar-benar keluar
Mulakan dengan Moonshot AI, makmal di Beijing di sebalik pembantu Kimi, yang menghabiskan setahun lalu membina reputasi dengan model terbuka yang besar dan berkebolehan. Ketika kami menulis tentang Kimi K3 pada Julai, beratnya masih sekadar janji — Moonshot pernah berkata "menjelang 27 Julai". Ia tiba pada 26 Julai: 1.56 terabait dalam 96 serpihan di Hugging Face, di bawah moonshotai/Kimi-K3. Itulah beritanya. Pengumuman ialah siaran akhbar; berat yang boleh dimuat turun ialah fakta yang boleh anda bina di atasnya.
Secara mudah, K3 ialah salah satu model terbuka terbesar yang pernah dilancarkan — sistem mixture-of-experts dengan 2.8 trilion parameter keseluruhan dan kira-kira 104 bilion aktif setiap token, menghalakan lebih kurang 16 daripada 896 pakar melalui mekanisme yang Moonshot namakan Kimi Delta Attention, dengan tetingkap konteks satu juta token dan peningkatan kecekapan penskalaan yang dilaporkan sekitar 2.5x berbanding pendahulunya, K2. Ditanggalkan daripada bahasa spesifikasi: ia sangat besar, agak jimat dijalankan untuk saiznya kerana hanya sekeping menyala setiap token, dan mampu menelan bulat-bulat input sepanjang buku.
Angka-angka itu juga memberitahu siapa yang benar-benar akan menjalankannya. 1.56 terabait dalam 96 serpihan bukan muat turun komputer riba; ia artifak kelas pusat data yang sekadar untuk dimuatkan sahaja memerlukan sekelompok pemecut kelas atas. Dalam praktik, hampir tiada individu yang akan menghos K3 sendiri — mereka akan mencapainya melalui pembekal yang sudah memiliki perkakasan, dan pasaran itu tiba pada hari pertama: Together AI dan Modal sama-sama menghidupkan endpoint Kimi K3 terhos pada saat berat itu mendarat. Begitu jugalah cara pembaca yang ingin tahu mencubanya hari ini — bukan dengan memuat turun 1.56 TB, tetapi dengan memanggil salah satu endpoint terhos itu atau menggunakan aplikasi Kimi. "Terbuka" di sini bermakna berat itu awam dan sesiapa yang mempunyai perkakasan boleh menyajikannya, yang justru mengekalkan persaingan harga; ia tidak bermaksud anda akan menjalankannya sendiri di meja anda.
Adakah ia bagus? Menurut satu-satunya angka bebas yang kami percayai pusingan ini, ya. Dalam kedudukan Artificial Analysis, ia menduduki tempat ke-4 daripada 189 model — di belakang Claude Fable 5 dan dua konfigurasi GPT-5.6 "Sol", di hadapan Opus 4.8 dan GPT-5.5. Bagi model terbuka yang boleh anda muat turun, sekadar berada dalam kalangan itu pun sudah menjadi kisahnya.
Kemudian baca lesennya, kerana di sinilah "terbuka" mendapat tanda bintang. Kimi K3 bukan MIT. Ia keluar di bawah lesen tersendiri "Kimi K3 License" yang tidak diluluskan OSI dan membawa klausa ambang hasil: menjalankan K3 sebagai enjin perniagaan Model-as-a-Service besar memerlukan perjanjian berasingan dengan Moonshot. Bagi pembangun solo, atau syarikat biasa yang menggunakannya secara dalaman, itu tidak mengubah apa-apa. Tetapi bagi sesiapa yang membina produk terhos berskala besar, "berat terbuka" dan "lesen terbuka" ialah dua soalan berbeza — dan di sini hanya yang pertama sahaja "ya" yang jelas.
Qwen3.8-Max ialah pratonton, bukan muat turun
Qwen ialah keluarga model Alibaba, dan pasukannya antara penerbit model terbuka paling prolifik di dunia — justru sejarah inilah yang membuatkan yang terbaharu mengelirukan. Diperkenalkan pada 19 Julai di WAIC Shanghai, Qwen3.8-Max ialah tajuk terbesar gelombang ini, sekali gus yang paling lembut. Ia ialah MoE jarang bersaiz 2.4 trilion parameter — bilangan parameter aktif tidak didedahkan — dan Qwen pertama melepasi satu trilion parameter yang multimodal, bermaksud ia menerima input bukan sahaja teks, tetapi juga imej, video dan dokumen.
Inilah perangkap yang perlu dieja untuk pendatang baharu: walaupun riuh-rendah, anda tidak boleh memuat turunnya. Buat masa ini ia hanya wujud sebagai "pratonton terhos" — qwen3.8-max-preview, dicapai melalui perkhidmatan Alibaba sendiri (Token Plan dan alat Qoder-nya) pada sekitar 10% harga standard. Pratonton terhos bermakna Alibaba menjalankan model pada pelayannya dan membenarkan anda memanggilnya; ia model API sewa, bukan model yang salinannya anda miliki. Menggelarnya pelancaran berat terbuka hari ini adalah terlalu awal.
Gambaran itu berubah pada 3 Ogos. Akaun rasmi Qwen di X, @Alibaba_Qwen, menyiarkan bahawa berat terbuka Qwen3.8-Max akan tiba "minggu depan" — dan bahawa Qwen3.8-27B yang lebih kecil juga akan menjadi berat terbuka. Jadi 27B bukan khabar angin, apa pun yang dibayangkan perbualan terdahulu: ia komitmen bertulis, daripada akaun Alibaba sendiri. Dan saiznya itulah intinya. Sedangkan Max bersaiz 2.4 trilion parameter, seperti K3, hanya boleh dijalankan pusat data, 27B cukup kecil untuk disajikan pada satu mesin kelas atas — kelas yang benar-benar boleh dihos sendiri oleh individu atau pasukan kecil. Itu benar-benar melembutkan gambaran "dijanjikan tanpa perincian": kini ada saiz dan rangka masa kasar.
Namun begitu, amaran jujurnya tetap berdiri. "Minggu depan" ialah hala tuju, bukan tarikh penghantaran, dan pada saat penulisan ini, 4 Ogos, tiada apa-apa yang mendarat di organisasi Qwen di Hugging Face — model terbarunya di sana daripada Jun. Lesen berat terbuka juga belum diterbitkan, dan pembaca awal terma pratonton menandakan kemungkinan sekatan serantau, belum disahkan sehingga lesen sebenar muncul — tepat-tepat pengajaran "lesen dahulu" daripada asas tadi. Dakwaan Alibaba bahawa model ini "hanya kalah kepada Fable 5" kekal dakwaan sendiri tanpa angka pihak ketiga, jadi anggap ia sebagai baris pemasaran vendor sehingga ada pihak di luar Alibaba mengukurnya. Jika anda mahu mencuba model ini hari ini, pratonton terhos ialah satu-satunya pintu — tetapi buat pertama kalinya, penantian berat yang boleh dimuat turun diukur dengan "minggu depan", bukan "suatu hari nanti".
DeepSeek V4 diam-diam mencapai ketersediaan umum
DeepSeek ialah makmal yang model R1-nya membantu mencetuskan perlumbaan model terbuka semasa pada awal 2025, dan tetap dengan gayanya, di sini ia paling kurang mengumumkan sambil menyerahkan yang paling boleh digunakan. Barisan V4-nya, yang dilancarkan sejak 24 April, ialah yang paling mudah diterima pakai, kerana ia datang di bawah lesen yang asas tadi tandakan sebagai piawai emas.
V4 hadir dalam dua saiz, kedua-duanya berlesen MIT. V4-Pro ialah perkasa dengan 1.6 trilion keseluruhan dan 49 bilion parameter aktif; V4-Flash ialah yang ringan dengan 284 bilion keseluruhan dan 13 bilion aktif. Ingat apa maksud angka aktif: V4-Flash hanya menyalakan 13 bilion parameter setiap token, yang menjadikannya murah dan pantas disajikan, dan itulah yang menjadikannya pilihan jimat untuk kerja bervolum tinggi — jenis beban transkripsi-dan-ringkasan di mana kos setiap token menentukan segalanya. Kedua-duanya mempunyai tetingkap konteks satu juta token dan boleh menghasilkan sehingga 384K token keluaran dalam satu respons, cukup untuk merangka laporan panjang, bukan sekadar satu perenggan. Sekitar 20 Julai, V4 mencapai ketersediaan umum dengan penetapan harga berasaskan masa, yang menarik pelancaran musim bunga ke dalam bingkai tiga minggu yang sama dengan K3 dan Qwen.
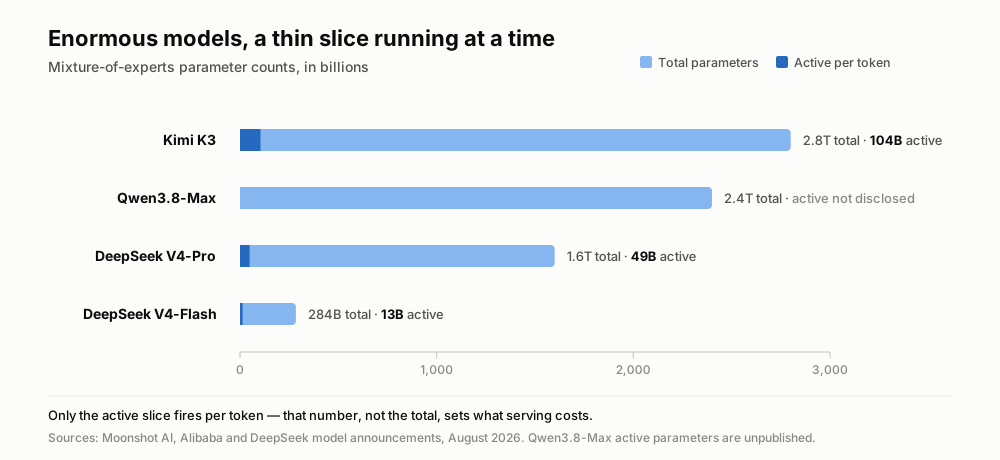
Bar cerah ialah saiz model itu; bahagian gelap yang pendek ialah bahagian yang benar-benar menyala pada setiap token. Alibaba belum mendedahkan parameter aktif Qwen3.8-Max.
Kerana ia MIT, V4 ialah yang boleh dibina oleh penerima pakai dengan paling sedikit peguam: dapatkan beratnya (atau guna pembekal terhos), jalankan, lancarkan secara komersial, tak berhutang apa-apa dan tak bertanya sesiapa. Dan supaya jelas tentang nombor versi, kerana kilang khabar angin menggemarinya — tiada R2, tiada V5, tiada V4.1. Hanya ada keluarga V4 yang matang menjadi sesuatu yang boleh diharapkan pasukan.
Jurang menguncup lebih pantas daripada yang diakui papan kedudukan
Berundur selangkah, kecerunan lebih penting daripada pelancaran satu per satu. Bacaan Nathan Lambert ialah jarak antara model terbuka terbaik dan model tertutup terbaik telah memampat daripada kira-kira enam hingga sembilan bulan kepada tiga hingga lima — "model terbuka tidak pernah sedekat ini dengan frontier sejak DeepSeek R1". Secara ringkas: model yang boleh dimuat turun percuma kini hanya beberapa bulan di belakang model terbaik yang boleh disewa dengan wang, sedangkan setahun lalu ia tertinggal satu pusingan yang selesa.
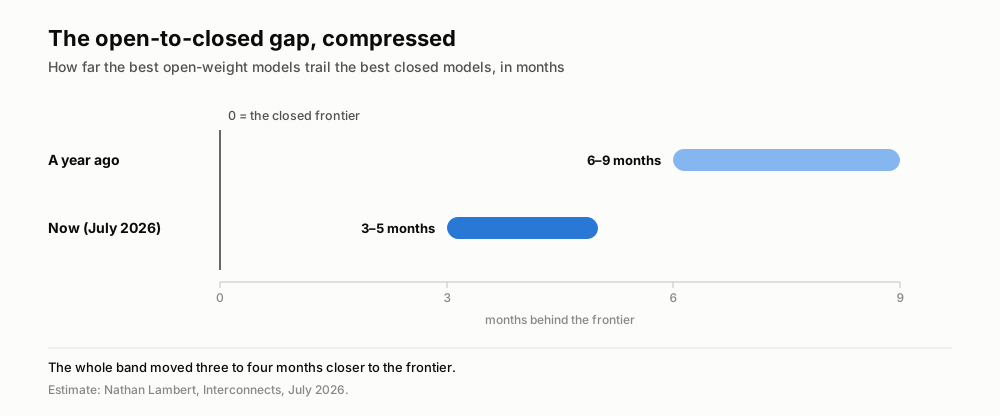
Anggaran Lambert dilukis mengikut skala: pihak terbuka bukan sekadar menghampiri, seluruh julat itu turut mengecil.
Data penggunaan menunjuk ke arah yang sama. Di OpenRouter, sebuah pasaran yang mengagihkan permintaan merentas banyak model, bahagian token model berasal AS jatuh daripada kira-kira 70% pada Jun 2025 kepada sekitar 30% setahun kemudian, sementara model berasal China kini kerap melepasi 30%. Harga ialah sebahagian besar sebabnya: model terbuka China biasanya 60% hingga 90% lebih murah setiap token, dan pengehosan muncul serta-merta, seperti yang diperjelaskan oleh endpoint K3 pada hari sifar itu.
Peralihan yang lebih senyap ialah tentang skala. Jenama model terbuka China dahulu ialah kecil, pantas, murah. K3 dengan 2.8 trilion parameter dan Qwen3.8-Max dengan 2.4 trilion ialah sebaliknya sama sekali — pertaruhan bahawa berfikir besar dalam ranah terbuka kini berbaloi. GLM-5.2 daripada Z.ai, yang dilancarkan pada 16 Jun di bawah MIT dan mendahului kategori berat terbuka Artificial Analysis Index dengan skor 51, ialah mesej yang sama daripada makmal keempat.
Kelokan: kerajaan yang memungkinkan ini mungkin mengekangnya
Kemudian angin berpaling arah. Sekitar 22 hingga 25 Julai, Financial Times dan Reuters melaporkan bahawa Kementerian Perdagangan China sedang menimbang kawalan eksport ke atas model AI — termasuk LLM berat terbuka — dengan Alibaba, ByteDance dan Z.ai dikatakan turut dalam perbincangan. Rangka kerja yang dibangkitkan bertingkat: kewajipan melapor bagi model yang lebih lemah, semakan keselamatan bagi yang lebih kuat, dan kemungkinan larangan menerbitkan secara terbuka model yang paling berupaya. Tiada apa-apa lagi menjadi undang-undang. Namun arahnya ketara: gelombang ini mungkin sedang memuncak tepat pada saat kerajaannya sendiri mula memperlakukan model-model ini sebagai eksport strategik, bukan sumbangan terbuka.
Kesimpulan: apabila yang terbuka menjadi aset strategik
Cerita yang kemas berbunyi "China telah mengejar". Yang lebih tepat berbunyi: berat terbuka menjadi aset strategik cukup pantas sehingga sebuah kerajaan kini mahu memegang paip. Dalam tiga minggu, model terbuka beralih daripada ketinggalan dua hingga tiga suku di belakang frontier kepada hanya satu — dan daripada kecil dan murah kepada antara model terbesar yang pernah diterbitkan dalam apa jua bentuk. Frontier terbuka bukan sekadar berganjak. Ia berganjak ke tempat yang penciptanya mungkin tidak lagi bebas untuk terus menghantar dari situ.
Bagi pasukan yang membina di atas model-model ini, pengajaran praktikalnya kekal sama dan sedikit lebih tajam. Telli.sh sudah menjalankan model terbuka, Qwen3, dalam lapisan ringkasannya, jadi setiap peningkatan kualiti dan harga model terbuka mengalir terus ke transkripsi mesyuarat, terjemahan dan ringkasan. Item baharunya ialah bekalan: jika peraturan eksport China terbentuk seperti yang dibayangkan laporan, persoalan model terbuka mana yang kekal boleh dimuat turun secara bebas ialah sesuatu yang perlu dipantau, bukan diandaikan. Bahawa model yang menyuap lapisan itu semakin baik ialah aliran; dari mana model-model itu dibenarkan datang ialah perkara yang perlu terus diperhatikan.
Sumber
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
