Qwen3.8-27B open weights: saiz, Q4_K_M dan kelajuan sebenar 4090/Mac
Qwen3.8-27B dikeluarkan di bawah lesen Apache 2.0. GGUF Q4_K_M bersaiz 17.1 GB dan muat pada laptop 32 GB; FP8 pula 30.9 GB. Diukur: 48 token/saat pada RTX 4090, 12.75 pada Mac mini M4 Pro.
Pada 3 Ogos, akaun Qwen milik Alibaba berkata pemberat terbuka akan tiba «minggu depan». Itulah jenis ayat yang telah dilatih oleh industri AI supaya didengar dengan diskaun. Dua belas hari kemudian tiada apa lagi untuk didiskaunkan: pemberat Qwen3.8-Max dengan 2.4 trilion parameter muncul di Hugging Face pada 12 Ogos, dan model kecilnya — Qwen3.8-27B, di bawah lesen Apache 2.0 yang biasa sahaja — menyusul pada 14 Ogos.
Kemudian bahagian yang menariknya berlaku. Dalam jam yang sama ketika Qwen selesai menerbitkan kad model 27B, tiga kumpulan komuniti yang berbeza sudah menukarkannya kepada format yang boleh dijalankan pada komputer peribadi. Dua hari selepas itu, penukaran tersebut melepasi sejuta muat turun.
Angka itulah beritanya, bukan jadual penanda aras. Sebuah model 27 bilion parameter daripada salah satu makmal AI terkemuka dunia bergerak daripada «diumumkan» kepada «sedang berjalan di kira-kira sejuta meja kerja» dalam lebih kurang 48 jam. Tulisan ini menerangkan dalam bahasa mudah apa maknanya: apa yang dikeluarkan dan di bawah lesen apa, apa yang diperlukan untuk menjalankan 27B pada perkakasan yang anda sudah miliki, sejauh mana ia melangkah dalam tiga tahun, dan bahagian yang selalunya dilangkau — apa yang masih tidak mampu dilakukan oleh 27B tempatan.
Ringkasnya:
- Janji ditepati. Qwen3.8-Max (2.4 trilion keseluruhan / 95 bilion aktif) tiba pada 12 Ogos, Qwen3.8-27B pada 14 Ogos. Kedua-duanya benar-benar boleh dimuat turun, bukan pratonton yang berjalan pada pelayan pengeluar.
- Lesen kedua-duanya berbeza, dan perbezaan itu lebih berat daripada markah. 27B menggunakan Apache 2.0: tiada ambang, tiada fasal, guna secara komersial tanpa berhutang apa-apa. Qwen3.8-Max keluar dengan lesen sendiri yang mempunyai pencetus hasil bagi perniagaan model sebagai perkhidmatan.
- Saiz yang menentukan siapa boleh menjalankan apa: Max ialah muat turun 4,892 GB; 27B yang dimampatkan kepada 4 bit hanya 17.1 GB dan muat pada mesin 32 GB. Versi 4 bit komuniti melepasi 1.07 juta muat turun dalam dua hari.
Gambar: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Menjalankan sendiri model daripada makmal terdepan bermakna mesin itu — dan penyelenggaraannya — menjadi milik anda.
Janji itu bertarikh, dan tarikhnya bertahan
Pada 4 Ogos kami menulis tentang pengumuman itu sendiri dan menyebut bahawa penantiannya diukur dalam «minggu depan», bukan «suatu hari nanti». Itulah sejauh mana bukti ketika itu membenarkan. Ceritanya berakhir dengan kemas.
Qwen3.8-2.4T-A95B — yang dipasarkan sebagai Qwen3.8-Max — muncul bersama fail lesennya pada 12 Ogos. Qwen3.8-27B dan varian FP8 yang dioptimumkan tiba pada 14 Ogos. Kedua-dua tarikh jatuh dalam tetingkap yang ditunjukkan oleh «minggu depan». Dalam industri yang model diumumkannya kerap tidak pernah keluar, sebuah makmal menepati tarikh akhir lisan berusia sembilan hari sudah pun layak dicatat.
Sambutannya segera dan besar. Utas Hacker News mengenai 27B mengumpul 1,351 mata dan 769 komen dalam sehari. Dalam beberapa jam, para pengamal menyiarkan konfigurasi penyajian yang berfungsi untuk perkakasan tertentu; ada yang berkongsi tetapan untuk NVIDIA DGX Spark dan juga kad grafik pengguna RTX 4090. Dua tahun lalu industri tidak menyambut keluaran terbuka begini, ketika sekadar membuat seni bina baharu berjalan pun sudah menjadi projek hujung minggu.
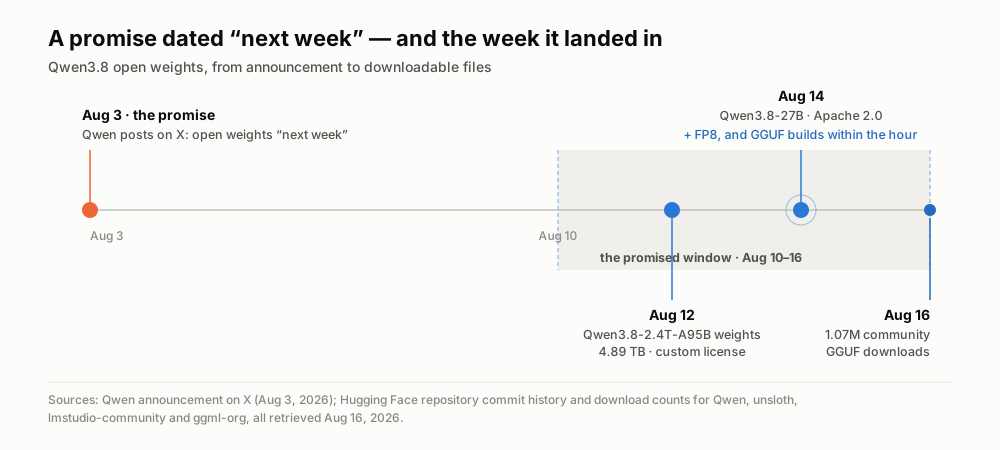
Sebuah janji bertarikh dan dua penghantaran yang mendarat di dalamnya. Tarikh daripada sejarah commit repositori Hugging Face, dicapai pada 16 Ogos 2026.
Lima istilah, ditumpukan pada soalan «mampukah saya menjalankannya?»
Jika anda datang daripada tulisan kami sebelum ini, anda sudah tahu apa itu pemberat terbuka: makmal menerbitkan grid gergasi berisi nombor yang dipelajari yang membentuk model siap, dan anda boleh memuat turunnya, menjalankannya pada perkakasan sendiri, serta membina di atasnya tanpa membayar bagi setiap permintaan. Di sini kita mengambil berat soalan seterusnya, yang sepenuhnya praktikal: berapa kosnya untuk dijalankan, dari segi perkakasan?
Parameter ialah nombor-nombor yang dipelajari itu, dan jumlahnya menetapkan saiz mentah model. Petua kasarnya mudah sehingga kejam: pada kejituan yang digunakan makmal untuk melatih, setiap satu bilion parameter memakan kira-kira 2 GB pada cakera, dan anda memerlukan lebih kurang sebanyak itu memori untuk memegang model semasa ia berjalan. Jadi model 27 bilion parameter ialah muat turun 55 GB. Model 2.4 trilion menghampiri 5 terabait. Itulah sebabnya yang satu ialah persoalan komputer riba dan yang satu lagi persoalan pusat data.
Kuantisasi ialah yang merapatkan jurang itu, dan ia idea paling berguna bagi sesiapa yang mahu menjalankan model di rumah. Parameter lazimnya disimpan pada kejituan 16 bit. Kuantisasi membundarkannya kepada bit yang lebih sedikit — 8, 4, kadangkala 2 — dan failnya mengecil lebih kurang mengikut nisbah yang sama. Kuantisasi 4 bit menjadikan muat turun 55 GB tadi kira-kira 17 GB. Anda kehilangan sedikit kejituan dan memperoleh keupayaan untuk menjalankannya langsung. GGUF hanyalah format fail yang digunakan oleh versi termampat ini; itulah yang dibaca oleh alat seperti llama.cpp, Ollama dan LM Studio. Apabila anda nampak «Q4_K_M», bacalah sebagai «versi 4 bit yang digunakan kebanyakan orang».
Padat berbanding campuran pakar menentukan kelajuan setelah model itu muat. Qwen3.8-27B ialah model padat: kesemua 27 bilion parameter menyala bagi setiap perkataan yang dihasilkan. Qwen3.8-Max pula model campuran pakar — 2.4 trilion parameter keseluruhan, tetapi sebuah penghala hanya memilih kira-kira 95 bilion bagi setiap token, tersebar merentasi 512 subrangkaian pakar. Angka keseluruhan memberitahu bil penyimpanan; angka aktif memberitahu bil pengiraan. Perbezaan ini mempunyai mata praktikal yang tajam, dan kita akan kembali kepadanya.
Tetingkap konteks ialah berapa banyak yang boleh dipertimbangkan model dalam satu masa. 27B mengendalikan 262,144 token secara asli — setimbun transkrip mesyuarat sejam — dan boleh diregangkan sehingga sejuta melalui perubahan konfigurasi.
Lesen ialah perkara pertama yang perlu dibaca
Inilah penemuan yang memikul beban tulisan ini, dan ia bertentangan dengan andaian bahawa satu keluarga model berkongsi satu keluarga syarat.
Qwen3.8-27B menggunakan Apache 2.0. Itulah hujung paling longgar pada spektrum: guna, ubah suai, perhalusi, masukkan ke dalam produk komersial, bina perniagaan di atasnya, tanpa berhutang apa-apa dan tanpa meminta izin sesiapa. Tiada ambang hasil, tiada kewajipan memaparkan nama pada antara muka, tiada pengecualian bidang penggunaan.
Qwen3.8-Max tidak. Ia keluar di bawah «Qwen3.8-Max License» sendiri, yang bermula seperti MIT lalu menambah dua syarat. Jika produk anda melepasi 100 juta pengguna aktif bulanan atau 20 juta dolar AS hasil bulanan, anda mesti memaparkan nama model pada antara muka. Dan jika anda mengendalikan perniagaan model sebagai perkhidmatan atau pembantu kerja AI yang hasilnya melebihi 50 juta dolar dalam mana-mana dua belas bulan berturut-turut, anda memerlukan perjanjian berasingan dengan Qwen sebelum sebarang penggunaan komersial.
Bagi pembangun bersendirian atau syarikat yang menggunakannya secara dalaman, tiada satu pun daripada ini menggigit. Tetapi inilah tanda bintang yang sama yang kami tandakan ketika Kimi K3 keluar dengan lesen sendiri dan bukan MIT, dan pengajarannya berulang: «pemberat terbuka» dan «lesen terbuka» ialah dua soalan berasingan, dan sebuah makmal boleh menjawabnya secara berbeza bagi dua model yang dikeluarkan berselang dua hari. Baca lesennya sebelum jatuh hati pada sesuatu markah.
| Model | Jumlah parameter | Aktif setiap token | Saiz muat turun | Lesen | Tempat berjalan realistik |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2.4 trilion | 95 bilion | 4,892 GB | Sendiri, pencetus hasil | Sekelompok pemecut |
| Qwen3.8-Max, FP8 | 2.4 trilion | 95 bilion | 2,496 GB | Sendiri, pencetus hasil | Sekelompok pemecut |
| Qwen3.8-27B | 27 bilion, padat | 27 bilion | 55.6 GB | Apache 2.0 | Stesen kerja berbilang GPU |
| Qwen3.8-27B, FP8 | 27 bilion, padat | 27 bilion | 30.9 GB | Apache 2.0 | Satu GPU kelas atas |
| Qwen3.8-27B, Q4_K_M GGUF | 27 bilion, padat | 27 bilion | 17.1 GB | Apache 2.0 | Komputer riba 32 GB atau sebuah 4090 |
Apa yang sebenarnya diperlukan untuk menjalankan 27B
Jawapan jujurnya: kurang daripada sangkaan anda, dan lebih daripada yang disiratkan tajuk berita.
Anak tangga paling rendah ialah satu arahan. 27B ada dalam pustaka Ollama; ollama run qwen3.8 menarik versi 18 GB dengan tetingkap konteks 256K dan input imej, daripada dua belas varian termasuk satu yang ditala untuk cip Apple. LM Studio, yang memberi anda tetingkap sembang dan bukan terminal, sudah menaikkan versinya beberapa minit selepas keluaran. Kedua-duanya tidak menuntut anda memahami bahagian sebelum ini.
Kemudian realiti menyampuk dalam bentuk token sesaat. Ukuran yang dilaporkan pengamal dalam utas keluaran jatuh lebih kurang di tempat yang diramalkan perkakasan. Pada RTX 4090 dengan versi 4 bit, seseorang mengukur kira-kira 48 token sesaat — jauh lebih laju daripada kelajuan anda membaca. Pada Mac mini M4 Pro dengan memori 64 GB, seorang lagi memperoleh 12.75 token sesaat: boleh diguna, tetapi anda memerhatikannya menaip. Dan pada komputer riba dengan AMD 7840U serta 64 GB DDR5 biasa, versi 4 bit yang sama menghasilkan kira-kira 4 token sesaat — dari segi teknikal ia berjalan, dari segi praktikal ia tugas kelompok yang anda mulakan lalu tinggalkan.
Angka terakhir itulah tempat perbezaan padat berbanding pakar membuktikan nilainya. Orang yang sama mengukur, pada komputer riba yang sama, sebuah model campuran pakar lama yang pada namanya lebih besar pada kira-kira 20 token sesaat — lima kali lebih laju daripada model padat yang lebih kecil, kerana hanya sebahagian kecil parameternya menyala bagi setiap perkataan. Jika anda mencari sesuatu untuk dijalankan pada CPU, angka yang perlu dibandingkan ialah parameter aktif, bukan jumlah keseluruhan. Itulah pengajaran paling berlawanan gerak hati dan paling berguna dalam AI tempatan.
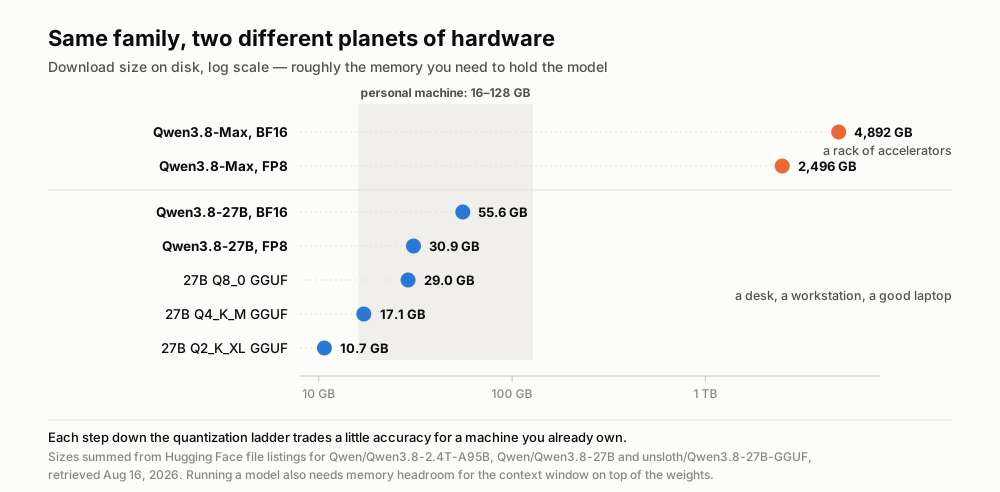
Dua ahli keluarga model yang sama, dipisahkan faktor 290 dari segi saiz muat turun. Saiz dijumlahkan daripada senarai fail Hugging Face, dicapai pada 16 Ogos 2026.
Tiga tahun lalu ini memerlukan kebocoran dan satu hujung minggu
Untuk melihat betapa besarnya lonjakan ini, letakkannya di sebelah titik permulaan model tempatan.
Pada Februari 2023, Meta mengeluarkan pemberat LLaMA asal hanya kepada penyelidik yang diluluskan. Ia bocor dalam masa kira-kira seminggu, dan seluruh kancah amatur model tempatan dibina di atas sebuah fail yang sepatutnya tiada sesiapa memilikinya. Pada 10 Mac 2023, seorang pembangun menerbitkan llama.cpp, sebuah program C++ kecil yang aksi utamanya ialah menjalankan model 7 bilion parameter pada MacBook. Repositori itu kini mempunyai 124,000 bintang dan menjadi moyang kepada hampir setiap alat «jalankan secara tempatan» yang digunakan hari ini.
Bandingkan dua hari keluaran itu. Pada 2023: sebuah 7B yang bocor, tiada lesen yang boleh disebut, seminggu usaha komuniti untuk membuatnya berjalan, dan sebuah model yang lebih menarik daripada berguna. Pada 2026: sebuah 27B daripada makmal terdepan, diterbitkan dengan sengaja di bawah Apache 2.0, dengan input imej dan video, tetingkap konteks 262K, dan versi komuniti yang siap sebelum dokumentasi makmal itu sendiri berhenti berubah. Commit pertama penukaran unsloth jatuh pada 14:56 UTC pada 14 Ogos — empat minit sebelum kemas kini terakhir kad model oleh Qwen.
Angka penerimaan menyatakan perkara yang sama dengan lebih terus terang. Setakat 16 Ogos, versi 4 bit komuniti bagi 27B mencatat 867,963 muat turun pada satu penerbit, 171,518 pada penerbit kedua dan 34,520 pada yang ketiga: 1.07 juta dalam dua hari. Repositori rasmi Qwen sendiri bagi 27B menambah 215,000 lagi. Qwen3.8-Max, model yang jauh lebih berkemampuan, berada pada 17,126 bagi kedua-dua repositorinya.
Baca semula nisbah itu. Model berskala terdepan menerima kira-kira 1.6 peratus daripada perhatian yang jatuh kepada model berskala komputer riba. Apa yang diambil oleh pasaran bukanlah keupayaan. Ia jangkauan.
Apa yang masih tidak mampu dilakukan 27B tempatan
Kini giliran pembetulan, kerana keghairahan memintas bukti dengan cara yang boleh dijangka.
Jadual penanda aras Alibaba sendiri meletakkan 27B di hadapan Opus 4.6 Max pada beberapa ukuran pengaturcaraan agentik dan kepatuhan arahan — 61.7 berbanding 53.4 pada SWE-bench Pro, 79.5 berbanding 62.5 pada IFBench — sambil kalah pada yang lain, termasuk 30.8 berbanding 40.0 pada HLE yang menguji pengetahuan luas. Setiap satu angka itu dilaporkan sendiri oleh pengeluarnya. Ketika tulisan ini disiapkan, Artificial Analysis, penilai bebas yang kami sandarkan, langsung tiada entri bagi 27B; ia memang meletakkan Qwen3.8-Max di kedudukan ke-10 daripada 188 model dengan skor kecerdasan 58, yang cemerlang dan juga merupakan model yang berlainan.
Para pengamal lebih tajam daripada hamparan angka. Bantahan yang paling banyak disokong dalam utas itu, daripada seseorang yang mengaku pengguna lama model terbuka, berbunyi tegas: model-model ini tidak mengalahkan model terhos terbaik dalam penggunaan sebenar; ia «cukup baik» untuk banyak tugas dan boleh dijalankan pada perkakasan yang mampu dimiliki — satu dakwaan yang berbeza dan lebih sederhana. Komen lain meletakkan siling itu secara fizikal: anda tidak boleh memampatkan seluruh pengetahuan manusia ke dalam fail 30 GB, jadi model kecil kekal agak lemah dalam mengingati fakta yang jarang diketahui, betapa tajam sekalipun ia dalam menulis kod atau menggunakan alat.
Ada dua lagi batasan yang hanya muncul apabila anda menjalankannya. Kuantisasi bukan percuma: model yang dimampatkan dengan berat cenderung hilang jalan cerita pada konteks panjang dan boleh terjatuh ke dalam gelung berulang — itulah sebabnya sesiapa yang mempunyai memori berlebihan dinasihatkan menggunakan versi kejituan penuh. Dan generasi Qwen ini berfikir panjang secara lalai: seorang pengguna memberi 27B pada Mac mini 64 GB dua patah perkataan sahaja, «svg owl», lalu menyaksikannya menjana 21,769 token penaakulan selama 17 minit 12 saat sebelum menjawab. Burung hantunya menjadi cantik. Bil dalam masa jam dinding juga terhasil, yang tidak akan dicaj oleh mana-mana API terhos.
Kemudian ada butiran yang tiada sesiapa mengiranya: operasi kini milik anda. Kemas kini model, pilihan kuantisasi, ruang lega memori, versi pemacu, kipas mesin itu sendiri. API terhos yang anda cuba elakkan itu juga sepasukan manusia yang menjaga sesuatu supaya terus berjalan.
Kesimpulannya: parit itu bergerak turun dalam tindanan
Inilah intinya, dan ia lebih besar daripada satu keluaran.
Sebuah makmal terdepan menerbitkan 27B yang berkemampuan pada hari Khamis. Menjelang Sabtu, lebih sejuta salinan versi yang dimampatkan komuniti sudah berada pada mesin orang ramai, ia hanya sejauh satu arahan dalam Ollama, dan secara undang-undang bebas untuk dijadikan asas perniagaan. Apa pun kelebihan yang diwakili model itu, ia mengambil masa kira-kira dua hari untuk tersedia kepada semua pesaing serentak. Panggillah ia parit dua hari: kelebihan model yang kini mempunyai separuh hayat kira-kira 48 jam.
Ini bukan ramalan. Ini pengukuran, diambil minggu ini, pada keluaran ini.
Dan ia mentakrifkan semula apa maksudnya membina produk AI. Apabila lapisan model menjadi komoditi yang boleh ditukar sesiapa dalam satu petang, model berhenti menjadi perkara yang anda bersaing padanya. Yang terus hidup ialah segala yang membungkusnya: kebolehpercayaan ketika pelayan inferens tumbang pada pukul tiga pagi, saluran data yang menangkap, membersih dan mendapatkan semula konteks yang betul, penilaian yang memberitahu anda sama ada ia berfungsi pada data anda dan bukan data penanda aras, antara muka yang benar-benar akan digunakan orang, dan pengaturan kepercayaan — privasi, tempoh simpanan, siapa boleh melihat apa — yang menentukan sama ada ada sesiapa sanggup menyerahkan rakaman mesyuarat mereka kepada anda.
Tiada satu pun daripada itu menjadi komoditi dalam dua hari. Tiada satu pun mempunyai butang muat turun.
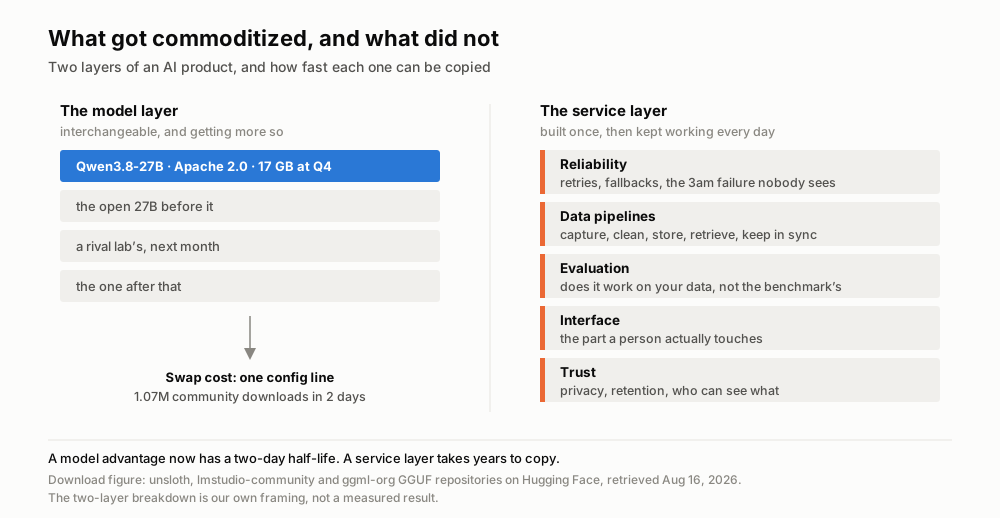
Lapisan yang menjadi murah minggu ini, dan lapisan yang tidak. Angka muat turun daripada Hugging Face, dicapai pada 16 Ogos 2026; pembahagian dua lapisan ini ialah rangka kami sendiri.
Jadi tindak balas yang betul terhadap sebuah model terbuka yang hebat mendarat di komputer riba bukanlah «syarikat model menang» atau «syarikat produk kalah». Ia adalah bahawa kerja yang menarik telah turun satu tingkat dalam tindanan — ke tempat yang jauh lebih sukar disalin dan jauh kurang seronok dijadikan tajuk berita.
Di mana Telli.sh berdiri: kami membina tepat lapisan perkhidmatan itu, di atas model terbuka. Telli.sh sudah pun menggunakan model Qwen terbuka dalam laluan ringkasannya, bermakna setiap lonjakan mutu model terbuka — termasuk yang ini — mengalir terus ke transkripsi, terjemahan dan ringkasan mesyuarat tanpa perubahan harga di pihak anda. Masa kami dihabiskan pada bahagian yang tidak tiba dalam fail GGUF: menangkap audio dengan boleh dipercayai, tidak keliru siapa bercakap, menukar rakaman 60 minit menjadi nota yang masih boleh anda cari berbulan kemudian, dan berterus terang tentang di mana data anda berada.
Sumber
- Kad model dan lesen Qwen3.8-27B, Hugging Face
- Kad model dan lesen Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: versi terkuantisasi dan jumlah muat turun
- Qwen3.8 dalam pustaka model Ollama
- Perbincangan Hacker News tentang keluaran Qwen3.8-27B (14 Ogos 2026)
- Halaman model Qwen3.8 Max di Artificial Analysis
- Pengumuman pemberat terbuka oleh Qwen (@Alibaba_Qwen) di X (3 Ogos 2026)
- Repositori llama.cpp, dicipta pada 10 Mac 2023
- Halaman gambar di Wikimedia Commons
