Un file da 16,5 GB ora batte il miglior modello chiuso di febbraio
Tre anni fa il miglior modello scaricabile perdeva di 37 punti contro GPT-4 su HumanEval e richiedeva due schede grafiche. La settimana scorsa un modello aperto da 27B ha ottenuto 52,0 nell'indice di intelligenza di Artificial Analysis contro il 44,9 di Claude Opus 4.6 Max, a un nono del prezzo e da un file di 16,5 GB. Un prima e dopo con le tabelle dei benchmark, la curva dei prezzi e il significato di un ritardo di rincorsa sceso a 162 giorni.
Qualcuno su Hacker News sta eseguendo un modello linguistico di primissima fascia su una scheda grafica da 16 GB, a 50-60 token al secondo, con una finestra di contesto da 128.000 token. Il modello è Qwen3.8-27B, pubblicato il 14 agosto 2026. Nell'indice di intelligenza di Artificial Analysis ottiene 52,0, più di Claude Opus 4.6 Max, che fino a febbraio era il miglior modello proprietario sul mercato e si ferma a 44,9.
Nel 2023 quella frase sarebbe stata fantascienza, e non del tipo divertente.
Questo articolo è il prima e dopo. Non la cronaca del rilascio — quella l'abbiamo già scritta — ma il confronto su tre anni: quanto segnava il miglior modello scaricabile contro la frontiera allora e oggi, quanto costava comprare un dato livello di intelligenza allora e oggi, e quale hardware bisognava possedere per eseguirlo da soli. Ogni cifra qui sotto ha una fonte e una data. La tendenza che descrivono è tra le cose più sinceramente ottimistiche che stiano accadendo oggi nel software.
In breve:
- Il divario si è chiuso, e possiamo datarlo. A luglio 2023 il miglior modello aperto perdeva 17,5 punti su MMLU e 37,1 su HumanEval contro GPT-4. Ad agosto 2026 un 27B aperto batte l'ammiraglia proprietaria di febbraio in 15 dei 19 benchmark che entrambi pubblicano, e anche su un indice composito indipendente.
- Il prezzo è sceso di circa 208 volte in 23 mesi, misurato da Epoch AI a soglia di capacità fissa. Il 27B aperto costa oggi 1,09 dollari per milione di token in tariffa mista, contro i 10,00 di Opus 4.6 Max, e zero per token se lo esegui tu.
- Non è la frontiera, e lo diciamo. Claude Opus 5 Max segna 63,1 e GPT-5.6 Sol Max 60,9. Sul ragionamento di cultura ampia il 27B perde nettamente contro Opus 4.6: 30,8 contro 40,0 su HLE.
Immagine: Steve Jurvetson, Wikimedia Commons, CC BY 2.0. L'interconnessione di un Cray Y-MP, intorno al 1988. Il calcolo serio era una stanza in cui si entrava.
Com'era davvero il «prima»
Riportiamo l'orologio al 18 luglio 2023, il giorno in cui Meta pubblicò Llama 2. Era il miglior modello liberamente scaricabile al mondo, e il suo stesso articolo stampava senza infingimenti il tabellone contro la frontiera chiusa.
Llama 2 70B otteneva 68,9 su MMLU contro l'86,4 di GPT-4. Su GSM8K, 56,8 contro 92,0. Su HumanEval, il benchmark di programmazione, 29,9 contro 67,0: meno della metà. Il riassunto dell'articolo stesso recita: «Permane un ampio divario di prestazioni tra Llama 2 70B e GPT-4 e PaLM-2-L». Ecco l'ammiraglia dei pesi aperti nel 2023, a parole sue.
Ora l'hardware. La build comunitaria a 4 bit di TheBloke — il modo in cui la gente eseguiva davvero Llama 2 70B — era un file da 41,4 GB, pubblicato il 4 settembre 2023. Per farlo girare a velocità utilizzabile servivano due schede da 24 GB o un Mac da 64 GB. Il modello che stava davvero su un portatile normale era Llama 2 13B: un file da 7,9 GB con 54,8 su MMLU, 31,6 punti dietro GPT-4 e utile a poco più che a una dimostrazione.
L'affare del 2023 era dunque questo: pagare un laboratorio di frontiera, oppure eseguire qualcosa di visibilmente peggiore su hardware che la maggior parte delle persone non possedeva. È esattamente per questo che l'argomento «usa l'API e basta» ha vinto in modo così netto per due anni. Era corretto.
Ora la stessa domanda ad agosto 2026
Alibaba ha pubblicato Qwen3.8-27B il 14 agosto 2026 sotto Apache 2.0, stampando sulla scheda del modello un confronto diretto con Claude Opus 4.6 Max. Abbiamo contato ogni riga in cui entrambi i modelli riportano un numero.
Qwen3.8-27B vince 15 di quelle 19 righe e ne perde 4. Tra le vittorie ci sono SWE-bench Pro (61,7 contro 53,4), l'aderenza alle istruzioni su IFBench (79,5 contro 62,5), la programmazione competitiva su LiveCodeBench v6 (90,3 contro 88,8), l'uso del computer su OSWorld-Verified (84,3 contro 72,7), i compiti di agente mobile su AndroidWorld (81,9 contro 62,0) e una lunga serie di benchmark multimodali in cui i margini non sono affatto stretti: 90,0 contro 65,5 su MathVision, 83,7 contro 66,0 sull'analisi di grafici in CharXiv, 65,5 contro 40,8 sul ragionamento incarnato di ERQA.
Le quattro sconfitte contano più delle vittorie, perché dicono che cosa un modello da 27 miliardi di parametri ancora non sa fare. Perde su Terminal Bench 2.1 (73,0 contro 78,2), sulla generazione di codice a livello di repository in NL2Repo-Bench (42,3 contro 47,6), di poco su GPQA Diamond (89,2 contro 91,3) e nettamente su HLE, il benchmark di ragionamento multidisciplinare: 30,8 contro 40,0. Quest'ultimo dato è la forma esatta dell'intero limite. Non si può comprimere la conoscenza del mondo in un file da 16,5 GB; si può invece comprimere una quantità enorme di abilità.
Una riga merita un asterisco: il 79,0 contro 63,8 arriva da QwenSWEBench, un benchmark costruito da Qwen. I risultati di un fornitore sul proprio benchmark sono la prova più debole in qualsiasi scheda di modello, e noi non ci contiamo.
Il tabellone indipendente dice la stessa cosa
Le tabelle del fornitore restano tabelle del fornitore, quindi ecco una terza parte. Artificial Analysis, che esegue valutazioni proprie invece di ristampare quelle altrui, ha ormai misurato il 27B. Al 21 agosto 2026 gli assegna un indice di intelligenza di 52,0, primo posto su 135 modelli nella classe dei pesi aperti da 4 a 40 miliardi di parametri, contro il 44,9 di Claude Opus 4.6 Max. Sono 7,1 punti a favore del modello aperto, misurati da chi non ha interessi nel risultato, 190 giorni dopo l'uscita di Opus 4.6.
Segui quel confronto a ritroso nel tempo ed è lì che sta la storia. A luglio 2023 il miglior modello aperto sotto i 40 miliardi di parametri segnava 2,6 sullo stesso indice. A luglio 2024, 7,4. A marzo 2025, 13,4. A febbraio 2026, 34,6. La settimana scorsa, 52,0.
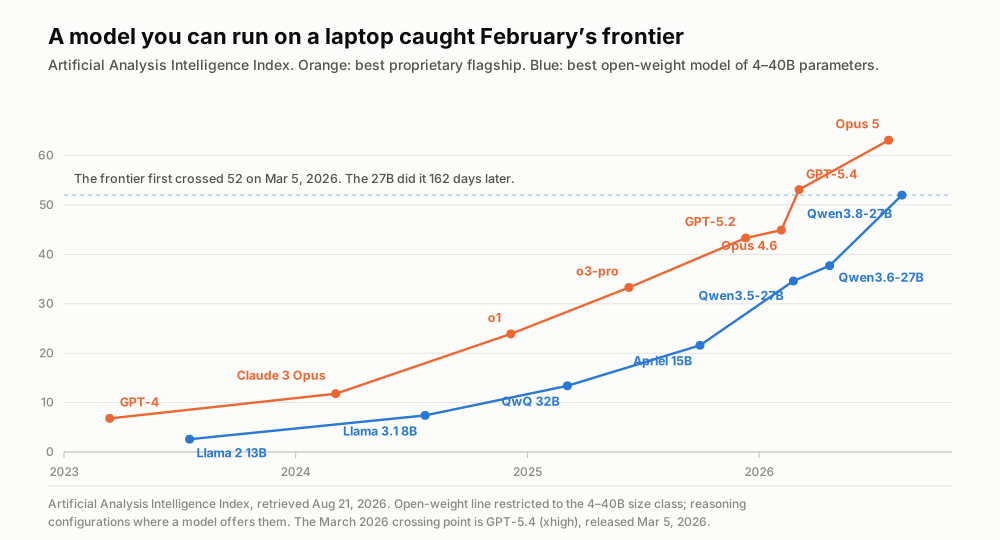
Entrambe le linee salgono; la quantità interessante è la distanza orizzontale tra loro. Indice di intelligenza di Artificial Analysis, consultato il 21 agosto 2026.
Ecco il numero che merita un nome. La frontiera ha superato l'indice 52 per la prima volta il 5 marzo 2026, quando GPT-5.4 ha ottenuto 53,1 al massimo sforzo di ragionamento. Un modello abbastanza piccolo da girare su una macchina personale ci è arrivato il 14 agosto: 162 giorni dopo. Chiamiamolo ritardo di rincorsa: il tempo che intercorre tra la comparsa di una capacità alla frontiera e la sua comparsa sul tuo hardware.
Quel ritardo era molto più lungo. A Llama 3.1 8B servirono 260 giorni per raggiungere un livello già toccato da GPT-4 Turbo. A GLM-4.7-Flash ne servirono 410 per pareggiare o1. Le ultime tre uscite di taglia portatile si collocano a 201, 155 e 162 giorni. La frontiera non sta rallentando — Opus 5 Max è oggi a 63,1 — ma il bordo che insegue recupera a una velocità circa doppia rispetto a due anni fa.
Il prezzo non è sceso: è crollato
La capacità è metà del prima e dopo. L'altra metà è la fattura.
Epoch AI ne ha pubblicato la misurazione più pulita a marzo 2025, e vale la pena capire il metodo: si fissa un punteggio di benchmark e si segue nel tempo il modello più economico che lo raggiunge. Fissa la soglia agli 86 punti di GPT-4 su MMLU e la scala dà 37,50 dollari per milione di token a marzo 2023, 15,00 a novembre 2023, 7,50 a maggio 2024, 2,19 più avanti nello stesso mese e 0,18 a febbraio 2025. Stesso punteggio. 208 volte più economico in 23 mesi.
La conclusione centrale di Epoch è che il ritmo varia enormemente a seconda del compito — tra 9 e 900 volte l'anno secondo la capacità fissata — con il prezzo delle prestazioni di livello GPT-4 su domande scientifiche da dottorato in calo di circa 40 volte l'anno. La direzione, invece, non cambia mai.
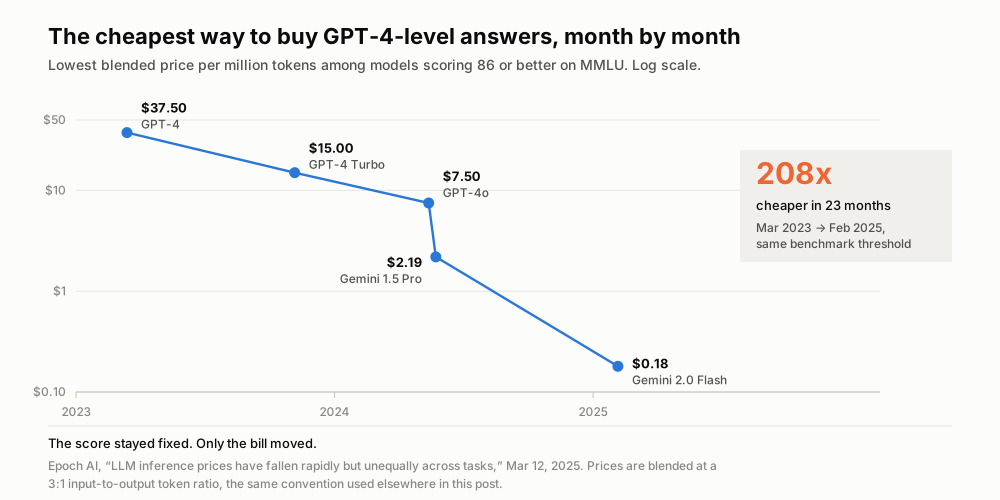
Il punteggio del benchmark è costante in ogni punto di questa linea. Epoch AI, 12 marzo 2025.
Estendi la serie ai prezzi di oggi e il movimento prosegue. Nel catalogo OpenRouter al 21 agosto 2026, Qwen3.8-27B costa 0,45 dollari per milione di token in ingresso e 3,20 per milione in uscita; Claude Opus 4.6 costa 5,00 e 25,00. Miscelati secondo il rapporto 3 a 1 usato da Epoch, fanno 1,09 contro 10,00 dollari: il modello aperto costa 9,1 volte meno ed è superiore di 7,1 punti di indice all'ammiraglia chiusa di sei mesi fa.
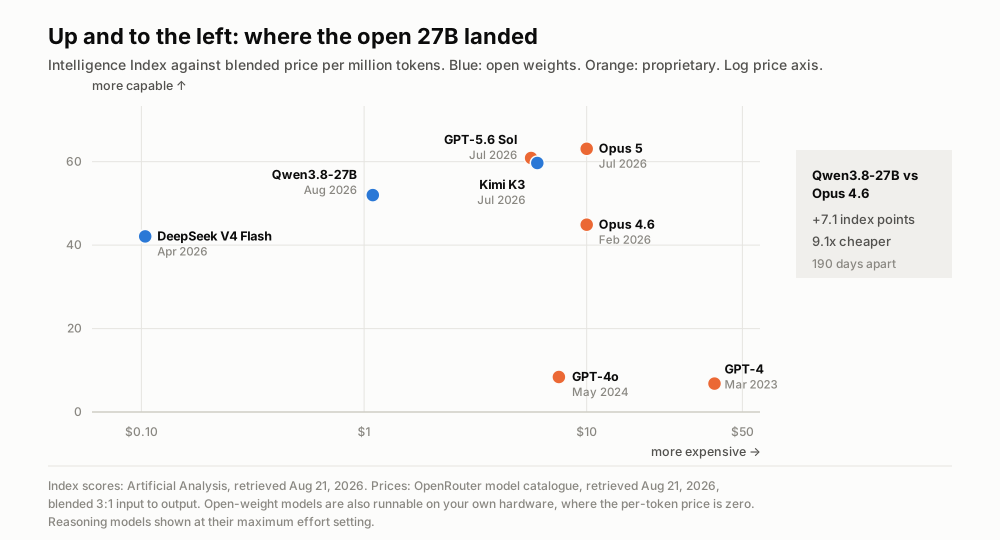
Tutti i modelli che contano stanno migrando verso l'angolo in alto a sinistra. Punteggi di Artificial Analysis, prezzi di OpenRouter, entrambi consultati il 21 agosto 2026.
E poi c'è l'opzione che non ha alcun prezzo per token. Esegui il 27B sulla tua RTX 4090 ai circa 48 token al secondo riportati dagli utenti nel thread del rilascio, assumi i 450 watt nominali della scheda e, al prezzo medio residenziale dell'elettricità negli Stati Uniti di 18,44 centesimi per kilowattora (EIA, maggio 2026), la corrente costa circa 0,48 dollari per milione di token in uscita: prima di contare la scheda, e dopo aver smesso di contare il margine di chiunque. È una stima calcolata con le ipotesi messe sul tavolo, non un'affermazione di un fornitore.
Il prima e il dopo, riga per riga
| Luglio 2023 | Agosto 2026 | |
|---|---|---|
| Miglior modello scaricabile | Llama 2 70B (Meta, 18 luglio 2023) | Qwen3.8-27B (Alibaba, 14 agosto 2026) |
| Parametri | 70 miliardi | 27 miliardi |
| Build comunitaria standard a 4 bit | 41,4 GB | 16,5 GB |
| Build minima utilizzabile | 7,9 GB (13B, MMLU 54,8) | 9,8 GB (2 bit, contesto da 128K su una scheda da 16 GB) |
| Hardware realistico | due GPU da 24 GB o un Mac da 64 GB | una GPU consumer da 16 GB |
| Modello di frontiera dell'epoca | GPT-4 (14 marzo 2023) | Claude Opus 4.6 Max (5 febbraio 2026) |
| Risultato contro di esso | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | vince 15 dei 19 benchmark pubblicati, +7,1 punti di indice |
| Prezzo misto di quel modello di frontiera | 37,50 $ per milione di token | 10,00 $ per milione di token |
| Prezzo misto del modello aperto | nessuna offerta su larga scala | 1,09 $ per milione di token |
| Licenza | Llama 2 Community License | Apache 2.0 |
Le fonti di ogni cella sono in fondo. La riga a cui torniamo di continuo è la penultima: il prezzo della frontiera stessa è sceso di 3,75 volte in tre anni, mentre l'alternativa aperta è comparsa al di sotto, a circa un decimo di quella cifra. Sono accadute entrambe le cose. È la seconda a cambiare chi può costruire.
Che cosa non è ancora vero
L'entusiasmo attorno a questo rilascio corre davanti alle prove in quattro punti precisi. Segnaliamoli.
Non è la frontiera. Sullo stesso indice Claude Opus 5 Max segna 63,1 e GPT-5.6 Sol Max 60,9, ben oltre 52,0. Se il tuo lavoro dipende dal ragionamento più difficile disponibile, la frontiera resta un altro prodotto, e resta chiusa.
Non è economico per la sua taglia. Lo stesso riassunto di Artificial Analysis definisce Qwen3.8-27B «particolarmente costoso rispetto ad altri modelli a pesi aperti di dimensioni simili»: la mediana della sua classe è 0,05 dollari per milione di token in ingresso, contro gli 0,43 di Qwen. Stai pagando la capacità, non i parametri.
È verboso, e la verbosità è una fattura. Durante la valutazione dell'indice di intelligenza il 27B ha generato 160 milioni di token in uscita, contro una mediana di 45 milioni. Un utente gli ha dato un prompt di due parole su un Mac mini da 64 GB e lo ha guardato pensare per 17 minuti e 12 secondi. I modelli di ragionamento fatturano in tempo reale anche quando i token sono gratis.
Infine, i punteggi dei benchmark appartengono al modello in piena precisione. La build a 2 bit da 9,8 GB che sta nella tua scheda grafica non è il modello che ha ottenuto 52,0. La quantizzazione spinta costa accuratezza, soprattutto sui contesti lunghi. Ogni affermazione del tipo «gira su un portatile», compresa la nostra, porta con sé quell'asterisco.
Perché il ritardo dovrebbe continuare a ridursi
Da qui in poi è la nostra lettura, e segnaliamo chiaramente il passaggio: tutto quanto precede è misura, ciò che segue è inferenza.
Il meccanismo che spinge in basso il ritardo di rincorsa non è misterioso. Le tecniche di post-addestramento pubblicate alla frontiera vengono riprodotte nei laboratori aperti nel giro di mesi. Il controllo dello sforzo di ragionamento, un anno e mezzo fa trucco proprietario, compare oggi come parametro documentato su questa scheda di modello. La quantizzazione comunitaria finisce prima che la documentazione del laboratorio originale smetta di cambiare. Nessuno di questi tre anelli di retroazione ha motivo di rallentare, e due accelerano man mano che aumentano i partecipanti.
L'aspettativa ragionevole per la prossima generazione non è dunque che i modelli aperti superino la frontiera. È che quei 162 giorni continuino a comprimersi mentre la capacità assoluta cresce a entrambi gli estremi. Allora la soglia interessante non è più «i modelli aperti possono vincere», ma «quanto recente deve essere la frontiera perché la differenza smetta di contare per il mio compito». Per trascrizione di riunioni, traduzione, sintesi e gran parte del lavoro documentale, quella soglia è stata superata da tempo. Per la ricerca di punta e l'ingegneria agentica più difficile, no.
È un mondo molto migliore di quello del 2023, e vale la pena dirlo chiaramente. Il costo per dare a un computer una comprensione competente del linguaggio è calato di due ordini di grandezza in tre anni e continua a calare. A guadagnarci di più sono quelli che il prezzo teneva fuori: sviluppatori singoli, team in paesi dove 10 dollari per milione di token non sono un errore di arrotondamento, ricercatori con un finanziamento invece di un budget, e chiunque abbia bisogno che i dati restino sulla propria macchina per ragioni legali.
In conclusione: la frontiera ha smesso di essere un luogo ed è diventata una data
La vecchia domanda era a quale laboratorio hai accesso. La nuova è quanti mesi dietro la frontiera sei disposto a stare, dato che costa un nono e gira su hardware che è già tuo.
Per un numero crescente di lavori la risposta onesta è: circa cinque mesi, e in calo.
Dove si colloca Telli.sh: tutto quanto sopra è il motivo per cui costruiamo su modelli aperti anziché attorno a un singolo fornitore. Telli.sh usa già un modello Qwen aperto nel percorso di sintesi, così ogni gradino sceso lungo questa curva arriva come verbali migliori e non come un annuncio di aumento dei prezzi. Il nostro lavoro sta nella parte che nessun download ti dà: catturare un'ora di audio senza perdere colpi, tenere distinti i parlanti, tradurre in diretta in 15 lingue e trasformare tutto in note ancora ricercabili mesi dopo.
Fonti
- Scheda del modello Qwen3.8-27B e tabelle dei benchmark, Hugging Face — dati del confronto diretto con Opus 4.6 Max, consultato il 21 agosto 2026
- Artificial Analysis: analisi di intelligenza, prestazioni e prezzo di Qwen3.8 27B — indice di intelligenza 52,0, prezzo e verbosità, consultato il 21 agosto 2026
- Artificial Analysis: pagina del modello Claude Opus 4.6 — indice di intelligenza 44,9 al massimo sforzo di ragionamento, consultato il 21 agosto 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 marzo 2025 — scala dei prezzi a soglia fissa e intervallo da 9 a 900 volte l'anno
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 luglio 2023 — tabella 4, Llama 2 70B contro GPT-4
- Elenco file di TheBloke/Llama-2-70B-Chat-GGUF — build Q4_K_M da 41,4 GB, pubblicata il 4 settembre 2023
- Elenco file di unsloth/Qwen3.8-27B-GGUF — build da 16,5 GB e 9,8 GB, download consultati il 21 agosto 2026
- Catalogo modelli di OpenRouter — prezzi per token di Qwen3.8-27B, Claude Opus 4.6 e Claude Opus 5, consultato il 21 agosto 2026
- Discussione su Hacker News del rilascio di Qwen3.8-27B, 14 agosto 2026 — misure di throughput riportate su schede da 16 e 24 GB
- US Energy Information Administration, Electric Power Monthly, tabella 5.3 — 18,44 centesimi per kilowattora di media residenziale, maggio 2026
- La nostra copertura precedente del rilascio dei pesi aperti di Qwen3.8 e dell'ondata più ampia di pesi aperti
- Pagina di Wikimedia Commons della fotografia del Cray Y-MP
