Qwen3.8-27B open weights: dimensioni, Q4_K_M e velocità reali su 4090 e Mac
Qwen3.8-27B esce con licenza Apache 2.0. Il GGUF Q4_K_M pesa 17,1 GB e sta in un portatile da 32 GB; l'FP8 è 30,9 GB. Misurato: 48 token/s su RTX 4090, 12,75 su Mac mini M4 Pro.
Il 3 agosto l'account Qwen di Alibaba ha scritto che i pesi aperti sarebbero arrivati «la prossima settimana». È esattamente il tipo di frase che il settore dell'IA ha insegnato a tutti ad ascoltare con lo sconto. Dodici giorni dopo non resta niente da scontare: i pesi di Qwen3.8-Max, 2.400 miliardi di parametri, sono comparsi su Hugging Face il 12 agosto, e il modello piccolo — Qwen3.8-27B, sotto una semplice licenza Apache 2.0 — è seguito il 14.
Poi è successa la parte interessante. Nella stessa ora in cui Qwen finiva di pubblicare la scheda del 27B, tre diversi gruppi della comunità lo avevano già convertito in formati eseguibili su un computer personale. Due giorni dopo, quelle conversioni superavano il milione di download.
È questo numero la notizia, non la tabella dei benchmark. Un modello da 27 miliardi di parametri di uno dei migliori laboratori di IA al mondo è passato da «annunciato» a «in funzione su circa un milione di scrivanie» in una quarantottina di ore. Questo articolo spiega in parole semplici cosa significa davvero: cosa è uscito e con quale licenza, cosa serve per eseguire il 27B sull'hardware che avete già, quanta strada è stata fatta in tre anni e la parte che quasi nessuno racconta — cosa un 27B locale ancora non sa fare.
In breve:
- La promessa è stata mantenuta. Qwen3.8-Max (2.400 miliardi totali / 95 miliardi attivi) è arrivato il 12 agosto, Qwen3.8-27B il 14. Entrambi sono download veri, non anteprime ospitate.
- Le licenze sono diverse, e questa differenza pesa più dei punteggi. Il 27B è Apache 2.0: nessuna soglia, nessuna clausola, uso commerciale libero e senza debiti. Qwen3.8-Max esce con una licenza propria che prevede una soglia di fatturato per le attività di modello come servizio.
- È la dimensione a decidere chi può eseguire cosa: Max sono 4.892 GB da scaricare; il 27B compresso a 4 bit pesa 17,1 GB e sta su una macchina da 32 GB. Le versioni comunitarie a 4 bit hanno superato 1,07 milioni di download in due giorni.
Immagine: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Eseguire in proprio il modello di un laboratorio di frontiera significa che la macchina — e la sua manutenzione — diventano vostre.
La promessa aveva una data, e la data ha tenuto
Il 4 agosto avevamo raccontato l'annuncio scrivendo che l'attesa si misurava in «la prossima settimana», non in «un giorno o l'altro». Era il massimo che le prove consentivano allora. Si è chiusa in modo netto.
Qwen3.8-2.4T-A95B — commercializzato come Qwen3.8-Max — è comparso con il suo file di licenza il 12 agosto. Qwen3.8-27B e una variante FP8 ottimizzata sono arrivati il 14. Entrambe le date cadono dentro la finestra indicata da «la prossima settimana». In un settore in cui i modelli annunciati regolarmente non escono mai, un laboratorio che rispetta una scadenza verbale vecchia di nove giorni merita già una nota.
L'accoglienza è stata immediata e ampia. Il thread di Hacker News sul 27B ha raccolto 1.351 punti e 769 commenti in un giorno. Nel giro di ore, i professionisti pubblicavano configurazioni di deployment funzionanti per hardware specifico; qualcuno ha condiviso i setup sia per un NVIDIA DGX Spark sia per una scheda grafica consumer RTX 4090. Non è così che il settore trattava le uscite aperte due anni fa, quando far partire una nuova architettura era un progetto da fine settimana.
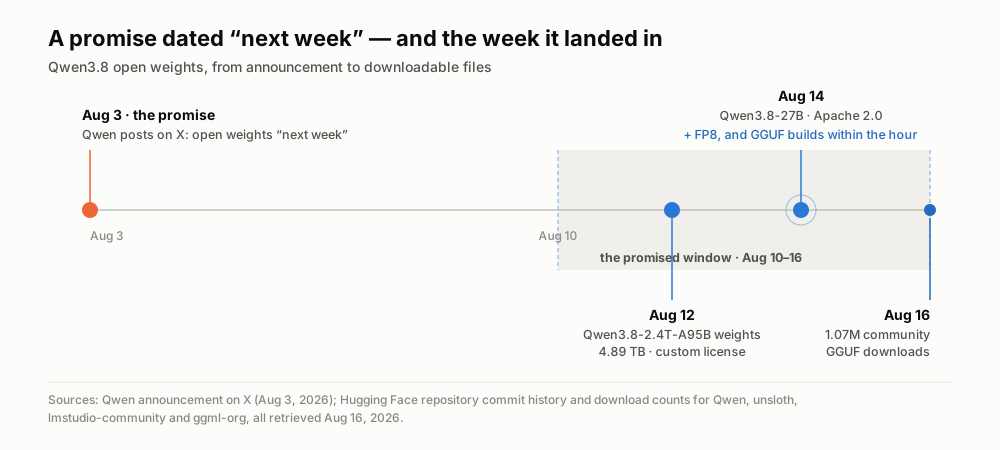
Una promessa con una data e le due consegne cadute al suo interno. Date dalla cronologia dei commit dei repository Hugging Face, consultata il 16 agosto 2026.
Cinque termini, tarati sulla domanda «riesco a farlo girare?»
Se arrivate dai nostri articoli precedenti sapete già cosa sono i pesi aperti: il laboratorio pubblica l'enorme griglia di numeri appresi che costituisce il modello finito, e voi potete scaricarla, eseguirla sul vostro hardware e costruirci sopra senza pagare a richiesta. Qui ci interessa la domanda successiva, del tutto pratica: quanto costa eseguirlo, in hardware?
I parametri sono quei numeri appresi, e il loro numero fissa la dimensione grezza del modello. La regola empirica è brutalmente semplice: alla precisione con cui i laboratori addestrano, ogni miliardo di parametri occupa circa 2 GB su disco, e serve grosso modo altrettanta memoria per tenere il modello mentre lavora. Quindi un modello da 27 miliardi di parametri è un download da 55 GB. Uno da 2.400 miliardi sfiora i 5 TB. Ecco perché uno è una questione da portatile e l'altro una questione da data center.
La quantizzazione colma quel divario ed è l'idea più utile per chi vuole eseguire modelli in casa. I parametri sono normalmente memorizzati a 16 bit di precisione. La quantizzazione li arrotonda a meno bit — 8, 4, a volte 2 — e il file si riduce all'incirca nella stessa proporzione. La quantizzazione a 4 bit trasforma quei 55 GB in circa 17 GB. Perdete un po' di accuratezza e guadagnate la possibilità di eseguirlo. GGUF è semplicemente il formato in cui queste versioni compresse vengono distribuite; è ciò che leggono strumenti come llama.cpp, Ollama e LM Studio. Quando vedete «Q4_K_M», leggetelo come «la build a 4 bit che usano quasi tutti».
Denso contro misto di esperti decide la velocità una volta che il modello ci sta. Qwen3.8-27B è denso: tutti i 27 miliardi di parametri si attivano per ogni parola prodotta. Qwen3.8-Max è un modello a misto di esperti: 2.400 miliardi di parametri in totale, ma un instradatore ne seleziona solo circa 95 miliardi per token, distribuiti su 512 sottoreti specializzate. Il totale vi dice il conto dello stoccaggio; il numero attivo vi dice il conto del calcolo. Questa distinzione ha un risvolto pratico affilato, e ci torneremo.
La finestra di contesto è quanto il modello riesce a considerare in una volta sola. Il 27B gestisce nativamente 262.144 token — una pila di verbali di riunioni da un'ora — ed è allungabile fino a un milione con una modifica di configurazione.
La licenza è la prima cosa da leggere
Ecco il risultato che regge tutto il resto, e va contro l'idea che una famiglia di modelli condivida una famiglia di condizioni.
Qwen3.8-27B è Apache 2.0. È l'estremo permissivo dello spettro: usatelo, modificatelo, mettetelo a punto, inseritelo in un prodotto commerciale, costruiteci sopra un'azienda, senza dovere nulla e senza chiedere a nessuno. Nessuna soglia di fatturato, nessun obbligo di mostrare il nome nell'interfaccia, nessuna esclusione d'uso.
Qwen3.8-Max no. Esce sotto una «Qwen3.8-Max License» propria che inizia come una MIT e poi aggiunge due condizioni. Se il vostro prodotto supera i 100 milioni di utenti attivi mensili o i 20 milioni di dollari di ricavi mensili, dovete mostrare il nome del modello nell'interfaccia. E se gestite un'attività di modello come servizio o di assistente di lavoro con IA i cui ricavi superano i 50 milioni di dollari in dodici mesi consecutivi, vi serve un accordo separato con Qwen prima di qualsiasi uso commerciale.
Per uno sviluppatore indipendente o per un'azienda che lo usi internamente, nulla di tutto questo morde. Ma è lo stesso asterisco che avevamo segnalato quando Kimi K3 è uscito con licenza propria anziché MIT, e la lezione si ripete: «pesi aperti» e «licenza aperta» sono due domande distinte, e un laboratorio può rispondervi diversamente per due modelli pubblicati a due giorni di distanza. Leggete la licenza prima di innamorarvi di un punteggio.
| Modello | Parametri totali | Attivi per token | Dimensione download | Licenza | Ambiente realistico |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2.400 mld | 95 mld | 4.892 GB | Propria, soglia di ricavi | Un cluster di acceleratori |
| Qwen3.8-Max, FP8 | 2.400 mld | 95 mld | 2.496 GB | Propria, soglia di ricavi | Un cluster di acceleratori |
| Qwen3.8-27B | 27 mld, denso | 27 mld | 55,6 GB | Apache 2.0 | Workstation multi-GPU |
| Qwen3.8-27B, FP8 | 27 mld, denso | 27 mld | 30,9 GB | Apache 2.0 | Una GPU di fascia alta |
| Qwen3.8-27B, Q4_K_M GGUF | 27 mld, denso | 27 mld | 17,1 GB | Apache 2.0 | Un portatile da 32 GB o una 4090 |
Cosa serve davvero per eseguire il 27B
La risposta onesta: meno di quanto pensiate, e più di quanto lascino intendere i titoli.
Il gradino più basso è un solo comando. Il 27B è nella libreria di Ollama; ollama run qwen3.8 scarica una build da 18 GB con finestra di contesto da 256K e input di immagini, tra dodici varianti, una delle quali ottimizzata per i chip Apple. LM Studio, che vi dà una finestra di chat invece di un terminale, aveva la sua build online pochi minuti dopo l'uscita. Nessuno dei due vi chiede di aver capito la sezione precedente.
Poi la realtà si presenta sotto forma di token al secondo. Le misure riportate dai professionisti nel thread dell'uscita cadono più o meno dove l'hardware fa prevedere. Su una RTX 4090 con la build a 4 bit, uno ha misurato circa 48 token al secondo — comodamente più veloce di quanto leggiate. Su un Mac mini M4 Pro con 64 GB di memoria, un altro ha ottenuto 12,75 token al secondo: utilizzabile, ma lo guardate scrivere. E su un portatile con AMD 7840U e 64 GB di normale DDR5, la stessa build a 4 bit ha reso circa 4 token al secondo: tecnicamente funziona, in pratica è un processo batch che avviate e lasciate lì.
Quest'ultima cifra è esattamente il punto in cui la distinzione denso/esperti si guadagna lo stipendio. La stessa persona ha misurato, sullo stesso portatile, un vecchio modello a misto di esperti nominalmente più grande a circa 20 token al secondo: cinque volte più veloce del modello denso più piccolo, perché per ogni parola si attiva solo una frazione dei parametri. Se cercate qualcosa da eseguire su CPU, il numero su cui confrontare sono i parametri attivi, non quelli totali. È la lezione meno intuitiva e più utile dell'IA locale.
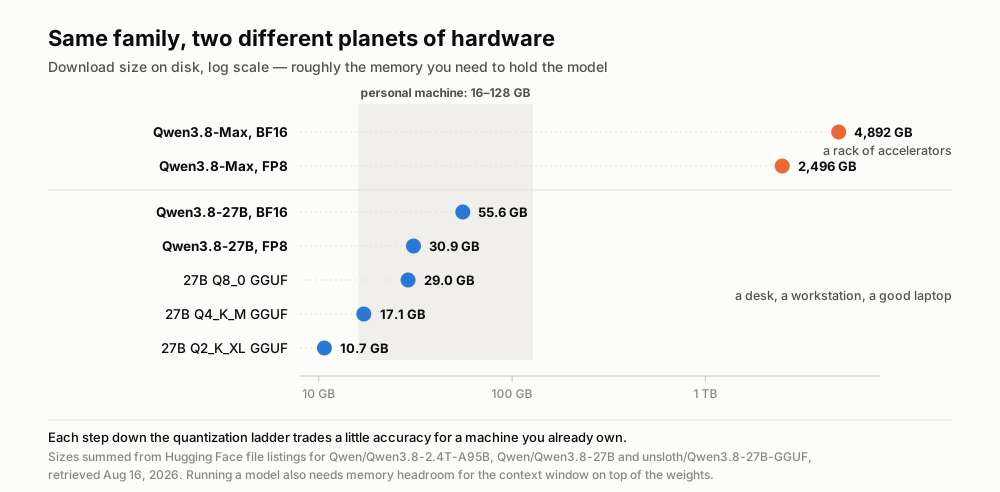
Due membri della stessa famiglia di modelli, separati da un fattore 290 nella dimensione del download. Dimensioni sommate dagli elenchi file di Hugging Face, consultati il 16 agosto 2026.
Tre anni fa servivano una fuga di dati e un fine settimana
Per cogliere il salto, mettetelo accanto al punto di partenza dei modelli locali.
Nel febbraio 2023 Meta distribuì i pesi del LLaMA originale solo a ricercatori approvati. Trapelarono nel giro di una settimana, e l'intera scena amatoriale dei modelli locali fu costruita su un file che nessuno avrebbe dovuto avere. Il 10 marzo 2023 uno sviluppatore pubblicò llama.cpp, un piccolo programma in C++ il cui numero da circo era far girare il modello da 7 miliardi di parametri su un MacBook. Quel repository ha oggi 124.000 stelle ed è l'antenato di praticamente ogni strumento di «esecuzione locale» usato oggi.
Confrontate i due giorni di rilascio. Nel 2023: un 7B trapelato, nessuna licenza degna di questo nome, una settimana di lavoro collettivo per farlo partire e un modello più interessante che utile. Nel 2026: un 27B di un laboratorio di frontiera, pubblicato deliberatamente sotto Apache 2.0, con input immagine e video, finestra di contesto da 262K e build della comunità completate prima che la documentazione del laboratorio smettesse di cambiare. Il primo commit della conversione di unsloth è delle 14:56 UTC del 14 agosto: quattro minuti prima dell'ultimo aggiornamento della scheda da parte di Qwen.
I numeri di adozione dicono la stessa cosa più bruscamente. Al 16 agosto, le build comunitarie a 4 bit del 27B contavano 867.963 download presso un editore, 171.518 presso un secondo e 34.520 presso un terzo: 1,07 milioni in due giorni. I repository ufficiali di Qwen per il 27B ne aggiungono altri 215.000. Qwen3.8-Max, modello ben più capace, si ferma a 17.126 sui suoi due repository.
Rileggete quel rapporto. Il modello di scala frontiera ha ricevuto circa l'1,6 % dell'attenzione andata a quello da portatile. Ciò che il mercato è andato a prendersi non è la capacità. È la portata.
Cosa un 27B locale ancora non sa fare
Ora la correzione, perché l'entusiasmo supera le prove in modi prevedibili.
La tabella di Alibaba mette il 27B davanti a Opus 4.6 Max su diverse misure di programmazione agentica e aderenza alle istruzioni — 61,7 contro 53,4 su SWE-bench Pro, 79,5 contro 62,5 su IFBench — e dietro su altre, incluso 30,8 contro 40,0 su HLE, che misura la cultura generale. Tutti questi numeri sono dichiarati dal produttore. Al momento in cui scriviamo, Artificial Analysis, il valutatore indipendente su cui ci appoggiamo, non ha alcuna voce per il 27B; classifica invece Qwen3.8-Max al 10° posto su 188 modelli con un punteggio di intelligenza di 58, che è ottimo ed è un altro modello.
I professionisti sono stati più affilati del foglio di calcolo. L'obiezione più votata del thread, di chi si dichiarava utente di lunga data di modelli aperti, era netta: questi non battono i migliori modelli ospitati nell'uso reale; sono «abbastanza buoni» per moltissimi compiti e girano su hardware abbordabile, che è un'affermazione diversa e più modesta. Un altro commento ha posto il tetto in termini fisici: non si può comprimere l'intera conoscenza umana in un file da 30 GB, quindi i modelli piccoli restano relativamente deboli nel recuperare fatti poco noti, per quanto affilati diventino nel codice o nell'uso di strumenti.
Ci sono altri due limiti che emergono solo eseguendolo. La quantizzazione non è gratis: un modello molto compresso tende a perdere il filo sui contesti lunghi e può cadere in cicli di ripetizione — per questo a chi ha memoria in eccesso si consiglia la versione a piena precisione. E questa generazione di Qwen ragiona molto per impostazione predefinita: un utente ha dato al 27B, su un Mac mini da 64 GB, le due parole «svg owl» e l'ha visto generare 21.769 token di ragionamento per 17 minuti e 12 secondi prima di rispondere. Il gufo è venuto bene. È venuto anche un conto in tempo reale che nessuna API ospitata avrebbe addebitato.
E poi c'è la voce che nessuno conteggia: l'esercizio adesso è vostro. Aggiornamenti del modello, scelta della quantizzazione, margine di memoria, versioni dei driver, la ventola della macchina. Quell'API ospitata che stavate evitando era anche una squadra di persone che teneva in piedi qualcosa.
In conclusione: il fossato si è spostato più in basso nello stack
Ecco il punto, ed è più grande di una singola uscita.
Un laboratorio di frontiera ha pubblicato un 27B capace di giovedì. Il sabato oltre un milione di copie di versioni compresse dalla comunità erano sulle macchine delle persone, era a un comando di distanza dentro Ollama ed era legalmente libero costruirci sopra un'attività. Qualunque vantaggio quel modello rappresenti, ci ha messo circa due giorni a diventare disponibile a tutti i concorrenti nello stesso momento. Chiamiamolo il fossato di due giorni: un vantaggio di modello con un'emivita di circa 48 ore.
Non è una previsione. È una misura, presa questa settimana, su questa uscita.
E ridefinisce cosa significhi costruire un prodotto di IA. Quando lo strato del modello è una merce che chiunque sostituisce in un pomeriggio, il modello smette di essere ciò su cui si compete. Sopravvive tutto ciò che gli sta attorno: l'affidabilità quando il server di inferenza cade alle tre di notte, le pipeline di dati che catturano, ripuliscono e recuperano il contesto giusto, la valutazione che vi dice se funziona sui vostri dati e non su quelli di un benchmark, un'interfaccia che qualcuno userà davvero e gli accordi di fiducia — riservatezza, conservazione, chi può vedere cosa — che decidono se qualcuno vi affiderà le proprie registrazioni di riunione.
Niente di tutto questo diventa merce in due giorni. Niente di tutto questo ha un pulsante di download.
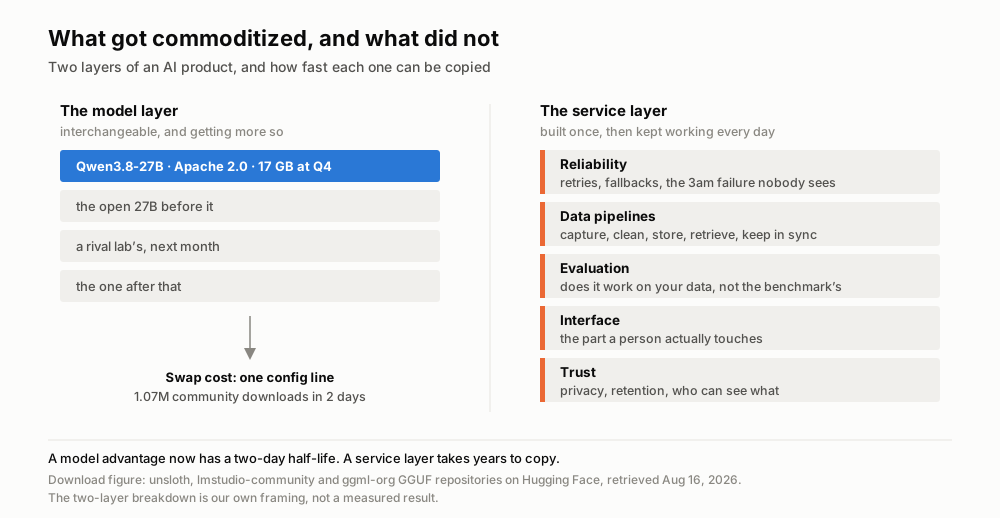
Lo strato diventato economico questa settimana e quello che non lo è. Cifre di download da Hugging Face, consultate il 16 agosto 2026; la divisione in due strati è nostra.
Quindi la reazione corretta all'arrivo di un ottimo modello aperto sui portatili non è «hanno vinto le aziende dei modelli» né «hanno perso quelle di prodotto». È che il lavoro interessante è sceso di un piano nello stack, dove è molto più difficile da copiare e molto meno divertente da titolare.
Dove si colloca Telli.sh: costruiamo esattamente quello strato di servizio, sopra modelli aperti. Telli.sh usa già un modello Qwen aperto nel percorso di sintesi, il che significa che ogni salto di qualità dei modelli aperti — questo compreso — confluisce direttamente in trascrizione, traduzione e riassunti delle riunioni, senza variazioni di prezzo dalla vostra parte. Il nostro tempo va nella parte che non arriva dentro un file GGUF: catturare l'audio in modo affidabile, non confondere gli interlocutori, trasformare una registrazione di 60 minuti in note che ritroverete mesi dopo ed essere chiari su dove risiedono i vostri dati.
Fonti
- Scheda e licenza di Qwen3.8-27B, Hugging Face
- Scheda e licenza di Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: build quantizzate e contatori di download
- Qwen3.8 nella libreria di modelli di Ollama
- Discussione su Hacker News dell'uscita di Qwen3.8-27B (14 agosto 2026)
- Pagina del modello Qwen3.8 Max su Artificial Analysis
- Annuncio dei pesi aperti di Qwen (@Alibaba_Qwen) su X (3 agosto 2026)
- Repository llama.cpp, creato il 10 marzo 2023
- Pagina dell'immagine su Wikimedia Commons
