Lo sprint open-weight cinese in tre settimane: Kimi K3, Qwen3.8-Max e la svolta che potrebbe fermare tutto
In tre settimane i maggiori laboratori di IA cinesi hanno pubblicato o annunciato modelli open-weight di frontiera — Kimi K3, Qwen3.8-Max e DeepSeek V4 in disponibilità generale. Una guida in linguaggio semplice: cos'è ciascun modello, cosa è uscito davvero e cosa resta una promessa, e perché Pechino potrebbe ora limitare l'ondata che ha innescato.
Tra il 16 e il 26 luglio, tre dei maggiori laboratori di IA cinesi hanno messo sul tavolo modelli aperti di livello frontiera. Moonshot AI ha annunciato Kimi K3 il 16 luglio e pubblicato i pesi il 26 luglio. Alibaba ha svelato Qwen3.8-Max il 19 luglio alla WAIC di Shanghai. La linea V4 di DeepSeek ha raggiunto la disponibilità generale (GA) intorno al 20 luglio. Tre laboratori, circa tre settimane.
Lo schema è difficile da ignorare, e non è quello con cui la scena cinese dei modelli aperti si è costruita la reputazione. Questi laboratori erano noti per modelli piccoli, veloci ed economici, che colpivano oltre la loro categoria. Quest'ondata è la scommessa opposta: sistemi da migliaia di miliardi di parametri, pubblicati o promessi come pesi aperti.
Questa è una lettura onesta di quell'ondata: cosa è uscito davvero, cosa resta un'anteprima o una promessa, e la svolta arrivata con essa — lo stesso governo che ha reso possibili questi rilasci sta ora valutando se limitarli. Terremo il gergo al minimo e spiegheremo il resto strada facendo, così potrai seguire la storia anche se «pesi aperti» e «mixture-of-experts» ti sono nuovi. Se hai letto la nostra panoramica di luglio, questo è il seguito, e uno dei suoi fili in sospeso si è sciolto.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Prima, le cinque idee che rendono tutto comprensibile
Se sei nuovo in questo angolo dell'IA, cinque termini reggono gran parte della storia, e vale la pena dedicare loro un minuto in linguaggio semplice prima di arrivare ai modelli.
I «pesi aperti» (open weights) sono l'intera ragione per cui quest'ondata conta. I pesi di un modello sono l'enorme griglia di numeri che ha imparato durante l'addestramento — di fatto, il cervello finito. Quando un laboratorio rilascia i pesi, puoi scaricare quel file, far girare il modello sul tuo hardware, adattarlo e costruirci prodotti sopra senza chiedere il permesso a nessuno né pagare a richiesta. L'alternativa è un modello chiuso, come la maggior parte dei chatbot commerciali, dove i pesi restano bloccati sui server del fornitore e tu affitti l'accesso tramite un'API a pagamento. I pesi aperti trasformano un modello da servizio che noleggi a qualcosa di cui possiedi una copia, e questa differenza è il motivo per cui un intero settore drizza le orecchie quando ne esce uno buono.
I «parametri» sono quei numeri appresi, e la loro quantità è l'indicatore approssimativo di quanto un modello può contenere. Un modello da «2,8 trilioni di parametri» ne ha 2,8 trilioni. Più grande non è automaticamente meglio, ma alla frontiera di solito significa più spazio per ragionare — e, altrettanto importante, più hardware per farlo girare. Qui entra il «mixture-of-experts» (MoE). Invece di attivare tutti i parametri per ogni parola, un modello MoE è suddiviso in molte sottoreti specializzate chiamate esperti, e un router ne sceglie solo una manciata per ogni token. Così, quando leggi «2,8 trilioni totali, 104 miliardi attivi», significa che il modello è enorme ma solo circa 104 miliardi di parametri lavorano in un dato istante — come un ospedale con migliaia di specialisti in cui ogni paziente è visto solo dai pochi pertinenti. Il totale suggerisce quanto possa essere capace; il numero attivo dice quanto costa servirlo. Questo divario è il singolo numero più utile per giudicare il costo.
Una «finestra di contesto» è quanto testo il modello può tenere in mente in una volta, contato in token — e un token vale circa tre quarti di parola. Una finestra da un milione di token non è una specifica astratta: sono diversi romanzi lunghi, o decine di trascrizioni di riunioni di un'ora, in un'unica passata. È la differenza tra riassumere una singola email e ragionare su un intero trimestre di email.
Infine la licenza — ed è la parte che i professionisti dovrebbero leggere per prima, prima dei benchmark. La licenza è la clausola legale in caratteri piccoli che dice cosa puoi fare con i pesi. MIT è lo standard aureo: usala, modificala, mettila in un prodotto commerciale, non devi nulla. Una licenza personalizzata può sembrare aperta ma escludere proprio l'uso che avevi in mente — per esempio addebitandoti qualcosa quando l'attività che ci hai costruito sopra diventa grande. Due modelli possono essere entrambi «pesi aperti» ed essere a mondi di distanza su ciò che è legalmente consentito. Conviene quindi leggere questa riga prima di innamorarti di un punteggio. Con queste cinque idee in mano, l'ondata si legge con chiarezza.
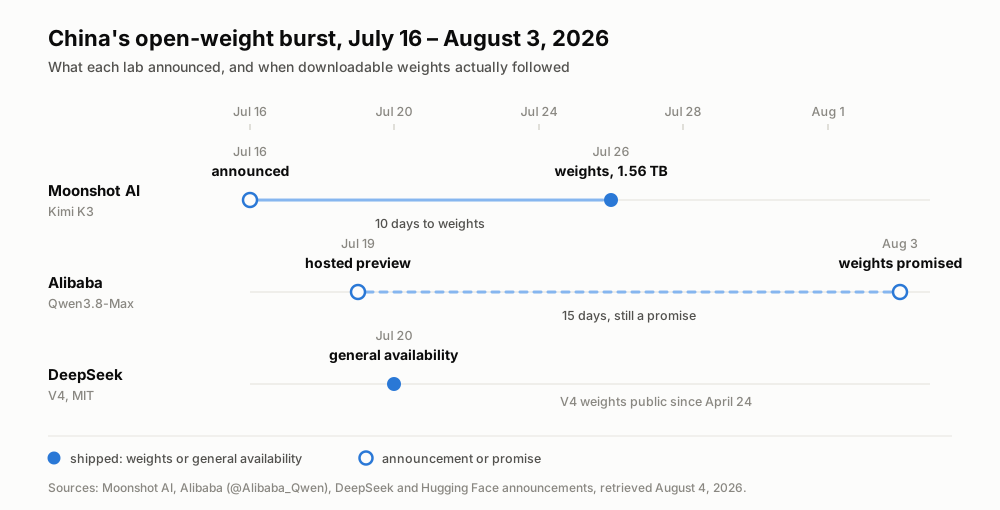
Tre laboratori, tre settimane — e di questi cinque momenti solo due hanno davvero messo i pesi nelle mani di qualcuno. Date dagli annunci dei laboratori, consultate il 4 agosto 2026.
Kimi K3 è quello uscito davvero
Partiamo da Moonshot AI, il laboratorio di Pechino dietro l'assistente Kimi, che nell'ultimo anno si è costruito una reputazione con modelli aperti grandi e capaci. Quando abbiamo scritto di Kimi K3 a luglio, i pesi erano solo una promessa — Moonshot aveva detto «entro il 27 luglio». Sono arrivati il 26 luglio: 1,56 terabyte suddivisi in 96 frammenti su Hugging Face, sotto moonshotai/Kimi-K3. Questa è la notizia. Un annuncio è un comunicato stampa; dei pesi scaricabili sono un fatto su cui costruire.
In parole semplici, K3 è uno dei più grandi modelli aperti mai pubblicati — un sistema mixture-of-experts con 2,8 trilioni di parametri totali e circa 104 miliardi attivi per token, che instrada all'incirca 16 esperti su 896 tramite un meccanismo che Moonshot chiama Kimi Delta Attention, con una finestra di contesto da un milione di token e un guadagno di efficienza di scaling dichiarato di circa 2,5x rispetto al predecessore K2. Tradotto dalla scheda tecnica: è molto grande, relativamente economico da far girare per la sua taglia perché solo una fetta si attiva per token, e capace di ingoiare in un colpo solo input lunghi come un libro.
Questi numeri dicono anche chi lo farà girare davvero. 1,56 terabyte in 96 frammenti non è un download da portatile; è un artefatto di classe datacenter che richiede un cluster di acceleratori di fascia alta solo per essere caricato. In pratica quasi nessun individuo ospiterà K3 da sé — lo raggiungerà tramite provider che hanno già l'hardware, e quel mercato è arrivato il primo giorno: Together AI e Modal hanno attivato endpoint ospitati di Kimi K3 nell'istante in cui i pesi sono atterrati. È anche così che un lettore curioso lo prova oggi — non scaricando 1,56 TB, ma chiamando uno di quegli endpoint ospitati o usando l'app Kimi. «Aperto» qui significa che i pesi sono pubblici e chiunque abbia l'hardware può servirli, che è proprio ciò che mantiene la concorrenza sui prezzi; non significa che lo farai girare personalmente sulla tua scrivania.
È buono? Secondo l'unico numero indipendente di cui ci fidiamo questo giro, sì. Nella classifica di Artificial Analysis si è piazzato 4° su 189 modelli — dietro Claude Fable 5 e due configurazioni GPT-5.6 «Sol», davanti a Opus 4.8 e GPT-5.5. Per un modello aperto che puoi scaricare, stare in quella compagnia è già di per sé la storia.
Poi leggi la licenza, perché è qui che «aperto» prende un asterisco. Kimi K3 non è MIT. Esce con una licenza propria, la «Kimi K3 License», non approvata dall'OSI e con una clausola di soglia di ricavi: usare K3 come motore di un grande servizio Model-as-a-Service richiede un accordo separato con Moonshot. Per uno sviluppatore solo, o un'azienda normale che lo usa internamente, non cambia nulla. Ma per chi costruisce un prodotto ospitato su larga scala, «pesi aperti» e «licenza aperta» sono due domande diverse — e qui solo la prima è un sì inequivocabile.
Qwen3.8-Max è un'anteprima, non un download
Qwen è la famiglia di modelli di Alibaba, e il suo team è tra i più prolifici al mondo nel pubblicare modelli aperti — ed è proprio questa storia a rendere confuso l'ultimo arrivato. Presentato il 19 luglio alla WAIC di Shanghai, Qwen3.8-Max è il titolo più grande dell'ondata, e anche il più tenero. È un MoE sparso da 2,4 trilioni di parametri — parametri attivi non divulgati — e il primo Qwen oltre il trilione di parametri a essere multimodale, ovvero a prendere in input non solo testo ma anche immagini, video e documenti.
Ecco la trappola che a un principiante va messa nero su bianco: nonostante la fanfara, non puoi scaricarlo. Al momento esiste solo come «anteprima ospitata» — qwen3.8-max-preview, raggiungibile tramite il servizio di Alibaba stessa (il suo Token Plan e lo strumento Qoder) a circa il 10 % del prezzo standard. Un'anteprima ospitata significa che Alibaba fa girare il modello sui suoi server e ti lascia chiamarlo; è il modello ad API noleggiata, non quello di cui possiedi una copia. Chiamarlo oggi un rilascio open-weight è prematuro.
Questo quadro è cambiato il 3 agosto. L'account ufficiale Qwen su X, @Alibaba_Qwen, ha pubblicato che i pesi aperti di Qwen3.8-Max sarebbero arrivati «la prossima settimana» — e che un Qwen3.8-27B più piccolo sarebbe passato anch'esso a pesi aperti. Quindi il 27B non è una voce, qualunque cosa lasciassero intendere le chiacchiere precedenti: è un impegno messo nero su bianco dall'account stesso di Alibaba. E la dimensione è il punto. Laddove il Max da 2,4 trilioni di parametri, come K3, è qualcosa che solo un datacenter fa girare, un 27B è abbastanza piccolo da essere servito su una singola macchina di fascia alta — la categoria che un individuo o un piccolo team può davvero ospitare in proprio. Questo ammorbidisce davvero l'immagine del «promesso senza specifiche»: ora c'è una dimensione e un orizzonte di massima.
Le avvertenze oneste restano valide, però. «La prossima settimana» è una direzione, non una data di spedizione, e mentre scriviamo, il 4 agosto, nulla è comparso nell'organizzazione Qwen su Hugging Face — i suoi modelli più recenti lì risalgono a giugno. Nemmeno la licenza open-weight è stata pubblicata, e i primi lettori dei termini dell'anteprima hanno segnalato possibili restrizioni regionali, non confermate finché non compare la licenza vera — esattamente la lezione del «prima la licenza» dell'abbicì. L'affermazione di Alibaba secondo cui il modello sarebbe «secondo solo a Fable 5» resta un dato dichiarato dall'azienda senza numeri di terzi, quindi trattalo come lo slogan di marketing di un fornitore finché qualcuno fuori da Alibaba non lo misura. Se vuoi provare il modello oggi, l'anteprima ospitata è l'unica porta — ma per la prima volta, l'attesa per pesi scaricabili si misura in «la prossima settimana», non in «un giorno».
DeepSeek V4 ha raggiunto la disponibilità generale in silenzio
DeepSeek è il laboratorio il cui modello R1 ha contribuito ad accendere l'attuale corsa ai modelli aperti a inizio 2025 e, fedele a se stesso, qui ha annunciato di meno consegnando la cosa più utilizzabile. La sua linea V4, pubblicata già il 24 aprile, è quella che si può adottare nel modo più diretto, perché arriva sotto la licenza che l'abbicì ha indicato come standard aureo.
V4 arriva in due taglie, entrambe con licenza MIT. V4-Pro è l'ammiraglia con 1,6 trilioni totali e 49 miliardi di parametri attivi; V4-Flash è il peso leggero con 284 miliardi totali e 13 miliardi attivi. Ricorda cosa significa il numero attivo: V4-Flash attiva solo 13 miliardi di parametri per token, il che lo rende economico e veloce da servire, ed è ciò che ne fa la scelta di budget per il lavoro ad alto volume — quel tipo di carico «trascrivi e riassumi» in cui il costo per token decide tutto. Entrambi hanno una finestra di contesto da un milione di token e possono produrre fino a 384K token di output in una singola risposta, abbastanza da abbozzare un lungo report, non solo un paragrafo. Intorno al 20 luglio, V4 ha raggiunto la disponibilità generale con un prezzo a tempo, il che ha portato un rilascio primaverile nella stessa cornice di tre settimane di K3 e Qwen.
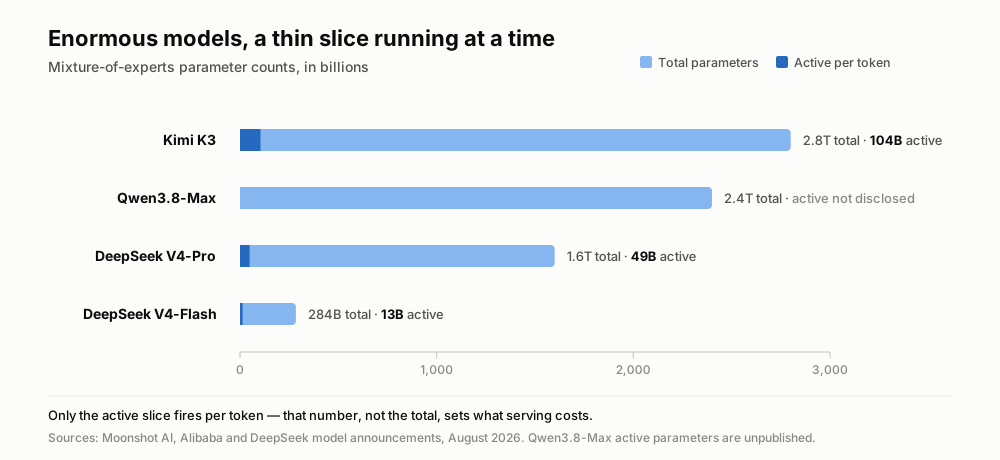
La barra chiara è quanto è grande il modello; il tratto scuro è quanto si accende a ogni token. Alibaba non ha reso noti i parametri attivi di Qwen3.8-Max.
Poiché è MIT, V4 è quello su cui un adottante può costruire con meno avvocati possibili: procurati i pesi (o usa un provider ospitato), fallo girare, spediscilo in commerciale, non devi nulla e non chiedi a nessuno. E per essere chiari sui numeri di versione, dato che la fabbrica delle voci li adora — non c'è nessun R2, nessun V5, nessun V4.1. C'è solo la famiglia V4 che matura in qualcosa su cui i team possono fare affidamento.
Il divario si chiude più in fretta di quanto ammettano le classifiche
Facendo un passo indietro, la pendenza conta più dei singoli rilasci. La lettura di Nathan Lambert è che la distanza tra i migliori modelli aperti e i migliori chiusi si sia compressa da circa sei-nove mesi a tre-cinque — «i modelli aperti non sono mai stati così vicini alla frontiera dai tempi di DeepSeek R1». In parole povere: i modelli liberamente scaricabili sono ora solo a qualche mese dai migliori modelli che si possono noleggiare, dove un anno fa erano un giro comodo indietro.
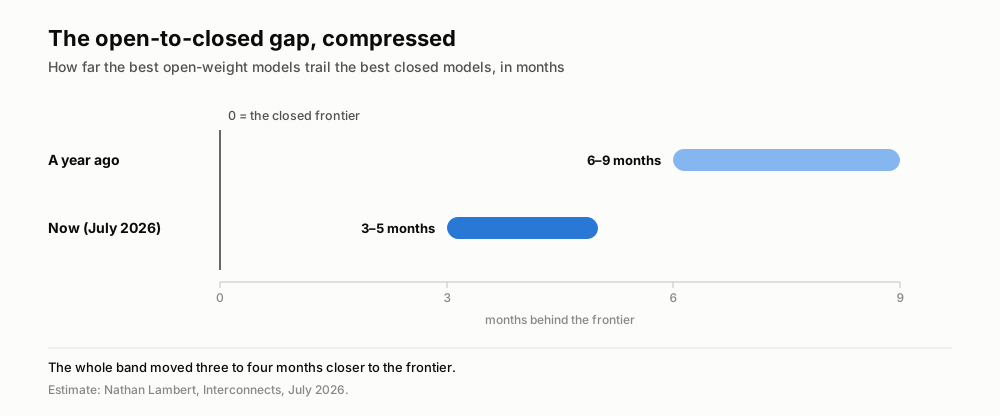
La stima di Lambert disegnata in scala: il fronte aperto non si è solo avvicinato, l'intera fascia si è stretta.
I dati d'uso vanno nella stessa direzione. Su OpenRouter, un marketplace che smista le richieste tra molti modelli, la quota di token dei modelli di origine statunitense è scesa da circa il 70 % di giugno 2025 a circa il 30 % un anno dopo, mentre i modelli di origine cinese superano ormai regolarmente il 30 %. Il prezzo pesa molto: i modelli aperti cinesi costano di solito dal 60 al 90 % in meno per token, e l'hosting è comparso subito, come hanno reso evidente quegli endpoint K3 al giorno zero.
Il cambiamento più silenzioso riguarda la scala. Il marchio del modello aperto cinese era piccolo, veloce, economico. K3 con 2,8 trilioni di parametri e Qwen3.8-Max con 2,4 trilioni sono esattamente l'opposto — una scommessa sul fatto che ora puntare in grande nell'aperto convenga. GLM-5.2 di Z.ai, pubblicato il 16 giugno sotto MIT e in testa alla categoria open-weight dell'Artificial Analysis Index con 51, è lo stesso messaggio da un quarto laboratorio.
La svolta: il governo che l'ha reso possibile potrebbe limitarlo
Poi il vento è cambiato. Intorno al 22-25 luglio, il Financial Times e Reuters hanno riferito che il Ministero del Commercio cinese sta valutando controlli sulle esportazioni dei modelli di IA — inclusi gli LLM open-weight — con Alibaba, ByteDance e Z.ai presumibilmente coinvolti nelle trattative. Il quadro ipotizzato è a livelli: un obbligo di notifica per i modelli più deboli, una revisione di sicurezza per quelli più forti e un possibile divieto di pubblicazione aperta per i più capaci. Nulla è ancora legge. Ma la direzione è sorprendente: l'ondata potrebbe toccare l'apice proprio nel momento in cui il suo stesso governo comincia a trattare questi modelli come esportazioni strategiche anziché come contributi aperti.
In sintesi: quando l'aperto diventa un asset strategico
La storia comoda dice «la Cina ha recuperato». Quella più accurata dice che i pesi aperti sono diventati un asset strategico così in fretta che un governo vuole ora la mano sul rubinetto. In tre settimane, i modelli aperti sono passati dall'essere due o tre trimestri dietro la frontiera a uno solo — e da piccoli ed economici a essere tra i modelli più grandi mai pubblicati, in qualunque forma. La frontiera aperta non si è solo spostata. Si è spostata in un luogo da cui i suoi creatori potrebbero non essere liberi di continuare a spedire.
Per i team che costruiscono su questi modelli, la conclusione pratica non cambia e si fa un po' più tagliente. Telli.sh usa già un modello aperto, Qwen3, nel suo livello di sintesi, così ogni miglioramento in qualità e prezzo dei modelli aperti confluisce dritto nella trascrizione, nella traduzione e nei riassunti delle riunioni. La voce nuova è l'approvvigionamento: se le regole cinesi sull'export prendono la forma suggerita dalle cronache, quali modelli aperti resteranno liberamente scaricabili è qualcosa da monitorare più che da dare per scontato. Che migliorino i modelli che alimentano quel livello è la tendenza; da dove a quei modelli è concesso arrivare è ciò da tenere d'occhio.
Fonti
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
