Berkas 16,5 GB kini mengungguli model tertutup terbaik bulan Februari
Tiga tahun lalu, model terbaik yang bisa diunduh kalah 37 poin dari GPT-4 di HumanEval dan butuh dua kartu grafis untuk berjalan. Pekan lalu sebuah model bobot terbuka 27B mencetak 52,0 pada indeks kecerdasan Artificial Analysis, sementara Claude Opus 4.6 Max di 44,9 — dengan sepersembilan harga, dari berkas 16,5 GB. Perbandingan sebelum dan sesudah lengkap dengan tabel tolok ukur, kurva harga, dan arti jeda mengejar yang menyusut ke 162 hari.
Seseorang di Hacker News sedang menjalankan model bahasa kelas terdepan pada kartu grafis bermemori 16 GB, di angka 50 sampai 60 token per detik, dengan jendela konteks 128.000 token. Modelnya Qwen3.8-27B, dirilis 14 Agustus 2026. Pada indeks kecerdasan Artificial Analysis ia mencetak 52,0 — lebih tinggi daripada Claude Opus 4.6 Max, yang sampai Februari masih model proprietari terbaik di pasar, dengan 44,9.
Di tahun 2023, kalimat itu adalah fiksi ilmiah. Dan bukan yang menyenangkan.
Tulisan ini adalah perbandingan sebelum dan sesudah. Bukan liputan perilisannya — itu sudah kami tulis — melainkan pembandingan lintas tiga tahun: berapa skor model terbaik yang bisa diunduh melawan garis depan dulu dan sekarang, berapa biaya membeli tingkat kecerdasan tertentu dulu dan sekarang, serta perangkat keras apa yang harus dimiliki untuk menjalankannya sendiri. Setiap angka di bawah punya sumber dan tanggal. Tren yang mereka gambarkan termasuk hal paling jujur-jujur optimistis yang sedang terjadi di dunia perangkat lunak.
Ringkasan:
- Jaraknya menutup, dan kami bisa memberi tanggalnya. Juli 2023 model terbuka terbaik kalah 17,5 poin di MMLU dan 37,1 poin di HumanEval dari GPT-4. Agustus 2026, sebuah 27B terbuka mengalahkan kapal induk proprietari bulan Februari pada 15 dari 19 tolok ukur yang dipublikasikan keduanya, dan juga pada indeks gabungan independen.
- Harga turun sekitar 208 kali lipat dalam 23 bulan, menurut pengukuran Epoch AI pada ambang kemampuan tetap. Model 27B terbuka kini seharga 1,09 dolar per juta token dalam tarif campuran, melawan 10,00 dolar Opus 4.6 Max — dan nol per token bila dijalankan sendiri.
- Ini bukan garis depan, dan kami mengatakannya. Claude Opus 5 Max mencetak 63,1 dan GPT-5.6 Sol Max 60,9. Pada penalaran berbasis pengetahuan luas, 27B kalah cukup jauh dari Opus 4.6: 30,8 lawan 40,0 di HLE.
Gambar: Steve Jurvetson, Wikimedia Commons, CC BY 2.0. Interkoneksi sebuah Cray Y-MP, sekitar 1988. Komputasi serius dulu berupa ruangan yang harus dimasuki.
Seperti apa «sebelumnya» itu sebenarnya
Putar jam ke 18 Juli 2023, hari Meta merilis Llama 2. Ia model paling baik yang bisa diunduh bebas di dunia, dan makalahnya sendiri mencetak papan skor melawan garis depan tertutup tanpa berkelit.
Llama 2 70B mencetak 68,9 di MMLU melawan 86,4 milik GPT-4. Di GSM8K, 56,8 lawan 92,0. Di HumanEval, tolok ukur pemrograman, 29,9 lawan 67,0 — kurang dari separuh. Ringkasan makalahnya sendiri berbunyi: «Masih terdapat jurang kinerja yang lebar antara Llama 2 70B dengan GPT-4 dan PaLM-2-L.» Itulah kapal induk bobot terbuka pada 2023, dengan kata-katanya sendiri.
Sekarang perangkat kerasnya. Build komunitas 4 bit dari TheBloke — cara orang benar-benar menjalankan Llama 2 70B — berupa berkas 41,4 GB yang terbit 4 September 2023. Agar kecepatannya layak pakai, Anda butuh dua kartu grafis 24 GB atau Mac 64 GB. Model yang benar-benar muat di laptop biasa adalah Llama 2 13B: berkas 7,9 GB dengan skor MMLU 54,8, tertinggal 31,6 poin dari GPT-4, dan nyaris tak berguna di luar demo.
Jadi tawaran tahun 2023 begini: bayar laboratorium garis depan, atau jalankan sesuatu yang jelas lebih buruk di perangkat keras yang kebanyakan orang tidak punya. Persis karena itulah argumen «pakai API saja» menang telak selama dua tahun. Argumen itu benar.
Sekarang ajukan pertanyaan yang sama untuk Agustus 2026
Alibaba merilis Qwen3.8-27B pada 14 Agustus 2026 di bawah Apache 2.0, lengkap dengan tabel perbandingan langsung melawan Claude Opus 4.6 Max di kartu modelnya. Kami menghitung setiap baris yang memuat angka dari kedua model.
Qwen3.8-27B memenangi 15 dari 19 baris itu dan kalah di 4 baris. Kemenangannya mencakup SWE-bench Pro (61,7 lawan 53,4), kepatuhan instruksi di IFBench (79,5 lawan 62,5), pemrograman kompetitif di LiveCodeBench v6 (90,3 lawan 88,8), pengendalian komputer di OSWorld-Verified (84,3 lawan 72,7), tugas agen ponsel di AndroidWorld (81,9 lawan 62,0), serta deretan panjang tolok ukur multimodal yang selisihnya sama sekali tidak tipis: 90,0 lawan 65,5 di MathVision, 83,7 lawan 66,0 pada analisis grafik di CharXiv, 65,5 lawan 40,8 pada penalaran terwujud di ERQA.
Empat kekalahannya lebih penting daripada kemenangannya, karena menunjukkan apa yang masih belum bisa dilakukan model berparameter 27 miliar. Ia kalah di Terminal Bench 2.1 (73,0 lawan 78,2), pada pembuatan kode berskala repositori di NL2Repo-Bench (42,3 lawan 47,6), tipis di GPQA Diamond (89,2 lawan 91,3), dan telak di HLE, tolok ukur penalaran lintas disiplin yang luas: 30,8 lawan 40,0. Angka terakhir itulah bentuk dari seluruh keterbatasannya. Pengetahuan dunia tidak bisa dimampatkan ke berkas 16,5 GB; keterampilan dalam jumlah luar biasa, bisa.
Satu baris pantas diberi tanda bintang: hasil 79,0 lawan 63,8 berasal dari QwenSWEBench, tolok ukur yang dibuat Qwen sendiri. Vendor yang menguji dirinya pada tolok ukur buatannya sendiri adalah bukti terlemah dalam kartu model mana pun, dan kami tidak mengandalkannya.
Papan skor independen mengatakan hal yang sama
Tabel vendor tetaplah tabel vendor, jadi mari lihat pihak ketiga. Artificial Analysis, yang menjalankan evaluasinya sendiri alih-alih mencetak ulang angka orang lain, kini telah mengukur 27B tersebut. Per 21 Agustus 2026 mereka memberi Qwen3.8-27B indeks kecerdasan 52,0, peringkat pertama dari 135 model di kelas bobot terbuka 4 sampai 40 miliar parameter, melawan 44,9 milik Claude Opus 4.6 Max. Itu selisih 7,1 poin untuk model terbuka, diukur pihak yang tak berkepentingan atas hasilnya, 190 hari setelah Opus 4.6 dirilis.
Runut perbandingan itu mundur dan di situlah ceritanya. Juli 2023, model terbuka terbaik di bawah 40 miliar parameter mencetak 2,6 pada indeks yang sama. Juli 2024, 7,4. Maret 2025, 13,4. Februari 2026, 34,6. Pekan lalu, 52,0.
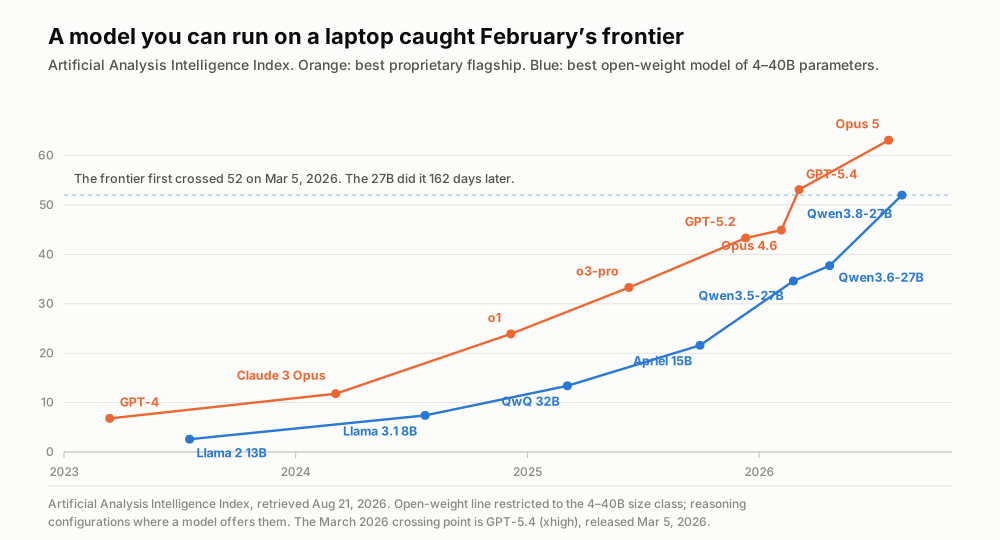
Kedua garis menanjak; yang menarik adalah jarak mendatar di antaranya. Indeks kecerdasan Artificial Analysis, diambil 21 Agustus 2026.
Inilah angka yang layak diberi nama. Garis depan pertama kali melewati indeks 52 pada 5 Maret 2026, ketika GPT-5.4 pada tingkat penalaran tertinggi mencetak 53,1. Model yang cukup kecil untuk berjalan di mesin pribadi sampai ke sana pada 14 Agustus — 162 hari kemudian. Sebut saja jeda mengejar: rentang antara munculnya suatu kemampuan di garis depan dan munculnya kemampuan itu di perangkat keras Anda sendiri.
Jeda itu dulu jauh lebih panjang. Llama 3.1 8B butuh 260 hari untuk mencapai level yang sudah disentuh GPT-4 Turbo. GLM-4.7-Flash butuh 410 hari untuk menyamai o1. Tiga rilis berukuran laptop terakhir tercatat 201, 155, dan 162 hari. Garis depan tidak melambat — Opus 5 Max hari ini di 63,1 — tetapi tepi pengejarnya mendekat sekitar dua kali lebih cepat dibanding dua tahun lalu.
Harga tidak turun, tetapi runtuh
Kemampuan hanyalah separuh dari perbandingan ini. Separuh lainnya adalah tagihan.
Epoch AI menerbitkan pengukuran paling bersih soal ini pada Maret 2025, dan metodenya layak dipahami: kunci satu skor tolok ukur, lalu telusuri dari waktu ke waktu model termurah yang mencapainya. Kunci ambangnya di skor MMLU 86 milik GPT-4 dan tangganya berbunyi 37,50 dolar per juta token pada Maret 2023, 15,00 pada November 2023, 7,50 pada Mei 2024, 2,19 di bulan yang sama, dan 0,18 pada Februari 2025. Skornya sama persis. 208 kali lebih murah dalam 23 bulan.
Temuan utama Epoch adalah lajunya sangat bervariasi menurut jenis tugas — antara 9 sampai 900 kali per tahun tergantung kemampuan yang dikunci — dengan harga kinerja setara GPT-4 pada soal sains tingkat doktoral turun kira-kira 40 kali per tahun. Arahnya tak pernah berubah.
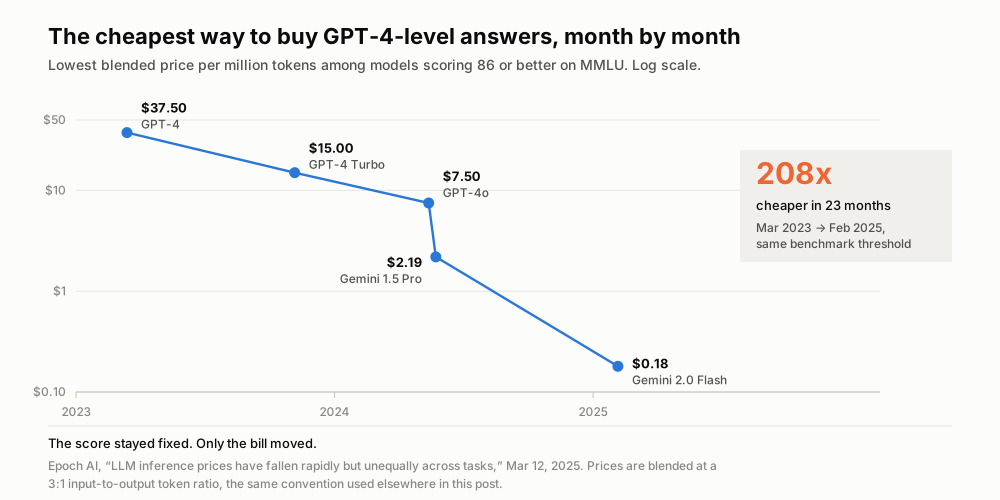
Skor tolok ukurnya konstan di setiap titik garis ini. Epoch AI, 12 Maret 2025.
Perpanjang deret itu sampai harga hari ini dan gerakannya berlanjut. Di katalog OpenRouter per 21 Agustus 2026, Qwen3.8-27B berharga 0,45 dolar per juta token masukan dan 3,20 per juta token keluaran; Claude Opus 4.6 berharga 5,00 dan 25,00. Dicampur dengan rasio 3 banding 1 seperti yang dipakai Epoch, hasilnya 1,09 lawan 10,00 dolar — model terbuka itu 9,1 kali lebih murah dan 7,1 poin indeks lebih baik daripada kapal induk tertutup enam bulan lalu.
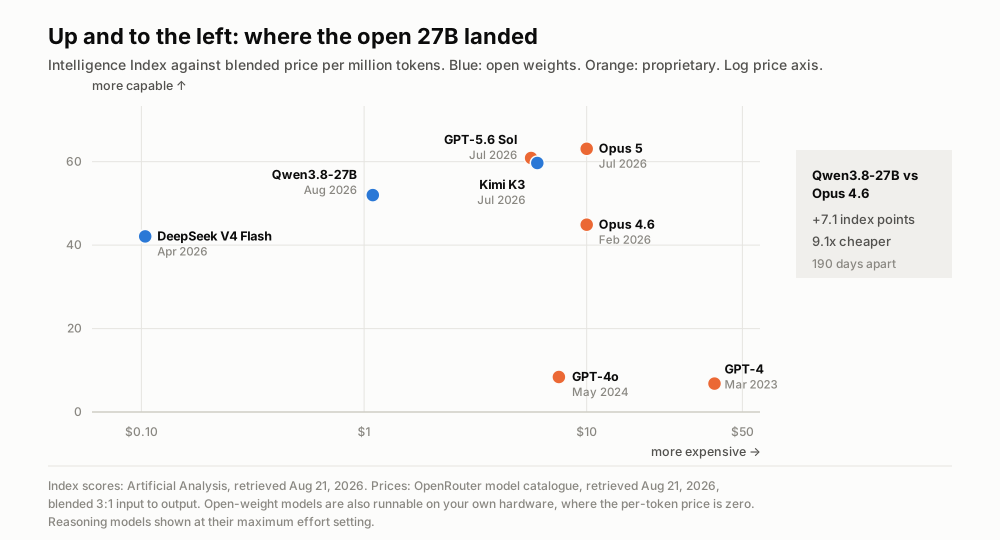
Semua model yang penting sedang bergeser ke pojok kiri atas. Skor dari Artificial Analysis, harga dari OpenRouter, keduanya diambil 21 Agustus 2026.
Lalu ada pilihan yang sama sekali tak punya harga per token. Jalankan 27B di RTX 4090 milik Anda pada kisaran 48 token per detik yang dilaporkan para praktisi di utas perilisan, asumsikan daya nominal kartu 450 watt, dan pada harga rata-rata listrik rumah tangga Amerika Serikat sebesar 18,44 sen per kilowatt-jam (EIA, Mei 2026), listriknya berkisar 0,48 dolar per juta token keluaran — sebelum menghitung kartunya, dan setelah berhenti menghitung margin siapa pun. Ini estimasi terhitung dengan seluruh asumsinya terbuka, bukan klaim vendor.
Sebelum dan sesudah, baris demi baris
| Juli 2023 | Agustus 2026 | |
|---|---|---|
| Model terbaik yang bisa diunduh | Llama 2 70B (Meta, 18 Juli 2023) | Qwen3.8-27B (Alibaba, 14 Agustus 2026) |
| Parameter | 70 miliar | 27 miliar |
| Build komunitas 4 bit standar | 41,4 GB | 16,5 GB |
| Build terkecil yang masih berguna | 7,9 GB (13B, MMLU 54,8) | 9,8 GB (2 bit, konteks 128K di kartu 16 GB) |
| Perangkat keras realistis | dua GPU 24 GB atau Mac 64 GB | satu GPU konsumen 16 GB |
| Model garis depan saat itu | GPT-4 (14 Maret 2023) | Claude Opus 4.6 Max (5 Februari 2026) |
| Hasil melawannya | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | menang 15 dari 19 tolok ukur terpublikasi, +7,1 poin indeks |
| Harga campuran model garis depan itu | 37,50 $ per juta token | 10,00 $ per juta token |
| Harga campuran model terbuka | tak tersedia dalam skala besar | 1,09 $ per juta token |
| Lisensi | Llama 2 Community License | Apache 2.0 |
Sumber tiap sel ada di bagian akhir. Baris yang terus kami tengok adalah baris kedua dari bawah: harga garis depan sendiri turun 3,75 kali dalam tiga tahun, sementara alternatif terbuka muncul di bawahnya pada sekitar sepersepuluh angka itu. Keduanya benar-benar terjadi. Yang mengubah siapa saja yang boleh membangun adalah yang kedua.
Apa yang masih belum benar
Antusiasme di sekitar rilis ini mendahului bukti pada empat titik tertentu. Mari kita tandai.
Ini bukan garis depan. Pada indeks yang sama, Claude Opus 5 Max mencetak 63,1 dan GPT-5.6 Sol Max 60,9, keduanya jauh di atas 52,0. Kalau pekerjaan Anda bergantung pada penalaran tersulit yang tersedia, garis depan tetap produk yang berbeda, dan tetap tertutup.
Untuk ukurannya, ia tidak murah. Ringkasan Artificial Analysis sendiri menyebut Qwen3.8-27B «sangat mahal jika dibandingkan model bobot terbuka lain dengan ukuran serupa»: median di kelasnya 0,05 dolar per juta token masukan, sementara Qwen 0,43. Anda membayar kemampuan, bukan jumlah parameter.
Ia bertele-tele, dan bertele-tele itu tagihan. Saat menjalankan evaluasi indeks kecerdasan, 27B ini menghasilkan 160 juta token keluaran dibanding median 45 juta. Seorang pengguna memberinya prompt dua kata di Mac mini 64 GB lalu menontonnya berpikir selama 17 menit 12 detik. Model penalar menagih dalam waktu jam dinding, bahkan ketika tokennya gratis.
Dan skor tolok ukur itu milik model dalam presisi penuh. Build 2 bit berukuran 9,8 GB yang muat di kartu grafis Anda bukan model yang mencetak 52,0. Kuantisasi berat memangkas ketepatan, terutama pada konteks panjang. Setiap klaim «bisa jalan di laptop», termasuk klaim kami, membawa tanda bintang itu.
Mengapa jedanya semestinya terus menyusut
Mulai dari sini adalah pandangan kami, dan kami menandai peralihannya dengan jelas: semua yang di atas adalah pengukuran, yang berikut adalah kesimpulan dari pengukuran itu.
Mekanisme yang menekan jeda mengejar tidak misterius. Teknik pascapelatihan yang dipublikasikan di garis depan direproduksi di laboratorium terbuka dalam hitungan bulan. Pengaturan tingkat upaya penalaran, delapan belas bulan lalu masih trik proprietari, kini hadir sebagai parameter terdokumentasi di kartu model ini. Kuantisasi komunitas selesai bahkan sebelum dokumentasi laboratorium aslinya berhenti berubah. Tak satu pun dari tiga lingkar umpan balik itu punya alasan melambat, dan dua di antaranya justru mempercepat seiring bertambahnya peserta.
Maka harapan yang masuk akal untuk generasi berikutnya bukanlah model terbuka menyalip garis depan. Melainkan bahwa jeda 162 hari itu terus memampat sementara kemampuan mutlak di kedua ujung terus naik. Dengan begitu, ambang yang menarik bukan lagi «bisakah model terbuka menang», melainkan «seberapa mutakhir garis depan harus ada supaya selisihnya berhenti berarti bagi tugas saya». Untuk transkripsi rapat, penerjemahan, peringkasan, dan sebagian besar pekerjaan dokumen, ambang itu sudah lama terlampaui. Untuk riset terdepan dan rekayasa agentik tersulit, belum.
Ini dunia yang jauh lebih baik daripada dunia 2023, dan itu pantas dikatakan terus terang. Biaya memberi komputer pemahaman bahasa yang kompeten turun dua orde besaran dalam tiga tahun dan masih terus turun. Yang paling diuntungkan adalah mereka yang dulu tersingkir oleh harga: pengembang tunggal, tim di negara-negara tempat 10 dolar per juta token bukan kesalahan pembulatan, peneliti dengan hibah alih-alih anggaran, dan siapa pun yang datanya harus tetap di mesin sendiri karena alasan hukum.
Intinya: garis depan berhenti menjadi tempat dan menjadi tanggal
Pertanyaan lamanya adalah laboratorium mana yang bisa Anda akses. Pertanyaan barunya adalah berapa bulan Anda bersedia tertinggal dari garis depan, mengingat biayanya sepersembilan dan berjalan di perangkat keras milik Anda sendiri.
Untuk semakin banyak jenis pekerjaan, jawaban jujurnya: sekitar lima bulan, dan terus mengecil.
Di mana Telli.sh berdiri: semua di atas adalah alasan kami membangun di atas model terbuka alih-alih mengelilingi satu vendor. Telli.sh sudah memakai model Qwen terbuka pada jalur peringkasannya, sehingga setiap langkah menurun di kurva ini sampai ke Anda sebagai catatan rapat yang lebih baik, bukan sebagai pengumuman kenaikan harga. Yang kami kerjakan adalah bagian yang tak diberikan unduhan mana pun: merekam audio satu jam tanpa putus, memisahkan pembicara, menerjemahkan langsung ke 15 bahasa, dan mengubah semuanya menjadi catatan yang masih bisa dicari berbulan-bulan kemudian.
Sumber
- Kartu model dan tabel tolok ukur Qwen3.8-27B, Hugging Face — angka perbandingan langsung dengan Opus 4.6 Max, diambil 21 Agustus 2026
- Artificial Analysis: analisis kecerdasan, kinerja, dan harga Qwen3.8 27B — indeks kecerdasan 52,0, harga dan tingkat verbositas, diambil 21 Agustus 2026
- Artificial Analysis: halaman model Claude Opus 4.6 — indeks kecerdasan 44,9 pada upaya penalaran maksimum, diambil 21 Agustus 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 Maret 2025 — tangga harga pada ambang tetap dan rentang 9 sampai 900 kali per tahun
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 Juli 2023 — tabel 4, Llama 2 70B melawan GPT-4
- Daftar berkas TheBloke/Llama-2-70B-Chat-GGUF — build Q4_K_M 41,4 GB, terbit 4 September 2023
- Daftar berkas unsloth/Qwen3.8-27B-GGUF — build 16,5 GB dan 9,8 GB, jumlah unduhan diambil 21 Agustus 2026
- Katalog model OpenRouter — harga per token Qwen3.8-27B, Claude Opus 4.6, dan Claude Opus 5, diambil 21 Agustus 2026
- Diskusi Hacker News tentang perilisan Qwen3.8-27B, 14 Agustus 2026 — laporan throughput praktisi di kartu 16 dan 24 GB
- US Energy Information Administration, Electric Power Monthly, tabel 5.3 — 18,44 sen per kilowatt-jam rata-rata rumah tangga, Mei 2026
- Liputan kami sebelumnya tentang perilisan bobot terbuka Qwen3.8 dan tentang gelombang bobot terbuka yang lebih luas
- Halaman Wikimedia Commons untuk foto Cray Y-MP
