Qwen3.8-27B open weights: ukuran, Q4_K_M, dan kecepatan nyata 4090/Mac
Qwen3.8-27B dirilis dengan lisensi Apache 2.0. GGUF Q4_K_M berukuran 17,1 GB dan muat di laptop 32 GB; FP8 30,9 GB. Terukur: 48 token/detik di RTX 4090, 12,75 di Mac mini M4 Pro.
Pada 3 Agustus, akun Qwen milik Alibaba mengatakan bobot terbuka akan hadir «minggu depan». Itu persis jenis kalimat yang telah diajarkan industri AI untuk didengar dengan diskon. Dua belas hari kemudian tidak ada lagi yang perlu didiskon: bobot Qwen3.8-Max dengan 2,4 triliun parameter muncul di Hugging Face pada 12 Agustus, dan model kecilnya — Qwen3.8-27B, dengan lisensi Apache 2.0 yang biasa saja — menyusul pada 14 Agustus.
Lalu bagian menariknya terjadi. Dalam jam yang sama ketika Qwen selesai menerbitkan kartu model 27B, tiga kelompok komunitas berbeda sudah mengonversinya ke format yang bisa dijalankan di komputer pribadi. Dua hari setelah itu, hasil konversi tersebut melewati satu juta unduhan.
Angka itulah beritanya, bukan tabel tolok ukur. Sebuah model 27 miliar parameter dari salah satu laboratorium AI terkemuka dunia berpindah dari «diumumkan» ke «berjalan di sekitar satu juta meja kerja» dalam kira-kira 48 jam. Tulisan ini menjelaskan dengan bahasa sederhana apa artinya itu: apa yang dirilis dan dengan lisensi apa, apa yang dibutuhkan untuk menjalankan 27B di perangkat keras yang sudah Anda punya, sejauh apa perkembangannya dalam tiga tahun, dan bagian yang biasanya dilewati — apa yang masih belum bisa dilakukan 27B lokal.
Ringkasnya:
- Janjinya ditepati. Qwen3.8-Max (2,4 triliun total / 95 miliar aktif) tiba 12 Agustus, Qwen3.8-27B pada 14 Agustus. Keduanya benar-benar bisa diunduh, bukan pratinjau yang berjalan di server vendor.
- Lisensinya berbeda, dan perbedaan itu lebih berbobot daripada skornya. 27B memakai Apache 2.0: tanpa ambang, tanpa klausul, boleh dipakai komersial tanpa berutang apa pun. Qwen3.8-Max keluar dengan lisensi sendiri yang memuat pemicu pendapatan bagi bisnis model sebagai layanan.
- Ukuran yang menentukan siapa bisa menjalankan apa: Max adalah unduhan 4.892 GB; 27B yang dipadatkan ke 4 bit hanya 17,1 GB dan muat di mesin 32 GB. Versi 4 bit komunitas melewati 1,07 juta unduhan dalam dua hari.
Gambar: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Menjalankan sendiri model dari laboratorium terdepan berarti mesinnya — dan perawatannya — menjadi milik Anda.
Janjinya bertanggal, dan tanggalnya bertahan
Pada 4 Agustus kami membahas pengumuman itu sendiri dan menulis bahwa penantiannya diukur dalam «minggu depan», bukan «suatu hari nanti». Itu batas terjauh yang diizinkan bukti saat itu. Perkaranya selesai dengan rapi.
Qwen3.8-2.4T-A95B — yang dipasarkan sebagai Qwen3.8-Max — muncul beserta berkas lisensinya pada 12 Agustus. Qwen3.8-27B dan varian FP8 yang dioptimalkan tiba pada 14 Agustus. Kedua tanggal itu jatuh di dalam jendela yang ditunjuk «minggu depan». Di industri yang model-model umumannya kerap tak pernah benar-benar terbit, sebuah laboratorium menepati tenggat lisan berumur sembilan hari sudah layak dicatat.
Sambutannya langsung dan besar. Utas Hacker News tentang 27B mengumpulkan 1.351 poin dan 769 komentar dalam sehari. Dalam hitungan jam, para praktisi memposting konfigurasi penyajian yang berfungsi untuk perangkat keras tertentu; ada yang membagikan pengaturan untuk NVIDIA DGX Spark sekaligus untuk kartu grafis konsumen RTX 4090. Dua tahun lalu industri tidak memperlakukan rilis terbuka seperti ini, ketika sekadar membuat arsitektur baru berjalan saja sudah proyek akhir pekan.
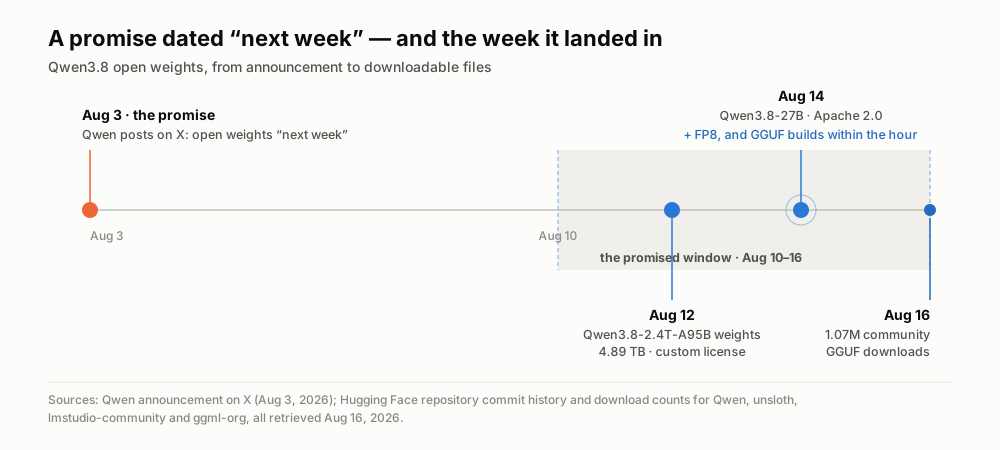
Sebuah janji bertanggal dan dua pengiriman yang mendarat di dalamnya. Tanggal dari riwayat commit repositori Hugging Face, diambil 16 Agustus 2026.
Lima istilah, diarahkan ke pertanyaan «bisakah saya menjalankannya?»
Kalau Anda datang dari tulisan kami sebelumnya, Anda sudah tahu apa itu bobot terbuka: laboratorium menerbitkan kisi raksasa berisi angka-angka hasil pelatihan yang membentuk model jadi, dan Anda bisa mengunduhnya, menjalankannya di perangkat keras sendiri, serta membangun di atasnya tanpa membayar per permintaan. Di sini kita mengurus pertanyaan berikutnya, yang sepenuhnya praktis: berapa biaya menjalankannya dalam bentuk perangkat keras?
Parameter adalah angka-angka hasil pelatihan tersebut, dan jumlahnya menentukan ukuran mentah model. Aturan praktisnya sederhana sampai kejam: pada presisi yang dipakai laboratorium untuk melatih, setiap satu miliar parameter memakan sekitar 2 GB di penyimpanan, dan Anda butuh kira-kira sebanyak itu memori untuk menampung model saat berjalan. Jadi model 27 miliar parameter adalah unduhan 55 GB. Model 2,4 triliun mendekati 5 terabita. Itulah sebabnya yang satu adalah urusan laptop dan yang lain urusan pusat data.
Kuantisasi adalah yang menutup jurang itu, dan merupakan gagasan paling berguna bagi siapa pun yang ingin menjalankan model di rumah. Parameter biasanya disimpan dengan presisi 16 bit. Kuantisasi membulatkannya ke bit yang lebih sedikit — 8, 4, kadang 2 — dan berkasnya menyusut kira-kira dengan proporsi yang sama. Kuantisasi 4 bit mengubah unduhan 55 GB tadi menjadi sekitar 17 GB. Anda kehilangan sedikit akurasi dan mendapatkan kemampuan untuk menjalankannya sama sekali. GGUF hanyalah format berkas tempat versi terkompresi ini beredar; itulah yang dibaca perkakas seperti llama.cpp, Ollama, dan LM Studio. Ketika melihat «Q4_K_M», bacalah sebagai «versi 4 bit yang dipakai kebanyakan orang».
Padat versus campuran pakar menentukan seberapa cepat model berjalan setelah ia muat. Qwen3.8-27B bertipe padat: seluruh 27 miliar parameter menyala untuk setiap kata yang dihasilkan. Qwen3.8-Max bertipe campuran pakar — 2,4 triliun parameter secara total, tetapi sebuah perute hanya memilih sekitar 95 miliar per token, tersebar di 512 subjaringan spesialis. Angka total memberi tahu tagihan penyimpanan; angka aktif memberi tahu tagihan komputasi. Pembedaan ini punya sisi praktis yang tajam, dan kita akan kembali ke sana.
Jendela konteks adalah seberapa banyak yang bisa dipertimbangkan model sekaligus. 27B menangani 262.144 token secara bawaan — setumpuk transkrip rapat sepanjang satu jam — dan bisa diregangkan sampai satu juta lewat perubahan konfigurasi.
Lisensi adalah yang pertama harus dibaca
Inilah temuan yang menanggung beban tulisan ini, dan ia bertentangan dengan anggapan bahwa satu keluarga model berbagi satu keluarga syarat.
Qwen3.8-27B memakai Apache 2.0. Itu ujung paling longgar dari spektrum: pakai, ubah, setel, masukkan ke produk komersial, bangun bisnis di atasnya, tanpa berutang apa pun dan tanpa meminta izin siapa pun. Tidak ada ambang pendapatan, tidak ada kewajiban menampilkan nama di antarmuka, tidak ada pengecualian bidang penggunaan.
Qwen3.8-Max tidak. Ia keluar dengan «Qwen3.8-Max License» sendiri, yang bermula mirip MIT lalu menempelkan dua syarat. Jika produk Anda melampaui 100 juta pengguna aktif bulanan atau 20 juta dolar AS pendapatan bulanan, Anda wajib menampilkan nama model di antarmuka. Dan jika Anda menjalankan bisnis model sebagai layanan atau asisten kerja berbasis AI yang pendapatannya melampaui 50 juta dolar dalam dua belas bulan berturut-turut mana pun, Anda perlu perjanjian terpisah dengan Qwen sebelum pemakaian komersial apa pun.
Bagi pengembang tunggal atau perusahaan yang memakainya secara internal, tak satu pun dari ini menggigit. Tetapi ini tanda bintang yang sama yang kami tandai ketika Kimi K3 rilis dengan lisensi sendiri alih-alih MIT, dan pelajarannya berulang: «bobot terbuka» dan «lisensi terbuka» adalah dua pertanyaan terpisah, dan satu laboratorium bisa menjawabnya berbeda untuk dua model yang dirilis berselang dua hari. Baca lisensinya sebelum jatuh hati pada sebuah skor.
| Model | Parameter total | Aktif per token | Ukuran unduhan | Lisensi | Tempat berjalan realistis |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2,4 triliun | 95 miliar | 4.892 GB | Sendiri, pemicu pendapatan | Sekelompok akselerator |
| Qwen3.8-Max, FP8 | 2,4 triliun | 95 miliar | 2.496 GB | Sendiri, pemicu pendapatan | Sekelompok akselerator |
| Qwen3.8-27B | 27 miliar, padat | 27 miliar | 55,6 GB | Apache 2.0 | Workstation multi-GPU |
| Qwen3.8-27B, FP8 | 27 miliar, padat | 27 miliar | 30,9 GB | Apache 2.0 | Satu GPU kelas atas |
| Qwen3.8-27B, Q4_K_M GGUF | 27 miliar, padat | 27 miliar | 17,1 GB | Apache 2.0 | Laptop 32 GB atau sebuah 4090 |
Apa yang sebenarnya dibutuhkan untuk menjalankan 27B
Jawaban jujurnya: lebih sedikit dari dugaan Anda, dan lebih banyak dari yang disiratkan judul-judul berita.
Anak tangga terendah adalah satu perintah. 27B ada di pustaka Ollama; ollama run qwen3.8 menarik versi 18 GB dengan jendela konteks 256K dan masukan gambar, dari dua belas varian termasuk satu yang disetel untuk cip Apple. LM Studio, yang memberi Anda jendela obrolan alih-alih terminal, sudah memasang versinya beberapa menit setelah rilis. Keduanya tidak menuntut Anda memahami bagian sebelumnya.
Lalu kenyataan menyela dalam bentuk token per detik. Angka-angka yang dilaporkan praktisi di utas rilis jatuh kira-kira di tempat yang diramalkan perangkat keras. Di RTX 4090 dengan versi 4 bit, seseorang mengukur sekitar 48 token per detik — jauh lebih cepat daripada kecepatan Anda membaca. Di Mac mini M4 Pro dengan memori 64 GB, orang lain mendapat 12,75 token per detik: terpakai, tetapi Anda menontonnya mengetik. Dan di laptop dengan AMD 7840U serta 64 GB DDR5 biasa, versi 4 bit yang sama menghasilkan sekitar 4 token per detik — secara teknis berjalan, secara praktis sebuah tugas batch yang Anda jalankan lalu tinggalkan.
Angka terakhir itulah tempat pembedaan padat versus pakar membuktikan gunanya. Orang yang sama mengukur, di laptop yang sama, sebuah model campuran pakar lama yang secara nominal lebih besar pada sekitar 20 token per detik — lima kali lebih cepat daripada model padat yang lebih kecil, karena hanya sebagian parameter yang menyala per kata. Kalau Anda mencari sesuatu untuk dijalankan di CPU, angka yang harus dibandingkan adalah parameter aktif, bukan totalnya. Itu pelajaran paling berlawanan intuisi dan paling berguna dalam AI lokal.
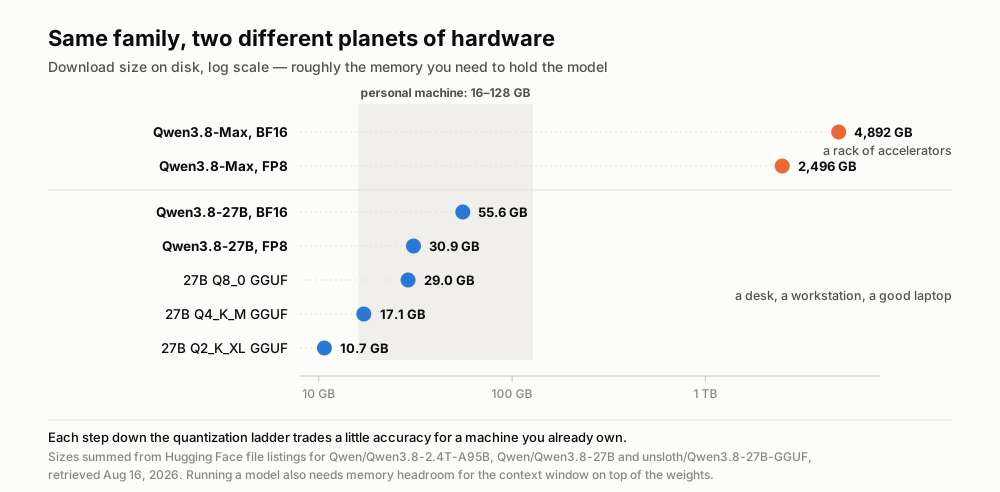
Dua anggota keluarga model yang sama, terpisah faktor 290 dalam ukuran unduhan. Ukuran dijumlahkan dari daftar berkas Hugging Face, diambil 16 Agustus 2026.
Tiga tahun lalu ini memerlukan kebocoran dan satu akhir pekan
Untuk melihat besarnya lompatan, sandingkan dengan titik awal model lokal.
Pada Februari 2023, Meta merilis bobot LLaMA orisinal hanya kepada peneliti yang disetujui. Bobot itu bocor dalam waktu sekitar sepekan, dan seluruh kancah amatir model lokal dibangun di atas berkas yang semestinya tak dimiliki siapa pun. Pada 10 Maret 2023, seorang pengembang menerbitkan llama.cpp, program C++ kecil yang jurus andalannya adalah menjalankan model 7 miliar parameter di sebuah MacBook. Repositori itu kini punya 124.000 bintang dan menjadi leluhur hampir setiap perkakas «jalankan secara lokal» yang dipakai hari ini.
Bandingkan dua hari rilis tersebut. Tahun 2023: sebuah 7B yang bocor, tanpa lisensi yang pantas disebut, sepekan kerja komunitas agar ia berjalan, dan model yang lebih menarik daripada berguna. Tahun 2026: sebuah 27B dari laboratorium terdepan, diterbitkan dengan sengaja di bawah Apache 2.0, dengan masukan gambar dan video, jendela konteks 262K, dan versi komunitas yang rampung sebelum dokumentasi laboratoriumnya sendiri berhenti berubah. Commit pertama konversi unsloth jatuh pada pukul 14.56 UTC tanggal 14 Agustus — empat menit sebelum pembaruan terakhir kartu model oleh Qwen.
Angka adopsi mengatakan hal yang sama secara lebih blak-blakan. Per 16 Agustus, versi 4 bit komunitas untuk 27B mencatat 867.963 unduhan di satu penerbit, 171.518 di penerbit kedua, dan 34.520 di ketiga: 1,07 juta dalam dua hari. Repositori resmi Qwen sendiri untuk 27B menambah 215.000 lagi. Qwen3.8-Max, model yang jauh lebih mampu, berada di angka 17.126 untuk kedua repositorinya.
Baca lagi rasio itu. Model berskala terdepan mendapat sekitar 1,6 persen dari perhatian yang jatuh ke model berskala laptop. Yang dijemput pasar bukan kemampuan. Melainkan jangkauan.
Apa yang masih belum bisa dilakukan 27B lokal
Sekarang koreksinya, karena antusiasme melampaui bukti dengan cara-cara yang bisa ditebak.
Tabel tolok ukur milik Alibaba sendiri menempatkan 27B di atas Opus 4.6 Max pada beberapa ukuran pemrograman agentik dan kepatuhan instruksi — 61,7 berbanding 53,4 pada SWE-bench Pro, 79,5 berbanding 62,5 pada IFBench — sementara kalah pada yang lain, termasuk 30,8 berbanding 40,0 pada HLE yang menguji pengetahuan luas. Setiap angka itu dilaporkan sendiri oleh vendornya. Saat tulisan ini dibuat, Artificial Analysis, penilai independen yang kami andalkan, sama sekali belum punya entri untuk 27B; ia memang menempatkan Qwen3.8-Max di peringkat 10 dari 188 model dengan skor kecerdasan 58, yang sangat bagus dan juga merupakan model yang berbeda.
Para praktisi lebih tajam daripada lembar kerjanya. Bantahan yang paling banyak didukung di utas itu, dari seseorang yang mengaku pengguna lama model terbuka, terdengar tegas: model-model ini tidak mengalahkan model terhosting terbaik dalam pemakaian nyata; mereka «cukup baik» untuk banyak tugas dan bisa dijalankan di perangkat keras yang terjangkau — sebuah klaim yang berbeda dan lebih rendah hati. Komentar lain merumuskan langit-langitnya secara fisik: Anda tak bisa memampatkan seluruh pengetahuan manusia ke dalam berkas 30 GB, sehingga model kecil tetap relatif lemah dalam mengingat fakta yang jarang, sesempurna apa pun mereka dalam menulis kode atau memakai perkakas.
Ada dua batas lagi yang baru muncul saat dijalankan. Kuantisasi tidak gratis: model yang dipadatkan habis-habisan cenderung kehilangan alur pada konteks panjang dan bisa terjatuh ke perulangan — karena itu siapa pun yang punya memori berlebih disarankan memakai versi presisi penuh. Dan generasi Qwen ini berpikir panjang secara bawaan: seorang pengguna memberi 27B di Mac mini 64 GB dua kata saja, «svg owl», lalu menyaksikannya menghasilkan 21.769 token penalaran selama 17 menit 12 detik sebelum menjawab. Burung hantunya jadi bagus. Jadi pula tagihan dalam waktu nyata yang tak akan ditagihkan API terhosting mana pun.
Lalu ada pos yang tak dihitung siapa pun: operasionalnya kini milik Anda. Pembaruan model, pilihan kuantisasi, kelonggaran memori, versi driver, kipas mesin. API terhosting yang Anda hindari itu juga berarti sekelompok orang yang menjaga sesuatu tetap berjalan.
Intinya: paritnya bergeser turun di tumpukan
Inilah pokoknya, dan ia lebih besar daripada satu rilis.
Sebuah laboratorium terdepan menerbitkan 27B yang mumpuni pada hari Kamis. Pada hari Sabtu, lebih dari satu juta salinan versi yang dipadatkan komunitas sudah ada di mesin orang-orang, ia berjarak satu perintah di Ollama, dan secara hukum bebas untuk dijadikan dasar bisnis. Apa pun keunggulan yang diwakili model itu, ia butuh sekitar dua hari untuk tersedia bagi semua pesaing sekaligus. Sebut saja parit dua hari: keunggulan model yang kini punya paruh waktu sekitar 48 jam.
Ini bukan ramalan. Ini pengukuran, diambil minggu ini, pada rilis ini.
Dan ia mendefinisikan ulang apa artinya membangun produk AI. Ketika lapisan model menjadi komoditas yang bisa ditukar siapa saja dalam satu sore, model berhenti menjadi hal yang Anda perlombakan. Yang bertahan adalah segala sesuatu yang membungkusnya: keandalan ketika server inferensi tumbang pukul tiga pagi, jalur data yang menangkap, membersihkan, dan menemukan kembali konteks yang tepat, evaluasi yang memberi tahu apakah ia bekerja pada data Anda dan bukan data tolok ukur, antarmuka yang benar-benar akan dipakai orang, dan pengaturan kepercayaan — privasi, masa simpan, siapa boleh melihat apa — yang menentukan apakah ada orang yang mau menyerahkan rekaman rapatnya kepada Anda.
Tak satu pun dari itu menjadi komoditas dalam dua hari. Tak satu pun punya tombol unduh.
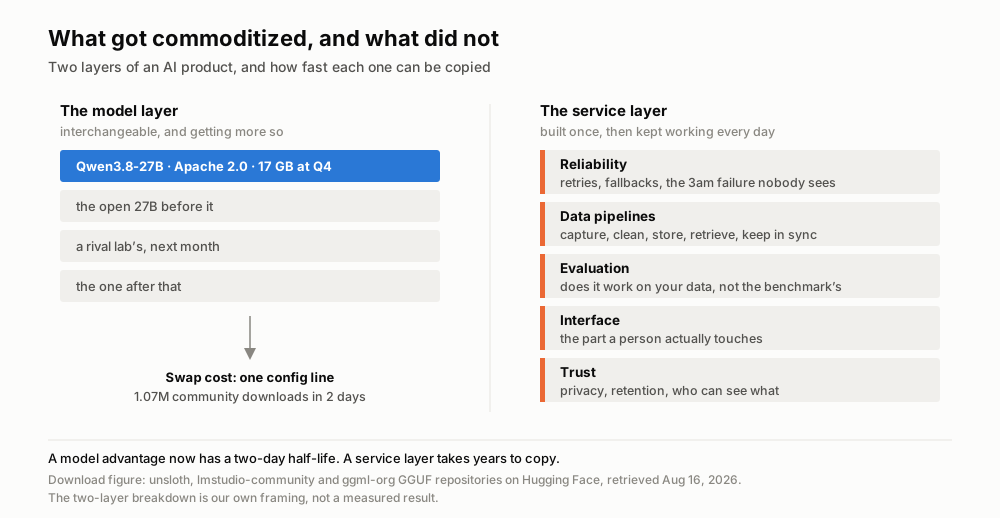
Lapisan yang menjadi murah minggu ini, dan lapisan yang tidak. Angka unduhan dari Hugging Face, diambil 16 Agustus 2026; pembagian dua lapisan ini adalah kerangka kami sendiri.
Jadi tanggapan yang tepat atas sebuah model terbuka yang hebat mendarat di laptop bukanlah «perusahaan model menang» atau «perusahaan produk kalah». Melainkan bahwa pekerjaan yang menarik turun satu lantai di dalam tumpukan — ke tempat yang jauh lebih sulit ditiru dan jauh lebih tidak seru dijadikan judul berita.
Di mana Telli.sh berdiri: kami membangun persis lapisan layanan itu, di atas model terbuka. Telli.sh sudah memakai model Qwen terbuka di jalur peringkasannya, yang berarti setiap lompatan mutu model terbuka — termasuk yang ini — mengalir langsung ke transkripsi, terjemahan, dan ringkasan rapat tanpa perubahan harga di sisi Anda. Waktu kami habis di bagian yang tidak datang di dalam berkas GGUF: menangkap audio dengan andal, tidak tertukar siapa yang bicara, mengubah rekaman 60 menit menjadi catatan yang masih bisa Anda cari berbulan-bulan kemudian, dan berterus terang soal di mana data Anda tinggal.
Sumber
- Kartu model dan lisensi Qwen3.8-27B, Hugging Face
- Kartu model dan lisensi Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: versi terkuantisasi dan jumlah unduhan
- Qwen3.8 di pustaka model Ollama
- Diskusi Hacker News tentang rilis Qwen3.8-27B (14 Agustus 2026)
- Halaman model Qwen3.8 Max di Artificial Analysis
- Pengumuman bobot terbuka oleh Qwen (@Alibaba_Qwen) di X (3 Agustus 2026)
- Repositori llama.cpp, dibuat 10 Maret 2023
- Halaman gambar di Wikimedia Commons
