Lari cepat tiga minggu bobot terbuka China: Kimi K3, Qwen3.8-Max, dan kejutan yang bisa mengakhirinya
Dalam tiga minggu, lab-lab AI terbesar China merilis atau mengisyaratkan model bobot terbuka kelas frontier — Kimi K3, Qwen3.8-Max, dan DeepSeek V4 yang sudah tersedia umum. Panduan berbahasa sederhana: apa itu setiap model, apa yang benar-benar rilis dan apa yang masih janji, dan mengapa Beijing kini mungkin membatasi gelombang yang ia sendiri picu.
Antara 16 dan 26 Juli, tiga dari lab AI terbesar China menaruh model terbuka kelas frontier di atas meja. Moonshot AI mengumumkan Kimi K3 pada 16 Juli dan merilis bobotnya pada 26 Juli. Alibaba memperkenalkan Qwen3.8-Max pada 19 Juli di WAIC Shanghai. Lini V4 DeepSeek mencapai ketersediaan umum (GA) sekitar 20 Juli. Tiga lab, kira-kira tiga minggu.
Polanya sulit dilewatkan, dan itu bukan pola yang membuat nama besar dunia model terbuka China selama ini. Lab-lab ini dikenal lewat model yang kecil, cepat, dan murah, tetapi memukul di atas kelasnya. Gelombang ini adalah taruhan sebaliknya: sistem triliunan parameter yang dirilis, atau dijanjikan, sebagai bobot terbuka.
Ini adalah ulasan jujur atas gelombang itu: apa yang benar-benar rilis, apa yang masih pratinjau atau janji, dan kejutan yang datang bersamanya — pemerintah yang sama yang memungkinkan rilis-rilis ini kini menimbang apakah harus membatasinya. Kami akan menekan jargon seminim mungkin dan menjelaskan sisanya sambil jalan, agar Anda bisa mengikuti kisah ini meski "bobot terbuka" dan "mixture-of-experts" terasa baru. Jika Anda membaca rangkuman Juli kami, ini adalah sekuelnya, dan salah satu benang yang menggantung kini terurai.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Pertama, lima gagasan yang membuat semuanya masuk akal
Jika Anda baru di sudut AI ini, lima istilah memikul sebagian besar kisahnya, dan layak diberi satu menit dalam bahasa sederhana sebelum kita sampai ke modelnya.
"Bobot terbuka" (open weights) adalah seluruh alasan gelombang ini penting. Bobot sebuah model adalah kisi angka raksasa yang ia pelajari selama pelatihan — pada dasarnya otak yang sudah jadi. Ketika sebuah lab merilis bobot, Anda bisa mengunduh berkas itu, menjalankan model di perangkat keras Anda sendiri, menyesuaikannya, dan membangun produk di atasnya tanpa meminta izin siapa pun atau membayar per permintaan. Alternatifnya adalah model tertutup, seperti kebanyakan chatbot komersial, di mana bobot terkunci di server vendor dan Anda menyewa akses lewat API berbayar. Bobot terbuka mengubah model dari layanan yang Anda sewa menjadi sesuatu yang salinannya Anda miliki, dan perbedaan itulah yang membuat seluruh industri memasang telinga ketika model yang bagus muncul.
"Parameter" adalah angka-angka yang dipelajari itu, dan jumlahnya adalah indikator kasar seberapa banyak yang bisa ditampung sebuah model. Model "2,8 triliun parameter" punya 2,8 triliun angka itu. Lebih besar tidak otomatis lebih baik, tetapi di frontier biasanya berarti lebih banyak ruang untuk bernalar — dan, sama pentingnya, lebih banyak perangkat keras untuk menjalankannya. Di sinilah "mixture-of-experts" (MoE) masuk. Alih-alih menyalakan seluruh parameter untuk setiap kata, model MoE dibagi menjadi banyak sub-jaringan khusus yang disebut pakar, dan sebuah router hanya memilih segelintir untuk setiap token. Jadi ketika Anda melihat "total 2,8 triliun, aktif 104 miliar", artinya modelnya raksasa tetapi pada satu saat hanya sekitar 104 miliar parameter yang bekerja — seperti rumah sakit dengan ribuan spesialis di mana tiap pasien hanya ditangani oleh yang beberapa relevan. Angka total mengisyaratkan seberapa mampu ia; angka aktif memberi tahu seberapa mahal melayaninya. Selisih itu adalah satu angka paling berguna untuk menilai biaya.
"Jendela konteks" (context window) adalah berapa banyak teks yang bisa ditahan model dalam ingatannya sekaligus, dihitung dalam token — dan satu token setara sekitar tiga perempat kata. Jendela satu juta token bukan spesifikasi abstrak: itu beberapa novel panjang, atau puluhan transkrip rapat berdurasi satu jam, dalam satu kali proses. Itulah beda antara meringkas satu email dan bernalar atas satu kuartal penuh email.
Terakhir, lisensi — dan inilah bagian yang mestinya dibaca praktisi lebih dulu, sebelum tolok ukur. Lisensi adalah cetakan halus hukum yang mengatakan apa yang boleh Anda lakukan dengan bobot. MIT adalah standar emas: gunakan, modifikasi, masukkan ke produk komersial, tak berutang apa pun. Lisensi khusus bisa tampak terbuka sambil justru mengecualikan penggunaan yang Anda maksudkan — misalnya menagih Anda begitu bisnis yang Anda bangun di atasnya membesar. Dua model bisa sama-sama "bobot terbuka" tetapi berjarak sejauh langit dan bumi dalam hal yang boleh Anda lakukan secara hukum. Jadi membaca baris ini sebelum jatuh cinta pada sebuah skor itu menguntungkan. Dengan lima gagasan ini di tangan, gelombangnya terbaca jelas.
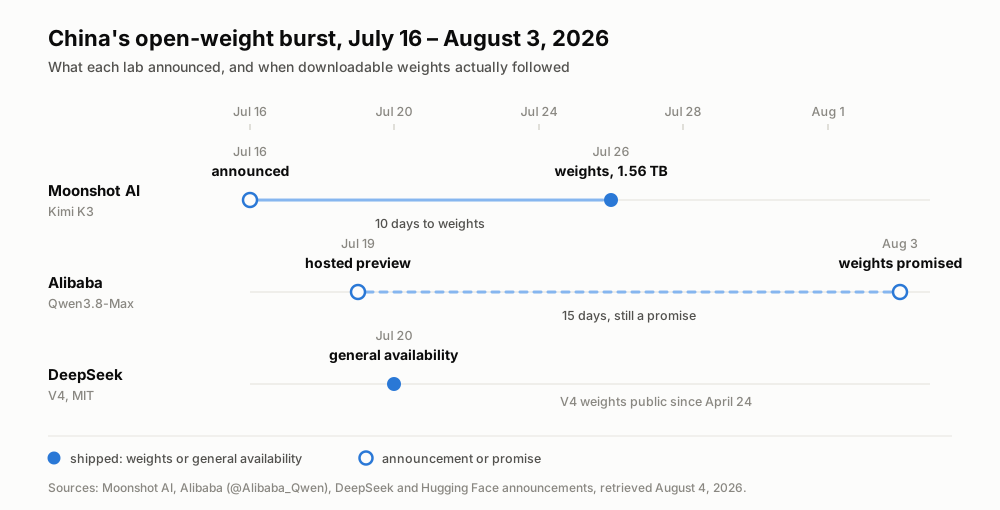
Tiga lab, tiga minggu — dan dari lima momen ini hanya dua yang benar-benar menyerahkan bobot ke tangan orang lain. Tanggal dari pengumuman masing-masing lab, diperiksa 4 Agustus 2026.
Kimi K3 adalah yang benar-benar rilis
Mulai dari Moonshot AI, lab di Beijing di balik asisten Kimi, yang menghabiskan setahun terakhir membangun reputasi lewat model terbuka yang besar dan mumpuni. Ketika kami menulis tentang Kimi K3 pada Juli, bobotnya masih sebatas janji — Moonshot mengatakan "paling lambat 27 Juli". Bobot itu tiba pada 26 Juli: 1,56 terabyte dalam 96 pecahan di Hugging Face, di bawah moonshotai/Kimi-K3. Itulah beritanya. Pengumuman adalah siaran pers; bobot yang bisa diunduh adalah fakta yang bisa Anda bangun di atasnya.
Secara sederhana, K3 adalah salah satu model terbuka terbesar yang pernah dirilis — sistem mixture-of-experts dengan 2,8 triliun parameter total dan sekitar 104 miliar aktif per token, merutekan kira-kira 16 dari 896 pakar melalui mekanisme yang Moonshot sebut Kimi Delta Attention, dengan jendela konteks satu juta token dan peningkatan efisiensi penskalaan yang dilaporkan sekitar 2,5x dibanding pendahulunya, K2. Diterjemahkan dari lembar spesifikasi: ia sangat besar, relatif hemat dijalankan untuk ukurannya karena hanya sepotong yang menyala per token, dan mampu menelan bulat-bulat masukan sepanjang buku.
Angka-angka itu juga memberi tahu siapa yang sebenarnya akan menjalankannya. 1,56 terabyte dalam 96 pecahan bukan unduhan laptop; ia artefak kelas pusat data yang sekadar untuk dimuat saja butuh klaster akselerator kelas atas. Praktiknya, nyaris tak ada individu yang akan menghosting K3 sendiri — mereka akan menjangkaunya lewat penyedia yang sudah punya perangkat kerasnya, dan pasar itu datang di hari pertama: Together AI dan Modal sama-sama menyalakan endpoint Kimi K3 ter-hosting pada saat bobotnya mendarat. Begitu pula cara pembaca penasaran mencobanya hari ini — bukan dengan mengunduh 1,56 TB, melainkan memanggil salah satu endpoint ter-hosting itu atau menggunakan aplikasi Kimi. "Terbuka" di sini berarti bobotnya publik dan siapa pun dengan perangkat keras bisa menyajikannya, yang justru menjaga persaingan harga; bukan berarti Anda akan menjalankannya sendiri di meja Anda.
Apakah bagus? Menurut satu-satunya angka independen yang kami percaya kali ini, ya. Pada peringkat Artificial Analysis, ia menempati posisi ke-4 dari 189 model — di belakang Claude Fable 5 dan dua konfigurasi GPT-5.6 "Sol", di depan Opus 4.8 dan GPT-5.5. Bagi model terbuka yang bisa Anda unduh, berada di lingkaran itu saja sudah menjadi cerita tersendiri.
Lalu baca lisensinya, karena di sinilah "terbuka" mendapat tanda bintang. Kimi K3 bukan MIT. Ia rilis di bawah lisensi khusus "Kimi K3 License" yang tidak disetujui OSI dan memuat klausul ambang pendapatan: menjalankan K3 sebagai mesin bisnis Model-as-a-Service besar mensyaratkan perjanjian terpisah dengan Moonshot. Bagi pengembang tunggal, atau perusahaan biasa yang memakainya secara internal, itu tidak mengubah apa pun. Tetapi bagi siapa pun yang membangun produk ter-hosting berskala besar, "bobot terbuka" dan "lisensi terbuka" adalah dua pertanyaan berbeda — dan di sini hanya yang pertama yang jelas-jelas "ya".
Qwen3.8-Max adalah pratinjau, bukan unduhan
Qwen adalah keluarga model Alibaba, dan timnya termasuk penerbit model terbuka paling produktif di dunia — justru riwayat itulah yang membuat yang terbaru membingungkan. Diperkenalkan pada 19 Juli di WAIC Shanghai, Qwen3.8-Max adalah judul terbesar gelombang ini, sekaligus yang paling lunak. Ia adalah MoE renggang berukuran 2,4 triliun parameter — jumlah parameter aktif tidak diungkap — dan Qwen pertama di atas satu triliun parameter yang multimodal, artinya menerima masukan bukan hanya teks, tetapi juga gambar, video, dan dokumen.
Inilah jebakan yang perlu dieja untuk pendatang baru: meski riuh, Anda tidak bisa mengunduhnya. Saat ini ia hanya ada sebagai "pratinjau ter-hosting" — qwen3.8-max-preview, dijangkau lewat layanan Alibaba sendiri (Token Plan dan alat Qoder-nya) sekitar 10% dari harga standar. Pratinjau ter-hosting berarti Alibaba menjalankan model di servernya dan membiarkan Anda memanggilnya; ini model API sewa, bukan model salinan milik sendiri. Menyebutnya rilis bobot terbuka hari ini terlalu dini.
Gambaran itu berubah pada 3 Agustus. Akun resmi Qwen di X, @Alibaba_Qwen, mengunggah bahwa bobot terbuka Qwen3.8-Max akan datang "minggu depan" — dan bahwa Qwen3.8-27B yang lebih kecil juga akan menjadi bobot terbuka. Jadi 27B bukan rumor, apa pun yang diisyaratkan obrolan sebelumnya: ini komitmen tertulis, dari akun Alibaba sendiri. Dan ukurannya justru intinya. Bila Max berukuran 2,4 triliun parameter, seperti K3, hanya bisa dijalankan pusat data, 27B cukup kecil untuk disajikan pada satu mesin kelas atas — kelas yang benar-benar bisa dihosting sendiri oleh individu atau tim kecil. Itu sungguh melunakkan gambaran "dijanjikan tanpa rincian": kini ada ukuran dan kerangka waktu kasar.
Namun, peringatan jujurnya tetap berlaku. "Minggu depan" adalah arah, bukan tanggal pengiriman, dan pada saat tulisan ini dibuat, 4 Agustus, belum ada apa pun yang mendarat di organisasi Qwen di Hugging Face — model terbarunya di sana dari Juni. Lisensi bobot terbuka pun belum diterbitkan, dan pembaca awal ketentuan pratinjau menandai kemungkinan pembatasan regional, belum terkonfirmasi sampai lisensi sebenarnya muncul — persis pelajaran "lisensi dulu" dari dasar-dasar tadi. Klaim Alibaba bahwa model ini "hanya kalah dari Fable 5" tetap klaim sepihak tanpa angka pihak ketiga, jadi perlakukan sebagai baris pemasaran vendor sampai ada yang di luar Alibaba mengukurnya. Jika Anda ingin mencoba model ini hari ini, pratinjau ter-hosting adalah satu-satunya pintu — tetapi untuk pertama kalinya, penantian bobot yang bisa diunduh diukur dengan "minggu depan", bukan "suatu hari nanti".
DeepSeek V4 diam-diam mencapai ketersediaan umum
DeepSeek adalah lab yang model R1-nya turut menyalakan lomba model terbuka saat ini di awal 2025, dan sesuai gayanya, di sini ia paling sedikit berkoar sambil mengirimkan yang paling bisa dipakai. Lini V4-nya, yang dirilis sejak 24 April, adalah yang paling mudah diadopsi, karena datang di bawah lisensi yang dasar-dasar tadi tandai sebagai standar emas.
V4 hadir dalam dua ukuran, keduanya berlisensi MIT. V4-Pro adalah unggulan dengan 1,6 triliun total dan 49 miliar parameter aktif; V4-Flash adalah yang ringan dengan 284 miliar total dan 13 miliar aktif. Ingat apa arti angka aktif: V4-Flash hanya menyalakan 13 miliar parameter per token, yang membuatnya murah dan cepat dilayani, dan itulah yang menjadikannya pilihan hemat untuk pekerjaan bervolume tinggi — jenis beban transkripsi-dan-ringkasan di mana biaya per token menentukan segalanya. Keduanya memiliki jendela konteks satu juta token dan bisa menghasilkan hingga 384K token keluaran dalam satu respons, cukup untuk menyusun laporan panjang, bukan sekadar satu paragraf. Sekitar 20 Juli, V4 mencapai ketersediaan umum dengan penetapan harga berbasis waktu, yang menarik rilis musim semi ke dalam bingkai tiga minggu yang sama dengan K3 dan Qwen.
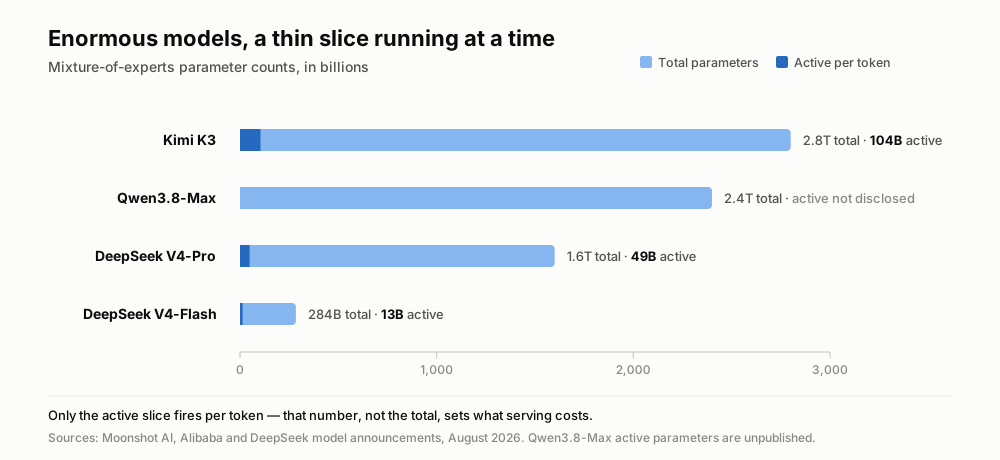
Batang terang adalah ukuran modelnya; potongan gelap adalah bagian yang benar-benar menyala tiap token. Alibaba belum mengungkap parameter aktif Qwen3.8-Max.
Karena MIT, V4 adalah yang bisa dibangun oleh pengadopsi dengan paling sedikit pengacara: ambil bobotnya (atau pakai penyedia ter-hosting), jalankan, rilis komersial, tak berutang apa pun dan tak bertanya siapa pun. Dan agar jelas soal nomor versi, karena pabrik rumor menyukainya — tidak ada R2, tidak ada V5, tidak ada V4.1. Hanya ada keluarga V4 yang matang menjadi sesuatu yang bisa diandalkan tim.
Jarak menyempit lebih cepat dari yang diakui papan peringkat
Bila mundur selangkah, kemiringannya lebih penting ketimbang rilis satu per satu. Bacaan Nathan Lambert: jarak antara model terbuka terbaik dan model tertutup terbaik telah memampat dari sekitar enam hingga sembilan bulan menjadi tiga hingga lima — "model terbuka tidak pernah sedekat ini dengan frontier sejak DeepSeek R1". Sederhananya: model yang bisa diunduh gratis kini hanya beberapa bulan di belakang model terbaik yang bisa disewa dengan uang, padahal setahun lalu mereka tertinggal satu putaran penuh yang nyaman.
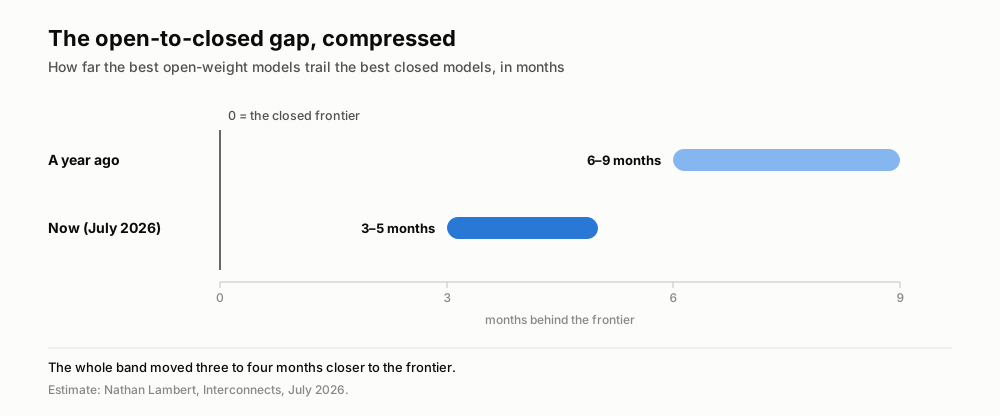
Perkiraan Lambert digambar sesuai skala: kubu terbuka bukan cuma mendekat, seluruh rentangnya ikut menyempit.
Data penggunaan menunjuk ke arah yang sama. Di OpenRouter, pasar yang menyalurkan permintaan ke banyak model, pangsa token model asal AS jatuh dari sekitar 70% pada Juni 2025 menjadi sekitar 30% setahun kemudian, sementara model asal China kini rutin melewati 30%. Harga jadi alasan besar: model terbuka China umumnya 60% hingga 90% lebih murah per token, dan hosting muncul seketika, seperti diperjelas oleh endpoint K3 di hari nol itu.
Pergeseran yang lebih senyap adalah soal skala. Merek model terbuka China dulu adalah kecil, cepat, murah. K3 dengan 2,8 triliun parameter dan Qwen3.8-Max dengan 2,4 triliun justru kebalikannya — taruhan bahwa berpikir besar di ranah terbuka kini sepadan. GLM-5.2 dari Z.ai, yang rilis 16 Juni di bawah MIT dan memimpin kategori bobot terbuka Artificial Analysis Index dengan skor 51, adalah pesan yang sama dari lab keempat.
Kejutan: pemerintah yang memungkinkan ini bisa membatasinya
Lalu angin berbalik arah. Sekitar 22 hingga 25 Juli, Financial Times dan Reuters melaporkan bahwa Kementerian Perdagangan China sedang menimbang kontrol ekspor atas model AI — termasuk LLM bobot terbuka — dengan Alibaba, ByteDance, dan Z.ai disebut ikut dalam pembicaraan. Kerangka yang diapungkan bertingkat: kewajiban pelaporan untuk model yang lebih lemah, tinjauan keamanan untuk yang lebih kuat, dan kemungkinan larangan merilis secara terbuka model yang paling mampu. Belum ada yang menjadi undang-undang. Namun arahnya mencolok: gelombang ini mungkin sedang di puncaknya tepat saat pemerintahnya sendiri mulai memperlakukan model-model ini sebagai ekspor strategis, bukan kontribusi terbuka.
Intinya: ketika yang terbuka menjadi aset strategis
Cerita yang rapi berbunyi "China menyusul". Cerita yang lebih akurat berbunyi: bobot terbuka menjadi aset strategis begitu cepat sampai-sampai sebuah pemerintah kini ingin memegang keran. Dalam tiga minggu, model terbuka bergerak dari tertinggal dua-tiga kuartal di belakang frontier menjadi satu kuartal saja — dan dari kecil dan murah menjadi salah satu model terbesar yang pernah dipublikasikan dalam bentuk apa pun. Frontier terbuka tidak sekadar bergeser. Ia bergeser ke tempat yang pembuatnya mungkin tak lagi bebas untuk terus mengirim dari sana.
Bagi tim yang membangun di atas model-model ini, kesimpulan praktisnya tetap sama dan sedikit lebih tajam. Telli.sh sudah menjalankan model terbuka, Qwen3, di lapisan ringkasannya, sehingga setiap peningkatan kualitas dan harga model terbuka mengalir langsung ke transkripsi rapat, penerjemahan, dan ringkasan. Item barunya adalah pasokan: jika aturan ekspor China mendarat seperti yang diisyaratkan laporan, pertanyaan model terbuka mana yang tetap bebas diunduh adalah hal yang perlu dipantau, bukan diandaikan. Bahwa model yang memberi makan lapisan itu terus membaik adalah tren; dari mana model-model itu boleh datang adalah hal yang perlu terus diawasi.
Sumber
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
