[Notatnik pomysłów AI 04] Od decyzji w stylu Jev do obrazów: poznaj QEV, mały model oparty na Qwen
Dlaczego wokół Qwen powstają wizualne modele decyzyjne, co zmienia eksperymentalna obsługa obrazów Jev i gdzie mieści się lokalny projekt QEV klasy 2B.
Notatnik pomysłów AI przybliża idee i praktyczne możliwości nowych modeli i narzędzi AI.
Do procesu sortowania trafia zdjęcie. Aplikacja musi wybrać plastik, szkło lub metal, sprawdzić przynależność do podanej kategorii i zwrócić wartość użyteczną dla oprogramowania. Płynny opis butelki może być interesujący, lecz zostawia dodatkowy krok między modelem a decyzją.
Jev zwrócił uwagę na inny interfejs: podaj sytuację, pytanie i dozwolone odpowiedzi, a otrzymasz uporządkowaną decyzję z prawdopodobieństwami. Naturalne kolejne pytanie brzmi: czy interfejs zadziała również z tym, co model widzi, a nie tylko czyta?
Teraz działa w kilku postaciach. TypeSafe wprowadził eksperymentalną obsługę obrazów Jev 14 października 2026 r. Niezależne projekty adaptują również modele wizualno-językowe Qwen do decyzji w stylu Jev. Jednym z nich jest QEV, lokalny model na Qwen3.5-2B, oferujący wybór, uporządkowane oceny, decyzje logiczne i wstrzymanie się od odpowiedzi. Zapowiedź Jev, repozytorium QEV
Ujawnienie autora: QEV jest niezależnie utrzymywanym projektem autora tego wpisu. Wprowadzenie oddziela opublikowane wydanie od funkcji dostępnych tylko w źródłach i korzysta z publicznej dokumentacji oraz zapisanych przykładów; nie przedstawia nowej niezależnej oceny modelu.
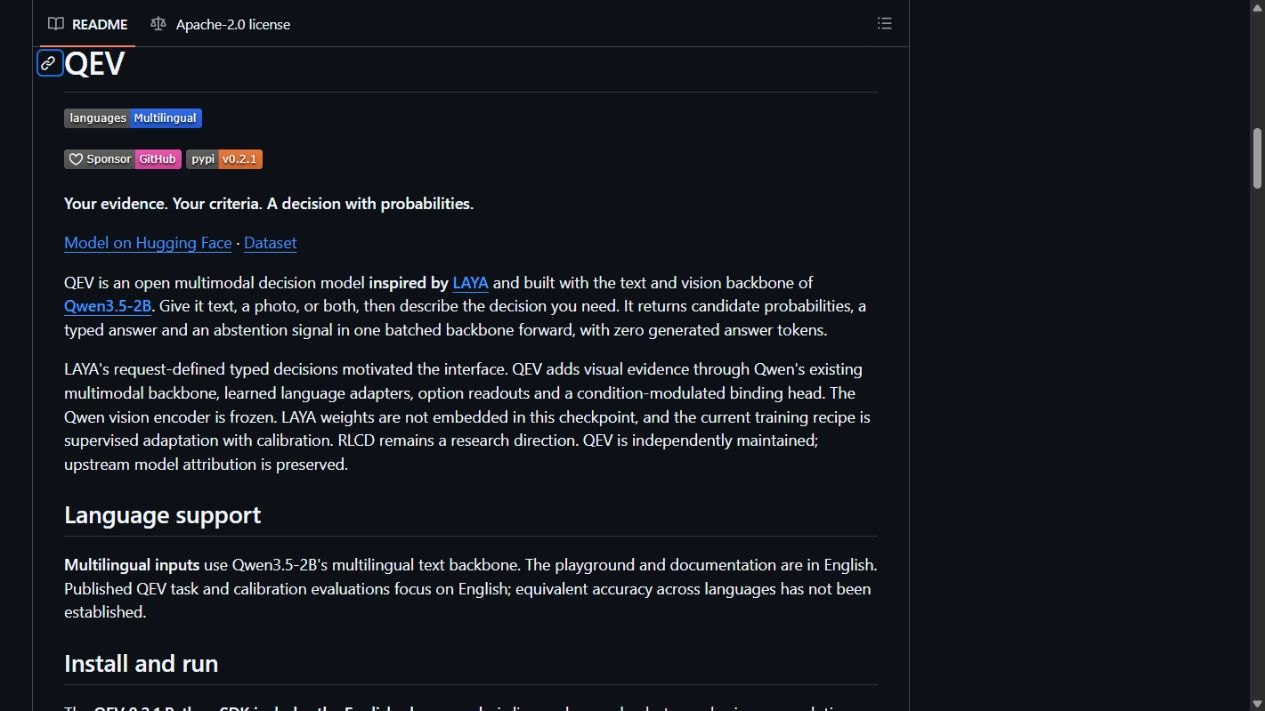 Publiczne repozytorium QEV, zrzut z 20 października 2026 r. To ekran dokumentacji, nie demonstracja lokalnego wnioskowania.
Dlaczego model decyzyjny różni się od chatbota
Chatbot zwykle pisze odpowiedź token po tokenie. Model decyzyjny przydaje się, gdy aplikacja zna już kształt odpowiedzi: wybór miejsca docelowego, ocena warunku na uporządkowanej skali albo rozstrzygnięcie prawdziwości stwierdzenia.
Odpowiedzi mogą zmieniać się w każdym żądaniu. System wsparcia oferuje dziś rozliczenia i pomoc techniczną, jutro doda odzyskiwanie konta. Sortowanie wizualne może podać sześć opisów materiału dla jednego pytania, a inny zestaw reguł postępowania dla drugiego. Model łączy bieżące dowody z opisami zamiast wybierać z trwale wyuczonej listy etykiet.
Znane typy Jev to choice, score i noul. W QEV wybór zwraca rozkład nad podanymi kandydatami. Ocena używa uporządkowanych poziomów i zwraca ich prawdopodobieństwa oraz poziom oczekiwany. Pytanie noul używa kryteriów prawdy i fałszu. To różne kontrakty wyjścia mimo wspólnego modelu bazowego. Dokumentacja API QEV
Prawdopodobieństwa ujawniają granicę: niewielka przewaga jednego kandydata może skierować sprawę do przeglądu zamiast automatycznej akcji. Nie czynią decyzji poprawną. Aplikacja nadal potrzebuje polityki niepewności, nieodpowiednich wejść i kosztu pomyłki.
Jev ma już eksperymentalną ścieżkę obrazu
Historyczna motywacja wymaga aktualizacji. Wprowadzanie QEV stwierdzeniem, że Jev obecnie nie przyjmuje obrazów, byłoby mylące. Październikowe ogłoszenie TypeSafe włącza eksperymentalne obrazy w Jev 1.13 i 1.14 za nagłówkiem TypeSafe-Danger-Zone-Images. Jev 1.14 dodaje także przestrzenny typ Box. Ogłoszenie określa te funkcje jako eksperymentalne. Zapowiedź Jev 1.14
To zmienia porównanie. Warto pytać, jakie wdrożenie, kontrakt wejścia i zachowanie decyzji pasują do procesu. Hostowany eksperyment Jev, model badawczy i lokalna adaptacja Qwen mogą dzielić ideę ograniczonych decyzji, znacznie różniąc się pakowaniem i obsługiwanymi operacjami.
QEV nie dokumentuje odpowiednika typu Box. Jest niezależną implementacją, nie wagami TypeSafe ani oficjalnym wydaniem Jev. Wspólne nazwy typów lub endpoint w stylu SystemOne to początek integracji, nie dowód przenośności każdego żądania bez zmian.
Dlaczego Qwen pojawia się w tych projektach
Model wizualno-językowy już łączy informacje tekstowe i obrazowe. To praktyczna baza projektu decyzyjnego: zachować rozumienie obrazu, potem dostosować powiązanie dowodów z odpowiedziami podanymi przez aplikację.
Dwa publiczne przykłady pokazują kierunek szerszy niż jedno repozytorium:
| Projekt | Publicznie opisane podejście | Jak rozumieć stan projektu |
|---|---|---|
| PixelJev | Bada wizualny wybór w stylu Jev na małych modelach Qwen3.5, w tym 2B i 4B | Praca badawcza o wyborze wizualnym, nie dowód kompletnego zastępstwa hostowanego Jev |
| AutoTrust JEV-27B-VL | Używa Qwen3.8-27B z głowicą decyzyjną i adapterami | Niezależny większy model; karta rozróżnia decyzje uczone na tekście i obrazy zero-shot |
| QEV | Adaptuje Qwen3.5-2B do decyzji choice, score i noul | Lokalny projekt klasy 2B z wydanym SDK i osobno opisanymi rozszerzeniami źródeł |
Praca PixelJev pomaga zrozumieć architekturę: połączenie obrazów i kandydatów podawanych w żądaniu z odczytem decyzyjnym. Karta AutoTrust pokazuje większą skalę, zaznaczając brak ustalonej systematycznej kalibracji wizualnej. To przykłady rodzącego się wzorca, nie ranking benchmarku ani zestaw jednakowo zgodnych produktów. Praca PixelJev, karta AutoTrust
Miejsce QEV to niewielkie wdrożenie lokalne. „Mały” oznacza klasę modelu bazowego względem znacznie większych modeli wizualno-językowych; nie oznacza kilku megabajtów całej instalacji ani natychmiastowej pracy na dowolnym urządzeniu.
Jak QEV zamienia obraz w decyzję
QEV używa jednego tekstowo-wizualnego Qwen3.5-2B. Opublikowana architektura dodaje adaptację po stronie języka i odczyt wiążący sytuację oraz pytanie z opisami kandydatów. Bezpośrednio ocenia kandydatów, zamiast generować zdanie i wyciągać etykietę osobnym parserem. Publiczna karta modelu
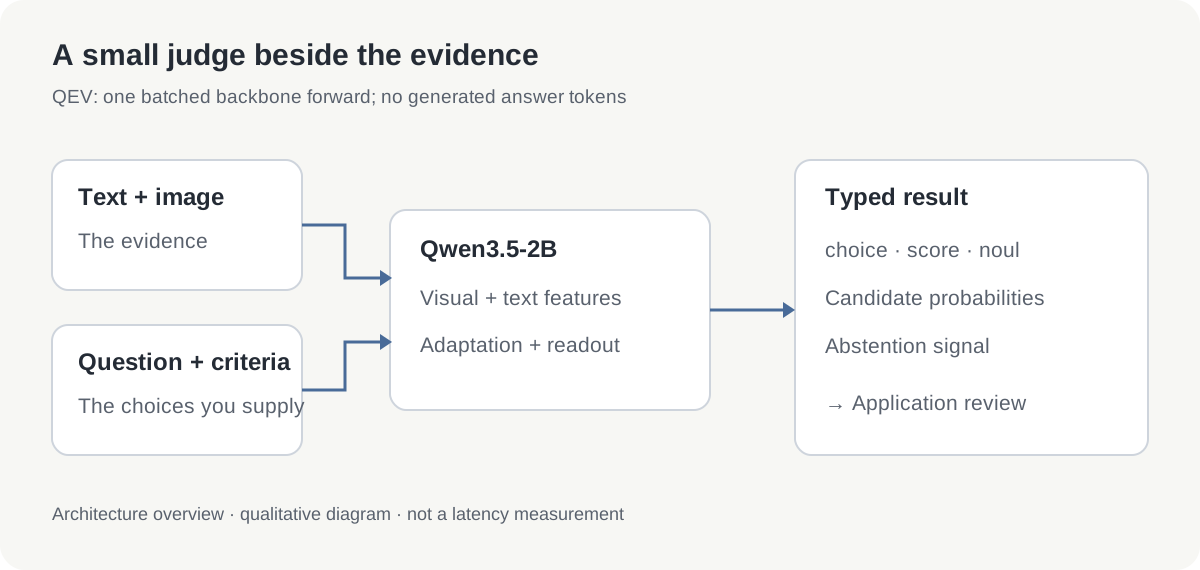 Autorski schemat. Strzałki opisują udokumentowaną ścieżkę decyzji, nie zmierzone porównanie szybkości.
W wydanym SDK żądanie może zawierać tekst, jeden obraz albo oba. Obsługuje od jednego do czterech pytań, od dwóch do szesnastu kandydatów choice i od dwóch do szesnastu uporządkowanych poziomów score. Pozwala zebrać powiązane decyzje bez osobnej rozmowy dla każdego pytania. Dokumentacja API
Rozważ zdjęcie z instrukcją „Wybierz materiał według tych opisów”. Drugie pytanie ustala pasmo polityki, trzecie zgodność przedmiotu z warunkiem logicznym. Zdjęcie jest wspólnym dowodem, a kryteria definiują znaczenie decyzji.
Udokumentowane wnioskowanie generuje zero tokenów odpowiedzi. Usuwa to źródło zmienności formatowania, lecz nie encoder obrazu, obliczenia modelu, przygotowanie obrazu ani narzut aplikacji. „Brak generowanej odpowiedzi” i „brak kosztu obliczeń” to zupełnie inne twierdzenia.
Traktuj przykład butelki jako przykład
Repozytorium QEV zawiera licencjonowane zdjęcie plastikowej butelki i zapisany wynik. Pokazuje strukturę odpowiedzi jeszcze przed instalacją.
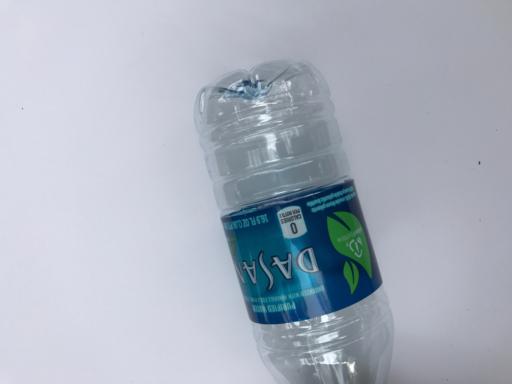 Opublikowane wejście z przykładu fotograficznego QEV, pierwotnie z TrashNet. Copyright 2017 Gary Thung, licencja MIT; zachowano informację licencyjną.
| Pytanie w opublikowanym przykładzie | Zapisany wynik | Znaczenie |
|---|---|---|
| Wybór z sześciu materiałów | Plastik, prawdopodobieństwo około 0.9361 | Plastik ma największy udział spośród podanych kandydatów |
| Wybór uporządkowanego pasma polityki | Poziom oczekiwany około 0.4254 na skali 0–2 | Średnia ważona trzech podanych indeksów pasm |
| Czy należy do szkła, papieru lub plastiku? | Prawda, prawdopodobieństwo około 0.7903 | Kryterium prawdy wygrywa z alternatywą fałszu |
Ocena wymaga uwagi. Pasmo 0 grupuje szkło i plastik, 1 metal i śmieci, a 2 karton i papier. Kolejność to przykładowa polityka. Liczba 0.4254 nie jest oceną bezpieczeństwa, standardem recyklingu ani pewnością wyboru materiału.
Podobnie prawdopodobieństwo plastiku opisuje to żądanie i kandydatów. Nie dowodzi poprawnej klasyfikacji 93.61% wszystkich zdjęć butelek. To wcześniej przejrzany przykład wydania, nie nowy odłożony test; wynik zapisał projekt, nie odtworzono go do artykułu.
Co powinno tu oznaczać „zgodny z Jev”
Zgodność łatwiej rozumieć warstwowo: wspólna idea decyzji definiowanych w żądaniu, dokładny schemat JSON, obsługiwane wejścia i zachowanie typów wyjścia. Dopasowanie jednej warstwy nie zapewnia pozostałych.
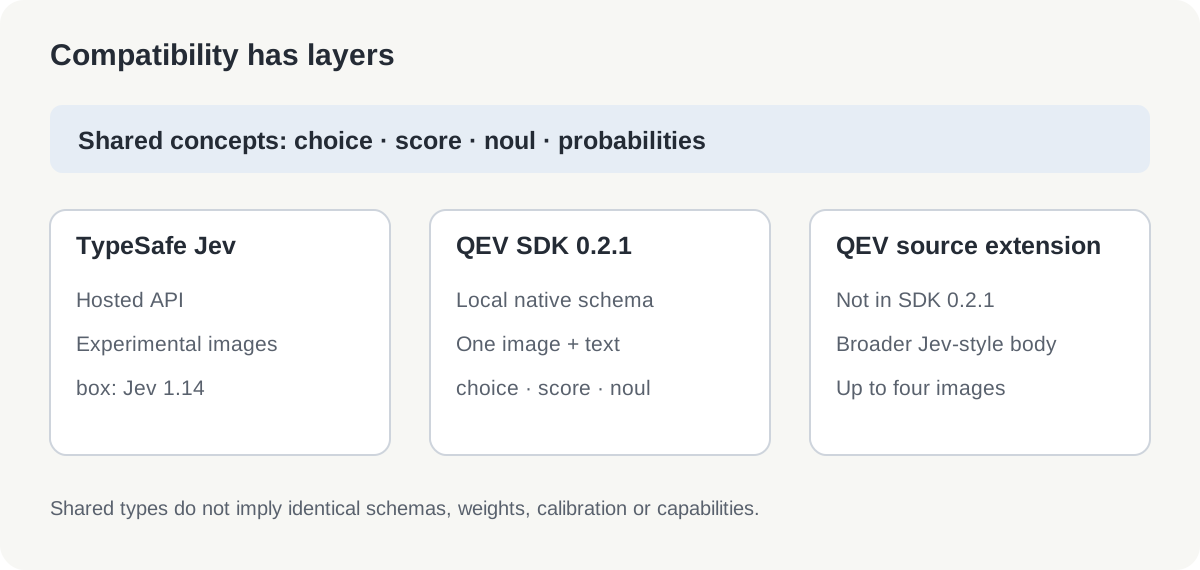 Autorska mapa zgodności, sprawdzona 20 października 2026 r. Rozszerzenia źródeł są oddzielne od kontraktu pakowanego SDK.
Pakiet SDK QEV 0.2.1 używa natywnego schematu QEV i jednego opcjonalnego obrazu. Publiczne źródła dokumentują również szerszą obsługę żądań Jev/SystemOne i do czterech uporządkowanych obrazów. Nie zakładaj obecności tych rozszerzeń w opublikowanym pakiecie 0.2.1. API i informacje o wydaniu, wydanie 0.2.1
Przy integracji zacznij od znanego żądania i porównaj walidację, pola odpowiedzi, kolejność kandydatów i niepewność. Sama trasa /v1/systemone nie dowodzi uniwersalnej zamienności usługi lub SDK TypeSafe.
Praktyczny pierwszy kontakt
Na początek lokalny playground łatwiej obejrzeć niż integrację aplikacji.
- Przygotuj i aktywuj środowisko Python 3.12.
- Zainstaluj przypięte wydanie i uruchom playground poniższymi poleceniami.
- Otwórz
http://127.0.0.1:7860, wybierz przykład i obejrzyj prawdopodobieństwa oraz wstrzymanie odpowiedzi.
python -m pip install qev==0.2.1
qev playground
Udokumentowany playground działa lokalnie pod http://127.0.0.1:7860. Ma przykładowe zdjęcia i pokazuje prawdopodobieństwa, wstrzymanie oraz uporządkowane wyjście. Interfejs i dokumentacja są po angielsku. To instrukcje wydania, nie deklaracja instalacji lub pomiaru do wpisu. Przewodnik playground
Małe żądanie tekstowe pokazuje kształt natywnego SDK:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Zacznij od dwóch lub trzech wyraźnie różnych kandydatów. Potem wypróbuj przypadek niejednoznaczny i niepasujący do żadnego. Sprawdź, czy wstrzymanie i polityka aplikacji dają użyteczny wynik. W testach obrazowych używaj zdjęć, do których przetwarzania masz prawo, a kryteria opieraj na widocznych dowodach, nie nieustalalnych faktach.
Zaplanuj zasoby na model bazowy, nie tylko adapter
Dla starszej ścieżki SDK 0.2.1 punkt kontrolny adaptacji QEV ma około 32.01 MB, a osobny Qwen do pobrania około 4.55 GB. Zestawienie podaje około 2.213 miliarda parametrów modelu bazowego i 7.992 miliona adaptacji oraz odczytu. Poniższe październikowe QEV-0.8B i QEV-2B używają osobnej ścieżki ładowania wydania. Rozmiary modelu SDK
Pierwsza konfiguracja wymaga więc gigabajtów. Potem można używać pamięci podręcznej, ale pamięć wykonawcza obejmuje też aktywacje, przetwarzanie obrazów i bufory. Ścieżki GPU i CPU stosują różną precyzję. Bajty punktu kontrolnego pomagają planować dysk, nie obiecują pamięci, przepustowości ani zużycia baterii danego komputera.
Jeśli 2B przeciąża komputer, spróbuj QEV-0.8B
Październikowe wydanie obejmuje QEV-0.8B, zbudowany na Qwen3.5-0.8B i destylowany od tego samego nauczyciela co nowszy QEV-2B. To praktyczny początek, gdy pamięć GPU lub czas odpowiedzi utrudnia użycie 2B. Mniejszy model zachowuje decyzje definiowane w żądaniu, wymieniając część jakości wizualnej na niższe zużycie zasobów. Karta 0.8B, karta 2B
| Opublikowana miara | QEV-0.8B | Październikowy QEV-2B | Różnica |
|---|---|---|---|
| Publiczny wizualny Decision Index, tryb accurate | 53.02 | 61.99 | 2B wyżej o 8.97 punktu indeksu |
| Szczytowa alokacja GPU, tryb accurate | 1.86 GiB | 4.44 GiB | 0.8B zużywa około 58% mniej |
| Mediana opóźnień p50 profili żądań | 66.0 ms | 135.3 ms | Około 51% mniej dla 0.8B |
| Najwyższe p95 profili żądań | 377.3 ms | 738.6 ms | Około 49% mniej dla 0.8B |
| Szczytowa alokacja GPU, tryb fast | 1.60 GiB | 4.13 GiB | 0.8B oszczędza 2.53 GiB |
| Wynik RealWorldQA | 39.2 | 56.2 | 2B wyżej o 17.0 punktów |
| Wynik Winoground | 47.5 | 65.5 | 2B wyżej o 18.0 punktów |
| Wynik InfographicVQA | 75.4 | 83.1 | 2B wyżej o 7.7 punktu |
To pomiary dewelopera sprawdzone 20 października 2026 r. Indeks oceniono samodzielnie na publicznym zestawie wizualnym, edycja 0.3.2, w oczekiwaniu na oficjalny przebieg; nie jest odsetkiem ogólnej trafności. Przedział sparowanego bootstrapu dla różnicy 8.97 punktu wynosi 7.39–10.48 punktu. Poszczególne benchmarki pokazują zależność luki od zadania.
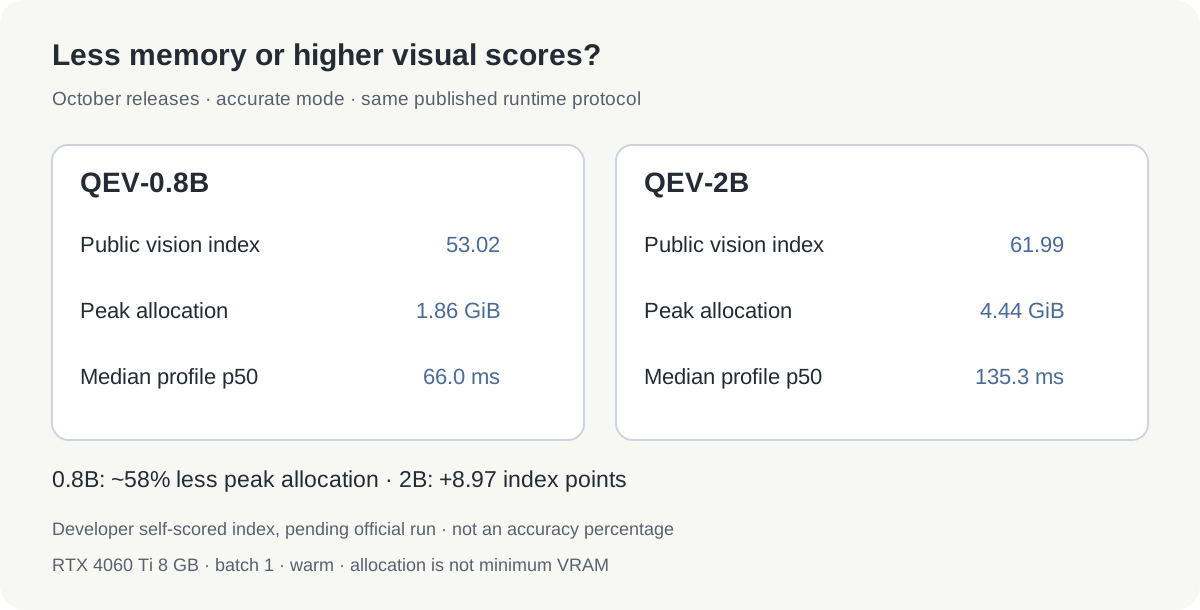 Autorska infografika na podstawie dwóch przypiętych kart. Indeks oceniono samodzielnie; pamięć i czas dotyczą trybu accurate na badanym GPU.
Pomiary używają RTX 4060 Ti 8 GB, batch 1, rozgrzanego modelu i 47 profili żądań, z trzema rozgrzewkami i 30 mierzonymi przebiegami każdego profilu. Tryb accurate dopuszcza do 1.6 MP na obraz. Pamięć to szczytowa alokacja PyTorch, nie minimalna pojemność karty: sterowniki, inne aplikacje i wejścia też potrzebują miejsca. Czasy wykluczają pobranie i ładowanie, nie przewidują wydajności CPU.
Tryb fast ogranicza obrazy do 0.26 MP i kończy obliczenia na warstwie 16 z 24. Dla 0.8B mediana p50 spada do 44.6 ms, a najgorsze p95 do 123.2 ms. Wewnętrzna trafność DEV spada z 86.0% w accurate do 82.0%, szczególnie dla dokumentów, wykresów i ekranów. Nie podano publicznego Decision Index dla fast; wynik 53.02 należy do accurate.
Dla tych punktów kontrolnych użyj osobnego środowiska Python 3.12. Stary pakiet qev==0.2.1 nie ładuje wydania 0.8B:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Przekaż DecisionRequest do model.predict(request), jak wcześniej. Zacznij od 0.8B accurate, potem spróbuj fast, jeśli zasobów nadal brakuje. Przejdź do 2B, gdy błędy reprezentatywnych wejść uzasadnią pamięć i czas, zachowując te same dane oraz opisy kandydatów.
Gdzie próbować i gdzie kończą się dowody
Dobre pierwsze eksperymenty mają widoczne dowody i ograniczone skutki: skierowanie obrazu dokumentu do kolejki przeglądu, kategoryzacja zdjęcia przedmiotu lub wybór najlepszego opisu obsługi. Zachowaj ścieżkę oceny przez człowieka podczas pomiaru korzyści.
Wybierz mały reprezentatywny zestaw przed zmianą promptów. Zapisuj trafność zaakceptowanych decyzji, odsetek wstrzymań i przepuszczone błędy. Powtarzaj dla oświetlenia, jakości i języków. QEV dziedziczy wielojęzyczne wejście modelu bazowego, ale opublikowane dowody trafności i kalibracji skupiają się na angielskim; równość dla koreańskiego i innych języków wymaga testu. Publiczna karta modelu
Oceny starszego modelu SDK ograniczają też obietnice. W porównaniu 2,000 pytań o decyzje typowane QEV uzyskał 77.00%, a tekstowy specjalista LAYA 76.95% — różnica jednego pytania, ze sparowanym przedziałem ufności obejmującym zero. To nie dowód ogólnej przewagi ani bezpośrednie porównanie z hostowanym Jev. Starsze wyniki są oddzielne od październikowego porównania powyżej. Specjalizacja tekstowa może też być szybsza we własnych warunkach. Metodyka i wyniki porównania
Rozumowanie wizualne pozostaje nierówne. Eksploracyjna ocena 2048 projektu nie wykazała wygranej w 72 próbach. Mały model rozpoznający materiały na zdjęciu nie jest automatycznie niezawodnym planistą przestrzennym. Notatki oceny
QEV warto badać, gdy jednocześnie liczy się lokalna praca, mały model bazowy i jawne wyjścia decyzyjne. Eksperymentalne obrazy Jev i inne projekty Qwen pokazują szerszy kierunek: więcej aplikacji poprosi model o ograniczony osąd obrazu, a zwykłe oprogramowanie zdecyduje, co z nim zrobić.
Źródła
Źródła sprawdzono 20 października 2026 r. Architektura, przykłady i granice wydań dotyczą przypiętych publicznych źródeł QEV i SDK 0.2.1. Szerszy kontekst pochodzi z ogłoszenia Jev firmy TypeSafe, pracy PixelJev i karty AutoTrust. Obraz główny to redakcyjny zrzut publicznego README QEV; źródła mediów i prawa zapisano oddzielnie.
Zachowaj oryginalne dowody obok decyzji, aby wrócić do błędnej klasyfikacji lub zmienionej polityki. Utwórz konto Telli.sh, by zbierać źródła, notatki i dalsze badania w jednym przeszukiwalnym miejscu.