[AI 아이디어 노트 04] Jev식 판단을 이미지로 확장하기: 소형 Qwen 기반 모델 QEV 소개
Qwen 기반 시각 판단 모델이 등장하는 배경, Jev의 실험적 이미지 지원 현황, 로컬에서 실행하는 2B급 QEV의 특징과 활용 범위를 살펴봅니다.
AI 아이디어 노트는 이제 막 등장한 AI 모델·도구의 발상과 활용 가능성을 살펴보는 연재입니다.
물건을 분류하는 업무에 사진 한 장이 들어왔다고 가정해 보겠습니다. 애플리케이션은 플라스틱·유리·금속 중 하나를 고르고, 지정한 분류 조건에 해당하는지 확인한 뒤 소프트웨어가 바로 사용할 수 있는 값을 받아야 합니다. 병의 모습을 유창하게 설명하는 문장도 도움이 되겠지만, 실제 판단에 활용하려면 그 문장을 다시 처리해야 합니다.
Jev는 다른 방식의 인터페이스에 관심을 모았습니다. 상황과 질문, 허용할 답을 주면 확률이 포함된 구조화된 판단을 받는 방식입니다. 여기서 자연스럽게 다음 질문이 나옵니다. 읽은 내용뿐 아니라 본 내용에도 같은 인터페이스를 적용할 수 있을까요?
지금은 여러 형태로 가능합니다. TypeSafe는 2026년 10월 14일 Jev의 실험적 이미지 지원을 발표했습니다. 독립 프로젝트에서도 Qwen 비전 언어 모델을 활용해 Jev식 판단을 구현하고 있습니다. 그중 QEV는 Qwen3.5-2B를 기반으로 선택, 순서형 점수, 참·거짓 판단, 판단 보류를 제공하는 로컬 모델입니다. Jev 발표, QEV 저장소
이해관계를 먼저 밝힙니다. QEV는 이 글의 작성자가 독립적으로 개발·관리하는 프로젝트입니다. 이 글은 공개 문서와 기록된 예제를 바탕으로 배포 버전과 소스 전용 기능을 구분해 소개합니다. 새로 실시한 독립 모델 평가 결과를 제시하는 글은 아닙니다.
 2026년 10월 20일 캡처한 QEV 공개 저장소입니다. 문서 화면이며, 로컬 추론 실행을 보여주는 화면은 아닙니다.
챗봇과 판단 모델은 어떻게 다른가
챗봇은 보통 답변을 토큰 단위로 생성합니다. 판단 모델은 애플리케이션이 이미 답의 형태를 알고 있을 때 유용합니다. 전달할 부서를 고르거나, 순서가 있는 척도로 상태를 평가하거나, 어떤 조건이 성립하는지 판단하는 경우입니다.
답의 후보는 요청마다 바뀔 수 있습니다. 고객 지원 시스템이 오늘은 결제와 기술 지원 중에서 고르도록 하고, 내일은 계정 복구를 추가할 수 있습니다. 사진 분류 업무에서도 어떤 질문에는 여섯 가지 재질 설명을 주고, 다른 질문에는 별도의 처리 규칙을 줄 수 있습니다. 모델은 고정된 학습 라벨만 선택하는 대신 현재 증거와 이번 요청의 설명을 연결해야 합니다.
Jev에서 익숙한 판단 유형은 choice, score, noul입니다. QEV에서 choice는 주어진 후보들의 확률 분포를 반환합니다. score는 순서가 있는 수준들을 받아 각 확률과 기대 수준을 반환합니다. noul은 참과 거짓의 기준을 사용합니다. 같은 기반 모델을 사용하더라도 세 유형이 뜻하는 출력은 서로 다릅니다. QEV API 문서
확률은 판단 경계를 드러내 줍니다. 두 후보의 차이가 작으면 자동 처리 대신 검토로 보낼 수 있습니다. 다만 확률이 있다고 해서 판단이 정확해지는 것은 아닙니다. 불확실하거나 적합하지 않은 입력을 처리할 방법과 오류 비용은 애플리케이션에서 정해야 합니다.
Jev에도 실험적 이미지 입력이 있다
처음의 문제의식을 소개할 때도 현재 상황은 반영해야 합니다. 지금 Jev가 이미지를 받을 수 없다고 설명하면 부정확합니다. TypeSafe의 10월 발표에 따르면 Jev 1.13과 1.14에서 TypeSafe-Danger-Zone-Images 헤더를 통해 실험적 이미지 입력을 사용할 수 있습니다. Jev 1.14에는 공간 정보를 다루는 Box 유형도 추가됐습니다. 발표에서는 이미지 기능을 실험적 기능으로 설명합니다. Jev 1.14 발표
따라서 비교의 초점도 달라집니다. 특정 업무에 어떤 배포 방식과 입력 규격, 판단 동작이 맞는지 살펴보는 것이 중요합니다. 호스팅된 Jev의 실험 기능, 연구용 모델, 로컬 Qwen 파생 모델은 제한된 후보 안에서 판단한다는 아이디어를 공유하면서도 제공 형태와 지원 기능은 상당히 다를 수 있습니다.
QEV에는 Jev의 Box에 대응하는 기능이 문서화되어 있지 않습니다. QEV는 독립 구현이며 TypeSafe의 가중치나 공식 Jev 배포판이 아닙니다. 판단 유형의 이름이나 SystemOne 형태의 엔드포인트가 같다는 사실은 연동의 출발점입니다. 모든 요청을 그대로 옮길 수 있다는 뜻은 아닙니다.
이 흐름에서 Qwen이 활용되는 이유
비전 언어 기반 모델은 텍스트와 이미지 정보를 하나의 모델에서 함께 다룹니다. 판단 모델을 만드는 입장에서는 실용적인 출발점이 됩니다. 시각 이해 능력을 활용하면서, 입력 증거와 애플리케이션이 제공한 답의 후보를 연결하는 방식을 조정할 수 있기 때문입니다.
다음 공개 사례를 보면 하나의 저장소에만 국한된 흐름이 아니라는 것을 알 수 있습니다.
| 프로젝트 | 공개된 접근 방식 | 공개 상태를 이해하는 방법 |
|---|---|---|
| PixelJev | 2B·4B 변형을 포함한 소형 Qwen3.5 기반 모델로 Jev식 시각 선택을 연구 | 시각 선택에 관한 연구 논문이며, 완전한 호스팅 Jev 대체 제품이 공개됐다는 뜻은 아님 |
| AutoTrust JEV-27B-VL | Qwen3.8-27B에 판단 헤드와 어댑터를 적용 | 독립적인 대형 모델이며, 모델 카드에서 텍스트로 학습한 판단과 제로샷 이미지 활용을 구분 |
| QEV | Qwen3.5-2B를 choice·score·noul 판단에 맞게 조정 | 배포된 SDK와 별도로 설명된 소스 확장 기능을 갖춘 로컬 2B급 프로젝트 |
PixelJev 논문은 이미지와 요청 시점의 후보들을 판단 출력에 연결하는 구조를 이해하는 데 도움이 됩니다. AutoTrust 모델 카드는 더 큰 규모의 구현 사례를 보여주면서 시각 입력의 체계적인 확률 보정 검증이 확립되지 않았다고 설명합니다. 위 사례들은 새롭게 나타나는 설계 흐름을 보여줍니다. 벤치마크 순위나 동일한 호환성을 갖춘 제품 목록은 아닙니다. PixelJev 논문, AutoTrust 모델 카드
이 가운데 QEV가 지향하는 위치는 비교적 작은 모델의 로컬 실행입니다. 여기서 ‘소형’은 훨씬 큰 비전 언어 모델과 비교한 기반 모델의 규모를 뜻합니다. 전체 설치 용량이 수 MB이거나 모든 기기에서 즉시 실행된다는 의미는 아닙니다.
QEV는 이미지를 어떻게 판단으로 연결하나
QEV는 텍스트와 비전을 함께 다루는 Qwen3.5-2B 기반 모델 하나를 사용합니다. 공개된 구조에서는 언어 측 적응과 판단 출력 계층을 추가해 상황·질문을 제공된 후보 설명과 연결합니다. 답변 문장을 생성하고 별도 파서로 라벨을 추출하는 대신 후보들의 점수를 직접 계산합니다. 공개 모델 카드
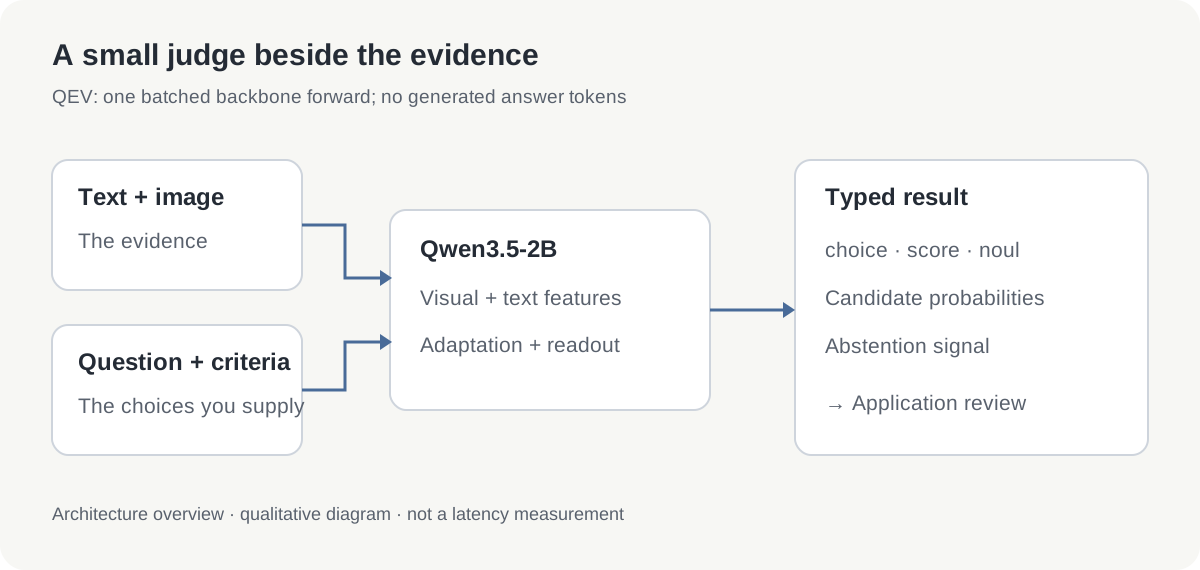 직접 제작한 구조 설명 그림입니다. 화살표는 문서화된 판단 흐름을 나타내며 측정된 속도 비교가 아닙니다.
배포된 SDK에서는 요청 하나에 텍스트, 이미지 한 장, 또는 둘 다 넣을 수 있습니다. 질문은 한 번에 14개를 지원하며 choice의 후보와 score의 순서형 수준은 각각 216개입니다. 관련된 소수의 판단을 묶을 수 있어 질문마다 별도의 채팅 대화를 만들 필요가 없습니다. API 문서
사진에 “다음 설명에 따라 재질을 고르세요”라는 짧은 지시를 붙일 수 있습니다. 두 번째 질문에서는 적용할 처리 구간을, 세 번째 질문에서는 제시한 참·거짓 조건에 해당하는지를 물을 수 있습니다. 사진은 함께 사용하는 증거이고, 각 판단의 의미는 질문별 기준이 정합니다.
문서화된 추론 경로는 답변 토큰을 생성하지 않습니다. 답변 형식이 흔들리는 원인 하나를 줄여 주지만, 비전 인코더와 기반 모델의 연산, 이미지 전처리, 애플리케이션 처리 비용까지 없어지는 것은 아닙니다. 답변 생성이 없다는 것과 계산 비용이 없다는 것은 구분해야 합니다.
병 사진 예제로 출력 읽어보기
QEV 저장소에는 라이선스가 명시된 플라스틱병 사진과 기록된 출력이 있습니다. 설치하기 전에 응답 구조를 이해하기 좋은 예제입니다.
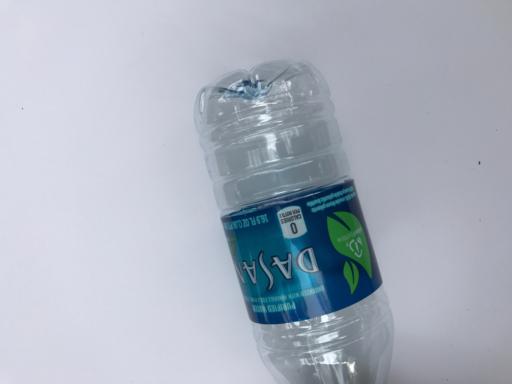 QEV 사진 예제의 공개 입력 이미지이며 원출처는 TrashNet입니다. Copyright 2017 Gary Thung, MIT 라이선스이며 라이선스 고지를 함께 보관했습니다.
| 공개 예제의 질문 | 기록된 결과 | 의미 |
|---|---|---|
| 여섯 가지 재질 중 선택 | 플라스틱, 확률 약 0.9361 | 제시된 후보들 중 플라스틱에 가장 큰 확률을 배정 |
| 순서가 있는 처리 구간 선택 | 0~2 척도에서 기대 수준 약 0.4254 | 제시된 세 구간 인덱스의 확률 가중 평균 |
| 유리·종이·플라스틱 중 하나에 속하는가 | 참, 확률 약 0.7903 | 거짓 조건보다 참 조건을 더 지지 |
점수는 특히 주의해서 읽어야 합니다. 이 예제의 구간 0은 유리와 플라스틱, 구간 1은 금속과 일반 쓰레기, 구간 2는 판지와 종이를 묶습니다. 순서는 예제에서 정한 정책입니다. 따라서 0.4254는 안전 등급이나 재활용 표준, 재질 선택의 신뢰도를 뜻하지 않습니다.
플라스틱 확률 역시 이번 요청과 후보들에 대한 값입니다. 모든 병 사진의 93.61%를 정확히 분류한다는 근거가 아닙니다. 이 사진은 배포 과정에서 이미 살펴본 예제이며 새로운 독립 평가 입력이 아닙니다. 위 출력도 이 글을 위해 재실행한 결과가 아니라 프로젝트가 공개한 기록입니다.
여기서 ‘Jev 호환’은 어느 범위를 뜻하나
호환성은 여러 층으로 나누면 이해하기 쉽습니다. 요청마다 후보를 정의하는 판단 방식, 정확한 JSON 규격, 지원 입력, 각 출력 유형의 동작이 있습니다. 한 층이 같다고 나머지까지 자동으로 같아지는 것은 아닙니다.
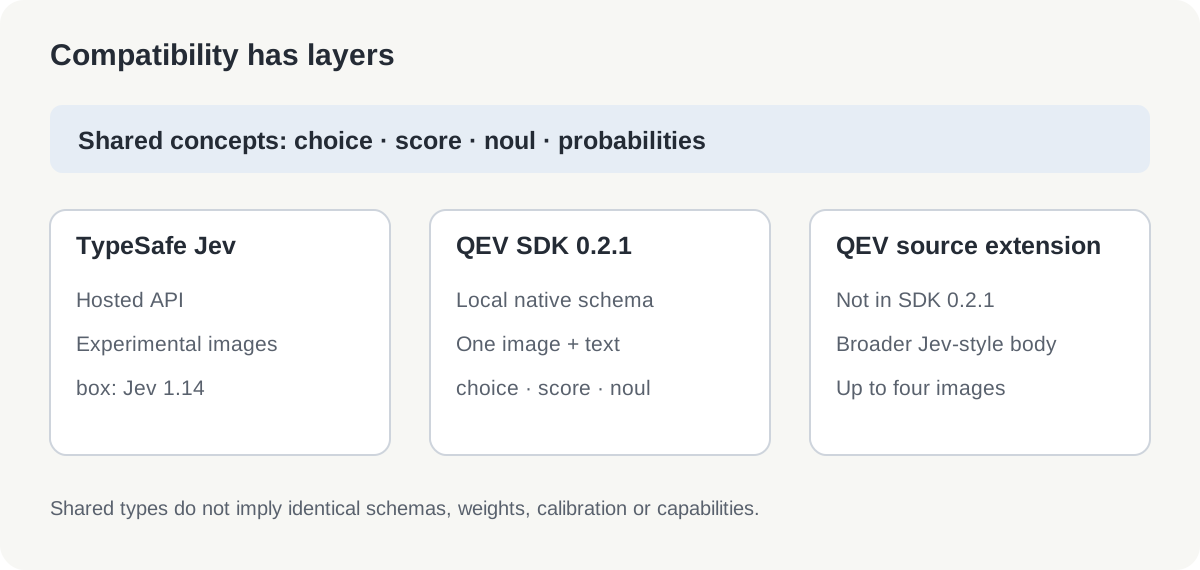 2026년 10월 20일 기준으로 직접 제작한 호환 범위 그림입니다. 소스 확장과 배포 패키지의 지원 규격을 구분했습니다.
배포된 QEV 0.2.1 SDK는 QEV 고유 요청 규격과 선택적 이미지 한 장을 사용합니다. 공개 소스에는 더 넓은 Jev/SystemOne 형태의 요청 처리와 순서를 가진 이미지 최대 네 장을 다루는 확장도 설명되어 있습니다. 이 소스 확장이 배포된 0.2.1 패키지에 이미 포함됐다고 가정하면 안 됩니다. API와 배포 설명, 0.2.1 릴리스
연동할 때는 알고 있는 요청 하나부터 입력 검증, 응답 필드, 후보 순서, 불확실성 처리를 비교하는 것이 좋습니다. 익숙한 /v1/systemone 경로가 있다는 사실만으로 TypeSafe 서비스나 SDK를 그대로 대체할 수 있다고 판단해서는 안 됩니다.
처음 살펴보는 방법
처음에는 애플리케이션 연동보다 로컬 플레이그라운드에서 출력을 살펴보는 편이 간단합니다.
- Python 3.12 환경을 준비하고 활성화합니다.
- 아래 명령으로 버전을 지정해 설치하고 플레이그라운드를 실행합니다.
http://127.0.0.1:7860을 열어 예제를 고르고 후보별 확률과 판단 보류를 확인합니다.
python -m pip install qev==0.2.1
qev playground
문서에 따르면 플레이그라운드는 로컬 http://127.0.0.1:7860에서 실행됩니다. 예제 사진과 함께 확률, 판단 보류, 구조화된 출력을 확인할 수 있습니다. 인터페이스와 문서는 영어입니다. 위 명령은 배포판의 설치 안내이며, 이 글을 위해 모델을 설치하거나 실행 시간을 측정했다는 의미는 아닙니다. 플레이그라운드 안내
간단한 텍스트 요청으로 고유 SDK의 형태를 볼 수 있습니다.
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
먼저 차이가 분명한 후보 두세 개로 시작해 보세요. 그다음 모호한 사례와 어느 후보에도 맞지 않는 사례를 넣어 판단 보류와 애플리케이션 정책이 유용하게 작동하는지 살펴보면 됩니다. 이미지는 처리할 권리가 있는 사진을 사용하고, 사진으로 알 수 없는 사실보다 눈으로 확인할 수 있는 증거를 기준으로 질문을 작성하는 것이 좋습니다.
어댑터와 기반 모델의 용량을 함께 확인하기
앞서 안내한 기존 SDK 0.2.1에서는 QEV 적응 체크포인트 약 32.01 MB와 별도로 약 4.55 GB의 Qwen 기반 모델을 내려받습니다. 공개 용량 설명에는 기반 모델 약 22.13억 개, 적응·출력 계층 약 799.2만 개의 파라미터가 기재되어 있습니다. 아래의 새로운 10월 QEV-0.8B·QEV-2B 체크포인트는 별도의 배포 모델 로딩 경로를 사용합니다. SDK 모델 용량 설명
따라서 최초 준비에는 GB 단위의 다운로드가 필요합니다. 이후에는 캐시된 모델 파일을 사용할 수 있지만, 실행 메모리에는 중간 계산값과 이미지 처리, 버퍼도 포함됩니다. 문서화된 GPU·CPU 실행 경로는 수치 정밀도도 다릅니다. 체크포인트 파일 크기는 저장 공간 계획에 유용하지만 특정 기기의 메모리, 처리량, 배터리 사용량까지 보장하지 않습니다.
2B가 부담스럽다면 QEV-0.8B부터 실험해 보자
10월 배포 모델에는 QEV-0.8B도 있습니다. Qwen3.5-0.8B를 기반으로 하며 새로운 QEV-2B와 같은 교사 모델에서 증류했습니다. GPU 메모리나 응답 시간 때문에 2B 실행이 부담스러울 때 먼저 실험해 볼 수 있는 선택지입니다. 요청마다 판단 기준을 정의하는 방식은 같고, 더 적은 자원을 사용하는 대신 일부 시각 판단 성능을 양보합니다. 0.8B 모델 카드, 2B 모델 카드
| 공개 측정 항목 | QEV-0.8B | 10월 QEV-2B | 격차 |
|---|---|---|---|
| 공개 시각 Decision Index, accurate 모드 | 53.02 | 61.99 | 2B가 지수 8.97점 높음 |
| GPU 메모리 할당 피크, accurate 모드 | 1.86 GiB | 4.44 GiB | 0.8B가 약 58% 적게 사용 |
| 요청 유형별 p50 지연 시간의 중앙값 | 66.0 ms | 135.3 ms | 0.8B의 지연 시간이 약 51% 짧음 |
| 요청 유형별 p95 지연 시간 중 최댓값 | 377.3 ms | 738.6 ms | 0.8B의 지연 시간이 약 49% 짧음 |
| GPU 메모리 할당 피크, fast 모드 | 1.60 GiB | 4.13 GiB | 0.8B가 2.53 GiB 적게 사용 |
| RealWorldQA 점수 | 39.2 | 56.2 | 2B가 17.0점 높음 |
| Winoground 점수 | 47.5 | 65.5 | 2B가 18.0점 높음 |
| InfographicVQA 점수 | 75.4 | 83.1 | 2B가 7.7점 높음 |
2026년 10월 20일 확인한 개발자의 공개 측정값입니다. 지수는 공개 시각 평가 도구 0.3.2로 자체 채점한 결과이며 공식 실행을 기다리는 상태입니다. 전체 정확도 백분율을 뜻하지 않습니다. 두 모델의 8.97점 차이에 대한 대응 부트스트랩 구간은 7.39~10.48점입니다. 개별 평가를 보면 업무에 따라 격차가 달라진다는 점도 알 수 있습니다.
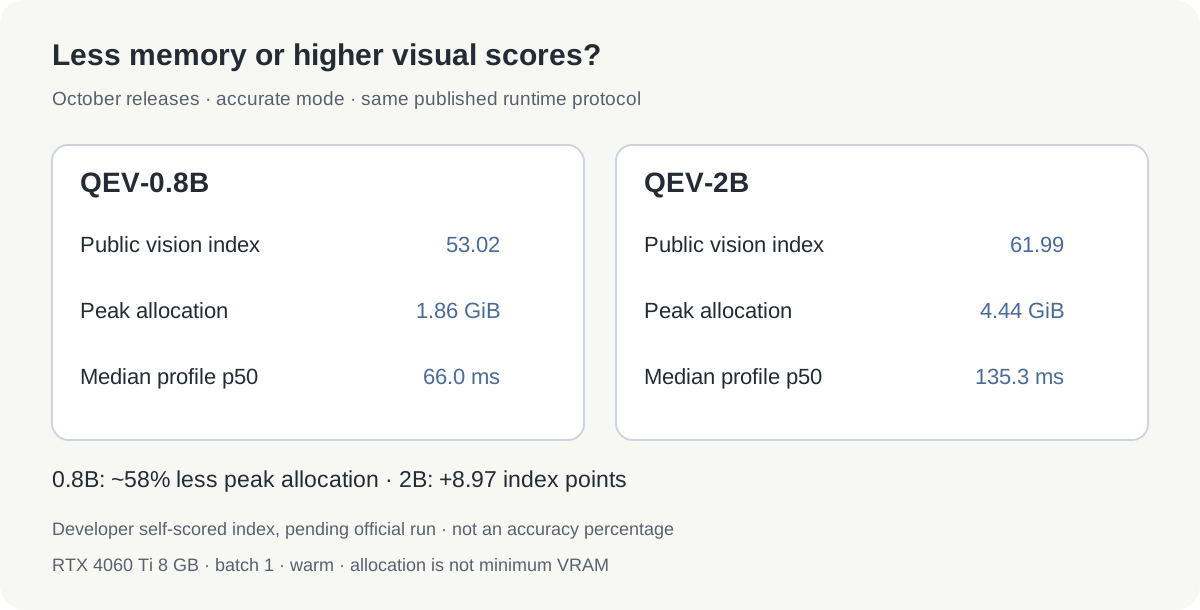 두 모델 카드의 고정 버전을 바탕으로 직접 제작한 비교 그림입니다. 지수는 자체 평가이며 메모리와 실행 시간은 측정 GPU의 accurate 모드 기준입니다.
실행 성능은 RTX 4060 Ti 8 GB, 배치 1, 모델 예열 후 요청 유형 47개를 각각 3회 예열하고 30회 측정한 조건입니다. accurate 모드는 이미지 한 장당 최대 1.6 MP를 사용합니다. 메모리는 PyTorch가 기록한 할당 피크이므로 그래픽카드의 최소 요구 용량과 같지 않습니다. 드라이버, 다른 프로그램, 입력 조건에 따른 여유 공간도 필요합니다. 지연 시간에는 최초 다운로드와 모델 로딩이 포함되지 않으며 CPU 성능을 예측하는 수치도 아닙니다.
fast 모드는 이미지 상한을 0.26 MP로 낮추고 전체 24개 층 중 16번째 층에서 판단합니다. 0.8B의 요청별 p50 중앙값은 44.6 ms로, 가장 느린 요청 유형의 p95는 123.2 ms로 줄었습니다. 반면 내부 DEV 정확도는 accurate 모드의 86.0%에서 82.0%로 낮아졌고, 문서·차트·화면 입력에서 손실이 컸습니다. fast 모드의 공개 Decision Index는 보고되지 않았으므로 53.02점을 fast 모드의 성능으로 읽으면 안 됩니다.
새 체크포인트는 별도의 Python 3.12 환경에서 사용하는 편이 좋습니다. 기존 qev==0.2.1 패키지로는 0.8B 배포 모델을 불러올 수 없습니다.
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
앞의 예제처럼 DecisionRequest를 만들어 model.predict(request)에 전달하면 됩니다. 우선 0.8B의 accurate 모드로 시작하고 자원이 더 부족하면 fast 모드를 실험해 보세요. 실제 입력의 오류를 줄이는 효과가 추가 메모리와 시간보다 중요하다면 2B로 옮길 이유가 됩니다. 두 모델을 비교할 때는 입력과 후보 설명을 동일하게 유지하는 것이 좋습니다.
어디에 활용하고 무엇을 더 확인해야 하나
처음 실험하기 좋은 업무는 눈으로 판단할 근거가 있고 결과의 영향 범위를 제한할 수 있는 경우입니다. 문서 이미지를 검토 대기열로 보내거나, 물건 사진을 분류하거나, 제시한 처리 설명 중 입력에 맞는 것을 선택하는 작업이 예가 될 수 있습니다. 모델이 도움이 되는지 측정하는 동안에는 사람이 검토할 경로를 유지하는 편이 좋습니다.
프롬프트를 조정하기 전에 실제 업무를 대표하는 작은 평가 묶음을 정해 보세요. 판단이 수락된 사례의 정확도, 보류 비율, 보류되지 않고 통과한 오류를 기록하고 조명·화질·언어를 바꿔 반복하면 됩니다. QEV는 기반 모델의 다국어 입력 능력을 활용하지만 공개된 정확도와 확률 보정 근거는 영어 중심입니다. 한국어나 다른 언어에서 같은 결과가 나오는지는 별도로 확인해야 합니다. 공개 모델 카드
기존 SDK 모델의 평가 결과도 기대 범위를 보여줍니다. 2,000개 질문으로 이루어진 유형별 판단 비교에서 QEV는 77.00%, 텍스트 특화 모델 LAYA는 76.95%를 기록했습니다. 한 문제 차이이며, 대응 비교의 신뢰구간에는 0이 포함됩니다. 일반적인 정확도 우위를 입증하는 결과가 아니고 호스팅 Jev와 직접 비교한 평가도 아닙니다. 이 과거 결과는 위의 10월 체크포인트 비교와 구분해야 합니다. 텍스트 전용 모델은 자신의 조건에서 더 빠를 수도 있습니다. 비교 방법과 결과
시각 추론 성능도 고르지 않습니다. 프로젝트의 탐색적 2048 게임 평가에서는 72회 시도 중 성공한 게임이 없었다고 보고합니다. 사진 속 재질을 구분하는 소형 모델이 곧바로 신뢰할 수 있는 공간 계획 모델이 되는 것은 아닙니다. 평가 기록
로컬 실행, 비교적 작은 기반 모델, 명시적인 판단 출력이 함께 필요하다면 QEV를 살펴볼 만합니다. Jev의 실험적 이미지 지원과 다른 Qwen 기반 프로젝트를 함께 보면 전체 방향도 보입니다. 더 많은 애플리케이션이 이미지에 대한 제한된 판단을 모델에 요청하고, 그 결과를 어떻게 사용할지는 일반적인 소프트웨어 로직으로 결정할 수 있게 되고 있습니다.
출처
출처는 2026년 10월 20일 확인했습니다. 구조와 예제, 배포 범위는 QEV의 특정 커밋 공개 소스와 SDK 0.2.1을 기준으로 설명했습니다. 전체 흐름은 TypeSafe의 Jev 발표, PixelJev 논문, AutoTrust 모델 카드를 참고했습니다. 대표 이미지는 QEV 공개 README를 소개 목적으로 캡처한 화면이며, 이미지 출처와 권리 근거는 별도로 기록했습니다.
잘못된 분류나 달라진 정책을 나중에 되짚을 수 있도록 판단과 함께 원본 근거를 보관해 보세요. Telli.sh 계정 만들기를 통해 출처 자료와 노트, 후속 리서치를 한곳에 모아 검색할 수 있습니다.