[Taccuino di idee sull'IA 04] Dalle decisioni in stile Jev alle immagini: scopri QEV, un piccolo modello basato su Qwen
Perché nascono modelli di decisione visiva attorno a Qwen, cosa cambia con il supporto sperimentale alle immagini di Jev e dove si colloca il progetto locale QEV di classe 2B.
Taccuino di idee sull'IA esplora le idee e le possibilità pratiche dei nuovi modelli e strumenti di IA.
Una fotografia arriva in un flusso di smistamento. L'applicazione deve scegliere tra plastica, vetro e metallo, verificare se l'oggetto appartiene a una categoria fornita e restituire un valore utilizzabile dal software. Un paragrafo ben scritto che descrive la bottiglia può essere interessante, ma lascia un ulteriore passaggio tra il modello e la decisione.
Jev ha attirato l'attenzione su un'interfaccia diversa: fornire al modello una situazione, una domanda e le risposte consentite, poi ricevere una decisione strutturata con probabilità. La domanda successiva è naturale: questa interfaccia può funzionare con ciò che un modello vede, oltre a ciò che legge?
Ora può farlo in diverse forme. TypeSafe ha introdotto il supporto sperimentale alle immagini per Jev il 14 ottobre 2026. Anche progetti indipendenti stanno adattando modelli di base Qwen per visione e linguaggio alle decisioni in stile Jev. Tra questi c'è QEV, un modello locale costruito su Qwen3.5-2B che espone scelte, punteggi ordinati, decisioni booleane e astensione. Annuncio Jev, repository QEV
Dichiarazione dell'autore: QEV è il progetto mantenuto indipendentemente dall'autore di questo articolo. L'introduzione distingue il rilascio pubblicato dalle funzioni disponibili soltanto nei sorgenti e usa documentazione pubblica ed esempi registrati; non presenta una nuova valutazione indipendente del modello.
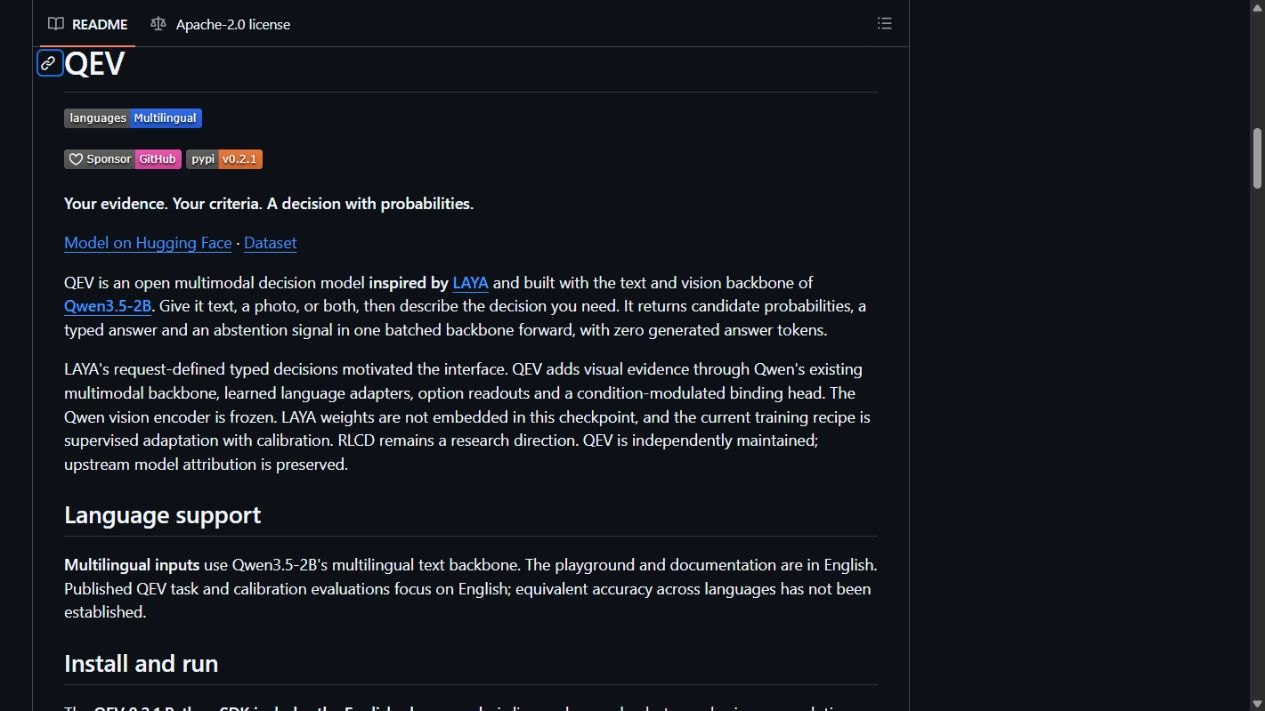 Il repository pubblico di QEV, acquisito il 20 ottobre 2026. È una schermata di documentazione, non una dimostrazione di inferenza locale.
Perché un modello decisionale è diverso da un chatbot
Un chatbot di solito scrive una risposta token dopo token. Un modello decisionale è utile quando l'applicazione conosce già la forma della risposta: scegliere una destinazione, valutare una condizione su una scala ordinata o decidere se un'affermazione è vera.
Le opzioni possono cambiare a ogni richiesta. Un sistema di assistenza può offrire oggi fatturazione e supporto tecnico, poi aggiungere domani il recupero degli account. Un flusso di smistamento visivo può fornire sei descrizioni di materiali per una domanda e un diverso insieme di regole di gestione per un'altra. Il modello deve collegare le prove attuali a quelle descrizioni, anziché scegliere da un elenco di etichette fissato durante l'addestramento.
Le primitive note di Jev sono choice, score e noul. In QEV, una scelta restituisce una distribuzione sui candidati forniti. Un punteggio usa livelli ordinati forniti e ne restituisce probabilità e livello atteso. Una domanda noul usa criteri vero e falso. Sono contratti di output differenti, anche quando condividono lo stesso modello sottostante. Riferimento API QEV
Le probabilità rendono visibile il confine: un vantaggio ridotto tra due candidati può attivare una revisione invece di un'azione automatica. Non rendono corretta la decisione. L'applicazione ha comunque bisogno di una politica per incertezza, ingressi inadatti e costo degli errori.
Jev ha già un percorso sperimentale per le immagini
La motivazione storica va aggiornata. Sarebbe fuorviante presentare QEV dicendo che oggi Jev non può accettare immagini. L'annuncio TypeSafe di ottobre abilita immagini sperimentali per Jev 1.13 e 1.14 attraverso l'header TypeSafe-Danger-Zone-Images. Jev 1.14 aggiunge anche la primitiva spaziale Box. L'annuncio descrive queste funzioni come sperimentali. Annuncio Jev 1.14
Questo cambia il confronto. La domanda utile riguarda quale distribuzione, contratto di ingresso e comportamento decisionale si adattino a un determinato flusso. Un esperimento con Jev ospitato, un modello di ricerca e un adattamento locale di Qwen possono condividere l'idea di decisioni circoscritte, differendo molto nel pacchetto e nelle operazioni supportate.
QEV non ha un equivalente documentato della primitiva Box di Jev. È un'implementazione indipendente, non i pesi di TypeSafe né un rilascio ufficiale Jev. Condividere nomi di primitive o un endpoint in stile SystemOne è un punto di partenza per integrare, non la prova che ogni richiesta possa passare invariata tra prodotti.
Perché Qwen compare in questi progetti
Un modello di base per visione e linguaggio porta già informazioni testuali e visive in un modello condiviso. Questo offre a un progetto decisionale un punto di partenza pratico: mantenere la comprensione visiva, poi adattare il modo in cui il modello collega le prove alle risposte fornite dall'applicazione.
Due esempi pubblici mostrano che si tratta di una direzione più ampia di un singolo repository:
| Progetto | Approccio descritto pubblicamente | Come leggerne lo stato |
|---|---|---|
| PixelJev | Studia scelte visive in stile Jev con piccoli modelli di base Qwen3.5, comprese varianti 2B e 4B | Un articolo di ricerca sulla scelta visiva; non prova un sostituto completo di Jev ospitato |
| AutoTrust JEV-27B-VL | Usa Qwen3.8-27B con una testa decisionale e adattatori | Un modello indipendente più grande; la scheda distingue decisioni addestrate sul testo e uso zero-shot delle immagini |
| QEV | Adatta Qwen3.5-2B a decisioni choice, score e noul | Un progetto locale di classe 2B con SDK rilasciato ed estensioni dei sorgenti documentate separatamente |
L'articolo PixelJev è utile per capire l'idea architetturale: collegare immagini e candidati definiti durante l'esecuzione a una lettura decisionale. La scheda AutoTrust illustra un'altra scala d'implementazione, segnalando che una calibrazione visiva sistematica non è stata stabilita. Sono esempi di un modello di progettazione emergente, non una graduatoria di benchmark o un elenco di prodotti ugualmente compatibili. Articolo PixelJev, scheda del modello AutoTrust
Il posto di QEV in questo quadro è una distribuzione locale compatta. «Piccolo» descrive la classe del modello di base rispetto a modelli visione-linguaggio molto maggiori; non significa che tutta l'installazione occupi pochi megabyte o funzioni all'istante su qualsiasi dispositivo.
Come QEV trasforma un'immagine in una decisione
QEV usa un unico modello di base Qwen3.5-2B per testo e visione. L'architettura pubblicata aggiunge adattamento sul lato linguistico e una lettura che collega situazione e domanda alle descrizioni dei candidati forniti. Il modello assegna direttamente punteggi ai candidati, invece di generare una frase e chiedere a un altro parser di estrarre un'etichetta. Scheda pubblica del modello
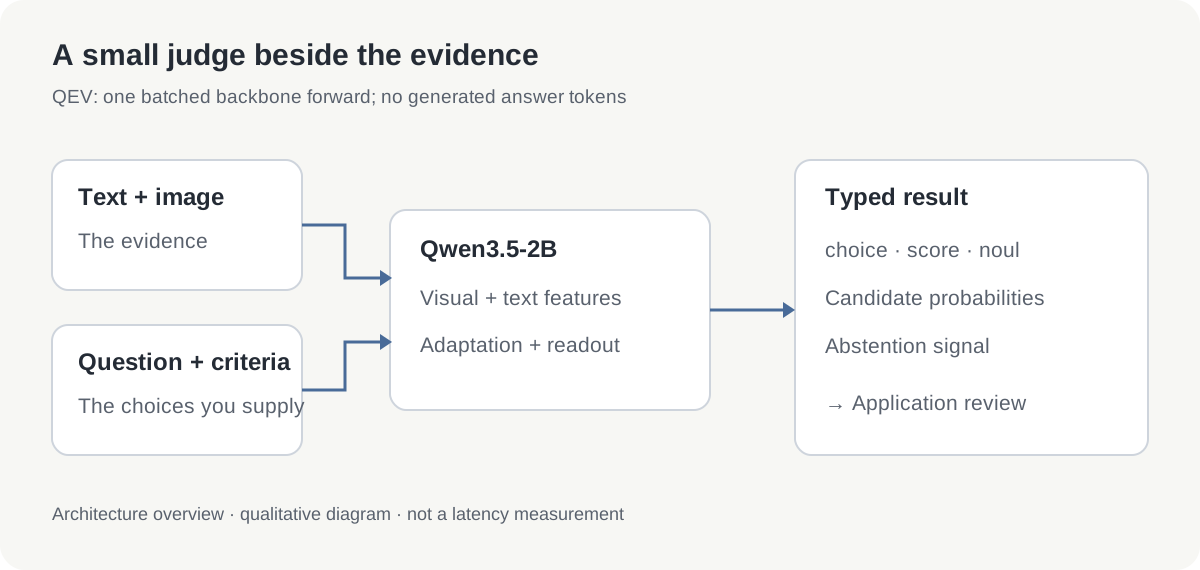 Diagramma esplicativo originale. Le frecce descrivono il percorso decisionale documentato, non un confronto misurato di velocità.
Nell'SDK rilasciato una richiesta può contenere testo, un'immagine o entrambi. Supporta da una a quattro domande, con da due a sedici candidati per choice e da due a sedici livelli ordinati per score. Questo permette un piccolo gruppo di decisioni collegate senza trasformare ogni domanda in una conversazione separata. Riferimento API
Considera una fotografia con una breve istruzione: «Scegli il materiale secondo queste descrizioni». Una seconda domanda può chiedere quale fascia di politica si applichi, una terza se l'oggetto soddisfi una condizione booleana fornita. La fotografia è una prova condivisa; i criteri definiscono cosa significa ogni decisione.
Il percorso documentato di inferenza genera zero token di risposta. Questo elimina una fonte di variabilità nel formato, ma non elimina il codificatore visivo, il calcolo del modello di base, il pretrattamento delle immagini o il lavoro accessorio dell'applicazione. «Nessuna risposta generata» e «nessun costo computazionale» sono affermazioni molto diverse.
Leggi l'esempio della bottiglia come un esempio
Il repository QEV include una fotografia con licenza e un output registrato per una bottiglia di plastica. È un modo utile per vedere la struttura della risposta prima di installare qualcosa.
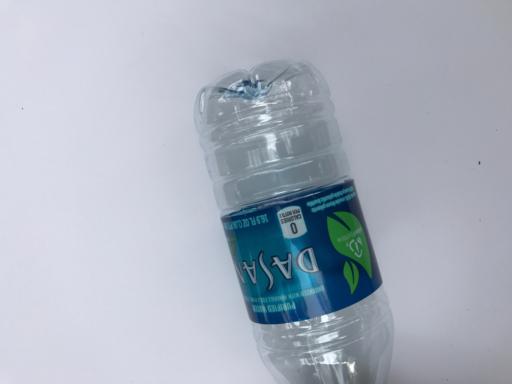 Ingresso di esempio pubblicato nel caso fotografico QEV, originariamente da TrashNet. Copyright 2017 Gary Thung, licenza MIT; l'avviso di licenza è conservato.
| Domanda nel caso pubblicato | Risultato registrato | Cosa significa |
|---|---|---|
| Scegliere tra sei materiali | Plastica, probabilità circa 0.9361 | La plastica riceve la quota maggiore tra i candidati forniti |
| Scegliere una fascia ordinata di politica | Livello atteso circa 0.4254 su una scala 0–2 | Una media ponderata dei tre indici di fascia forniti |
| Appartiene a vetro, carta o plastica? | Vero, probabilità circa 0.7903 | Il criterio booleano è favorito rispetto all'alternativa falsa |
Il punteggio richiede particolare attenzione. In questo esempio la fascia 0 raggruppa vetro e plastica, la 1 metallo e rifiuti e la 2 cartone e carta. L'ordine è una politica di esempio. Il numero 0.4254 non è una valutazione di sicurezza, uno standard di riciclo o la confidenza della scelta del materiale.
Allo stesso modo, la probabilità della plastica descrive questa richiesta e i suoi candidati. Non dimostra che il 93.61% di tutte le fotografie di bottiglie sarà classificato correttamente. È un esempio del rilascio già esaminato, non un nuovo test su dati riservati, e l'output precedente è stato registrato dal progetto anziché riprodotto per questo articolo.
Cosa dovrebbe significare qui «compatibile con Jev»
La compatibilità si capisce meglio a strati. Ci sono l'idea condivisa di decisioni definite nella richiesta, lo schema JSON esatto, gli ingressi supportati e il comportamento di ogni tipo di output. Corrispondere a uno strato non significa corrispondere automaticamente agli altri.
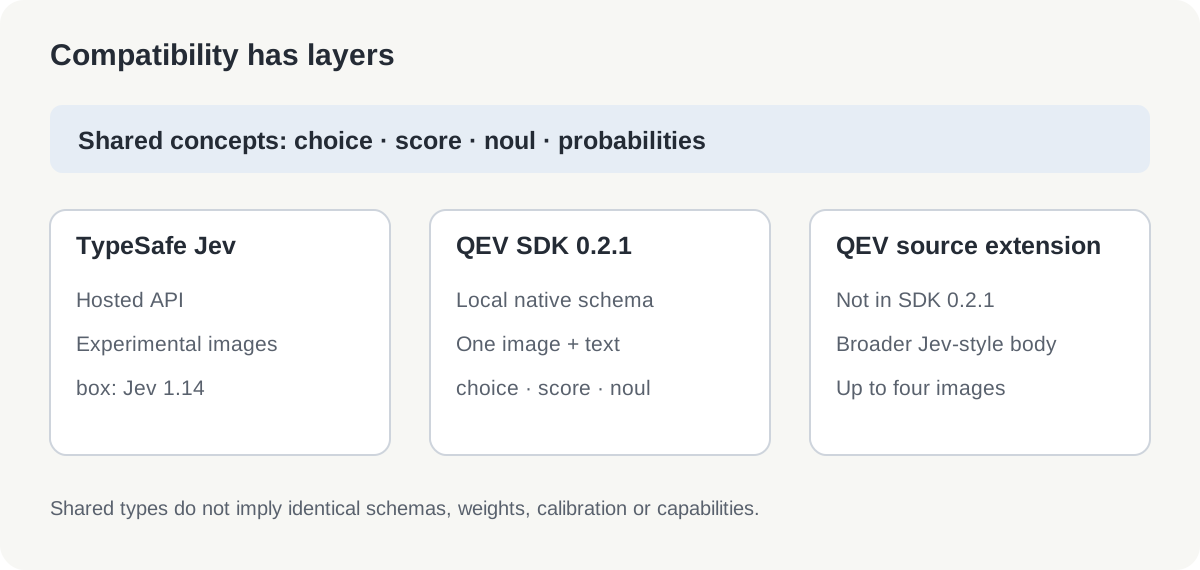 Mappa originale di compatibilità, controllata il 20 ottobre 2026. Le estensioni dei sorgenti sono separate dal contratto dell'SDK confezionato.
L'SDK confezionato QEV 0.2.1 usa lo schema nativo QEV e una sola immagine facoltativa. La copia pubblica dei sorgenti documenta anche una gestione più ampia delle richieste in stile Jev/SystemOne e fino a quattro immagini ordinate. Non bisogna presumere che queste estensioni esistano nel pacchetto 0.2.1 pubblicato. API e note di rilascio, rilascio 0.2.1
Per un'integrazione, parti da una richiesta nota e confronta validazione, campi delle risposte, ordine dei candidati e comportamento nell'incertezza. Una rotta familiare /v1/systemone da sola non stabilisce un sostituto universale e immediato del servizio o dell'SDK TypeSafe.
Un primo sguardo pratico
Per una prima esplorazione, il playground locale è più semplice da esaminare di un'integrazione applicativa.
- Prepara un ambiente Python 3.12 e attivalo.
- Installa il rilascio fissato e avvia il playground con i comandi seguenti.
- Apri
http://127.0.0.1:7860, scegli un esempio e osserva probabilità dei candidati e astensione.
python -m pip install qev==0.2.1
qev playground
Il playground documentato gira localmente su http://127.0.0.1:7860. Include fotografie di esempio e mostra probabilità, astensione e output strutturato. Interfaccia e documentazione sono in inglese. Sono istruzioni di installazione del rilascio, non l'affermazione che il modello sia stato installato o cronometrato per questo articolo. Guida al playground
Una piccola richiesta testuale mostra la forma dell'SDK nativo:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Inizia con due o tre candidati chiaramente diversi. Poi prova un caso ambiguo e uno che non appartiene a nessuno. Verifica se astensione e politica applicativa producono un esito utile. Per le prove con immagini, usa fotografie che hai diritto di elaborare e scrivi criteri basati su prove visibili, non su fatti che l'immagine non può stabilire.
Calcola il budget del modello di base, non soltanto dell'adattatore
Per il precedente percorso SDK 0.2.1, il checkpoint di adattamento QEV è di circa 32.01 MB, con un download separato del modello di base Qwen di circa 4.55 GB. La suddivisione pubblicata indica circa 2.213 miliardi di parametri del modello di base e 7.992 milioni di parametri di adattamento e lettura. I checkpoint di ottobre QEV-0.8B e QEV-2B descritti sotto usano un percorso separato di caricamento del rilascio. Suddivisione delle dimensioni del modello SDK
La configurazione iniziale coinvolge quindi gigabyte. Gli usi successivi possono sfruttare file in cache, ma la memoria di esecuzione comprende anche attivazioni, elaborazione delle immagini e buffer. I percorsi documentati per GPU e CPU usano precisioni numeriche diverse. Il numero di byte di un checkpoint serve a pianificare lo spazio, non promette memoria, capacità di elaborazione o consumo di batteria su una macchina specifica.
Se 2B mette in difficoltà il computer, prova QEV-0.8B
Il rilascio di ottobre include QEV-0.8B, costruito su Qwen3.5-0.8B e distillato dallo stesso modello insegnante del nuovo QEV-2B. È un punto di partenza pratico quando memoria GPU o tempi di risposta rendono scomodo 2B. Il modello più piccolo conserva le decisioni definite nella richiesta, scambiando parte della qualità decisionale visiva con un minore uso di risorse. Scheda del modello 0.8B, scheda del modello 2B
| Misura pubblicata | QEV-0.8B | QEV-2B di ottobre | Differenza |
|---|---|---|---|
| Decision Index visivo pubblico, modalità accurate | 53.02 | 61.99 | 2B è avanti di 8.97 punti dell'indice |
| Allocazione GPU massima, modalità accurate | 1.86 GiB | 4.44 GiB | 0.8B usa circa il 58% in meno |
| Mediana delle latenze p50 dei profili di richiesta | 66.0 ms | 135.3 ms | Circa il 51% in meno per 0.8B |
| Latenza p95 più alta tra i profili di richiesta | 377.3 ms | 738.6 ms | Circa il 49% in meno per 0.8B |
| Allocazione GPU massima, modalità fast | 1.60 GiB | 4.13 GiB | 0.8B risparmia 2.53 GiB |
| Punteggio RealWorldQA | 39.2 | 56.2 | 2B è avanti di 17.0 punti |
| Punteggio Winoground | 47.5 | 65.5 | 2B è avanti di 18.0 punti |
| Punteggio InfographicVQA | 75.4 | 83.1 | 2B è avanti di 7.7 punti |
Sono misure dello sviluppatore controllate il 20 ottobre 2026. L'indice è autovalutato sul kit visivo pubblico, edizione 0.3.2, in attesa di un'esecuzione ufficiale; non è una percentuale di accuratezza complessiva. L'intervallo bootstrap appaiato per il divario di 8.97 punti è 7.39–10.48 punti. I singoli benchmark mostrano come il divario varia con l'attività.
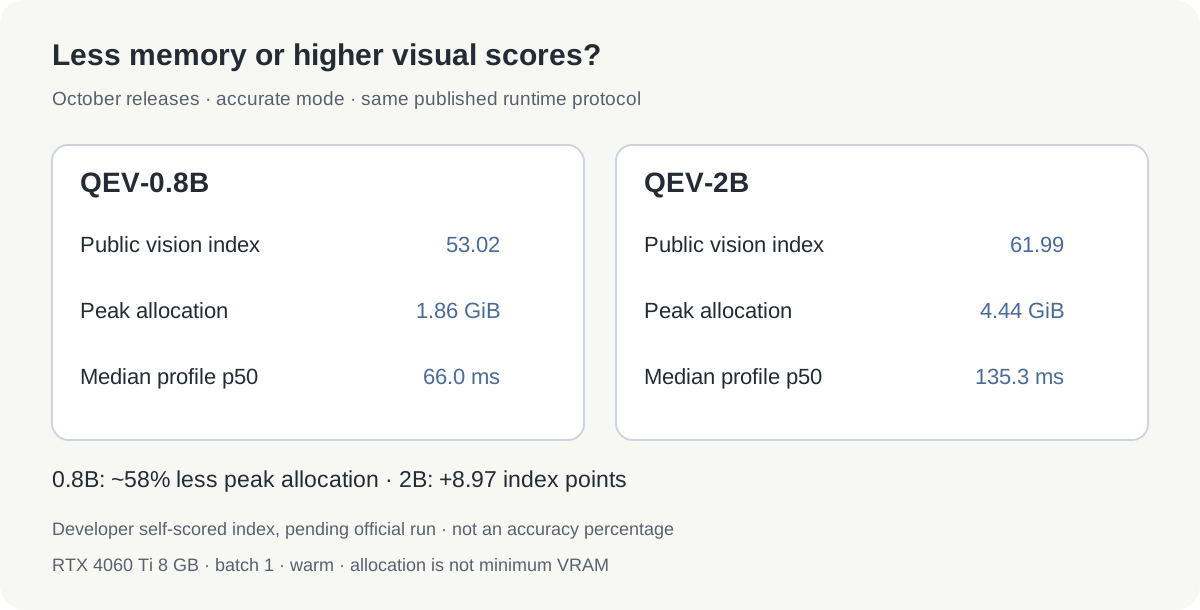 Infografica comparativa originale basata sulle due schede fissate dei modelli. Gli indici sono autovalutati; memoria e tempi si riferiscono alla modalità accurate sulla GPU misurata.
Le misure di esecuzione usano una RTX 4060 Ti da 8 GB, batch 1, un modello già riscaldato e 47 profili di richiesta, con tre riscaldamenti e 30 esecuzioni cronometrate per profilo. La modalità accurate permette fino a 1.6 MP per immagine. La memoria è l'allocazione massima di PyTorch, non la capacità minima della scheda: driver, altre applicazioni e ingressi diversi richiedono ancora spazio. I tempi escludono download e caricamento del modello e non prevedono le prestazioni su CPU.
La modalità fast limita le immagini a 0.26 MP ed esce al livello 16 su 24. Per 0.8B, la mediana p50 scende a 44.6 ms e il p95 del profilo peggiore a 123.2 ms. L'accuratezza interna DEV scende da 86.0% in modalità accurate a 82.0%, interessando soprattutto documenti, grafici e schermate. Non viene riportato un Decision Index pubblico per fast; il punteggio 53.02 appartiene alla modalità accurate.
Usa un ambiente Python 3.12 separato per questi checkpoint. Il vecchio pacchetto qev==0.2.1 non carica il rilascio 0.8B:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Invia un DecisionRequest tramite model.predict(request), come nell'esempio precedente. Parti da 0.8B in modalità accurate, poi prova fast se le risorse rimangono limitate. Passa a 2B quando gli errori su ingressi rappresentativi giustificano memoria e tempo aggiuntivi, mantenendo identici ingressi e descrizioni dei candidati per confrontare.
Dove provarlo e dove si fermano le prove
Buoni primi esperimenti hanno prove visibili e conseguenze circoscritte: instradare l'immagine di un documento verso una coda di revisione, classificare la foto di un oggetto o scegliere quale descrizione di gestione, tra diverse fornite, si adatti meglio all'ingresso. Conserva un percorso di revisione umana mentre misuri se il modello aiuta.
Scegli un piccolo insieme rappresentativo prima di regolare i prompt. Registra accuratezza delle decisioni accettate, tasso di astensione ed errori che continuano a passare. Ripeti con illuminazione, qualità delle immagini e lingue diverse. QEV eredita capacità di ingresso multilingue dal modello di base, ma le prove pubblicate di accuratezza e calibrazione si concentrano sull'inglese: la parità in coreano o altre lingue va verificata, non presunta. Scheda pubblica del modello
Anche le valutazioni del vecchio modello SDK delimitano le promesse. In un confronto di decisioni tipizzate su 2,000 domande, QEV ha ottenuto 77.00% e lo specialista testuale LAYA 76.95%: una sola domanda di differenza, con un intervallo di confidenza appaiato che attraversa lo zero. Non dimostra un vantaggio generale di accuratezza e non è un confronto diretto con Jev ospitato. Questi risultati precedenti sono separati dal confronto dei checkpoint di ottobre sopra riportato. Anche la specializzazione soltanto testuale può essere più rapida nel proprio contesto. Metodologia e risultati del confronto
Il ragionamento visivo rimane disomogeneo. La valutazione esplorativa del progetto su 2048 riporta nessuna partita riuscita in 72 tentativi. Un modello compatto capace di identificare materiali in una fotografia non è automaticamente un pianificatore spaziale affidabile. Note di valutazione
Vale la pena esplorare QEV quando funzionamento locale, una classe piccola di modello di base e output decisionali espliciti contano insieme. Il percorso sperimentale per immagini di Jev e gli altri progetti basati su Qwen rendono chiara la direzione generale: più applicazioni possono chiedere a un modello un giudizio circoscritto su un'immagine, per poi decidere cosa farne nel normale software.
Fonti
Fonti consultate il 20 ottobre 2026. Architettura, esempi e limiti dei rilasci precedenti si riferiscono ai sorgenti pubblici QEV fissati e all'SDK 0.2.1. Il contesto più ampio deriva dall'annuncio Jev di TypeSafe, dall'articolo PixelJev e dalla scheda AutoTrust. L'immagine principale è una cattura editoriale del README pubblico QEV; fonti e diritti dei materiali visivi sono registrati separatamente.
Conserva le prove originali accanto alla decisione, così resta possibile riesaminare una classificazione sbagliata o una politica cambiata. Crea un account Telli.sh per raccogliere fonti, note e approfondimenti in un unico spazio di lavoro ricercabile.