[Carnet d’idées IA 04] Des décisions façon Jev aux images : découvrez QEV, un petit modèle fondé sur Qwen
Pourquoi des modèles de décision visuelle émergent autour de Qwen, ce que change la prise en charge expérimentale des images de Jev et la place du projet local QEV de classe 2B.
Le Carnet d’idées IA explore les idées et les possibilités concrètes des nouveaux modèles et outils d’IA.
Une photographie arrive dans un processus de tri. L'application doit choisir entre plastique, verre et métal, vérifier si l'objet relève d'une catégorie fournie et renvoyer une valeur exploitable par le logiciel. Un paragraphe bien écrit décrivant la bouteille peut être intéressant, mais laisse une étape entre le modèle et la décision.
Jev a attiré l'attention sur une autre interface : fournir une situation, une question et les réponses autorisées, puis recevoir une décision structurée assortie de probabilités. La question suivante est naturelle : cette interface peut-elle fonctionner avec ce que voit un modèle, et pas seulement avec ce qu'il lit ?
C'est désormais possible sous plusieurs formes. TypeSafe a introduit la prise en charge expérimentale des images dans Jev le 14 octobre 2026. Des projets indépendants adaptent aussi les backbones vision-langage de Qwen aux décisions façon Jev. Parmi eux, QEV, un modèle local construit sur Qwen3.5-2B, propose choix, scores ordonnés, décisions booléennes et abstention. Annonce de Jev, dépôt QEV
Déclaration de l'auteur : QEV est le projet maintenu de façon indépendante par l'auteur de cet article. Cette introduction distingue la version publiée des fonctionnalités disponibles uniquement dans les sources et utilise la documentation publique et des exemples enregistrés ; elle ne présente pas une nouvelle évaluation indépendante du modèle.
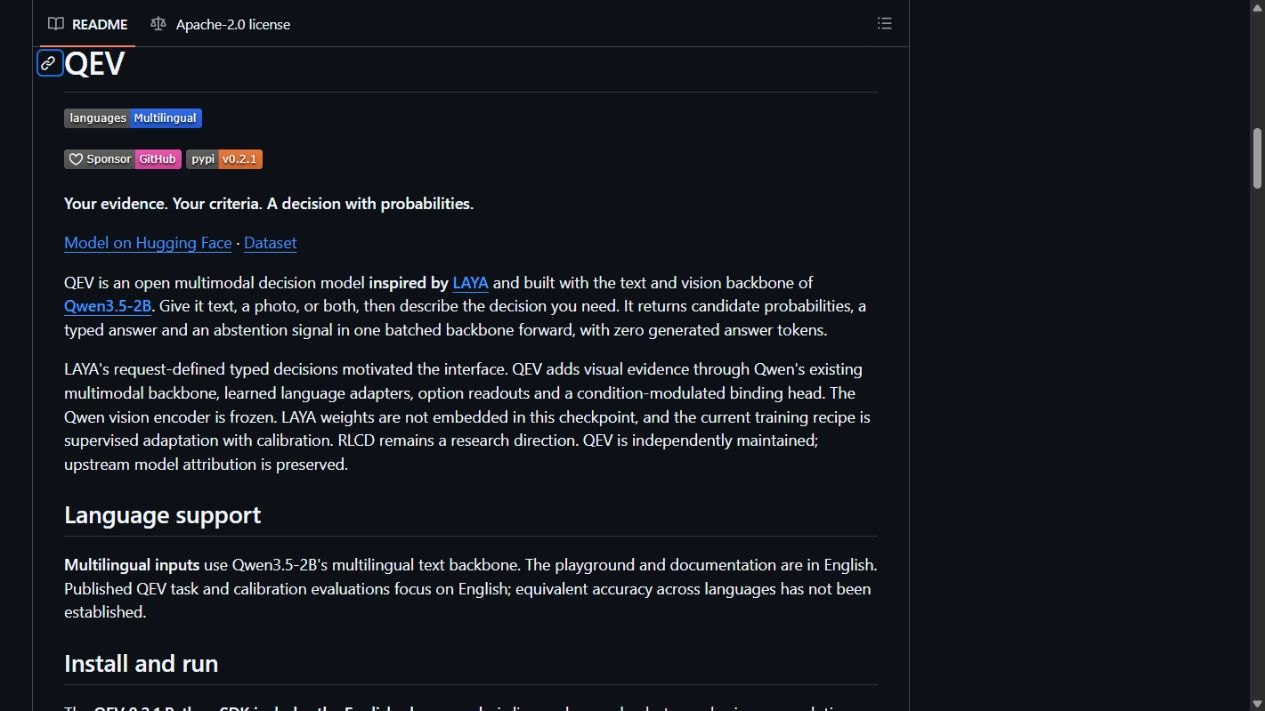 Le dépôt public de QEV, capturé le 20 octobre 2026. Il s'agit d'un écran de documentation, pas d'une démonstration d'inférence locale.
Pourquoi un modèle de décision diffère d'un chatbot
Un chatbot rédige généralement une réponse token après token. Un modèle de décision est utile lorsque l'application connaît déjà la forme de la réponse : sélectionner une destination, situer une condition sur une échelle ordonnée ou déterminer si une affirmation est vraie.
Les réponses possibles peuvent changer à chaque requête. Un support peut proposer facturation et assistance technique aujourd'hui, puis ajouter la récupération de compte demain. Un tri visuel peut fournir six descriptions de matériaux pour une question et un autre ensemble de règles de traitement pour la suivante. Le modèle doit relier les preuves actuelles à ces descriptions, plutôt que choisir dans une liste de classes figée à l'entraînement.
Les primitives familières de Jev sont choice, score et noul. Dans QEV, un choix retourne une distribution sur les candidats fournis. Un score utilise des niveaux ordonnés fournis et retourne leurs probabilités ainsi qu'un niveau attendu. Une question noul emploie des critères vrai et faux. Ce sont des contrats de sortie distincts, même s'ils partagent le même modèle. Référence de l'API QEV
Les probabilités rendent la frontière visible : une faible avance entre deux candidats peut déclencher une revue plutôt qu'une action automatique. Elles ne rendent pas la décision correcte. L'application a toujours besoin d'une politique pour l'incertitude, les entrées inadaptées et le coût d'une erreur.
Jev possède déjà un parcours d'image expérimental
La motivation historique doit être actualisée. Présenter QEV en disant que Jev ne peut actuellement pas accepter d'images serait trompeur. L'annonce d'octobre de TypeSafe active les images expérimentales pour Jev 1.13 et 1.14, derrière l'en-tête TypeSafe-Danger-Zone-Images. Jev 1.14 ajoute aussi la primitive spatiale Box. L'annonce décrit ces fonctions visuelles comme expérimentales. Annonce de Jev 1.14
Cela change la comparaison. La question utile est de savoir quel déploiement, quel contrat d'entrée et quel comportement conviennent au parcours visé. Un essai Jev hébergé, un modèle de recherche et une adaptation Qwen locale peuvent partager l'idée de décisions bornées tout en différant fortement par leur conditionnement et leurs opérations prises en charge.
QEV n'a pas d'équivalent documenté à la primitive Box de Jev. C'est une implémentation indépendante, pas les poids de TypeSafe ni une version officielle de Jev. Partager des noms de primitives ou un endpoint de style SystemOne donne un point de départ à l'intégration, sans prouver que toutes les requêtes se déplacent inchangées entre produits.
Pourquoi Qwen apparaît dans ces projets
Un backbone vision-langage réunit déjà texte et image dans un modèle commun. C'est un point de départ pratique pour un projet de décision : conserver la compréhension visuelle, puis adapter la manière de relier les preuves aux réponses fournies par l'application.
Deux exemples publics montrent que cette direction dépasse un seul dépôt :
| Projet | Approche décrite publiquement | Comment interpréter son statut |
|---|---|---|
| PixelJev | Étudie le choix visuel façon Jev avec de petits backbones Qwen3.5, dont des variantes 2B et 4B | Un article de recherche sur le choix visuel, pas la preuve d'un remplacement complet de Jev hébergé |
| AutoTrust JEV-27B-VL | Utilise Qwen3.8-27B avec une tête de décision et des adaptateurs | Un modèle indépendant plus grand ; sa fiche distingue les décisions entraînées sur texte et l'usage d'images en zero-shot |
| QEV | Adapte Qwen3.5-2B aux décisions choice, score et noul | Un projet local de classe 2B avec un SDK publié et des extensions sources documentées séparément |
L'article PixelJev aide à comprendre l'architecture : relier images et candidats définis à l'exécution à une sortie de décision. La fiche AutoTrust illustre une autre échelle tout en précisant que la calibration visuelle systématique n'est pas établie. Ce sont les exemples d'un schéma émergent, pas un classement de benchmark ni une liste de produits équivalents en compatibilité. Article PixelJev, fiche AutoTrust
La place de QEV est celle d'un déploiement local compact. « Petit » désigne sa classe de backbone par rapport à des modèles vision-langage bien plus grands ; cela ne signifie pas que toute l'installation tient en quelques mégaoctets ou tourne instantanément sur tout appareil.
Comment QEV transforme une image en décision
QEV utilise un seul backbone texte-image Qwen3.5-2B. Son architecture publiée ajoute une adaptation côté langage et une couche de lecture reliant la situation et la question aux descriptions des candidats fournis. Le modèle note directement les candidats au lieu de générer une phrase puis de demander à un parseur d'en extraire une classe. Fiche publique du modèle
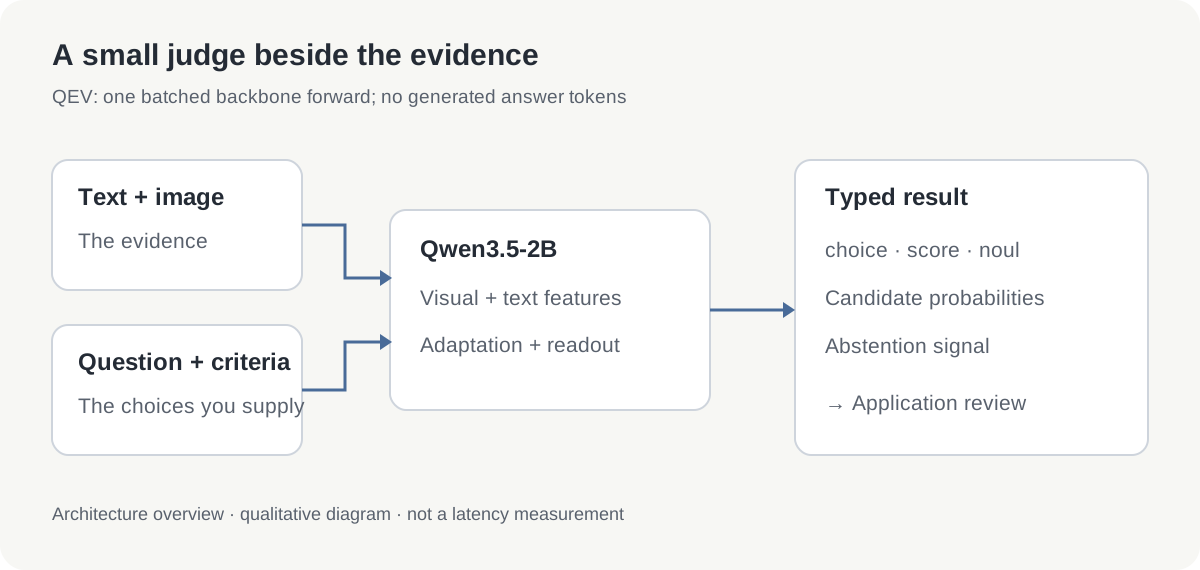 Schéma explicatif original. Les flèches décrivent le parcours documenté, pas une comparaison mesurée de vitesse.
Dans le SDK publié, une requête peut contenir du texte, une image ou les deux. Il prend en charge une à quatre questions, avec deux à seize candidats pour choice et deux à seize niveaux ordonnés pour score. Un petit groupe de décisions liées devient ainsi possible sans transformer chaque question en conversation distincte. Référence de l'API
Prenez une photographie accompagnée de l'instruction « Choisissez le matériau selon ces descriptions ». Une deuxième question peut demander la catégorie de traitement applicable et une troisième si l'objet satisfait une condition booléenne fournie. La photo est la preuve commune ; les critères définissent le sens de chaque décision.
Le parcours documenté génère zéro token de réponse. Cela supprime une source de variation de format, mais pas l'encodeur visuel, les calculs du backbone, le prétraitement d'image ni les coûts applicatifs. « Aucune réponse générée » et « aucun coût de calcul » sont deux affirmations très différentes.
L'exemple de bouteille reste un exemple
Le dépôt de QEV comprend une photographie sous licence et une sortie enregistrée pour une bouteille en plastique. C'est un moyen utile de voir la structure de réponse avant toute installation.
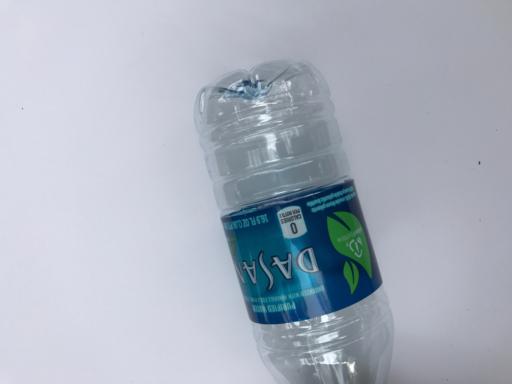 Entrée d'exemple publiée dans le jeu photographique de QEV, initialement issue de TrashNet. Copyright 2017 Gary Thung, licence MIT ; la mention de licence est conservée.
| Question de l'exemple publié | Résultat enregistré | Signification |
|---|---|---|
| Choisir parmi six matériaux | Plastique, probabilité d'environ 0.9361 | Le plastique reçoit la plus grande part parmi les candidats fournis |
| Choisir une catégorie ordonnée de traitement | Niveau attendu d'environ 0.4254 sur une échelle 0–2 | Moyenne pondérée des trois indices de catégories fournis |
| Appartient-il au verre, au papier ou au plastique ? | Vrai, probabilité d'environ 0.7903 | Le critère booléen est favorisé par rapport à son alternative fausse |
Le score demande une attention particulière. Ici, la catégorie 0 regroupe verre et plastique, la 1 métal et déchets, et la 2 carton et papier. L'ordre correspond à une règle d'exemple. Le nombre 0.4254 n'est ni une note de sécurité, ni une norme de recyclage, ni la confiance du choix de matériau.
De même, la probabilité du plastique décrit cette requête et ses candidats. Elle ne prouve pas que 93.61% de toutes les photos de bouteilles seront correctement classées. C'est un exemple de version déjà examiné, pas un nouveau test réservé ; la sortie a été enregistrée par le projet et non reproduite pour cet article.
Ce que « compatible Jev » doit signifier ici
La compatibilité se comprend mieux par couches : l'idée partagée de décisions définies par requête, le schéma JSON exact, les entrées acceptées et le comportement de chaque type de sortie. Correspondre sur une couche ne garantit pas les autres.
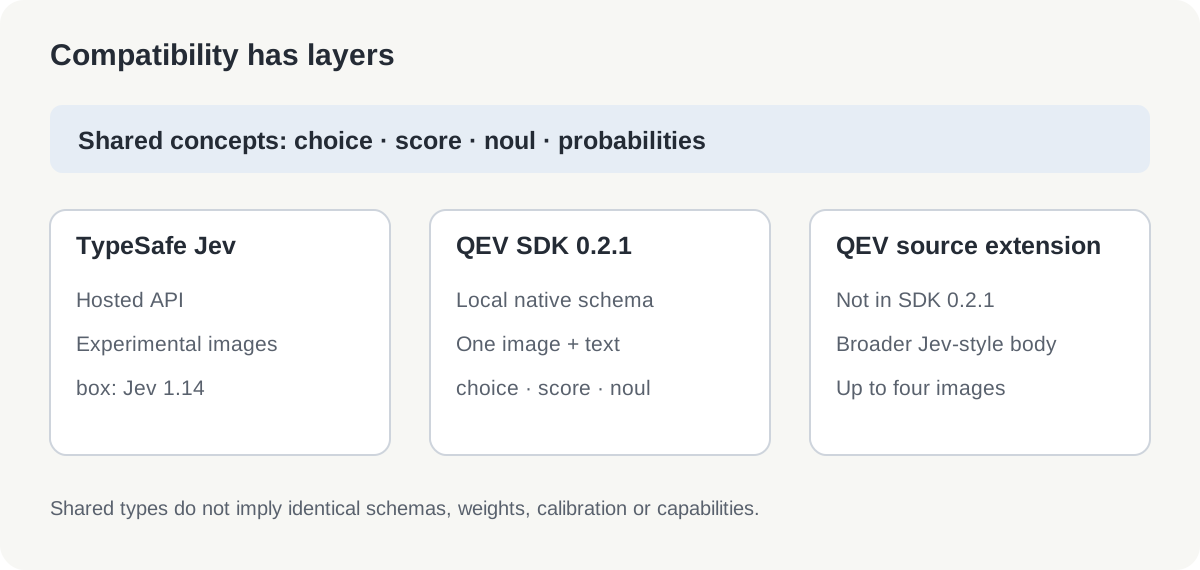 Carte de compatibilité originale, vérifiée le 20 octobre 2026. Les extensions sources sont distinctes du contrat du SDK distribué.
Le SDK distribué QEV 0.2.1 utilise le schéma natif de QEV et une seule image facultative. Les sources publiques documentent aussi un traitement plus large des requêtes de style Jev/SystemOne et jusqu'à quatre images ordonnées. Il ne faut pas présumer que ces extensions existent dans le paquet 0.2.1 publié. API et notes de version, version 0.2.1
Pour intégrer le modèle, commencez par une requête connue et comparez validation, champs de réponse, ordre des candidats et gestion de l'incertitude. La seule présence d'une route familière /v1/systemone ne prouve pas un remplacement universel direct du service ou du SDK TypeSafe.
Un premier aperçu pratique
Pour une première exploration, le playground local est plus facile à examiner qu'une intégration applicative.
- Préparez un environnement Python 3.12 et activez-le.
- Installez la version figée et démarrez le playground avec les commandes suivantes.
- Ouvrez
http://127.0.0.1:7860, choisissez un exemple et examinez probabilités et abstention.
python -m pip install qev==0.2.1
qev playground
Le playground documenté fonctionne localement à http://127.0.0.1:7860. Il inclut des photos d'exemple et affiche probabilités, abstention et sortie structurée. L'interface et la documentation sont en anglais. Ce sont les instructions d'installation de la version, pas l'affirmation que le modèle a été installé ou chronométré pour cet article. Guide du playground
Une petite requête textuelle montre la forme du SDK natif :
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Commencez par deux ou trois candidats clairement différents. Essayez ensuite un cas ambigu et un cas qui ne correspond à aucun. Vérifiez si l'abstention et la politique applicative produisent une issue utile. Pour les images, utilisez des photos que vous avez le droit de traiter et rédigez des critères fondés sur des éléments visibles, pas sur des faits que l'image ne peut établir.
Budgétez le backbone, pas seulement l'adaptateur
Pour l'ancien parcours SDK 0.2.1 ci-dessus, le checkpoint d'adaptation de QEV pèse environ 32.01 MB, auquel s'ajoute un téléchargement séparé du backbone Qwen d'environ 4.55 GB. La répartition publiée donne environ 2.213 milliards de paramètres de backbone et 7.992 millions de paramètres d'adaptation et de lecture. Les checkpoints d'octobre QEV-0.8B et QEV-2B ci-dessous utilisent un autre parcours de chargement. Détail de taille du modèle SDK
La configuration initiale implique donc des gigaoctets. Les usages suivants peuvent reposer sur les fichiers en cache, mais la mémoire d'exécution comprend aussi activations, traitement d'image et tampons. Les parcours GPU et CPU documentés utilisent des précisions numériques différentes. Le nombre d'octets aide à planifier le stockage, sans promettre mémoire, débit ou autonomie sur une machine donnée.
Si 2B met votre ordinateur à l'épreuve, essayez QEV-0.8B
La publication d'octobre comprend QEV-0.8B, fondé sur Qwen3.5-0.8B et distillé depuis le même enseignant que le nouveau QEV-2B. C'est un point de départ pratique si la mémoire GPU ou le temps de réponse rendent 2B inconfortable. Le petit modèle conserve les décisions définies par requête et échange une partie de la qualité visuelle contre une consommation moindre. Fiche 0.8B, fiche 2B
| Mesure publiée | QEV-0.8B | QEV-2B d'octobre | Écart |
|---|---|---|---|
| Decision Index visuel public, mode accurate | 53.02 | 61.99 | 2B mène de 8.97 points d'indice |
| Allocation GPU maximale, mode accurate | 1.86 GiB | 4.44 GiB | 0.8B utilise environ 58% de moins |
| Médiane des latences p50 des profils de requête | 66.0 ms | 135.3 ms | Environ 51% de moins pour 0.8B |
| Plus haute latence p95 des profils de requête | 377.3 ms | 738.6 ms | Environ 49% de moins pour 0.8B |
| Allocation GPU maximale, mode fast | 1.60 GiB | 4.13 GiB | 0.8B économise 2.53 GiB |
| Score RealWorldQA | 39.2 | 56.2 | 2B mène de 17.0 points |
| Score Winoground | 47.5 | 65.5 | 2B mène de 18.0 points |
| Score InfographicVQA | 75.4 | 83.1 | 2B mène de 7.7 points |
Ces mesures du développeur ont été vérifiées le 20 octobre 2026. L'indice est autoévalué sur le kit visuel public, édition 0.3.2, dans l'attente d'une exécution officielle ; ce n'est pas un pourcentage global d'exactitude. L'intervalle bootstrap apparié de l'écart de 8.97 points est de 7.39–10.48 points. Les benchmarks individuels montrent la variation de l'écart selon la tâche.
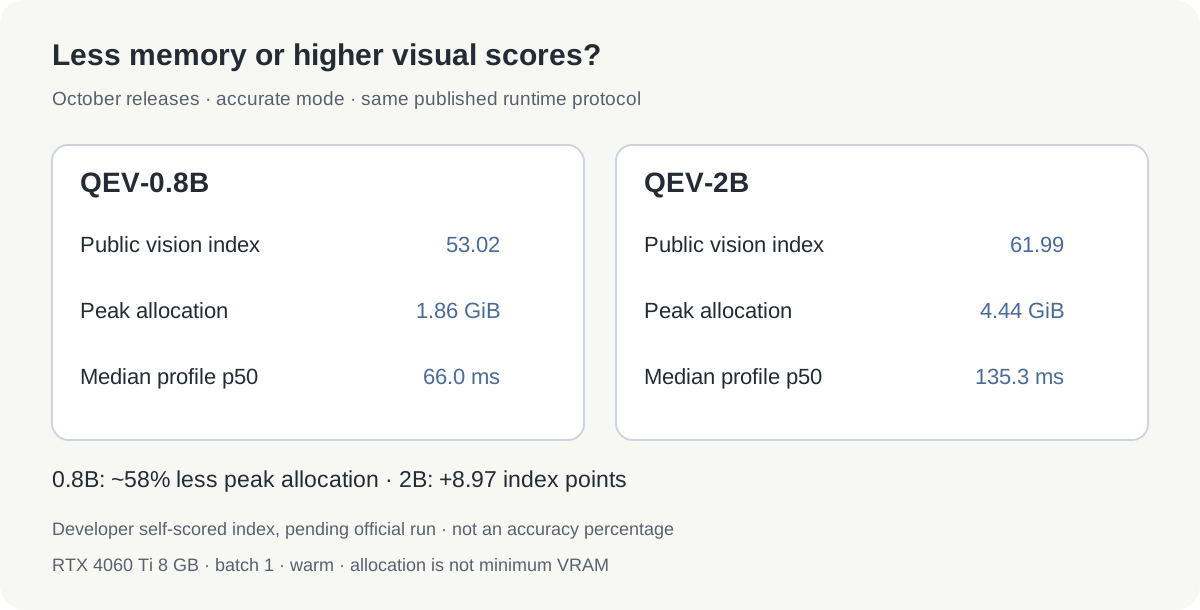 Infographie originale fondée sur les deux fiches figées. Les indices sont autoévalués ; mémoire et temps correspondent au mode accurate sur le GPU mesuré.
Les mesures utilisent une RTX 4060 Ti 8 GB, un batch de 1, un modèle préchauffé et 47 profils de requête, avec trois échauffements et 30 exécutions chronométrées par profil. Le mode accurate accepte jusqu'à 1.6 MP par image. La mémoire désigne l'allocation maximale de PyTorch, pas la capacité minimale de carte graphique : pilotes, autres applications et entrées différentes demandent aussi de la place. Les temps excluent téléchargement et chargement et ne prédisent pas les performances CPU.
Le mode fast limite les images à 0.26 MP et sort à la couche 16 sur 24. Pour 0.8B, le p50 médian tombe à 44.6 ms et le p95 du pire profil à 123.2 ms. L'exactitude interne DEV passe de 86.0% en mode accurate à 82.0%, surtout pour les documents, graphiques et écrans. Aucun Decision Index public n'est donné pour fast ; le score 53.02 appartient au mode accurate.
Utilisez un environnement Python 3.12 séparé pour ces checkpoints. L'ancien paquet qev==0.2.1 ne charge pas la version 0.8B :
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Soumettez une DecisionRequest via model.predict(request), comme dans l'exemple précédent. Commencez avec 0.8B accurate, puis essayez fast si les ressources restent insuffisantes. Passez à 2B lorsque les erreurs sur des entrées représentatives justifient la mémoire et le temps supplémentaires, en gardant les mêmes entrées et descriptions pour comparer.
Où l'essayer, et où s'arrêtent les preuves
Les bons premiers essais comportent des preuves visibles et une conséquence bornée : diriger l'image d'un document vers une file de revue, catégoriser une photo d'objet ou sélectionner la description de traitement la plus adaptée parmi plusieurs proposées. Gardez un recours à la revue humaine tout en mesurant l'aide apportée.
Choisissez un petit ensemble représentatif avant de régler les prompts. Notez l'exactitude des décisions acceptées, le taux d'abstention et les erreurs qui passent encore. Répétez selon l'éclairage, la qualité et la langue. QEV hérite de capacités d'entrée multilingue du backbone, mais ses preuves publiées d'exactitude et de calibration se concentrent sur l'anglais ; la parité en coréen ou dans une autre langue doit être testée plutôt que supposée. Fiche publique
Les évaluations de l'ancien modèle SDK limitent aussi la promesse. Dans un comparatif de 2,000 questions typées, QEV obtient 77.00% et le spécialiste textuel LAYA 76.95%, soit une question d'écart, avec un intervalle de confiance apparié traversant zéro. Cela ne prouve pas un avantage général et ne compare pas directement Jev hébergé. Ces anciens résultats sont distincts du comparatif des checkpoints d'octobre ci-dessus. La spécialisation textuelle peut aussi être plus rapide dans son propre contexte. Méthode et résultats du comparatif
Le raisonnement visuel reste inégal. L'évaluation exploratoire de 2048 rapporte zéro partie réussie en 72 tentatives. Un modèle compact capable d'identifier des matériaux sur une photo n'est pas automatiquement un planificateur spatial fiable. Notes d'évaluation
QEV mérite un essai lorsque fonctionnement local, petit backbone et sorties explicites comptent ensemble. Le parcours visuel expérimental de Jev et les autres projets Qwen rendent la direction générale claire : davantage d'applications peuvent demander un jugement borné sur une image, puis décider dans un logiciel ordinaire de l'action à lui donner.
Sources
Sources vérifiées le 20 octobre 2026. Architecture, exemples et limites de version se réfèrent aux sources publiques figées de QEV et au SDK 0.2.1. Le contexte vient de l'annonce Jev de TypeSafe, de l'article PixelJev et de la fiche AutoTrust. L'image principale est une capture éditoriale du README public de QEV ; sources et droits des médias sont consignés séparément.
Gardez les preuves originales avec la décision pour pouvoir revenir sur une classification erronée ou une règle modifiée. Créez un compte Telli.sh pour réunir sources, notes et recherches complémentaires dans un espace consultable.