[Cuaderno de ideas de IA 04] De las decisiones al estilo Jev a las imágenes: conoce QEV, un pequeño modelo basado en Qwen
Por qué surgen modelos de decisión visual en torno a Qwen, qué cambia el soporte experimental de imágenes de Jev y dónde encaja el proyecto local QEV de la clase 2B.
Cuaderno de ideas de IA explora las ideas y las posibilidades prácticas que hay detrás de los nuevos modelos y herramientas de IA.
Una fotografía llega a un flujo de clasificación. La aplicación necesita elegir entre plástico, vidrio y metal, comprobar si el objeto pertenece a una categoría proporcionada y devolver un valor que el software pueda utilizar. Un párrafo fluido que describa la botella puede ser interesante, pero deja otro paso entre el modelo y la decisión.
Jev llamó la atención sobre una interfaz diferente: dar al modelo una situación, una pregunta y las respuestas permitidas, y recibir una decisión estructurada con probabilidades. La siguiente pregunta surge de forma natural: ¿puede funcionar esa interfaz con lo que un modelo ve, además de con lo que lee?
Ahora puede hacerlo de varias formas. TypeSafe presentó soporte experimental de imágenes para Jev el 14 de octubre de 2026. También hay proyectos independientes que adaptan modelos base de visión y lenguaje Qwen a decisiones al estilo Jev. Entre ellos está QEV, un modelo local basado en Qwen3.5-2B que ofrece elecciones, puntuaciones ordenadas, decisiones booleanas y abstención. Anuncio de Jev, repositorio de QEV
Declaración del autor: QEV es el proyecto mantenido de forma independiente por el autor de este artículo. Esta introducción distingue la versión publicada de las funciones disponibles solo en el código fuente y utiliza documentación pública y ejemplos registrados; no presenta una nueva evaluación independiente del modelo.
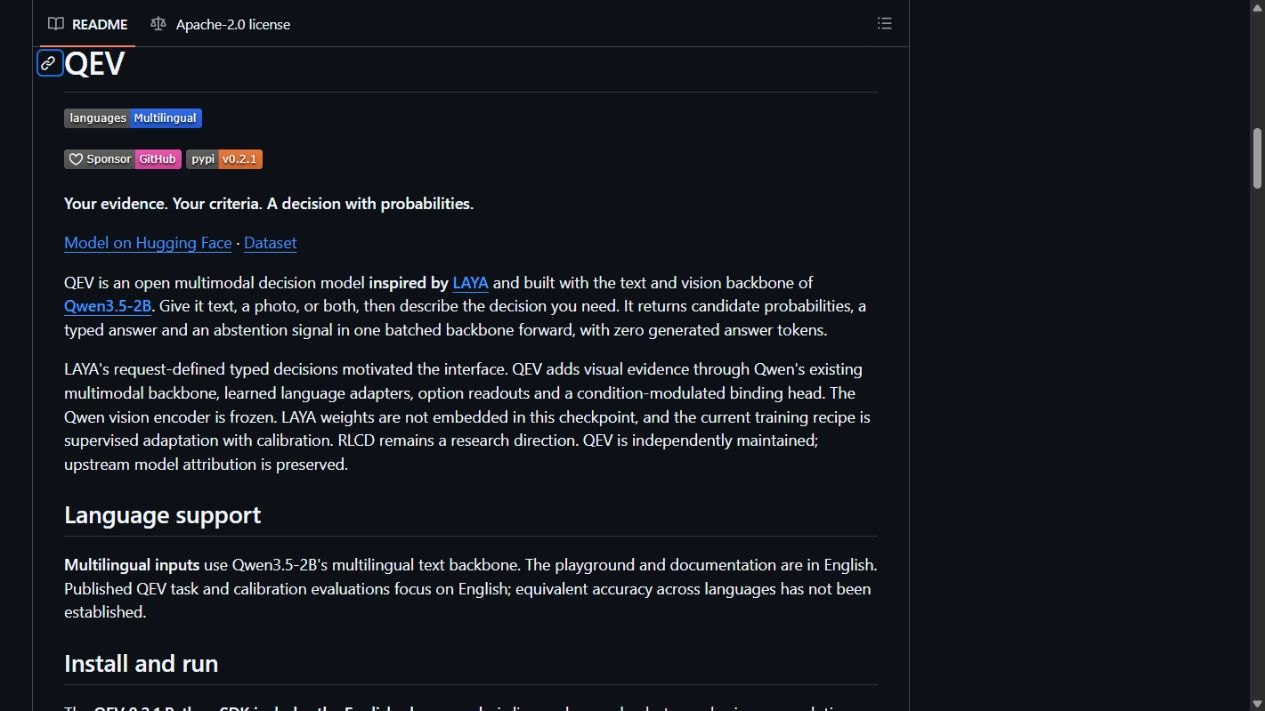 El repositorio público de QEV, capturado el 20 de octubre de 2026. Es una pantalla de documentación, no una demostración de inferencia local.
Por qué un modelo de decisión se siente distinto de un chatbot
Un chatbot suele escribir una respuesta token a token. Un modelo de decisión resulta útil cuando la aplicación ya conoce la forma de la respuesta: seleccionar un destino, valorar una condición en una escala ordenada o decidir si se cumple una afirmación.
Las opciones de respuesta pueden cambiar con cada petición. Un sistema de soporte podría ofrecer facturación y asistencia técnica hoy y añadir recuperación de cuentas mañana. Un flujo de clasificación visual podría proporcionar seis descripciones de materiales para una pregunta y otro conjunto de reglas de manejo para la siguiente. El modelo debe relacionar las pruebas actuales con esas descripciones, en lugar de elegir entre etiquetas fijas aprendidas durante el entrenamiento.
Las primitivas conocidas de Jev son choice, score y noul. En QEV, una elección devuelve una distribución sobre los candidatos proporcionados. Una puntuación utiliza niveles ordenados suministrados y devuelve sus probabilidades junto con un nivel esperado. Una pregunta noul utiliza criterios verdadero y falso. Son contratos de salida diferentes, aunque compartan el mismo modelo subyacente. Referencia de la API de QEV
Las probabilidades hacen visible el límite: una ventaja estrecha entre dos candidatos puede activar una revisión en vez de una acción automática. No hacen correcta la decisión. La aplicación sigue necesitando una política para la incertidumbre, las entradas inadecuadas y el coste de equivocarse.
Jev ya dispone de una vía experimental para imágenes
La motivación histórica necesita actualizarse. Sería engañoso presentar QEV diciendo que Jev actualmente no puede aceptar imágenes. El anuncio de octubre de TypeSafe habilita entrada experimental de imágenes para Jev 1.13 y 1.14 mediante la cabecera TypeSafe-Danger-Zone-Images. Jev 1.14 añade además la primitiva espacial Box. El anuncio describe estas funciones de imagen como experimentales. Anuncio de Jev 1.14
Eso cambia la comparación. La pregunta útil es qué despliegue, contrato de entrada y comportamiento de decisión encajan con un flujo concreto. Un experimento con Jev alojado, un modelo de investigación y una adaptación local de Qwen pueden compartir la idea de decisiones acotadas y diferir sustancialmente en empaquetado y operaciones admitidas.
QEV no tiene un equivalente documentado de la primitiva Box de Jev. Es una implementación independiente, no los pesos de TypeSafe ni una versión oficial de Jev. Compartir nombres de primitivas o un endpoint al estilo SystemOne es un punto de partida para integrar, no una prueba de que todas las peticiones puedan trasladarse intactas entre productos.
Por qué aparece Qwen en estos proyectos
Un modelo base de visión y lenguaje ya incorpora información textual y visual en un modelo compartido. Eso da a un proyecto de decisiones un punto de partida práctico: conservar la comprensión visual y adaptar después cómo relaciona el modelo las pruebas con las respuestas suministradas por una aplicación.
Dos ejemplos públicos muestran que esta dirección va más allá de un repositorio:
| Proyecto | Enfoque descrito públicamente | Cómo interpretar su estado |
|---|---|---|
| PixelJev | Estudia elecciones visuales al estilo Jev con modelos base pequeños Qwen3.5, incluidas variantes 2B y 4B | Un artículo de investigación sobre elección visual; no demuestra un reemplazo completo de Jev alojado |
| AutoTrust JEV-27B-VL | Utiliza Qwen3.8-27B con una cabeza de decisión y adaptadores | Un modelo independiente y mayor; su ficha distingue las decisiones entrenadas con texto del uso de imágenes sin ejemplos específicos |
| QEV | Adapta Qwen3.5-2B a decisiones choice, score y noul | Un proyecto local de la clase 2B con un SDK publicado y extensiones de código fuente documentadas por separado |
El artículo de PixelJev ayuda a entender la idea arquitectónica: conectar imágenes y candidatos definidos en la ejecución con una capa de lectura de decisiones. La ficha de AutoTrust ilustra otra escala de implementación y señala que no se ha establecido una calibración visual sistemática. Son ejemplos de un patrón de diseño emergente, no una clasificación por benchmark ni una lista de productos igualmente compatibles. Artículo de PixelJev, ficha del modelo de AutoTrust
El lugar de QEV en este panorama es un despliegue local compacto. «Pequeño» describe la clase de su modelo base frente a modelos de visión y lenguaje mucho mayores; no significa que toda la instalación ocupe unos megabytes ni que se ejecute al instante en cualquier dispositivo.
Cómo convierte QEV una imagen en una decisión
QEV utiliza un único modelo base Qwen3.5-2B de texto y visión. Su arquitectura publicada añade adaptación del lado del lenguaje y una capa de lectura que vincula la situación y la pregunta con las descripciones de candidatos suministradas. El modelo puntúa directamente esos candidatos, en vez de generar una frase de respuesta y pedir a otro analizador que extraiga una etiqueta. Ficha pública del modelo
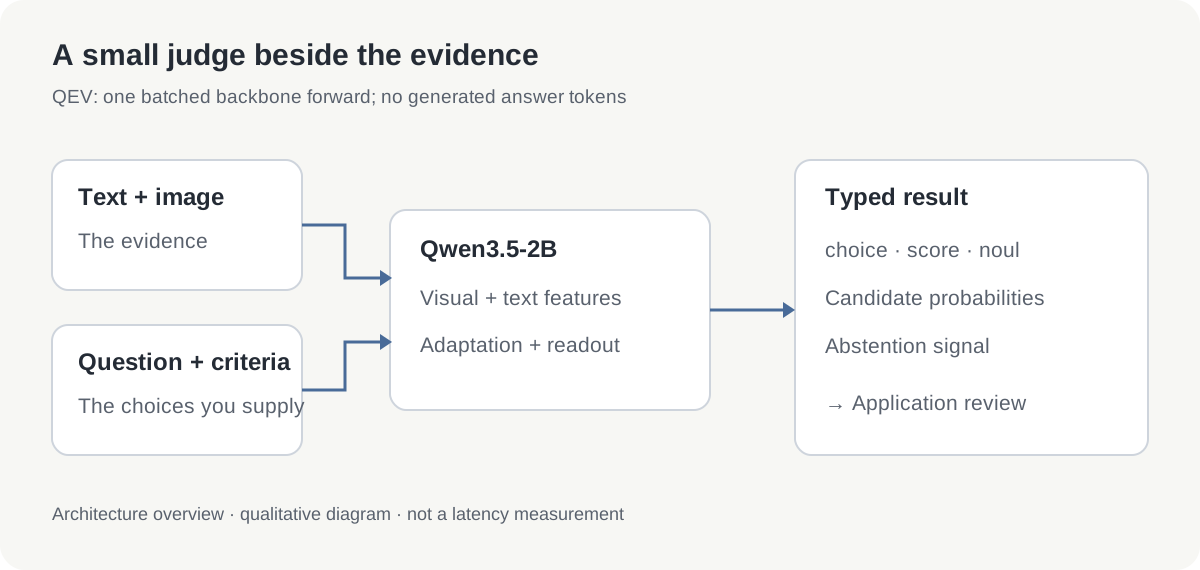 Diagrama explicativo original. Las flechas describen el recorrido de decisión documentado, no una comparación medida de velocidad.
En el SDK publicado, una petición puede contener texto, una imagen o ambos. Admite de una a cuatro preguntas, de dos a dieciséis candidatos para choice y de dos a dieciséis niveles ordenados para score. Esto permite un pequeño grupo de decisiones relacionadas sin convertir cada pregunta en una conversación de chat separada. Referencia de la API
Pensemos en una fotografía con una instrucción breve: «Elige el material según estas descripciones». Una segunda pregunta puede pedir la banda de política aplicable y una tercera si el objeto cumple una condición booleana proporcionada. La fotografía es una prueba compartida; los criterios definen el significado de cada decisión.
La vía documentada de inferencia genera cero tokens de respuesta. Eso elimina una fuente de variación de formato, pero no elimina el codificador visual, el cálculo del modelo base, el preprocesamiento de imágenes ni el sobrecoste de la aplicación. «Sin respuesta generada» y «sin coste computacional» son afirmaciones muy distintas.
Interpreta el ejemplo de la botella como un ejemplo
El repositorio de QEV incluye una fotografía con licencia y una salida registrada para una botella de plástico. Es una forma útil de ver la estructura de respuesta antes de instalar nada.
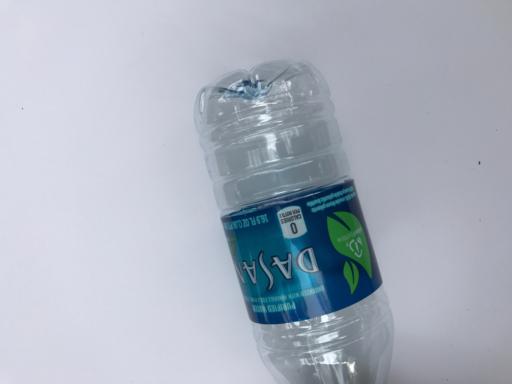 Entrada del ejemplo publicado en el caso fotográfico de QEV, procedente originalmente de TrashNet. Copyright 2017 Gary Thung, licencia MIT; se conserva el aviso de licencia.
| Pregunta del caso publicado | Resultado registrado | Qué significa |
|---|---|---|
| Elegir entre seis materiales | Plástico, probabilidad aproximada de 0.9361 | El plástico recibe la mayor proporción entre los candidatos proporcionados |
| Elegir una banda de política ordenada | Nivel esperado aproximado de 0.4254 en una escala de 0–2 | Un promedio ponderado de los índices de las tres bandas proporcionadas |
| ¿Pertenece a vidrio, papel o plástico? | Verdadero, probabilidad aproximada de 0.7903 | El criterio booleano se favorece frente a su alternativa falsa |
La puntuación requiere especial cuidado. En este caso, la banda 0 agrupa vidrio y plástico, la 1 metal y basura y la 2 cartón y papel. El orden es una política de ejemplo. La cifra 0.4254 no es una valoración de seguridad, una norma de reciclaje ni la confianza de la elección de material.
Del mismo modo, la probabilidad del plástico describe esta petición y sus candidatos. No demuestra que el 93.61% de todas las fotografías de botellas vayan a clasificarse correctamente. Es un caso de la versión previamente inspeccionado, no una nueva prueba con datos reservados, y la salida anterior fue registrada por el proyecto, no reproducida para este artículo.
Qué debería significar aquí «compatible con Jev»
La compatibilidad se entiende mejor por capas. Está la idea compartida de decisiones definidas por la petición, el esquema JSON exacto, las entradas admitidas y el comportamiento de cada tipo de salida. Coincidir en una capa no implica coincidir automáticamente en las demás.
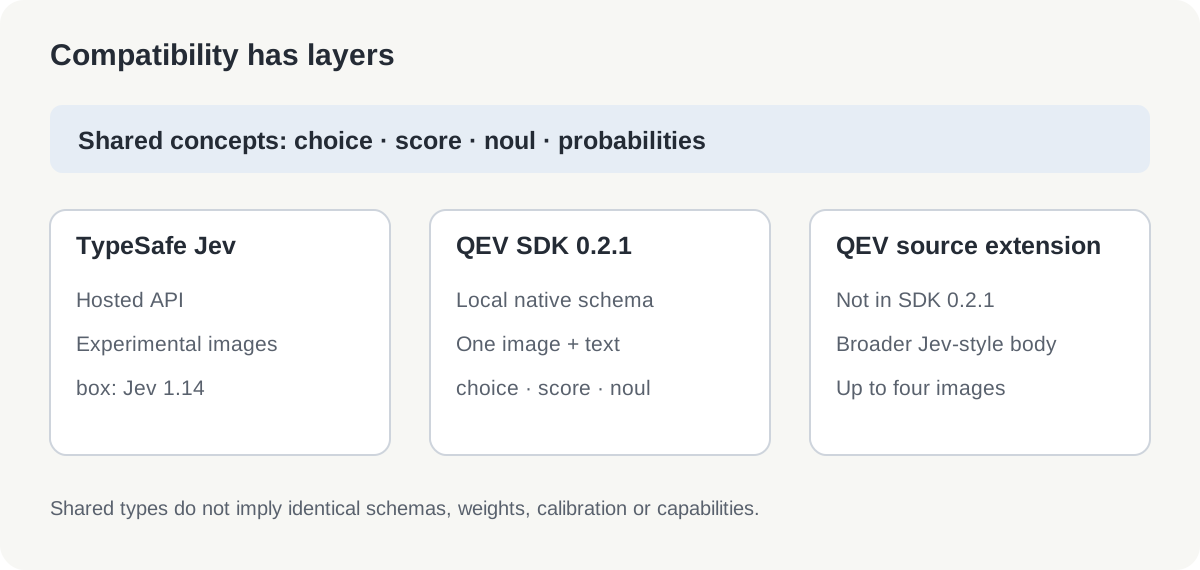 Mapa de compatibilidad original, comprobado el 20 de octubre de 2026. Las extensiones del código fuente son independientes del contrato del SDK empaquetado.
El SDK empaquetado QEV 0.2.1 utiliza el esquema nativo de QEV y una única imagen opcional. La copia pública del código fuente también documenta un manejo más amplio de peticiones al estilo Jev/SystemOne y hasta cuatro imágenes ordenadas. No debe darse por hecho que esas extensiones existan en el paquete 0.2.1 publicado. API y notas de versión, versión 0.2.1
Para integrar, empieza por una petición conocida y compara la validación, los campos de respuesta, el orden de los candidatos y el comportamiento de incertidumbre. Una ruta familiar /v1/systemone por sí sola no establece un reemplazo universal sin cambios del servicio o SDK de TypeSafe.
Una primera exploración práctica
Para empezar a explorar, el entorno de pruebas local es más fácil de inspeccionar que una integración de aplicación.
- Prepara un entorno Python 3.12 y actívalo.
- Instala la versión fijada y arranca el entorno de pruebas con los comandos siguientes.
- Abre
http://127.0.0.1:7860, elige un ejemplo e inspecciona las probabilidades de los candidatos y la abstención.
python -m pip install qev==0.2.1
qev playground
El entorno de pruebas documentado se ejecuta localmente en http://127.0.0.1:7860. Incluye fotografías de ejemplo y muestra probabilidades, abstención y salida estructurada. La interfaz y la documentación están en inglés. Son instrucciones de instalación de la versión, no una afirmación de que el modelo se haya instalado o cronometrado para este artículo. Guía del entorno de pruebas
Una pequeña petición de texto muestra la forma del SDK nativo:
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
Empieza por dos o tres candidatos claramente diferentes. Después prueba un caso ambiguo y otro que no pertenezca a ninguno. Inspecciona si la abstención y la política de tu aplicación producen un resultado útil. Para las imágenes, utiliza fotografías que tengas derecho a procesar y escribe criterios basados en pruebas visibles, no en hechos que la imagen no puede demostrar.
Calcula el presupuesto del modelo base, no solo del adaptador
Para la vía anterior del SDK 0.2.1, el checkpoint de adaptación de QEV ocupa aproximadamente 32.01 MB, con una descarga independiente del modelo base Qwen de unos 4.55 GB. El desglose publicado enumera aproximadamente 2.213 mil millones de parámetros del modelo base y 7.992 millones de parámetros de adaptación y lectura. Los checkpoints de octubre QEV-0.8B y QEV-2B descritos a continuación utilizan una vía independiente de carga de la versión. Desglose de tamaño del modelo del SDK
Por tanto, la preparación inicial implica gigabytes. Los usos posteriores pueden aprovechar archivos en caché, pero la memoria en ejecución también incluye activaciones, procesamiento de imágenes y búferes. Las vías documentadas de GPU y CPU emplean precisiones numéricas diferentes. El tamaño en bytes de un checkpoint sirve para planificar almacenamiento, no promete memoria, rendimiento ni consumo de batería en un equipo concreto.
Si 2B exige demasiado a tu ordenador, prueba QEV-0.8B
La versión de octubre incluye QEV-0.8B, basado en Qwen3.5-0.8B y destilado del mismo modelo profesor que el nuevo QEV-2B. Es un punto de partida práctico cuando la memoria de GPU o el tiempo de respuesta hacen incómodo usar 2B. El modelo menor conserva las decisiones definidas por la petición, intercambiando parte de la calidad de decisión visual por un menor uso de recursos. Ficha del modelo 0.8B, ficha del modelo 2B
| Medida publicada | QEV-0.8B | QEV-2B de octubre | Diferencia |
|---|---|---|---|
| Decision Index visual público, modo accurate | 53.02 | 61.99 | 2B aventaja en 8.97 puntos del índice |
| Asignación máxima de GPU, modo accurate | 1.86 GiB | 4.44 GiB | 0.8B utiliza aproximadamente un 58% menos |
| Mediana de las latencias p50 de los perfiles de petición | 66.0 ms | 135.3 ms | Aproximadamente un 51% menor con 0.8B |
| Mayor latencia p95 entre perfiles de petición | 377.3 ms | 738.6 ms | Aproximadamente un 49% menor con 0.8B |
| Asignación máxima de GPU, modo fast | 1.60 GiB | 4.13 GiB | 0.8B ahorra 2.53 GiB |
| Puntuación RealWorldQA | 39.2 | 56.2 | 2B aventaja en 17.0 puntos |
| Puntuación Winoground | 47.5 | 65.5 | 2B aventaja en 18.0 puntos |
| Puntuación InfographicVQA | 75.4 | 83.1 | 2B aventaja en 7.7 puntos |
Son mediciones del desarrollador comprobadas el 20 de octubre de 2026. El índice es una autoevaluación con el kit visual público, edición 0.3.2, pendiente de una ejecución oficial; no es un porcentaje de exactitud global. El intervalo bootstrap emparejado para la diferencia de 8.97 puntos es de 7.39–10.48 puntos. Los benchmarks individuales muestran cómo varía la brecha según la tarea.
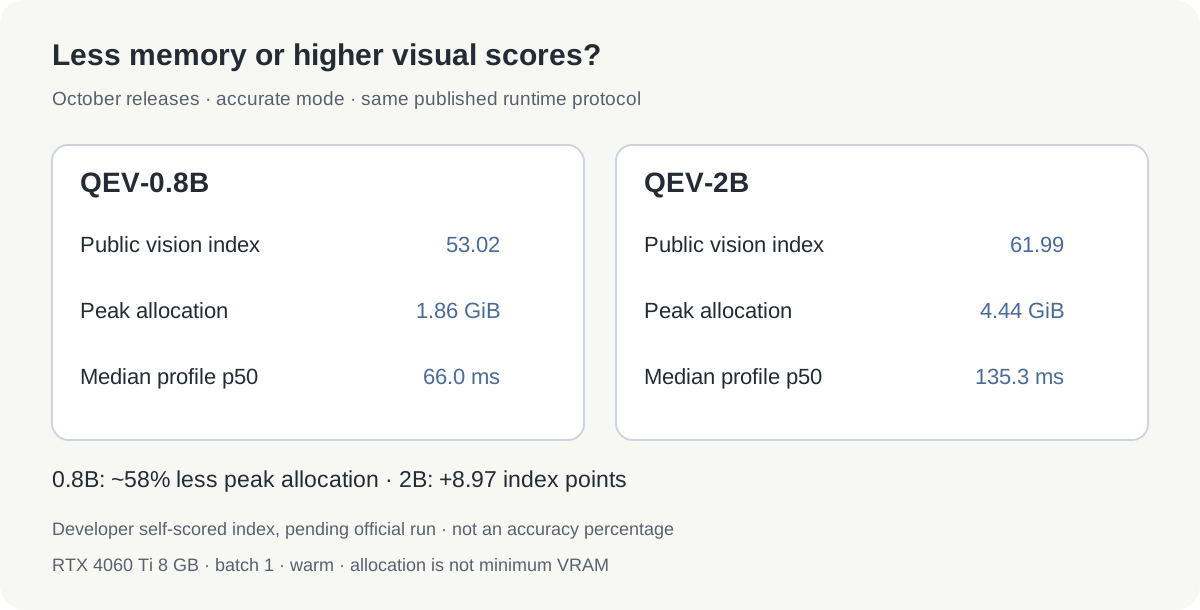 Infografía comparativa original basada en las dos fichas fijadas de los modelos. Los índices son autoevaluados; memoria y tiempos corresponden al modo accurate en la GPU medida.
Las mediciones de ejecución utilizan una RTX 4060 Ti de 8 GB, lote 1, un modelo ya calentado y 47 perfiles de petición, con tres calentamientos y 30 ejecuciones cronometradas por perfil. El modo accurate permite hasta 1.6 MP por imagen. La memoria es la asignación máxima de PyTorch, no la capacidad mínima de la tarjeta: controladores, otras aplicaciones y entradas diferentes también necesitan espacio. Los tiempos excluyen la descarga y la carga del modelo y no predicen el rendimiento en CPU.
El modo fast limita las imágenes a 0.26 MP y sale en la capa 16 de 24. Con 0.8B, la mediana p50 baja a 44.6 ms y el p95 del peor perfil a 123.2 ms. La exactitud interna DEV cae del 86.0% en modo accurate al 82.0%, afectando especialmente a documentos, gráficas y pantallas. No se publica un Decision Index para el modo fast; la puntuación 53.02 pertenece al modo accurate.
Utiliza un entorno Python 3.12 separado para estos checkpoints. El paquete antiguo qev==0.2.1 no carga la versión 0.8B:
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
Envía un DecisionRequest mediante model.predict(request), como en el ejemplo anterior. Empieza con 0.8B en modo accurate y prueba fast si los recursos siguen siendo limitados. Pasa a 2B cuando los errores en entradas representativas justifiquen la memoria y el tiempo adicionales, manteniendo iguales las entradas y descripciones de candidatos para comparar.
Dónde probarlo y hasta dónde llegan las pruebas
Los buenos primeros experimentos tienen pruebas visibles y consecuencias acotadas: enviar la imagen de un documento a una cola de revisión, clasificar una foto de un objeto o elegir qué descripción de manejo, entre varias suministradas, encaja mejor con la entrada. Conserva una vía de revisión humana mientras mides si el modelo ayuda.
Elige un conjunto pequeño y representativo antes de ajustar los prompts. Registra la exactitud de las decisiones aceptadas, la tasa de abstención y los errores que aún se cuelan. Repite con distintas iluminaciones, calidades de imagen e idiomas. QEV hereda capacidades multilingües de entrada de su modelo base, pero las pruebas publicadas de exactitud y calibración se centran en el inglés; la paridad en coreano u otros idiomas debe comprobarse, no darse por hecha. Ficha pública del modelo
Las evaluaciones del modelo del SDK antiguo también delimitan la promesa. En una comparación de decisiones tipadas de 2,000 preguntas, QEV obtuvo un 77.00% y el especialista textual LAYA un 76.95%: una diferencia de una pregunta, con un intervalo de confianza emparejado que cruza el cero. No demuestra una ventaja general de exactitud y no es una comparación directa con Jev alojado. Estos resultados antiguos son independientes de la comparación de checkpoints de octubre anterior. La especialización solo textual también puede ser más rápida en su propio contexto. Metodología y resultados de la comparación
El razonamiento visual sigue siendo desigual. La evaluación exploratoria del proyecto sobre 2048 no informa de ninguna partida ganada en 72 intentos. Un modelo compacto capaz de identificar materiales en una fotografía no es automáticamente un planificador espacial fiable. Notas de evaluación
Merece la pena explorar QEV cuando importan a la vez la ejecución local, una clase pequeña de modelo base y salidas de decisión explícitas. La vía experimental de imágenes de Jev y los demás proyectos basados en Qwen dejan clara la dirección más amplia: más aplicaciones pueden pedir al modelo un juicio acotado sobre una imagen y decidir después qué hacer con él mediante software convencional.
Fuentes
Fuentes consultadas el 20 de octubre de 2026. La arquitectura, los ejemplos y los límites de las versiones anteriores remiten al código fuente público fijado de QEV y al SDK 0.2.1. El contexto más amplio procede del anuncio de Jev de TypeSafe, el artículo de PixelJev y la ficha del modelo de AutoTrust. La imagen principal es una captura editorial del README público de QEV; las fuentes y derechos de los recursos visuales se registran por separado.
Conserva las pruebas originales junto a la decisión para poder revisar una clasificación errónea o una política modificada. Crea una cuenta en Telli.sh para reunir fuentes, notas e investigación posterior en un único espacio de trabajo con búsqueda.