Dlaczego PFN chce ułożyć pamięć na swoim następnym chipie AI
Współpraca PFN i SEMIFIVE nad MN-Core L2000 ma usunąć wąskie gardło pamięci podczas inferencji AI. Co plan rozwoju oznacza dla agentów, prywatnej AI i przyszłych zakupów sprzętu.
Asystent AI może mieć dość pamięci, by załadować model, a mimo to każda jego odpowiedź może wydawać się powolna. Jednostki obliczeniowe są gotowe, ale użyteczna praca zależy od dostarczenia im właściwych danych we właściwym momencie. Dla firmy obsługującej kilka prywatnych asystentów ta różnica może zamienić imponującą specyfikację chipu w uciążliwe oczekiwanie na kolejne słowa.
Preferred Networks i SEMIFIVE stawiają w swoim projekcie na rozwiązanie tego problemu. Komunikat z 16 listopada 2026 roku opisuje serię MN-Core L2000, procesor przeznaczony do inferencji, w którym układy logiczne i DRAM są ułożone pionowo. Deklarowany cel to ponad dwukrotna przepustowość pamięci względem poprzedzającej serii L1000. PFN zamieściło komunikat na swojej stronie 17 listopada. Komunikat PFN
Interesujące jest to, co taki projekt mógłby zmienić dla ludzi, którzy będą kiedyś utrzymywać usługi AI. Szybsze przesyłanie danych może być równie ważne jak dodatkowa moc obliczeniowa, a obudowa układu, obsługa programowa i gotowy serwer decydują, czy korzyść dotrze na ekran użytkownika. Zapowiedź L2000 pomaga uporządkować te decyzje, zanim nadejdzie moment zakupu.
Firma stojąca za PLaMo projektuje także sprzęt pod nim
Preferred Networks to tokijska firma AI zajmująca się procesorami, infrastrukturą obliczeniową i rodziną modeli PLaMo. W tej współpracy PFN odpowiada za architekturę procesora i projekt logiki, a SEMIFIVE zapewnia realizację projektu i usługi łańcucha dostaw, korzystając z platformy Samsung Foundry oraz infrastruktury projektowej 3D-IC. Firma PFN i podział prac rozwojowych
Ten podział zadań ma znaczenie, ponieważ użyteczny akcelerator to więcej niż lista instrukcji czy rysunek chipu. Projekt logiki musi stać się krzemowym układem nadającym się do produkcji, trzeba podłączyć pamięć, a gotowe układy muszą działać powtarzalnie. Klient potrzebuje ostatecznie odtwarzalnej konfiguracji serwera i oprogramowania, które pozwoli zamienić model w aplikację. Każde przekazanie prac może wpłynąć na koszt gotowego produktu i termin dostawy.
Związek z PLaMo daje czytelnikom znajomy punkt odniesienia, ale nie dowodzi, że każde wdrożenie PLaMo zostanie przeniesione na ten sprzęt. Twórca modelu i nabywca infrastruktury zadają też inne pytania. Twórcę interesuje, czy obciążenie można wydajnie opisać, a nabywcę — czy wspierana implementacja spełni wymagania usługi przez cały okres eksploatacji instalacji.
Dla czytelników z Korei udział SEMIFIVE jest konkretnym przykładem wykorzystania lokalnych kompetencji w projektowaniu półprzewodników do budowy infrastruktury inferencji. Warto teraz pytać, jak te kompetencje przełożą się na produkowane urządzenia i wspierane systemy. Komunikat o współpracy wskazuje uczestników i kierunek; produkty powstałe w dalszych etapach określą rzeczywiste możliwości klientów.
Pojemność i przepustowość pamięci odpowiadają na różne pytania
Pojemność mówi, ile danych może pomieścić system pamięci. Przepustowość określa, ile danych może przesłać w danym czasie. Model może mieścić się w pierwszym limicie, a drugi nadal ograniczać tempo pracy procesora. Samo dodanie pojemności nie gwarantuje, że aplikacja zacznie reagować szybciej.
Proste obliczenie planistyczne pokazuje pierwszą różnicę. Hipotetyczny model gęsty z 30 miliardami parametrów, przechowywanych po dwa bajty na parametr, wymaga około 60 miliardów bajtów na same parametry. Nie obejmuje to pamięci roboczej środowiska wykonawczego, buforowanych danych uwagi ani innych narzutów. To ilustracja planowania pojemności, a nie informacja o pamięci L2000 czy obsługiwanych przez niego modelach.
Następne pytanie dotyczy sposobu wykorzystania przechowywanych danych. Przetwarzanie otrzymanego promptu i generowanie kolejnych tokenów odpowiedzi stawiają systemowi odmienne wymagania. Wyjaśnienie optymalizacji inferencji autorstwa NVIDIA rozróżnia równoległe przetwarzanie promptu i autoregresyjne dekodowanie, podczas którego przesyłanie danych z pamięci może stać się ograniczeniem. Pokazuje także, dlaczego przetwarzanie wsadowe i zarządzanie pamięcią podręczną uwagi zmieniają tę równowagę. Poradnik NVIDIA o optymalizacji inferencji, 17 listopada 2023 roku
Można wyobrazić sobie pamięć jako spiżarnię połączoną z kuchnią. Większa spiżarnia pozwala trzymać składniki na miejscu; szersze przejście ułatwia ich dostarczanie do kuchni. Żadna z tych cech nie mówi, ile potrwa przygotowanie konkretnego posiłku, bo liczy się też samo gotowanie i reszta procesu. Porównania sprzętu stają się bardziej użyteczne, gdy te odrębne role pozostają widoczne.
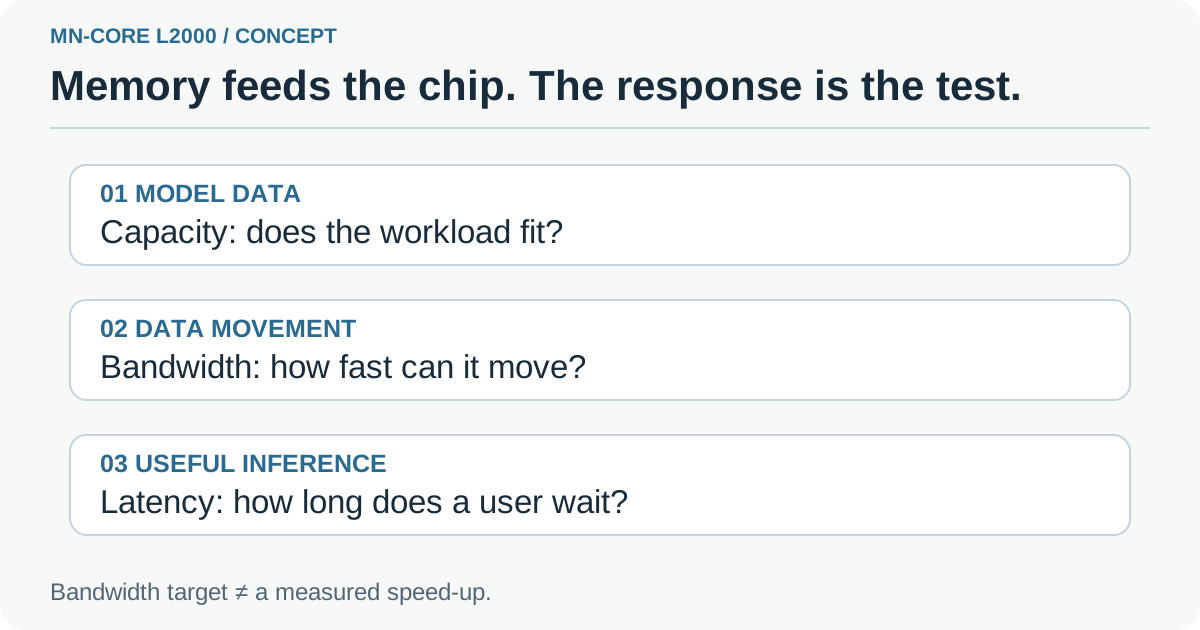
Autorski diagram wyjaśniający różnicę między przechowywaniem danych, ich przesyłaniem i odpowiedzią aplikacji. Ilustruje problem decyzyjny, a nie nieopublikowany układ obudowy L2000.
Układanie warstw zmienia także problem inżynieryjny
Oficjalny komunikat PFN zawiera schemat pionowo ułożonej logiki i DRAM w serii MN-Core L. Pomaga on zobaczyć proponowany kierunek rozwoju. Nie przedstawia kompletnego serwera do instalacji u klienta ani nie potwierdza wydajności gotowej aplikacji.
Umieszczenie komponentów w stosie oznacza, że projekt musi działać jako system fizyczny. Dostarczanie energii, odprowadzanie ciepła i powtarzalność produkcji należą do tej samej rozmowy co przesyłanie danych. Nie są dodatkami, którymi można zająć się dopiero wtedy, gdy architektura dobrze wygląda na slajdzie. Wpływają na możliwość produkcji, obudowywania, chłodzenia i wspierania układów przy rozsądnym koszcie.
Dla operatora projekt obudowy jest więc początkiem analizy, nie jej końcem. Szafa ma budżet mocy, obiekt — projekt chłodzenia, a usługa — wymagania dostępności. Proponowany akcelerator musi ostatecznie pasować do wszystkich trzech. Korzyść ekonomiczna zależy od całej instalacji, wraz ze sprzętem i pracą potrzebnymi do jej utrzymania.
Dlatego opowieść o efektywności powinna zawsze zawierać warunki pomiaru. Dobry wynik dla jednego modelu, precyzji i poziomu współbieżności nie opisuje wszystkich obciążeń. Klient musi zobaczyć, gdzie system działa dobrze, gdzie kończy się zapas wydajności i ile energii zużywa cała usługa na dostarczenie użytecznych odpowiedzi.
Trzy zastosowania stawiają trzy różne pytania
Rozważmy prywatnego asystenta dokumentowego dla zespołu prawnego lub inżynieryjnego. W tej przykładowej usłudze zapytania napływają nieregularnie, a użytkownicy zauważają opóźnienie przed początkiem odpowiedzi. Ocena powinna uwzględniać reprezentatywne dokumenty, czas wyszukiwania i pierwszą odpowiedź modelu. Akcelerator może przyspieszyć fragment tej ścieżki, podczas gdy wyszukiwanie dokumentów lub sprawdzanie uprawnień nadal trwa dłużej.
Drugi przykład to wewnętrzny agent wielokrotnie wywołujący model podczas wykonywania zadania. Jedno powolne generowanie może tu opóźnić kilka zależnych kroków. Użyteczny wynik to czas ukończenia poprawnie autoryzowanego zadania, wraz z rezultatami narzędzi i ewentualną akceptacją człowieka. Większe tempo tokenów poprawia tylko tę część procesu, która faktycznie czeka na generowanie.
Trzecim przykładem jest kolejka nocnego przetwarzania, która klasyfikuje lub streszcza duży zbiór rekordów. Może akceptować większe partie danych i bardziej liczyć ukończoną pracę przed terminem. Takie obciążenie może wymagać innej konfiguracji niż asystent interaktywny, nawet jeśli używa tego samego modelu. Przegląd zakupowy powinien zachować tę różnicę zamiast wybierać demonstrację z największą liczbą w nagłówku.
Te scenariusze to plany oceny, nie testy L2000. Pokazują, dlaczego warto śledzić architekturę skupioną na pamięci, nie zakładając z góry jednego wyniku wydajności. Najlepszy pilotaż zaczyna się od obciążenia dobrze znanego zespołowi i wyniku, który można porównać z obecną infrastrukturą.
| Decyzja | Co powinien przygotować zespół | Co musi pokazać wynik |
|---|---|---|
| Prywatny asystent dokumentowy | Reprezentatywne pytania, dokumenty i reguły dostępu | Użyteczne odpowiedzi mieszczą się w uzgodnionym czasie reakcji |
| Wieloetapowy agent wewnętrzny | Kompletne zadania, wywołania narzędzi i punkty akceptacji | Całe zadanie kończy się szybciej bez utraty poprawności |
| Kolejka nocnego przetwarzania | Stały zbiór rekordów i termin ukończenia | Wymagana praca kończy się niezawodnie w ramach budżetu operacyjnego |
Docelowa przepustowość to tylko jedna część oceny usługi
Naszym zdaniem najbardziej użyteczne porównanie zaczyna się od pracy, którą zamierzamy kupić. Zespół nie nabywa samej przepustowości; nabywa zdolność wykonywania zadań przy określonych ograniczeniach. Potrzebny jest więc ciąg dowodów łączący model i środowisko wykonawcze z serwerem i aplikacją.
Zacznij od obsługi modeli. Konkretna architektura, precyzja i wymagane operatory muszą działać we wspieranym stosie oprogramowania. Kompilator lub środowisko wykonawcze uruchamiające demonstrację może nadal wymagać integracji przed wdrożeniem produkcyjnym. Zapytaj o wspierane wersje, operacje wymagające konwersji i osobę odpowiedzialną za utrzymanie tej ścieżki po zmianie modelu.
Następnie rozdziel miary czasu odpowiedzi. Czas do pierwszej użytecznej odpowiedzi, tempo generowania i łączna liczba obsłużonych żądań opisują różne doświadczenia. Zapisuj je przy tych samych rozmiarach danych wejściowych i współbieżności, uwzględniając odpowiedzi błędne i niepełne. Szybszy przebieg, który zmienia jakość lub po cichu odrzuca żądania, jest innym wynikiem niż poprawa usługi.
Na koniec przywróć kontekst aplikacji wokół modelu. Wyszukiwanie, moderacja, dostęp do narzędzi, kolejki i komunikacja sieciowa też zajmują czas. Pilotaż sprzętu powinien pokazać, jak duża część całego zadania czeka na inferencję. To daje zespołowi rozsądną podstawę do oszacowania rzeczywistej korzyści z szybszego wykonywania modelu.
Następny widoczny kamień milowy to przekazanie projektu
Zapowiedziany termin tape-out to pierwszy kwartał 2027 roku: moment przekazania ostatecznych danych projektowych do produkcji. To etap rozwoju, a nie termin dostawy gotowego serwera. Plan rozwoju PFN
Produkcja, obudowywanie układów, pierwsze uruchomienie i walidacja muszą jeszcze połączyć projekt z użytecznym produktem. Kwalifikacja oprogramowania i integracja systemu określą następnie, co klienci będą mogli wdrożyć. Postęp na tych etapach może przynieść ważne wiadomości długo przed rozpoczęciem ogólnej sprzedaży, ale każdy etap odpowiada na inne pytanie.
Ta sama zasada dotyczy punktu odniesienia. Premiera L1000 także jest planowana na 2027 rok, więc komunikat porównuje generacje rozwojowe, a nie dwa systemy dostępne dziś w sprzedaży. Nie podaje ceny detalicznej L2000, harmonogramu dostaw do Korei ani benchmarku gotowego systemu. Terminy zakupowe powinny opierać się na przyszłej wspieranej konfiguracji i warunkach dostawy określonych przez dostawcę.
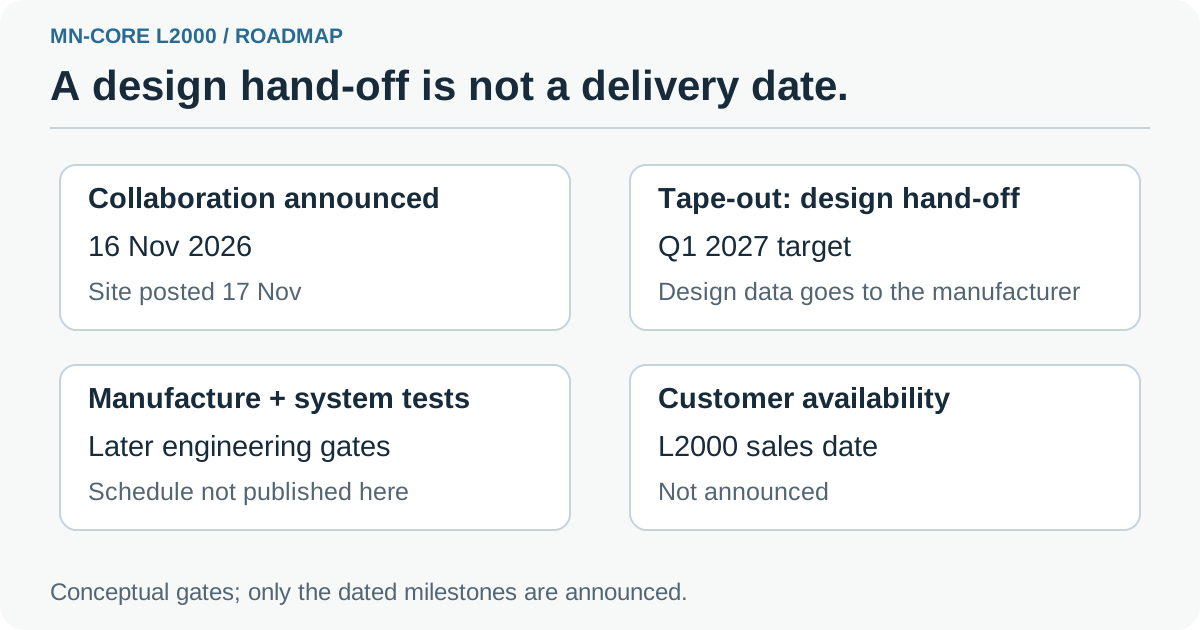
Autorski przewodnik po etapach rozwoju. Zapowiedziany termin tape-out jest oddzielony od późniejszej produkcji, kwalifikacji i dostaw do klientów; daty tych dalszych etapów pozostają otwarte.
Co powinien zawierać praktyczny zestaw materiałów do oceny
Śledząc plan rozwoju, zespół może już wykonać użyteczną pracę. Powinien przygotować zwięzły punkt odniesienia, przydatny niezależnie od tego, czy ostatecznie kupi system MN-Core, serwer GPU, czy usługę hostowaną. Chodzi o to, by przyszłe porównania sprzętu były tańsze i bardziej miarodajne.
- Wybierz całe zadanie. Zdefiniuj jedno zadanie interaktywne i, jeśli to istotne, jedno wsadowe. Zapisz kryterium poprawnego ukończenia oraz wymagany czas odpowiedzi lub termin zakończenia.
- Ustal materiał testowy i wersje oprogramowania. Przechowuj razem prompty, dokumenty wejściowe, rewizję modelu, precyzję i ustawienia środowiska wykonawczego. Używaj materiałów, które zespół ma prawo przetwarzać.
- Zmierz obecną ścieżkę. Zapisz czas odpowiedzi modelu, czas całego zadania, błędy i wykorzystanie zasobów przy oczekiwanym obciążeniu. Odnotuj, kiedy usługa czeka na wyszukiwanie lub narzędzia zamiast na generowanie.
- Poproś o porównywalną wspieraną konfigurację. Przyszły test u dostawcy powinien wskazywać akcelerator, konfigurację pamięci, hosta, środowisko wykonawcze i obsługiwane modele. Zachowaj widoczność zmian jakości lub precyzji.
- Porównaj decyzję operacyjną. Uwzględnij zakup, integrację oprogramowania, energię, chłodzenie, wsparcie i odtwarzanie po awarii. Oceń, czy poprawa rozwiązuje pierwotne zadanie przy akceptowalnym koszcie.
Taki zestaw jest bardziej użyteczny niż kolekcja niepowiązanych zrzutów ekranu z wynikami przepustowości. Zapobiega zmienianiu obciążenia przy pojawieniu się każdego nowego systemu. Ułatwia też rozpoznanie rzeczywistej korzyści: tego samego zadania wykonanego poprawnie, z mniejszym opóźnieniem lub mniejszym obciążeniem operacyjnym.
Mały zespół może na razie zdecydować się pozostać przy obecnym sprzęcie i poprawić aplikację. Jeśli czas odpowiedzi jest zdominowany przez wyszukiwanie, sama szybsza inferencja niewiele zmieni. Jeżeli przy wymaganym obciążeniu usługa stale czeka na generowanie, nowy akcelerator staje się bardziej odpowiednim kandydatem do prób. Oba ustalenia pomagają kierować wydatki na wąskie gardło odczuwane przez użytkowników.
Rozwój sprzętu przesuwa się bliżej pamięci
Warto śledzić współpracę nad L2000, ponieważ łączy problem inferencji z fizycznym projektem i pracą produkcyjną potrzebnymi do jego rozwiązania. Kolejnymi użytecznymi dowodami będą postępy produkcji i kwalifikacji oprogramowania, a potem pomiary wspieranych systemów. Wyniki pokażą, jakie obciążenia zyskują i co operator musi zainwestować, by uzyskać tę korzyść.
Na razie praktyczny wniosek jest już dostępny. Porównując sprzęt AI, oddzielaj pojemność modelu, przesyłanie danych i rezultaty aplikacji. Zmieszczenie modelu w pamięci to początek rozmowy; niezawodna usługa to wynik, którego potrzebuje nabywca.
Źródła
- Preferred Networks, PFN and SEMIFIVE Collaborate to Develop the MN-Core L2000 Series, komunikat datowany na 16 listopada 2026 roku; publikacja w witrynie 17 listopada 2026 roku. Zawiera oficjalny schemat struktury i harmonogram rozwoju.
- Preferred Networks, komunikat w języku japońskim, odpowiadająca mu publikacja firmy.
- Shashank Verma i Neal Vaidya, NVIDIA Technical Blog, Mastering LLM Techniques: Inference Optimization, 17 listopada 2023 roku. Tło dotyczące etapów inferencji, przetwarzania wsadowego i wykorzystania pamięci, nie benchmark sprzętu MN-Core.
Przechowuj razem obciążenie, ustawienia modelu i odpowiedzi dostawców, aby kolejna ocena zaczynała się od porównywalnej podstawy. Utwórz pierwszą notatkę w Telli.sh.