Perché PFN vuole impilare la memoria sul suo prossimo chip per l’IA
La collaborazione tra PFN e SEMIFIVE per MN-Core L2000 affronta un collo di bottiglia della memoria nell’inferenza. Cosa significa il piano di sviluppo per agenti, IA privata e futuri acquisti hardware.
Un assistente di IA può avere abbastanza memoria per caricare un modello e far comunque sembrare lenta ogni risposta. Le unità aritmetiche sono pronte, ma per un calcolo utile servono i dati giusti al momento giusto. Per un’azienda che gestisce più assistenti privati, questa differenza può trasformare una specifica impressionante in un’attesa fastidiosa tra una parola e l’altra.
Preferred Networks e SEMIFIVE puntano sullo sviluppo per affrontare il problema. L’annuncio del 16 novembre 2026 descrive la serie MN-Core L2000, un processore dedicato all’inferenza che impila verticalmente logica e DRAM. L’obiettivo dichiarato è superare il doppio della banda di memoria della precedente serie L1000. PFN ha pubblicato l’annuncio sul proprio sito il 17 novembre. Annuncio di PFN
La domanda interessante è cosa potrebbe cambiare per chi un giorno gestirà servizi di IA. Spostare i dati più velocemente può contare quanto aggiungere potenza aritmetica, mentre packaging, supporto software e server finito determinano se il beneficio arriverà allo schermo dell’utente. L’annuncio di L2000 offre un modo utile per ragionare su queste decisioni prima di dover acquistare.
L’azienda dietro PLaMo progetta anche le macchine che lo sostengono
Preferred Networks è un’azienda di IA con sede a Tokyo, attiva nei processori, nell’infrastruttura di calcolo e nella famiglia di modelli PLaMo. In questa collaborazione PFN si occupa dell’architettura del processore e della progettazione logica; SEMIFIVE fornisce implementazione e servizi di filiera attraverso la piattaforma di Samsung Foundry e la sua infrastruttura di progettazione 3D-IC. PFN e i ruoli nello sviluppo
La divisione è importante perché un acceleratore utile non è solo un insieme di istruzioni o il disegno di un chip. La logica deve diventare silicio fabbricabile, la memoria deve essere collegata e i dispositivi nel package devono funzionare con regolarità. Il cliente ha infine bisogno di una configurazione server riproducibile e di un percorso software che trasformi il modello in un’applicazione. Ogni passaggio di consegne può influire sul costo e sui tempi di consegna del prodotto finito.
Il legame con PLaMo offre un punto d’ingresso familiare, ma non prova che ogni sua installazione passerà a questo hardware. Lo sviluppatore di un modello e chi acquista infrastruttura hanno inoltre domande diverse. Il primo chiede se il carico può essere espresso in modo efficiente; il secondo se l’implementazione supportata potrà rispettare un obiettivo di servizio per tutta la vita dell’installazione.
Per i lettori coreani, la partecipazione di SEMIFIVE è un esempio concreto di competenze locali nella progettazione di semiconduttori applicate all’infrastruttura di inferenza. La domanda successiva è come tali competenze diventeranno dispositivi di produzione e sistemi supportati. L’annuncio identifica partecipanti e direzione; i prodotti successivi determineranno le opzioni disponibili ai clienti.
Capacità e banda di memoria rispondono a domande diverse
La capacità indica quanti dati può contenere un sistema di memoria. La banda indica quanti ne può trasferire in un certo intervallo. Un modello può rispettare il primo limite mentre il secondo frena il lavoro del processore. Aggiungere solo capacità non garantisce un’applicazione più reattiva.
Un semplice calcolo di pianificazione rende visibile la prima distinzione. Un ipotetico modello denso con 30 miliardi di parametri, memorizzati a due byte ciascuno, richiede circa 60 miliardi di byte solo per i parametri. Il conto esclude aree di lavoro del runtime, dati di attenzione in cache e altri costi aggiuntivi. È un esempio di budget di archiviazione, non un’indicazione della capacità di L2000 o dei modelli supportati.
La domanda successiva riguarda l’uso di quanto viene conservato. Elaborare un prompt in ingresso e generare in sequenza i token di uscita impongono requisiti differenti. La spiegazione di NVIDIA sull’ottimizzazione dell’inferenza distingue il lavoro parallelo sul prompt dalla decodifica autoregressiva, dove il trasferimento della memoria può diventare un vincolo. Spiega anche perché il batching e la gestione della cache di attenzione cambiano l’equilibrio. Guida NVIDIA all’ottimizzazione dell’inferenza, 17 novembre 2023
Pensate alla memoria come a una dispensa collegata a una cucina. Una dispensa più grande permette di tenere più ingredienti sul posto; un passaggio più ampio facilita il loro arrivo in cucina. Nessuno dei due dice quanto durerà un pasto specifico, perché contano anche la preparazione e il resto del lavoro. Il confronto hardware è più utile quando questi ruoli restano distinti.
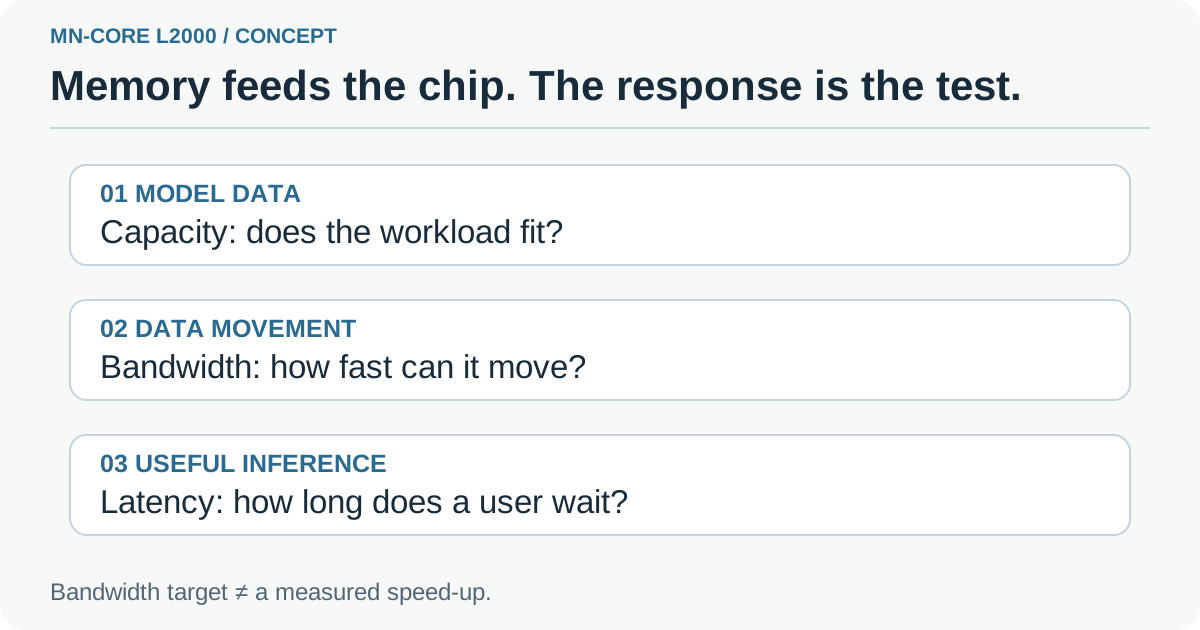
Diagramma esplicativo originale che separa archiviazione, trasferimento dei dati e risposta dell’applicazione. Illustra la decisione, senza rappresentare il layout di un package L2000 non pubblicato.
L’impilamento cambia sia il problema ingegneristico sia il percorso dei dati
L’annuncio ufficiale di PFN include un diagramma della logica e della DRAM impilate verticalmente nella serie MN-Core L. È utile per capire la direzione proposta. Non mostra il server completo che un cliente installerebbe né dimostra le prestazioni di un’applicazione finita.
Riunire componenti in una pila significa far funzionare il progetto come sistema fisico. Alimentazione elettrica, dissipazione del calore e uniformità produttiva vanno discusse insieme ai trasferimenti. Non sono dettagli da risolvere dopo che l’architettura appare convincente in una slide. Influenzano la possibilità di produrre, confezionare, raffreddare e supportare i dispositivi a un costo sensato.
Per un operatore, il progetto del package è quindi l’inizio dell’analisi, non la fine. Un rack ha un limite di potenza, una struttura ha un progetto di raffreddamento e il servizio ha un’aspettativa di disponibilità. L’acceleratore dovrà adattarsi a tutti e tre. Il vantaggio economico dipende dall’installazione completa, incluse attrezzature e manodopera necessarie a mantenerla attiva.
Ecco perché le affermazioni di efficienza devono mantenere le condizioni di misura. Un risultato favorevole per un modello, una precisione e una concorrenza specifici non descrive tutti i carichi. Il cliente deve vedere dove il sistema funziona bene, dove esaurisce il margine e quanta energia consuma l’intero servizio per fornire risposte utili.
Tre carichi porrebbero tre domande diverse
Consideriamo un assistente documentale privato per un gruppo legale o di ingegneria. In questo servizio esemplificativo le richieste arrivano irregolarmente e gli utenti notano il ritardo prima che inizi una risposta. La valutazione deve includere documenti rappresentativi, tempo di ricerca e prima risposta del modello. Un acceleratore può migliorare una parte mentre la ricerca documentale o un controllo di accesso resta il ritardo maggiore.
Un secondo esempio è un agente interno che richiama più volte un modello per completare un compito. Una generazione lenta può influire su varie fasi dipendenti. Il risultato utile è il tempo per completare un compito correttamente autorizzato, inclusi risultati degli strumenti ed eventuali approvazioni umane. Aumentare i token al secondo aiuta solo la parte che aspetta davvero la generazione.
Un terzo esempio è una coda notturna che classifica o riassume molti record. Può accettare batch più grandi e privilegiare il lavoro complessivo terminato entro una scadenza. Potrebbe preferire una configurazione diversa da quella di un assistente interattivo, pur usando lo stesso modello. La revisione d’acquisto deve preservare questa differenza invece di scegliere la dimostrazione dal numero più vistoso.
Sono piani di valutazione, non prove di L2000. Mostrano perché un’architettura centrata sulla memoria merita attenzione senza presupporre un unico risultato prestazionale. Il pilota migliore parte da un carico già compreso dal gruppo e da un risultato confrontabile con il sistema attuale.
| Decisione | Cosa dovrebbe fornire il gruppo | Cosa deve mostrare il risultato |
|---|---|---|
| Assistente documentale privato | Domande, documenti e regole di accesso rappresentativi | Risposte utili entro l’obiettivo concordato |
| Agente interno a più fasi | Compiti completi, chiamate agli strumenti e approvazioni | Il completamento dall’inizio alla fine migliora senza perdere correttezza |
| Coda di elaborazione notturna | Insieme fisso di record e termine di completamento | Il lavoro richiesto termina in modo affidabile entro il budget operativo |
Un obiettivo di banda è un elemento della stima del servizio
A nostro avviso, il confronto più utile parte dal lavoro acquistato. Un gruppo non compra banda isolatamente: compra la capacità di completare compiti rispettando vincoli. Servono quindi prove che colleghino modello e runtime al server e all’applicazione.
Iniziate dal supporto ai modelli. Architettura esatta, precisione e operatori necessari devono funzionare nello stack software supportato. Un compilatore o runtime capace di eseguire una demo potrebbe lasciare lavoro d’integrazione per la produzione. Chiedete quali versioni sono supportate, quali operazioni richiedono conversione e chi mantiene quel percorso quando cambia il modello.
Separate poi le misure di risposta. Tempo fino alla prima risposta utile, velocità durante la generazione e richieste totali completate descrivono esperienze diverse. Registratele con le stesse dimensioni di ingresso e la stessa concorrenza, includendo errori e risposte incomplete. Un’esecuzione più veloce che altera la qualità o perde richieste senza segnalarlo è un risultato diverso da un miglioramento del servizio.
Infine, rimettete l’applicazione attorno al modello. Ricerca, moderazione, accesso agli strumenti, code e traffico di rete richiedono tempo. Un pilota hardware deve mostrare quanta parte del compito attende l’inferenza. Il gruppo può così stimare ragionevolmente il beneficio reale di un percorso d’inferenza più veloce.
Il prossimo traguardo visibile è la consegna del progetto alla produzione
L’obiettivo annunciato per il tape-out è il primo trimestre del 2027: il punto in cui i dati finali del progetto passano alla fabbricazione. È una tappa di sviluppo, non la data di consegna di un server completo. Piano di sviluppo di PFN
Fabbricazione, packaging, avvio iniziale e validazione devono ancora collegare il progetto a un prodotto utilizzabile. La qualificazione software e l’integrazione del sistema determinano poi cosa i clienti potranno installare. Il progresso di queste fasi può generare notizie importanti prima della vendita generale, ma ognuna risponde a una domanda diversa.
La stessa disciplina vale per il riferimento di confronto. Anche L1000 è previsto per il 2027: l’annuncio confronta quindi generazioni in sviluppo, non due sistemi acquistabili oggi. Non pubblica un prezzo al dettaglio di L2000, un calendario di consegna in Corea o benchmark di un sistema finito. La pianificazione d’acquisto deve basarsi sulla configurazione supportata e sulle condizioni che il fornitore offrirà in futuro.
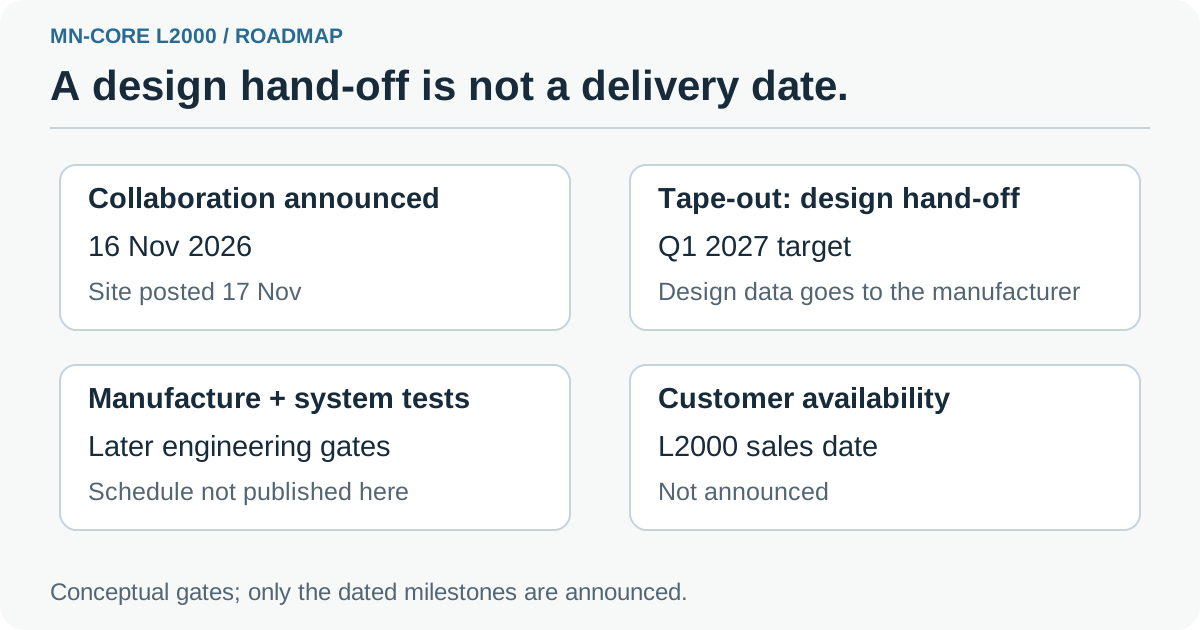
Guida originale alle fasi di sviluppo. L’obiettivo di tape-out annunciato è distinto dalle successive fabbricazione, qualificazione e consegna al cliente; quelle date restano aperte.
Cosa deve contenere un dossier di valutazione pratico
Un gruppo può lavorare utilmente mentre segue il piano. Dovrebbe creare un riferimento compatto che resti valido anche se l’acquisto finale sarà un sistema MN-Core, un server GPU o un servizio ospitato. Lo scopo è rendere i confronti futuri più economici e significativi.
- Scegliete il lavoro completo. Definite un compito interattivo e, se pertinente, un’elaborazione batch. Registrate cosa costituisce un completamento corretto e il termine di risposta o conclusione.
- Fissate materiale di prova e versioni software. Conservate insieme prompt, documenti, revisione del modello, precisione e impostazioni del runtime. Usate materiale che siete autorizzati a elaborare.
- Misurate il percorso attuale. Registrate risposta del modello, tempo complessivo, errori e uso delle risorse con il carico previsto. Annotate quando il servizio aspetta ricerca o strumenti anziché generazione.
- Chiedete una configurazione supportata equivalente. Una futura prova del fornitore deve identificare acceleratore, memoria, host, runtime e modelli supportati. Tenete visibili i cambiamenti di qualità o precisione.
- Confrontate la decisione operativa. Includete acquisto, integrazione software, elettricità, raffreddamento, supporto e ripristino. Valutate se il miglioramento risolve il compito iniziale a un costo accettabile.
Questo dossier è più utile di una raccolta di schermate di throughput scollegate. Impedisce al gruppo di cambiare carico a ogni nuovo sistema. Rende anche più facile riconoscere un guadagno autentico: lo stesso lavoro, completato bene, con meno ritardo o minor impegno operativo.
Per un piccolo gruppo, la scelta immediata potrebbe essere continuare con l’hardware attuale migliorando l’applicazione. Se la ricerca domina il tempo di risposta, accelerare solo l’inferenza avrà un effetto limitato. Se il servizio attende costantemente la generazione sotto il carico necessario, un nuovo acceleratore diventa un candidato di prova più pertinente. Entrambi i risultati aiutano a dirigere la spesa sul collo di bottiglia che incide sugli utenti.
Il racconto dell’hardware si avvicina alla memoria
La collaborazione L2000 merita attenzione perché collega un problema di inferenza al progetto fisico e alla produzione necessari per risolverlo. Le prossime prove utili saranno i progressi nella fabbricazione e nella qualificazione software, seguiti da misure su sistemi supportati. Mostreranno quali carichi ne beneficiano e cosa deve investire un operatore per ottenere quel beneficio.
La lezione pratica è già disponibile. Nel confronto tra hardware per l’IA, tenete distinti capacità del modello, trasferimento dei dati e risultati applicativi. Far entrare un modello in memoria apre la discussione; il risultato richiesto dal compratore è un servizio affidabile.
Fonti
- Preferred Networks, PFN e SEMIFIVE collaborano allo sviluppo della serie MN-Core L2000, comunicato datato 16 novembre 2026 e pubblicato sul sito il 17 novembre 2026. Include il diagramma ufficiale e il calendario di sviluppo.
- Preferred Networks, annuncio in giapponese, il corrispondente comunicato aziendale.
- Shashank Verma e Neal Vaidya, NVIDIA Technical Blog, Mastering LLM Techniques: Inference Optimization, 17 novembre 2023. Informazioni su fasi di inferenza, batching e memoria, non un benchmark dell’hardware MN-Core.
Conservate insieme carico, impostazioni del modello e risposte dei fornitori, così la prossima valutazione partirà da una base confrontabile. Create la vostra prima nota con Telli.sh.