Pourquoi PFN veut empiler la mémoire sur sa prochaine puce d’IA
Avec le MN-Core L2000, PFN et SEMIFIVE ciblent un goulot d’étranglement de l’inférence : la mémoire. Ce que leur feuille de route implique pour les agents, l’IA privée et les futurs achats de matériel.
Un assistant d’IA peut disposer d’assez de mémoire pour charger un modèle et donner malgré tout l’impression que chaque réponse traîne. Les unités de calcul sont prêtes, mais un calcul utile exige de leur apporter les bonnes données au bon moment. Pour une entreprise qui exploite plusieurs assistants privés, cette différence peut transformer une fiche technique impressionnante en attente inconfortable entre les mots.
Preferred Networks et SEMIFIVE misent sur le développement pour résoudre ce problème. Leur annonce du 16 novembre 2026 décrit la série MN-Core L2000, un processeur destiné à l’inférence qui empile verticalement logique et DRAM. L’objectif annoncé est de plus que doubler la bande passante mémoire de la série L1000 précédente. PFN a publié le communiqué sur son site le 17 novembre. Annonce de PFN
La question intéressante est ce que cette conception pourrait changer pour les futurs exploitants de services d’IA. Accélérer le déplacement des données peut compter autant qu’ajouter de la puissance de calcul. Le boîtier, la prise en charge logicielle et le serveur final déterminent toutefois si le bénéfice arrive jusqu’à l’écran de l’utilisateur. L’annonce du L2000 permet de réfléchir à ces choix avant de devoir acheter.
L’entreprise derrière PLaMo conçoit aussi les machines qui le font fonctionner
Preferred Networks est une entreprise d’IA établie à Tokyo, dont les activités couvrent les processeurs, les infrastructures de calcul et la famille de modèles PLaMo. Dans cette collaboration, PFN est responsable de l’architecture du processeur et de la conception logique ; SEMIFIVE assure l’implémentation et les services de chaîne d’approvisionnement, avec la plateforme de Samsung Foundry et son infrastructure de conception 3D-IC. Présentation de PFN et rôles de développement
Cette répartition compte, car un accélérateur utile dépasse le jeu d’instructions ou le dessin d’une puce. La logique doit devenir du silicium fabricable, la mémoire doit y être raccordée et les composants encapsulés doivent fonctionner de manière régulière. Le client a finalement besoin d’une configuration serveur reproductible et d’une voie logicielle reliant le modèle à l’application. Chaque passage de relais peut peser sur le coût et le calendrier de livraison du produit fini.
Le lien avec PLaMo constitue un point d’entrée familier, sans établir que tous ses déploiements passeront sur ce matériel. Le développeur d’un modèle et l’acheteur d’infrastructure ne se posent pas non plus les mêmes questions. Le premier veut savoir si la charge peut être exprimée efficacement ; le second, si l’implémentation prise en charge pourra respecter un objectif de service pendant la durée de vie de l’installation.
Pour les lecteurs coréens, la participation de SEMIFIVE illustre concrètement l’apport d’une expertise locale de conception de semi-conducteurs à l’infrastructure d’inférence. La prochaine question utile est la traduction de cette expertise en composants de série et en systèmes pris en charge. L’annonce identifie les acteurs et la direction ; les produits qui suivront détermineront les choix accessibles aux clients.
Capacité mémoire et bande passante répondent à deux questions différentes
La capacité indique la quantité de données qu’un système mémoire peut conserver. La bande passante indique celle qu’il peut déplacer pendant un intervalle donné. Un modèle peut respecter la première limite alors que la seconde freine le processeur. Ajouter de la capacité ne garantit donc pas une application plus réactive.
Un calcul de planification simple permet de visualiser la première distinction. Un modèle dense hypothétique de 30 milliards de paramètres, conservés à deux octets chacun, nécessite environ 60 milliards d’octets rien que pour ces paramètres. Ce calcul exclut les espaces de travail du moteur, les données d’attention en cache et les autres surcoûts. Il illustre un budget de stockage, sans décrire la capacité du L2000 ni les modèles qu’il prendra en charge.
Il faut ensuite examiner l’usage des données stockées. Traiter un prompt entrant et produire des tokens successifs sollicitent le système différemment. L’explication de NVIDIA sur l’optimisation de l’inférence distingue le traitement parallèle du prompt du décodage autorégressif, où les transferts mémoire peuvent devenir contraignants. Elle explique également pourquoi le regroupement en lots et la gestion du cache d’attention modifient cet équilibre. Guide NVIDIA sur l’optimisation de l’inférence, 17 novembre 2023
Imaginez la mémoire comme un garde-manger relié à une cuisine. Un plus grand garde-manger permet de garder davantage d’ingrédients sur place ; un passage plus large facilite leur acheminement. Aucun des deux ne donne le temps de préparation d’un repas précis, car les autres étapes comptent aussi. Comparer le matériel devient plus utile lorsque ces rôles restent distincts.
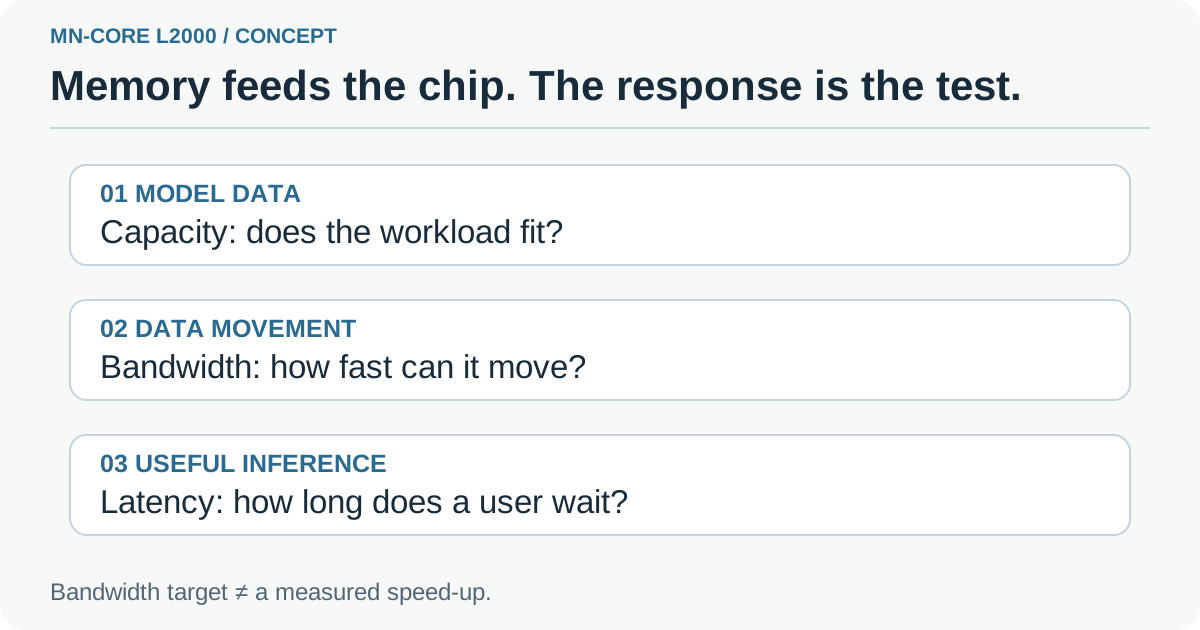
Schéma explicatif original distinguant stockage, déplacement des données et réponse applicative. Il illustre les critères de décision et non l’agencement d’un boîtier L2000 non publié.
L’empilement change autant le problème d’ingénierie que le trajet des données
L’annonce officielle de PFN comprend un schéma de l’empilement vertical de la logique et de la DRAM dans la série MN-Core L. Il aide à comprendre la direction proposée. Il ne représente pas le serveur complet qu’un client installerait et n’établit pas les performances d’une application achevée.
Réunir des composants dans une pile exige que la conception fonctionne comme un système physique. Alimentation électrique, évacuation de chaleur et régularité de fabrication doivent être abordées avec les transferts de données. Ce ne sont pas des détails à régler une fois l’architecture séduisante sur une diapositive. Ils déterminent si les composants peuvent être fabriqués, encapsulés, refroidis et pris en charge à un coût pertinent.
Pour un exploitant, le boîtier marque donc le début de l’examen et non sa fin. Une baie possède une enveloppe électrique, un bâtiment un dispositif de refroidissement, et le service une exigence de disponibilité. Le nouvel accélérateur devra s’intégrer aux trois. Le gain économique dépend de l’installation complète, équipements et travail nécessaires à son fonctionnement compris.
C’est aussi pourquoi un discours sur l’efficacité doit conserver ses conditions de mesure. Un résultat favorable pour un modèle, une précision et un niveau de concurrence donnés ne décrit pas toutes les charges. Le client doit savoir où le système fonctionne bien, où il épuise sa marge et combien d’énergie le service complet consomme pour fournir des réponses utiles.
Trois charges conduisent à trois questions différentes
Prenons un assistant documentaire privé destiné à une équipe juridique ou d’ingénierie. Dans ce service illustratif, les demandes arrivent irrégulièrement et les utilisateurs remarquent le délai avant le début d’une réponse. Son évaluation doit inclure des documents représentatifs, le temps de recherche et la première réponse du modèle. Un accélérateur peut améliorer une partie du trajet alors qu’une recherche documentaire ou un contrôle d’accès reste la principale source de retard.
Un deuxième exemple est l’agent interne qui appelle plusieurs fois un modèle pour terminer une tâche. Une génération lente peut alors affecter plusieurs étapes dépendantes. Le résultat utile est le temps nécessaire pour terminer une tâche correctement autorisée, résultats des outils et éventuelle approbation humaine compris. Augmenter le débit de tokens n’aide que la partie qui attend réellement la génération.
Le troisième exemple est une file nocturne qui classe ou résume de nombreux dossiers. Elle peut accepter des lots plus importants et privilégier la quantité de travail achevée avant une échéance. Elle peut donc préférer une autre configuration qu’un assistant interactif, même avec le même modèle. Un examen d’achat doit préserver cette distinction plutôt que choisir la démonstration affichant le plus gros chiffre.
Ces scénarios sont des plans d’évaluation, pas des essais du L2000. Ils montrent pourquoi une architecture centrée sur la mémoire mérite d’être suivie sans lui attribuer un résultat unique. Le meilleur pilote commence par une charge que l’équipe comprend déjà et un résultat comparable à celui du système actuel.
| Décision | Ce que l’équipe doit apporter | Ce que le résultat doit montrer |
|---|---|---|
| Assistant documentaire privé | Questions, documents et règles d’accès représentatifs | Des réponses utiles arrivent dans le délai convenu |
| Agent interne à plusieurs étapes | Tâches complètes, appels d’outils et points d’approbation | Le délai de bout en bout s’améliore sans perte d’exactitude |
| File de traitement nocturne | Ensemble fixe de dossiers et échéance | Le travail requis se termine de façon fiable dans le budget d’exploitation |
Un objectif de bande passante n’est qu’un élément de l’estimation du service
À notre avis, la comparaison la plus utile commence par le travail acheté. Une équipe n’achète pas de bande passante isolément ; elle achète la capacité de terminer des tâches sous contraintes. Cela exige une chaîne de preuves reliant modèle et moteur d’exécution au serveur et à l’application.
Commencez par les modèles pris en charge. L’architecture exacte, la précision et les opérateurs requis doivent fonctionner dans la pile logicielle supportée. Un compilateur ou un moteur capable d’exécuter une démonstration peut laisser des travaux d’intégration pour la production. Demandez quelles versions sont prises en charge, quelles opérations nécessitent une conversion et qui entretient cette voie lorsque le modèle évolue.
Séparez ensuite les mesures de réponse. Le délai jusqu’à la première réponse utile, la vitesse de génération et le total de requêtes terminées décrivent des expériences différentes. Relevez-les avec les mêmes tailles d’entrée et niveaux de concurrence, échecs et réponses incomplètes compris. Une exécution plus rapide qui modifie la qualité ou abandonne discrètement des requêtes n’est pas la même chose qu’une amélioration de service.
Enfin, replacez l’application autour du modèle. Recherche, modération, accès aux outils, files et trafic réseau prennent aussi du temps. Un pilote matériel doit montrer quelle part de la tâche attend l’inférence. L’équipe peut alors estimer raisonnablement le bénéfice réel d’un chemin d’inférence accéléré.
La prochaine étape visible est le passage du design à la fabrication
L’objectif annoncé de tape-out est le premier trimestre 2027 : le moment où les données finales de conception sont remises à la fabrication. C’est une étape de développement, pas une date de livraison d’un serveur terminé. Feuille de route de PFN
Fabrication, encapsulation, mise en route et validation doivent encore relier le design à un produit utilisable. La qualification logicielle et l’intégration système déterminent ensuite ce que les clients pourront déployer. Ces étapes peuvent produire des nouvelles importantes avant une commercialisation générale, mais chacune répond à une question différente.
La même discipline s’applique à la référence de comparaison. Le L1000 est lui-même prévu pour 2027 : l’annonce compare donc des générations en développement, pas deux systèmes disponibles aujourd’hui. Elle ne publie ni prix de détail du L2000, ni calendrier de livraison en Corée, ni benchmark d’un système final. Un calendrier d’achat doit reposer sur la configuration supportée et les conditions de livraison que le fournisseur proposera finalement.
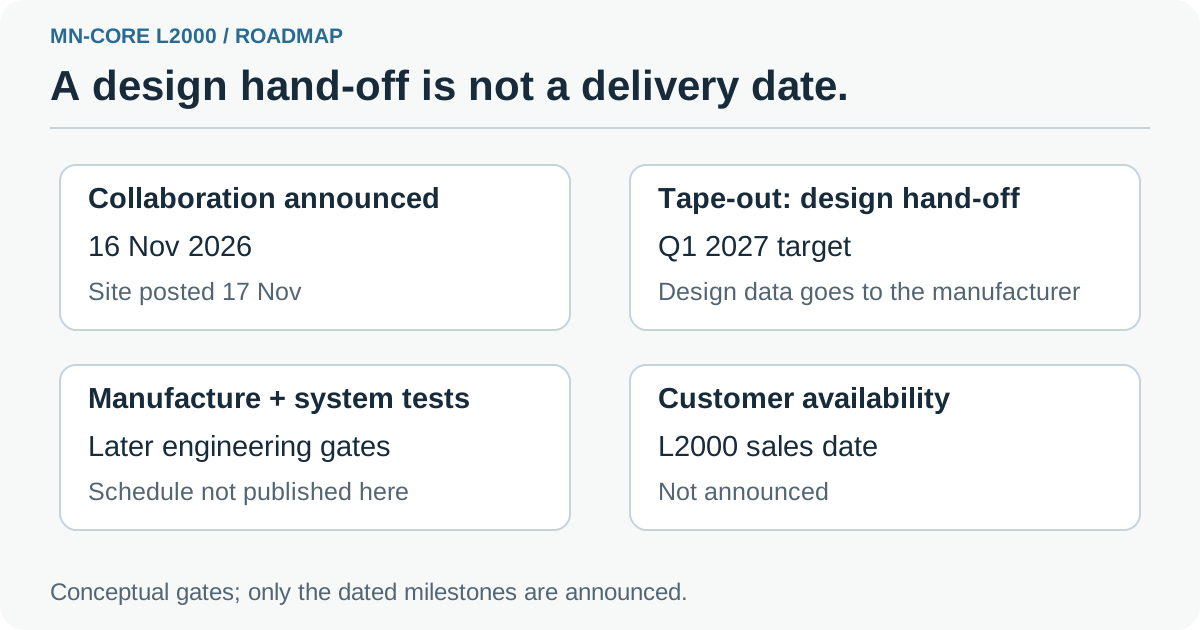
Guide original des étapes de développement. L’objectif de tape-out annoncé est distingué de la fabrication, de la qualification et de la livraison client ultérieures, dont les dates restent ouvertes.
Que doit contenir un dossier d’évaluation pratique ?
Une équipe peut avancer utilement tout en suivant la feuille de route. Elle devrait constituer une référence concise qui reste valable si l’achat final porte sur un système MN-Core, un serveur GPU ou un service hébergé. Le but est de rendre les comparaisons futures moins coûteuses et plus pertinentes.
- Choisissez le travail complet. Définissez une tâche interactive et, si nécessaire, un traitement par lots. Notez ce qui constitue une réalisation correcte et l’échéance de réponse ou d’achèvement.
- Fixez les données d’essai et les versions logicielles. Conservez ensemble prompts, documents, révision du modèle, précision et réglages du moteur. Utilisez des données que l’équipe est autorisée à traiter.
- Mesurez le trajet actuel. Relevez le temps de réponse du modèle, la durée totale, les échecs et la consommation de ressources sous la charge attendue. Distinguez l’attente de la recherche ou des outils de celle de la génération.
- Demandez une configuration supportée correspondante. Un futur essai fournisseur devra identifier accélérateur, mémoire, hôte, moteur et prise en charge des modèles. Rendez visibles les changements de qualité ou de précision.
- Comparez la décision d’exploitation. Incluez acquisition, intégration logicielle, électricité, refroidissement, support et reprise après incident. Vérifiez si l’amélioration résout la tâche initiale à un coût acceptable.
Ce dossier vaut mieux qu’une collection de captures de débits sans rapport entre elles. Il empêche de modifier la charge à chaque nouveau système. Il aide aussi à repérer un gain réel : le même travail, bien réalisé, avec moins d’attente ou de contraintes opérationnelles.
Pour une petite équipe, la décision immédiate peut être de conserver le matériel actuel et d’améliorer l’application. Si la recherche domine le temps de réponse, accélérer seulement l’inférence aura un effet limité. Si le service attend constamment la génération sous la charge requise, un nouvel accélérateur devient un candidat plus pertinent à tester. Dans les deux cas, le constat aide à orienter le budget vers le goulot qui touche les utilisateurs.
L’histoire du matériel se rapproche de la mémoire
La collaboration L2000 mérite d’être suivie parce qu’elle relie un problème d’inférence aux travaux de conception physique et de production nécessaires pour le résoudre. Les prochaines preuves utiles seront les progrès de fabrication et de qualification logicielle, puis des mesures sur des systèmes supportés. Elles montreront quelles charges bénéficient du changement et ce qu’un exploitant doit investir pour en profiter.
La leçon pratique est déjà disponible. Distinguez capacité du modèle, déplacement des données et résultats applicatifs lorsque vous comparez du matériel d’IA. Faire tenir un modèle en mémoire ouvre la discussion ; le résultat dont l’acheteur a besoin est un service fiable.
Sources
- Preferred Networks, PFN et SEMIFIVE collaborent au développement de la série MN-Core L2000, communiqué daté du 16 novembre 2026, publié sur le site le 17 novembre 2026. Comprend le schéma officiel et le calendrier de développement.
- Preferred Networks, annonce en japonais, communiqué correspondant de l’entreprise.
- Shashank Verma et Neal Vaidya, NVIDIA Technical Blog, Mastering LLM Techniques: Inference Optimization, 17 novembre 2023. Explications sur les phases d’inférence, les lots et la mémoire, pas un benchmark du matériel MN-Core.
Conservez ensemble la charge, les réglages du modèle et les réponses des fournisseurs pour démarrer la prochaine évaluation sur une base comparable. Créez votre première note avec Telli.sh.