Por qué PFN quiere apilar memoria sobre su próximo chip de IA
La colaboración de PFN y SEMIFIVE en MN-Core L2000 aborda un cuello de botella de la inferencia: la memoria. Qué implica su calendario para los agentes, la IA privada y futuras compras de hardware.
Un asistente de IA puede tener memoria suficiente para cargar un modelo y aun así responder con lentitud. Las unidades aritméticas están listas, pero para realizar cálculos útiles necesitan recibir los datos adecuados en el momento oportuno. En una empresa que ofrece varios asistentes privados, esa diferencia puede convertir una especificación impresionante en una espera incómoda entre palabras.
Preferred Networks y SEMIFIVE han apostado por desarrollar una solución a ese problema. Su anuncio del 16 de noviembre de 2026 describe la serie MN-Core L2000: un procesador orientado a inferencia que apila lógica y DRAM verticalmente. El objetivo declarado es superar el doble del ancho de banda de memoria de la serie L1000 anterior. PFN publicó el anuncio en su web el 17 de noviembre. Anuncio de PFN
Lo interesante es qué podría cambiar ese diseño para quienes acaben operando servicios de IA. Mover los datos más rápido puede importar tanto como añadir capacidad aritmética, mientras que el encapsulado, el soporte de software y el servidor terminado determinan si la ventaja llega a la pantalla del usuario. El anuncio de L2000 ofrece una forma útil de pensar en esas decisiones antes de tener que comprar.
La empresa que desarrolla PLaMo también diseña las máquinas que lo sustentan
Preferred Networks es una empresa de IA de Tokio cuyo trabajo abarca procesadores, infraestructura de cómputo y la familia de modelos PLaMo. En esta colaboración, PFN se encarga de la arquitectura del procesador y el diseño lógico; SEMIFIVE aporta servicios de implementación y cadena de suministro mediante la plataforma de Samsung Foundry y su infraestructura de diseño 3D-IC. PFN y las funciones de desarrollo
Ese reparto importa porque un acelerador útil es mucho más que un juego de instrucciones o un dibujo de un chip. El diseño lógico debe convertirse en silicio fabricable, la memoria debe conectarse a él y los dispositivos encapsulados deben funcionar de manera consistente. El cliente necesita finalmente una configuración de servidor reproducible y una vía de software que convierta el modelo en una aplicación. Cada traspaso puede afectar al coste y al plazo de entrega del producto.
La relación con PLaMo ofrece una referencia conocida, pero no demuestra que todos sus despliegues vayan a trasladarse a este hardware. Un desarrollador de modelos y un comprador de infraestructura también plantean preguntas distintas. El primero pregunta si la carga puede expresarse de forma eficiente; el segundo, si la implementación compatible cumplirá el objetivo del servicio durante la vida de la instalación.
Para los lectores coreanos, la participación de SEMIFIVE es un ejemplo concreto de experiencia local en diseño de semiconductores aplicada a la infraestructura de inferencia. La siguiente pregunta útil es cómo se traduce esa experiencia en dispositivos de producción y sistemas con soporte. El anuncio identifica a los participantes y la dirección; los productos posteriores determinarán las opciones del cliente.
La capacidad y el ancho de banda de memoria responden a preguntas diferentes
La capacidad indica cuántos datos puede almacenar un sistema de memoria. El ancho de banda indica cuántos puede mover en un intervalo determinado. Un modelo puede caber dentro del primer límite mientras el segundo restringe la velocidad del procesador. Añadir capacidad por sí solo no garantiza una aplicación más ágil.
Un cálculo sencillo de planificación permite visualizar la primera distinción. Un modelo denso hipotético con 30.000 millones de parámetros almacenados a dos bytes cada uno necesita unos 60.000 millones de bytes solo para los parámetros. No incluye espacios de trabajo de ejecución, datos de atención en caché ni otros gastos adicionales. Ilustra un presupuesto de almacenamiento, no la capacidad de L2000 ni sus modelos compatibles.
Después hay que preguntar cómo utiliza la carga lo que almacena. Procesar un prompt entrante y generar sucesivamente los tokens de salida exigen cosas distintas al sistema. La explicación de NVIDIA sobre optimización de inferencia diferencia el procesamiento paralelo del prompt de la decodificación autorregresiva, donde el movimiento de memoria puede convertirse en una restricción. También explica cómo el procesamiento por lotes y la gestión de la caché de atención cambian el equilibrio. Guía de optimización de inferencia de NVIDIA, 17 de noviembre de 2023
Piense en la memoria como una despensa conectada a una cocina. Una despensa mayor permite guardar más ingredientes; un paso más ancho facilita llevarlos a la cocina. Ninguna de las dos cosas determina cuánto tardará una comida concreta, porque la preparación y el resto del proceso siguen importando. Las comparaciones de hardware resultan más útiles cuando estas funciones permanecen separadas.
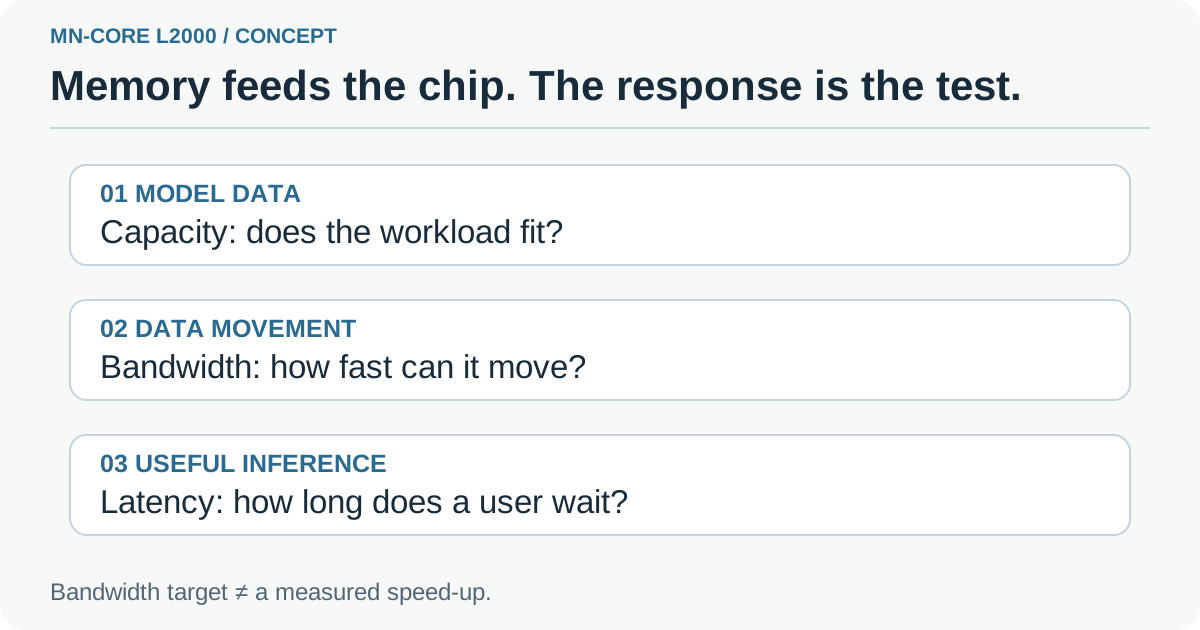
Diagrama explicativo original que separa almacenamiento, movimiento de datos y respuesta de la aplicación. Ilustra la decisión, no la disposición de un encapsulado L2000 sin publicar.
El apilado cambia tanto el problema de ingeniería como la ruta de datos
El anuncio oficial de PFN incluye un diagrama de la lógica y la DRAM apiladas verticalmente en la serie MN-Core L. Es una forma útil de entender la dirección propuesta. No muestra el servidor completo que instalaría un cliente ni demuestra el rendimiento de una aplicación terminada.
Apilar componentes exige que el diseño funcione como sistema físico. La alimentación eléctrica, la evacuación del calor y la consistencia de fabricación deben tratarse junto con el movimiento de datos. No son cuestiones secundarias que resolver después de que la arquitectura quede bien en una diapositiva. Influyen en la posibilidad de producir, encapsular, refrigerar y mantener los dispositivos a un coste razonable.
Para un operador, el diseño del encapsulado es el comienzo del análisis, no su final. Un rack tiene un margen eléctrico, una instalación un diseño de refrigeración y el servicio una expectativa de disponibilidad. El acelerador tendrá que encajar en los tres. El beneficio económico depende de la instalación completa, incluidos los equipos y el trabajo necesarios para mantenerla operativa.
Por eso una explicación de eficiencia debe ir acompañada de sus condiciones de medición. Un resultado favorable para un modelo, precisión y concurrencia concretos no describe todas las cargas. El cliente necesita saber dónde funciona bien el sistema, dónde agota su margen y cuánta energía consume el servicio completo para proporcionar respuestas útiles.
Tres cargas plantearían tres preguntas distintas
Piense en un asistente documental privado para un equipo jurídico o de ingeniería. En este servicio ilustrativo, las peticiones llegan de forma irregular y los usuarios perciben la demora antes de que empiece una respuesta. Su evaluación debe incluir documentos representativos, tiempo de búsqueda y primera respuesta del modelo. Un acelerador puede mejorar una parte mientras la búsqueda documental o una comprobación de acceso sigue causando la mayor demora.
Un segundo ejemplo es un agente interno que llama repetidamente al modelo para completar una tarea. Una generación lenta puede afectar a varios pasos dependientes. El resultado útil es el tiempo necesario para terminar una tarea correctamente autorizada, incluidos los resultados de herramientas y las aprobaciones humanas. Aumentar los tokens por segundo solo mejora la parte que espera realmente a la generación.
Un tercer ejemplo es una cola nocturna que clasifica o resume muchos registros. Puede admitir lotes mayores y valorar más el trabajo total completado antes de una fecha límite. Podría preferir una configuración diferente de la de un asistente interactivo, aunque ambos usen el mismo modelo. La evaluación de compra debe preservar esa distinción, no elegir la demostración con la cifra más llamativa.
Estos escenarios son planes de evaluación, no pruebas de L2000. Muestran por qué merece la pena seguir una arquitectura centrada en memoria sin dar por hecho un único resultado de rendimiento. El mejor piloto empieza con una carga que el equipo ya comprende y un resultado comparable con su sistema actual.
| Decisión | Qué debe aportar el equipo | Qué debe demostrar el resultado |
|---|---|---|
| Asistente documental privado | Preguntas, documentos y reglas de acceso representativos | Llegan respuestas útiles dentro del objetivo acordado |
| Agente interno de varios pasos | Tareas completas, llamadas a herramientas y aprobaciones | Mejora el tiempo de principio a fin sin perder corrección |
| Cola nocturna de procesamiento | Un conjunto fijo de registros y una fecha límite | El trabajo requerido termina con fiabilidad dentro del presupuesto operativo |
Un objetivo de ancho de banda es un dato para estimar el servicio
Creemos que la comparación más útil empieza por el trabajo que se compra. Un equipo no adquiere ancho de banda de forma aislada: compra la capacidad de completar tareas bajo restricciones. Eso exige una cadena de pruebas que conecte el modelo y su entorno de ejecución con el servidor y la aplicación.
Empiece por los modelos compatibles. La arquitectura exacta, la precisión y los operadores necesarios deben funcionar en la pila de software con soporte. Un compilador o motor que ejecute una demostración todavía puede requerir integración para producción. Pregunte qué versiones se admiten, qué operaciones necesitan conversión y quién mantiene esa vía cuando cambia el modelo.
Después separe las medidas de respuesta. El tiempo hasta la primera respuesta útil, la velocidad durante la generación y el total de solicitudes terminadas describen experiencias distintas. Regístrelas con los mismos tamaños de entrada y concurrencia, incluyendo fallos y respuestas incompletas. Una ejecución más rápida que cambie la calidad o descarte peticiones silenciosamente no equivale a una mejora del servicio.
Por último, vuelva a situar la aplicación alrededor del modelo. La búsqueda, moderación, acceso a herramientas, colas y tráfico de red también consumen tiempo. El piloto de hardware debe mostrar qué parte de la tarea espera a la inferencia. Así se puede estimar razonablemente el beneficio real de acelerar esa ruta.
El siguiente hito visible es entregar el diseño a fabricación
El objetivo anunciado de tape-out es el primer trimestre de 2027: el momento de entregar los datos finales del diseño para fabricarlo. Es un hito de desarrollo, no una fecha de entrega de un servidor terminado. Calendario de desarrollo de PFN
La fabricación, el encapsulado, la puesta en marcha y la validación todavía deben conectar el diseño con un producto utilizable. La cualificación del software y la integración del sistema determinan después qué pueden desplegar los clientes. Avanzar por estas fases puede generar noticias importantes antes de la venta general, pero cada fase responde a una pregunta distinta.
Lo mismo se aplica a la base de comparación. L1000 también está previsto para 2027, de modo que el anuncio compara generaciones en desarrollo, no dos sistemas disponibles hoy. No publica un precio minorista de L2000, un calendario de entrega en Corea ni un benchmark del sistema terminado. La planificación de compra debe basarse en la futura configuración con soporte y las condiciones de entrega del proveedor.
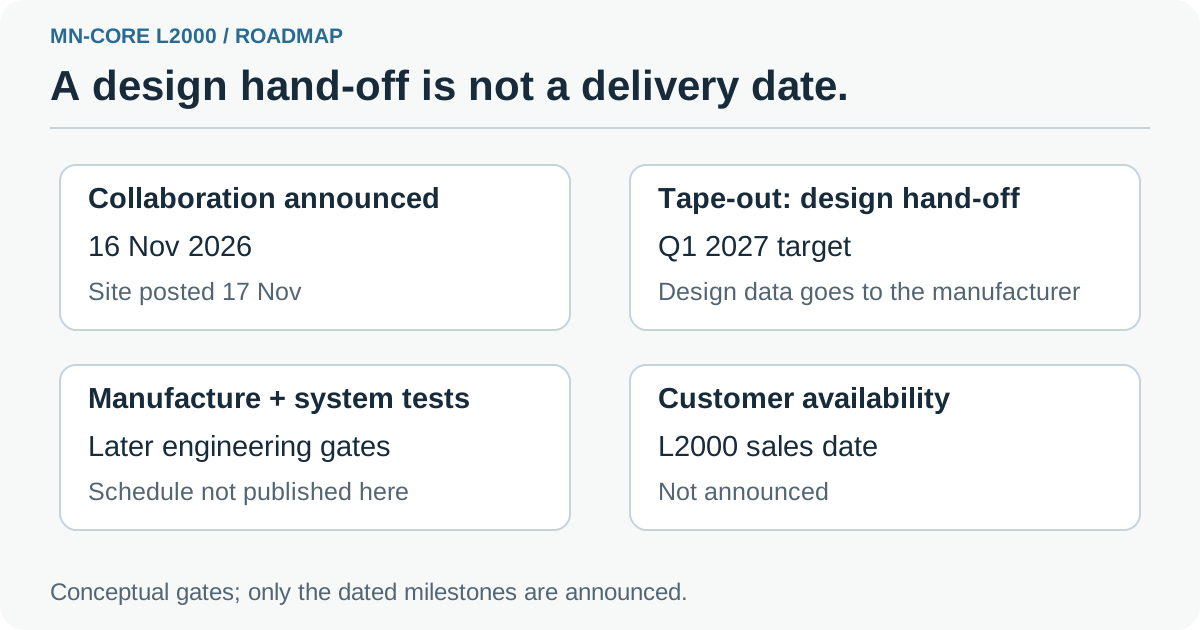
Guía original de las etapas de desarrollo. El objetivo de tape-out anunciado aparece separado de la fabricación, cualificación y entrega posteriores; esas fechas siguen abiertas.
Qué debe contener un expediente de evaluación práctico
Un equipo puede hacer trabajo útil mientras sigue el calendario. Debe crear una base compacta que siga sirviendo aunque la compra final sea un sistema MN-Core, un servidor GPU o un servicio alojado. El objetivo es abaratar las futuras comparaciones de hardware y hacerlas más significativas.
- Elija el trabajo completo. Defina una tarea interactiva y, si procede, una tarea por lotes. Registre qué cuenta como finalización correcta y el plazo de respuesta o terminación.
- Fije los datos de prueba y las versiones de software. Conserve juntos los prompts, documentos, revisión del modelo, precisión y ajustes de ejecución. Utilice material que el equipo esté autorizado a procesar.
- Mida la ruta actual. Registre el tiempo de respuesta del modelo, el tiempo total, los fallos y el consumo de recursos bajo la carga prevista. Anote cuándo se espera a búsquedas o herramientas en lugar de a la generación.
- Solicite una configuración compatible equivalente. Una futura prueba del proveedor debe identificar acelerador, memoria, host, entorno de ejecución y modelos admitidos. Mantenga visibles los cambios de calidad o precisión.
- Compare la decisión operativa. Incluya adquisición, integración de software, electricidad, refrigeración, soporte y recuperación. Juzgue si la mejora resuelve la tarea original a un coste aceptable.
Este expediente es más útil que una colección de capturas de rendimiento inconexas. Evita que el equipo cambie la carga cada vez que aparece un sistema nuevo. También facilita detectar una mejora real: el mismo trabajo, bien terminado, con menos demora o menor carga operativa.
Para un equipo pequeño, la decisión inmediata podría ser conservar el hardware actual mientras mejora la aplicación. Si la búsqueda domina el tiempo de respuesta, acelerar solo la inferencia tendrá un efecto limitado. Si el servicio espera de forma constante a la generación bajo la carga requerida, un acelerador nuevo será un candidato más pertinente para probar. Ambos hallazgos dirigen el gasto al cuello de botella que afecta al usuario.
La historia del hardware se acerca a la memoria
Merece la pena seguir la colaboración L2000 porque conecta un problema de inferencia con el diseño físico y la producción necesarios para abordarlo. Las siguientes pruebas útiles serán los avances de fabricación y cualificación de software, seguidos de mediciones en sistemas con soporte. Mostrarán qué cargas se benefician y qué debe invertir un operador para conseguirlo.
Por ahora ya existe una lección práctica. Distinga capacidad del modelo, movimiento de datos y resultados de la aplicación al comparar hardware de IA. Que un modelo quepa en memoria inicia la conversación; el comprador necesita como resultado un servicio fiable.
Fuentes
- Preferred Networks, PFN y SEMIFIVE colaboran para desarrollar la serie MN-Core L2000, comunicado fechado el 16 de noviembre de 2026 y publicado en la web el 17 de noviembre de 2026. Incluye el diagrama oficial y el calendario de desarrollo.
- Preferred Networks, anuncio en japonés, el comunicado correspondiente de la empresa.
- Shashank Verma y Neal Vaidya, NVIDIA Technical Blog, Mastering LLM Techniques: Inference Optimization, 17 de noviembre de 2023. Contexto sobre fases de inferencia, lotes y memoria, no un benchmark de hardware MN-Core.
Conserve juntos la carga, los ajustes del modelo y las respuestas del proveedor para comenzar la próxima evaluación desde una base comparable. Cree su primera nota con Telli.sh.