Um modelo anônimo queimou 26 trilhões de tokens em quatro dias. A tabela de preços veio depois: 24 centavos.
Em 20 de agosto de 2026, um modelo sem laboratório, sem ficha técnica e sem preço apareceu no OpenRouter como stealth/ox-alpha. Quatro dias depois, os usuários do OpenCode já tinham empurrado 26 trilhões de tokens por ele. Seis dias depois, a Z.AI assumiu a autoria: GLM-5.3-Flash, 320 bilhões de parâmetros, licença MIT, 0,15 dólar por milhão de tokens de entrada. Por que os laboratórios agora publicam modelos sem o próprio nome, o que aqueles números de tráfego realmente medem e o que um preço combinado de 24 centavos faz com a economia de pipelines de voz.
Em 20 de agosto de 2026, um modelo apareceu no OpenRouter com o slug stealth/ox-alpha. Nenhum laboratório associado. Sem ficha técnica, sem tabela de benchmarks, sem thread de anúncio. O campo de preço dizia 0 dólar na entrada, 0 dólar na saída. O que ele tinha era uma janela de contexto de 1.048.576 tokens, entrada de texto, imagem e vídeo, e uma descrição de uma linha sobre engenharia de software de longo prazo.
Quatro dias depois, o OpenCode informou que seus usuários tinham empurrado 26 trilhões de tokens por ele.
Seis dias depois, a Z.AI confirmou à Bloomberg que o modelo era dela, publicou os pesos sob licença MIT e anexou uma tabela de preços: quinze centavos por milhão de tokens de entrada, cinquenta centavos por milhão de saída. O nome era GLM-5.3-Flash. A palavra "Flash" está fazendo um trabalho enorme nessa frase, e é por isso que estamos escrevendo este texto.
Isto é um comentário, não uma cobertura de lançamento. O que vem a seguir é a linha do tempo dos seis dias com os números de tráfego e suas ressalvas, um argumento sobre por que os laboratórios cada vez mais publicam modelos sem o nome de ninguém, as especificações e as notas independentes agora que a identidade foi revelada, uma lista explícita das afirmações que não conseguimos verificar e um cálculo detalhado do que um preço combinado de 24 centavos faz com o custo de processar fala. É a sequência direta do nosso antes e depois sobre o retorno dos modelos locais, e aponta na mesma direção: o preço de uma inteligência de máquina competente continua caindo, mais rápido do que a maioria dos roadmaps de produto assume.
Resumo:
- O tráfego foi real e recorde. 26 trilhões de tokens no OpenCode em quatro dias, com 327.000 usuários únicos, e 11,6 trilhões no OpenRouter em três dias: o maior lançamento de modelo da história do OpenRouter, contra um recorde anterior de 4,4 trilhões.
- A identidade está confirmada por fonte primária. A Z.AI declarou à Bloomberg em 26 de agosto de 2026 que o Ox Alpha era um modelo da série GLM; a própria página do OpenRouter agora diz que o modelo furtivo "foi desenvolvido e operado pela ZAI, revelado como ZAI GLM-5.3-Flash".
- O preço é a notícia. 320 bilhões de parâmetros no total com 18 bilhões ativos, licença MIT, 0,15 dólar de entrada e 0,50 de saída por milhão de tokens: 0,24 dólar combinado, contra 10,00 dólares do carro-chefe fechado de seis meses atrás, que ele supera em 12,1 pontos no Intelligence Index da Artificial Analysis.
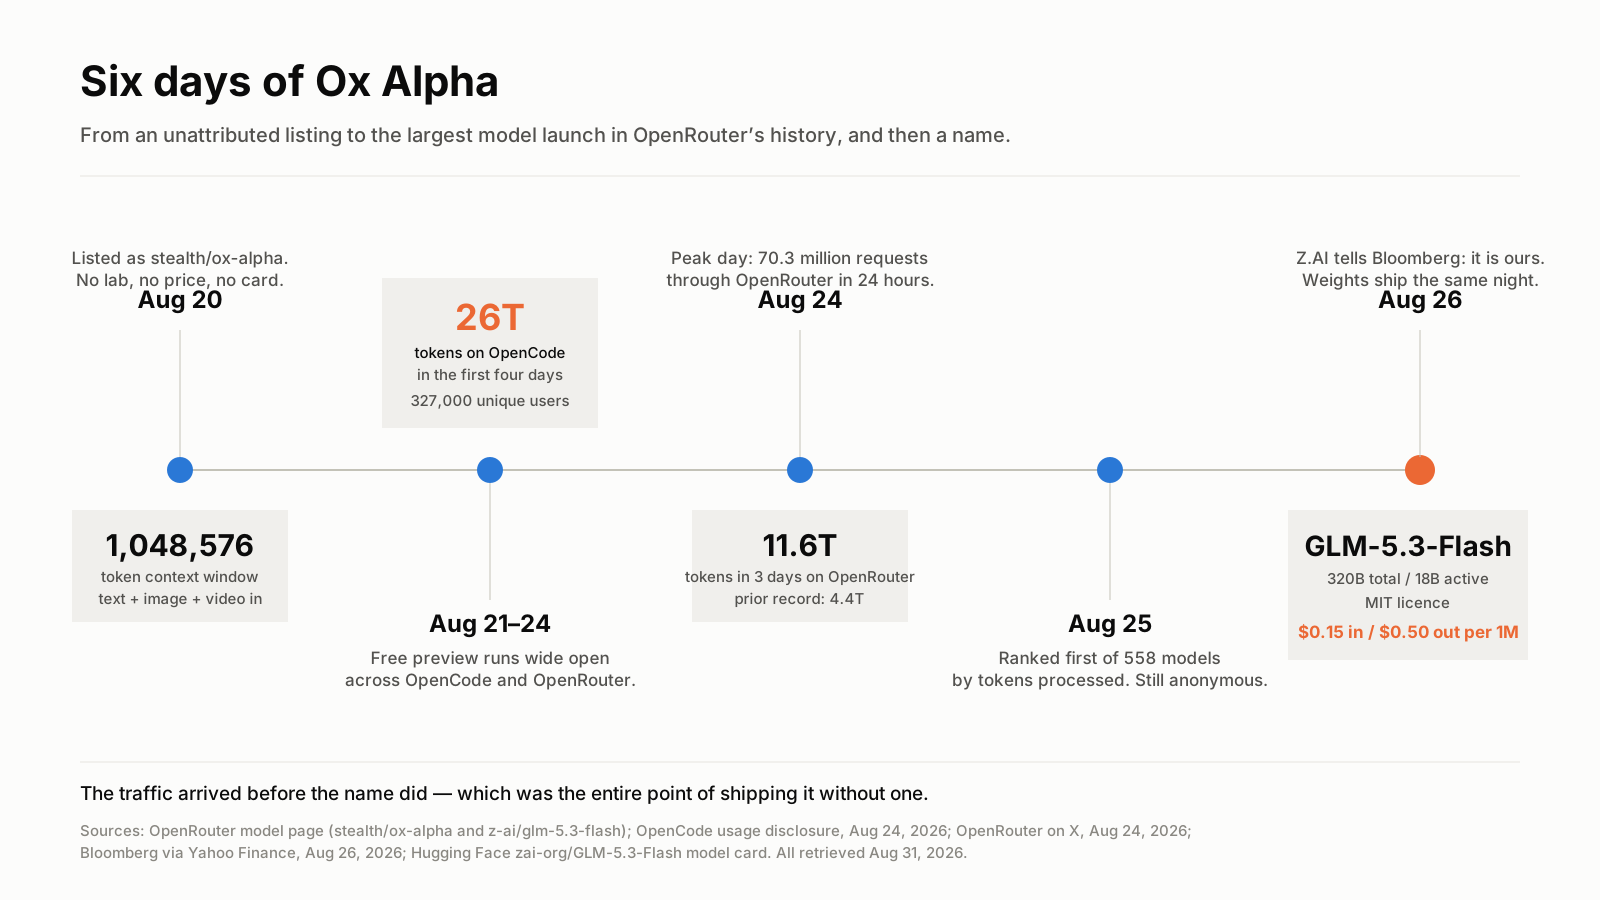
O episódio inteiro, do começo ao fim, durou menos de uma semana. Fontes no final do texto.
Seis dias, na ordem em que aconteceram
20 de agosto: a listagem entra no ar no OpenRouter e simultaneamente dentro do OpenCode, o agente de programação em terminal de código aberto criado por Dax Raad. O OpenCode o anuncia como gratuito, praticamente ilimitado, sem retenção de dados pela própria rota, e diz ter garantido capacidade para até 100 trilhões de tokens por dia.
De 21 a 24 de agosto: o uso sobe todos os dias, sem exceção. O endpoint de atividade de modelos do OpenRouter registrou 27,0 milhões de requisições em 21 de agosto, 54,4 milhões em 22 (alta de 101,2%), 63,9 milhões em 23 e 70,3 milhões em 24.
24 de agosto: o OpenCode publica os números. 26 trilhões de tokens nos primeiros quatro dias, com 327.000 usuários únicos e 8.328.244 sessões concluídas, uma média de 3,2 milhões de tokens por sessão e cerca de 25 sessões por usuário. Isso colocou o Ox Alpha em segundo lugar entre os modelos rastreados pelo OpenCode, atrás do DeepSeek V4 Flash com 33 trilhões e à frente do MiMo-V2.5 da Xiaomi com 12 trilhões. O OpenRouter informou separadamente 11,6 trilhões de tokens nos três primeiros dias completos, chamando o episódio de maior lançamento de modelo da história da plataforma; o recordista anterior gerou 4,4 trilhões na mesma janela inicial.
25 de agosto: a API de modelos do OpenRouter, ordenada por tokens processados na última semana, coloca o Ox Alpha em primeiro lugar entre 558 modelos retornados. Ninguém fora do laboratório sabe quem o construiu.
26 de agosto: a Z.AI confirma à Bloomberg que o Ox Alpha é um novo modelo de sua série GLM. Os pesos saem na mesma noite. O post de lançamento da empresa diz que ela testou o GLM-5.3-Flash anonimamente como ox-alpha no OpenCode e no OpenRouter "para coletar feedback dos usuários", e a página furtiva do OpenRouter é corrigida para dizer que o modelo "foi desenvolvido e operado pela ZAI, revelado como ZAI GLM-5.3-Flash".
O número de tráfego é real. Mas não é um veredito de qualidade.
Foi aqui que a maior parte da cobertura errou, então sejamos precisos sobre o que aqueles 26 trilhões de tokens medem.
Eles medem a vazão de um endpoint gratuito com uma janela de um milhão de tokens, consumido principalmente por agentes de programação. O próprio painel do OpenCode indica que 93% dos tokens de entrada foram servidos a partir de cache: o mesmo contexto de repositório, relido repetidamente ao longo de uma sessão longa. Um ranking ordenado por tokens processados dá uma vantagem mecânica enorme a qualquer modelo gratuito com janela gigantesca, porque os arcabouços de agentes reinjetam contexto, repetem chamadas de ferramenta que falharam e devolvem a saída das ferramentas ao prompt. Sessões longas inflam o número por construção.
O número de 100 trilhões de tokens por dia merece o mesmo tratamento. Aquilo era o OpenCode descrevendo capacidade agregada de serviço, não uso entregue nem cota por usuário. O uso real ficou em torno de 6,5 trilhões de tokens por dia em média nos primeiros quatro dias: 6,5% do teto anunciado. O analista Teortaxes observou que gerar 100 trilhões de tokens de saída por dia a 80 tokens por segundo exigiria cerca de 580.000 equivalentes de GPU, que é exatamente o tipo de número que deveria levar você a perguntar o que está sendo contado antes de repeti-lo.
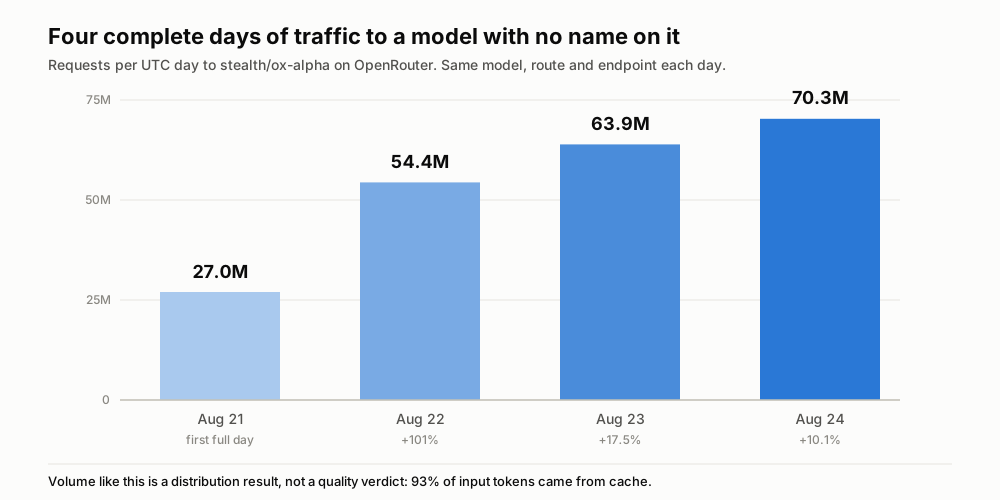
Contagens diárias de requisições do endpoint de atividade de modelos do OpenRouter, snapshot em cache de 25 de agosto de 2026. A plataforma pode revisar esses valores.
Então o que o tráfego de fato prova? Que um modelo gratuito com forma de fronteira e janela de um milhão de tokens, colocado nos dois lugares onde os agentes de programação já vivem, satura a demanda em 24 horas. É um resultado de distribuição, e resultados de distribuição merecem ser estudados por si mesmos. Isso não diz nada sobre se o modelo é bom no seu repositório.
Por que um laboratório hoje publica um modelo sem o próprio nome
Aqui vem a virada, e a marcamos com clareza: tudo acima é medição; o que segue é a nossa leitura.
Publicar anonimamente compra ao laboratório três coisas que ele não consegue de outro jeito. Vamos chamar essa combinação de dividendo do anonimato.
A primeira é uma avaliação limpa. Todo lançamento assinado chega dentro de um preconceito. Um modelo de um laboratório chinês é avaliado contra "surpreendentemente bom para um modelo aberto"; um de um laboratório de fronteira americano é avaliado contra "isso justifica o aumento de preço?". Tire o nome e a única coisa que resta para quem desenvolve reagir é a saída. As avaliações que voltaram durante a semana furtiva foram feitas por gente que não fazia ideia de qual modelo estava elogiando: a coisa mais cara de fabricar em marketing de IA e a mais barata de obter simplesmente não falando.
A segunda é o volante de inércia. O mistério é a campanha. Ninguém escreve um post forense sobre uma atualização de versão rotineira, mas uma semana de impressão digital de tokenizador, análise da camada de serviço e especulação produz um volume enorme de cobertura que o laboratório não precisou comprar. A revelação então aterrissa sobre um público já investido na resposta. A Z.AI ganhou uma semana de atenção gratuita e depois um dia de lançamento com a piada já embutida.
A terceira é telemetria numa escala que o dinheiro não compra com facilidade. 8,3 milhões de sessões de agente concluídas, feitas de trabalho real, bagunçado, com formato de produção, são um conjunto de dados. A página do Ox Alpha no OpenRouter dizia que prompts e respostas eram retidos pelo provedor e explicitamente não usados para treinamento — voltaremos a isso em instantes —, mas só a retenção já rende modos de falha, distribuições de latência, taxas de erro em chamadas de ferramenta e curvas de degradação em contexto longo, ao longo de centenas de milhares de repositórios reais. Você não obtém isso com uma suíte interna de avaliação.
Essa linha sobre condições de dados merece nota própria, porque é a única coisa genuinamente incomum nesta história. Das quatorze listagens furtivas que o OpenRouter operou desde abril de 2025, treze traziam alguma versão de "prompts e respostas são registrados pelo provedor e podem ser usados para melhorar o modelo". Só a do Ox Alpha dizia, em vez disso: retidos, não usados para treinamento. Se isso tranquiliza você depende de quanto peso dá a uma linha de texto na página de modelo de uma plataforma de roteamento. É, no mínimo, uma escolha deliberada, e é a primeira vez que uma listagem furtiva a faz.
O codinome já virou um gênero
Não é uma manobra inédita. É um padrão com cinco confirmações de primeira mão no currículo, e conhecer esse histórico é o que permite calibrar o próximo caso.
| Codinome | Acabou sendo | Confirmado por | Data | Evidência |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1, snapshot da OpenAI antes do lançamento | O próprio blog do OpenRouter | 14/04/2025 | Fonte primária |
| Optimus Alpha | GPT-4.1, snapshot mais próximo da versão final | O próprio blog do OpenRouter | 14/04/2025 | Fonte primária |
| Horizon Alpha / Horizon Beta | Checkpoints iniciais do GPT-5 | OpenRouter, "GPT-5 is now live" | 07/08/2025 | Fonte primária |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast, versões sem e com raciocínio | Apenas inferência da comunidade | — | Relatado, não confirmado |
| Hunter Alpha / Healer Alpha | Xiaomi MiMo | A própria equipe MiMo da Xiaomi | 18/03/2026 | Fonte primária |
| Owl Alpha | Meituan LongCat-2.0-Preview | Blog da Meituan e @Meituan_LongCat | 30/06/2026 | Fonte primária |
| Cypher Alpha / Aurora Alpha | Nunca resolvido | — | — | Nenhuma |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI à Bloomberg; página do OpenRouter corrigida | 26/08/2026 | Fonte primária |
Duas coisas saem dessa tabela. Sete das treze listagens históricas acabaram confirmadas por uma declaração de primeira mão, uma taxa de resolução bem melhor do que o folclore sugere, e três dessas confirmações vieram do laboratório, não do OpenRouter, o que explica por que compilações que só acompanham o blog do OpenRouter continuam subcontando. E o gênero mudou de palco. As linhas de 2025 são OpenAI e xAI. As de 2026 são Xiaomi, Meituan e Z.AI. Os laboratórios chineses não inventaram o lançamento furtivo; eles o industrializaram.
A revelação: 320 bilhões no total, 18 bilhões ativos, MIT
Agora as especificações, tiradas da própria ficha da Z.AI e não do resumo de ninguém.
O GLM-5.3-Flash é descrito por seus autores como "o primeiro modelo nativamente multimodal da série GLM-5", com 320 bilhões de parâmetros no total e 18 bilhões ativos numa configuração de mistura de especialistas, treinado sobre um corpus multimodal de 30 trilhões de tokens. A arquitetura combina, pela primeira vez na série, atenção esparsa e linear, mais uma técnica que o artigo chama de Manifold-Constrained Hyper-Connections. A janela de contexto é de 1.048.576 tokens, com resposta única máxima de 131.072 tokens. A profundidade de raciocínio é exposta por um parâmetro reasoning_effort com os níveis low, high e max, sendo max o padrão. A licença é MIT: não uma licença comunitária sob medida com gatilho de número de usuários, e sim MIT.
A própria afirmação de capacidade da Z.AI merece citação exata, porque é mais contida do que a cobertura ao redor: o modelo "supera o GLM-5.2 em benchmarks e cargas de trabalho reais a um décimo do preço, aproximando-se do Claude Opus 4.8 em benchmarks de programação e de agentes". Aproximando-se. Não superando.
Para uma leitura independente, a Artificial Analysis já o avaliou. O GLM-5.3-Flash marca 57 no Artificial Analysis Intelligence Index, contra uma mediana de 29 entre modelos de pesos abertos comparáveis. Rodar essa suíte completa custou 138,02 dólares em gasto de API — número que citamos por ser o dado isolado mais honesto de todo este texto sobre quanto custa hoje usar inteligência próxima da fronteira. A mesma avaliação sinaliza duas fraquezas reais: a 45 tokens de saída por segundo, o modelo é lento, e gerou 150 milhões de tokens para completar o índice contra uma mediana de 110 milhões, o que o torna prolixo. Prolixidade é conta, mesmo quando o preço por token é pequeno.
Um modelo de linha Flash chegar a 57 é a notícia de verdade
Coloquemos os números lado a lado, com a mesma convenção combinada 3:1 de entrada para saída que a Epoch AI usa em comparações de preço.
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| Lançamento | 05/02/2026 | 14/08/2026 | 26/08/2026 |
| Pesos | Fechados | Apache 2.0 | MIT |
| Intelligence Index | 44,9 | 52,0 | 57 |
| Preço por milhão de entrada | US$ 5,00 | US$ 0,45 | US$ 0,15 |
| Preço por milhão de saída | US$ 25,00 | US$ 3,20 | US$ 0,50 |
| Combinado (3:1) | US$ 10,00 | US$ 1,09 | US$ 0,24 |
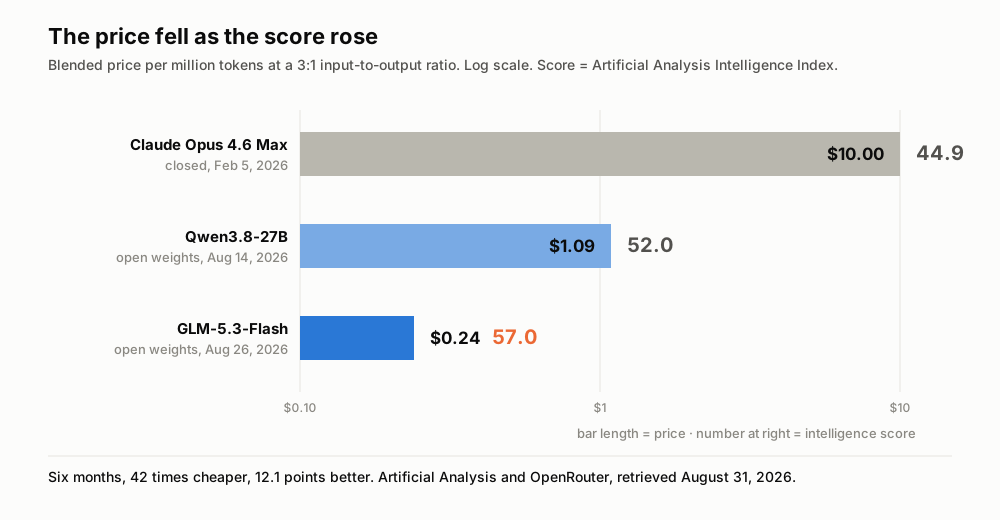
O comprimento da barra é o preço; o número à direita de cada barra é a pontuação de inteligência. Artificial Analysis e OpenRouter, consultados em 31 de agosto de 2026.
O GLM-5.3-Flash custa 42 vezes menos que o carro-chefe fechado de fevereiro e pontua 12,1 pontos a mais no mesmo índice independente. Contra o 27B aberto sobre o qual escrevemos dez dias atrás, é 4,6 vezes mais barato e 5 pontos melhor. Os dois abismos se abriram dentro de seis meses.
É a mesma curva que nosso texto sobre o Qwen3.8 mediu pela outra ponta: a série de limiar fixo da Epoch AI, que mantém uma pontuação de benchmark constante e acompanha o modelo mais barato que a alcança, constatou que o desempenho de nível GPT-4 caiu de 37,50 dólares por milhão de tokens em março de 2023 para 0,18 dólar em fevereiro de 2025 — 208 vezes mais barato em 23 meses. O GLM-5.3-Flash é como essa curva se parece quando alcança a fronteira atual em vez de uma de três anos atrás.
E repare na faixa. Isto não é o carro-chefe. "Flash", na convenção de nomes de qualquer laboratório, designa o irmão barato, rápido e de alto volume do modelo com o qual eles realmente querem impressionar você. O fato interessante não é que um laboratório chinês lançou um modelo forte. É que a referência de entrada já está perto o bastante da fronteira para que uma semana de testes anônimos frente a frente não tenha entregado o jogo de imediato.
Quatro coisas que não conseguimos verificar, marcadas como tais
O entusiasmo em torno deste lançamento corre à frente das evidências em pontos específicos. Aqui estão eles.
A afirmação de que o Ox Alpha "supera o GPT-5.6" em testes de contexto de um milhão de tokens vem de textos de terceiros, não de uma metodologia publicada que pudéssemos inspecionar, e o alvo de comparação da própria Z.AI é o Claude Opus 4.8, não o GPT-5.6. Trate a comparação com o GPT-5.6 como uma afirmação da comunidade não verificada.
A muito repetida pontuação de 80% em pass@1 no DeepSWE não é comparável aos mais de 96% no SWE-bench Verified que aparecem ao lado nas mesmas tabelas. Arcabouço diferente, conjunto de tarefas diferente, dificuldade diferente. Qualquer tabela que os coloque em linhas vizinhas está produzindo um ranking que não existe.
A afirmação da Z.AI de que toda a semana furtiva foi servida em aceleradores chineses domésticos, com melhoria de 3x no serviço de ponta a ponta e custo por token comparável ao hardware da NVIDIA, é declaração do fornecedor e não foi auditada de forma independente. Se se confirmar, é o detalhe mais consequente de toda a história; por ora, é uma afirmação de release.
E a prévia gratuita era um subsídio, não uma faixa de preço. Ela acabou. Os preços atuais são 0,15 e 0,50 dólar, com um desconto promocional de 50% válido até 9 de setembro de 2026 às 16:00 UTC — ou seja, o número honesto em regime estável é o sem desconto, e o orçamento deve ser feito contra 0,15 / 0,50 dólar e não contra o que o modelo custa esta semana.
O que 24 centavos fazem com um pipeline que escuta, traduz e resume
Produtos de voz são incomumente expostos ao preço dos tokens, porque geram transcrições e depois as leem repetidamente. Cada etapa seguinte — refinamento, tradução, resumo, resposta a perguntas — reingere o mesmo texto. Aqui está a aritmética, com todas as premissas na mesa.
- Comece por uma unidade real de trabalho. Uma reunião de 60 minutos entre duas pessoas, a cerca de 130 palavras por minuto, produz aproximadamente 7.800 palavras. Com rótulos de locutor e marcações de tempo, conte 12.000 tokens de transcrição.
- Some a passagem de resumo. Transcrição completa na entrada, notas estruturadas na saída: 12.000 tokens de entrada, cerca de 800 de saída.
- Some a tradução ao vivo para três idiomas. Cada passagem lê a transcrição e escreve um volume comparável: 12.000 de entrada e 12.000 de saída, três vezes.
- Totalize a reunião. 48.000 tokens de entrada e 36.800 de saída.
- Precifique duas vezes. Aos 0,15 / 0,50 dólar do GLM-5.3-Flash, essa reunião custa 2,6 centavos. Aos 5,00 / 25,00 dólares do Claude Opus 4.6, a mesma reunião custa 1,16 dólar.
Uma diferença de 45 vezes em uma única hora de áudio não é otimização de linha de custo. É a diferença entre um recurso cujo uso você mede com cuidado e um recurso que você deixa ligado por padrão. A 1,16 dólar por reunião, traduzir para três idiomas para todo usuário é uma decisão que alguém do financeiro precisa aprovar. A 2,6 centavos, é uma caixa de seleção.
Essa é a parte desta história que sobrevive ao codinome. O lançamento furtivo foi uma manobra de marketing, e das boas. O fato duradouro é que a faixa barata do catálogo de um laboratório de porte médio entrega hoje 57 pontos de índice a 24 centavos combinados, com licença MIT anexada para que você possa rodá-lo por conta própria se o preço um dia se mover na direção errada.
Conclusão: a fronteira já não é onde estão os preços interessantes
Por três anos, a pergunta sobre escolha de modelo foi "quão perto da fronteira você pode se dar ao luxo de estar". Os seis dias do Ox Alpha responderam a outra: quanta capacidade já existe abaixo da faixa de carro-chefe, precificada como commodity, e publicada por laboratórios confiantes o bastante para testá-la com o próprio nome removido.
O dividendo do anonimato só é pago se o modelo for bom o suficiente para sobreviver a uma semana sem marca. A Z.AI recebeu. O próximo codinome que aparecer numa plataforma de roteamento merece o mesmo tratamento que o Ox Alpha recebeu: rode-o nas suas próprias tarefas antes que alguém lhe diga de quem ele é, porque durante aquela semana essa é a única avaliação honesta que qualquer um consegue.
Onde a Telli.sh entra: esta curva é a razão pela qual construímos nosso pipeline de voz sobre uma camada de provedores de motores em vez de em torno da API de um único fornecedor. A Telli.sh roteia transcrição, tradução e resumo por motores intercambiáveis, então um degrau descido nessa curva de preços chega como notas melhores pelo mesmo preço, não como um aviso de reajuste. A parte que nenhum lançamento de modelo entrega é o resto do trabalho: capturar uma hora de áudio sem perdê-la, manter os locutores separados, traduzir ao vivo em 15 idiomas e deixar notas que você ainda consiga buscar no próximo trimestre.
Começar uma nota de IA ao vivo
Fontes
- Página do modelo
stealth/ox-alphano OpenRouter — data de listagem de 20 de agosto de 2026, contexto de um milhão de tokens e a linha acrescentada confirmando ZAI GLM-5.3-Flash; consultada em 31 de agosto de 2026 - Página do modelo
z-ai/glm-5.3-flashno OpenRouter — preços atuais e a janela de desconto promocional até 9 de setembro de 2026; consultada em 31 de agosto de 2026 - Ficha do modelo no Hugging Face, zai-org/GLM-5.3-Flash — 320 bilhões de parâmetros no total / 18 bilhões ativos, corpus multimodal de 30 trilhões de tokens, licença MIT, níveis de
reasoning_efforte a afirmação de aproximação ao Claude Opus 4.8 - Ox Alpha anônimo processa 26 trilhões de tokens no OpenCode e quebra o recorde de lançamento do OpenRouter — RuntimeWire, 26 de agosto de 2026 — 26 trilhões de tokens, 327.000 usuários, 8.328.244 sessões, o índice de 93% de cache e o recorde de 11,6 trilhões de tokens do OpenRouter
- Uso, especificações e indícios sobre a identidade do Ox Alpha — LLM Rumors, 25 de agosto de 2026 — requisições diárias e o primeiro lugar entre 558 modelos
- Modelo furtivo de nível fronteira Ox Alpha aparece gratuitamente no OpenRouter e no OpenCode — WinBuzzer, 24 de agosto de 2026 — a alegação de capacidade de 100 trilhões de tokens por dia e a estimativa de GPU de Teortaxes
- A chinesa Z.AI criou o modelo furtivo Ox Alpha, que rivaliza com a DeepSeek — Bloomberg via Yahoo Finance, 26 de agosto de 2026 — a confirmação de identidade de primeira mão
- O modelo furtivo que bateu a DeepSeek pertence à Zhipu — The Next Web — cobertura da revelação e compromisso com pesos abertos
- Modelos furtivos do OpenRouter: quem eles acabaram sendo — Digital Applied, 22 de agosto de 2026 — o censo de quatorze listagens, datas de revelação, níveis de evidência e a comparação das condições de dados
- Artificial Analysis: análise de inteligência, desempenho e preço do GLM-5.3-Flash — Intelligence Index 57, custo de avaliação de 138,02 dólares, 45 tokens por segundo, 150 milhões de tokens gerados; consultada em 31 de agosto de 2026
- Epoch AI, "LLM inference prices have fallen rapidly but unequally across tasks", 12 de março de 2025 — a escada de preços de limiar fixo por trás do número de 208 vezes
- Nosso antes e depois sobre o retorno dos modelos locais — os números do Qwen3.8-27B, a curva de preços e a defasagem de recuperação