Un modèle anonyme a brûlé 26 000 milliards de tokens en quatre jours. Le tarif est arrivé après : 24 cents.
Le 20 août 2026, un modèle sans laboratoire, sans fiche technique et sans prix est apparu sur OpenRouter sous le nom stealth/ox-alpha. Quatre jours plus tard, les utilisateurs d'OpenCode y avaient poussé 26 000 milliards de tokens. Six jours plus tard, Z.AI le revendiquait : GLM-5.3-Flash, 320 milliards de paramètres, licence MIT, 0,15 dollar par million de tokens en entrée. Pourquoi les laboratoires publient désormais des modèles sans y mettre leur nom, ce que mesurent réellement ces chiffres de trafic, et ce qu'un prix mixte de 24 cents change à l'économie des pipelines vocaux.
Le 20 août 2026, un modèle est apparu sur OpenRouter sous le slug stealth/ox-alpha. Aucun laboratoire n'y était rattaché. Pas de fiche technique, pas de tableau de benchmarks, pas de fil d'annonce. Le champ prix indiquait 0 dollar en entrée, 0 dollar en sortie. Ce qu'il avait, en revanche : une fenêtre de contexte de 1 048 576 tokens, une entrée texte, image et vidéo, et une description d'une ligne sur l'ingénierie logicielle de longue haleine.
Quatre jours plus tard, OpenCode annonçait que ses utilisateurs y avaient poussé 26 000 milliards de tokens.
Six jours plus tard, Z.AI confirmait à Bloomberg que le modèle était le sien, publiait les poids sous licence MIT et y accrochait un tarif : quinze cents par million de tokens en entrée, cinquante cents par million en sortie. Le nom : GLM-5.3-Flash. Le mot « Flash » fait un travail considérable dans cette phrase, et c'est la raison de cet article.
Ceci est un commentaire, pas une couverture de lancement. Vous trouverez ci-dessous la chronologie des six jours avec les chiffres de trafic et leurs réserves, un argument sur les raisons pour lesquelles les laboratoires publient de plus en plus des modèles sans nom, les spécifications et les scores indépendants maintenant que l'identité est connue, une liste explicite des affirmations que nous n'avons pas pu vérifier, et un calcul détaillé de ce qu'un prix mixte de 24 cents fait au coût d'un pipeline vocal. C'est la suite directe de notre avant-après sur le retour des modèles locaux, et la conclusion va dans le même sens : le prix d'une intelligence machine compétente continue de baisser, plus vite que ne le supposent la plupart des feuilles de route produit.
En bref :
- Le trafic était réel et record. 26 000 milliards de tokens sur OpenCode en quatre jours pour 327 000 utilisateurs uniques, et 11 600 milliards sur OpenRouter en trois jours — le plus gros lancement de modèle de l'histoire d'OpenRouter, contre un précédent record de 4 400 milliards.
- L'identité est confirmée à la source. Z.AI a déclaré à Bloomberg le 26 août 2026 qu'Ox Alpha était un modèle de la série GLM ; la page d'OpenRouter indique désormais que ce modèle furtif « a été développé et exploité par ZAI, révélé comme étant ZAI GLM-5.3-Flash ».
- Le prix est l'information principale. 320 milliards de paramètres au total dont 18 milliards actifs, licence MIT, 0,15 dollar en entrée et 0,50 dollar en sortie par million de tokens — soit 0,24 dollar en mixte, contre 10,00 dollars pour le fleuron fermé d'il y a six mois qu'il devance de 12,1 points sur l'Intelligence Index d'Artificial Analysis.
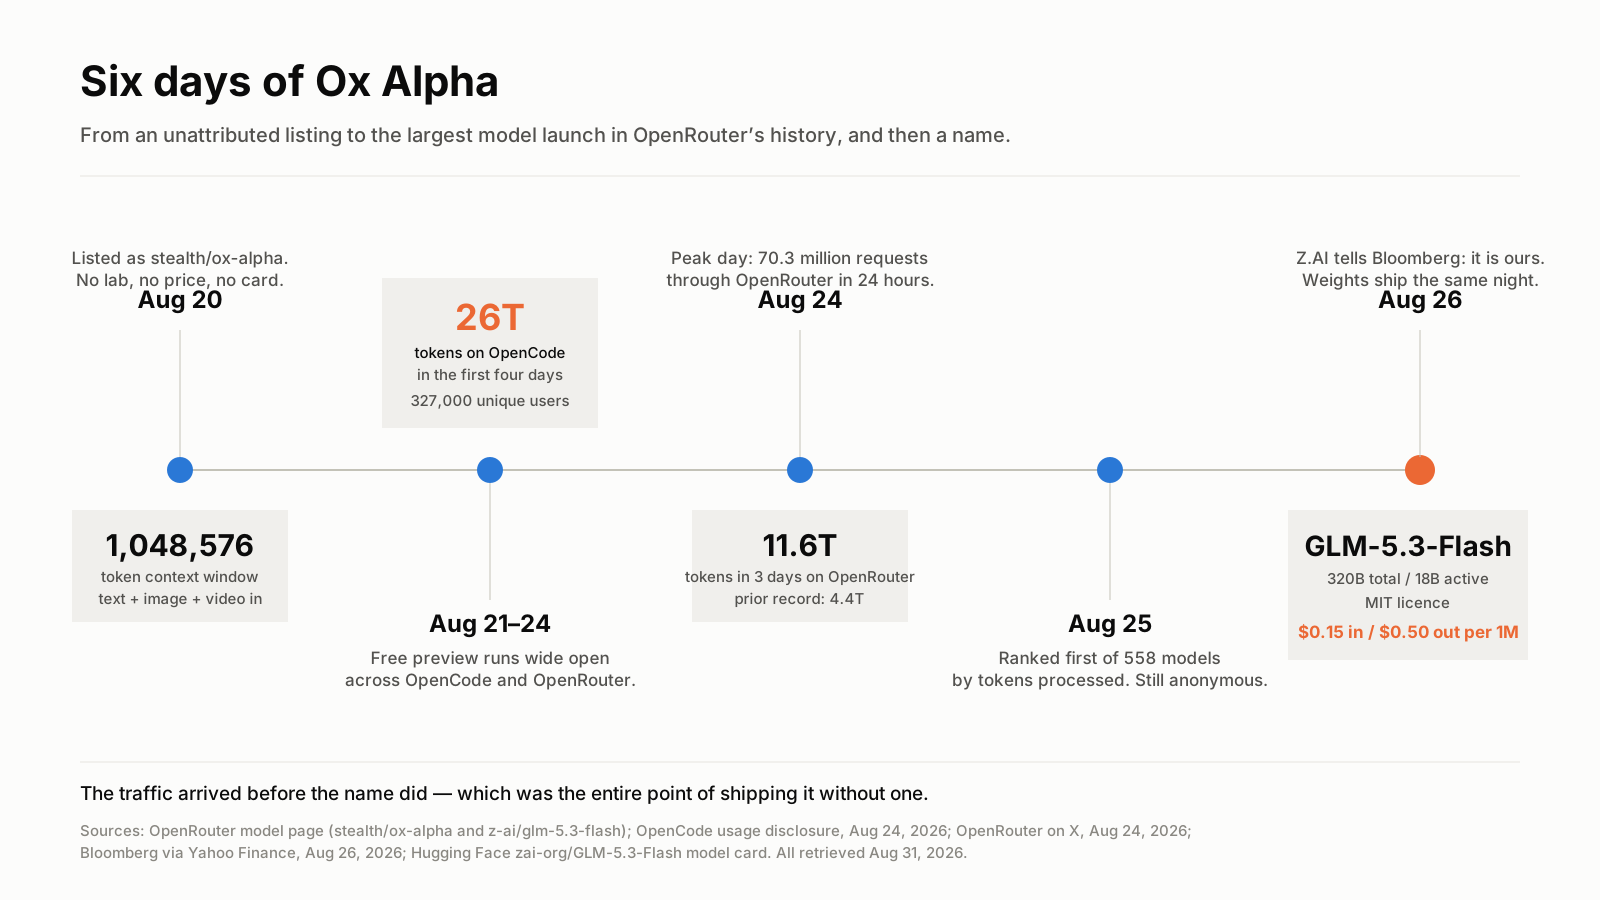
L'ensemble de l'épisode a duré moins d'une semaine. Sources en fin d'article.
Six jours, dans l'ordre où ils se sont déroulés
20 août : la fiche est mise en ligne sur OpenRouter et simultanément dans OpenCode, l'agent de codage en terminal open source créé par Dax Raad. OpenCode le présente comme gratuit, pratiquement illimité, sans conservation des données via sa propre route, et annonce avoir sécurisé une capacité pouvant atteindre 100 000 milliards de tokens par jour.
Du 21 au 24 août : l'usage grimpe chaque jour sans exception. Le point de terminaison d'activité des modèles d'OpenRouter a enregistré 27,0 millions de requêtes le 21 août, 54,4 millions le 22 août (+101,2 %), 63,9 millions le 23 août et 70,3 millions le 24 août.
24 août : OpenCode publie les chiffres. 26 000 milliards de tokens sur les quatre premiers jours, pour 327 000 utilisateurs uniques et 8 328 244 sessions terminées — soit en moyenne 3,2 millions de tokens par session et environ 25 sessions par utilisateur. Ox Alpha se classait ainsi deuxième parmi les modèles suivis par OpenCode, derrière DeepSeek V4 Flash à 33 000 milliards et devant MiMo-V2.5 de Xiaomi à 12 000 milliards. OpenRouter a signalé séparément 11 600 milliards de tokens sur les trois premiers jours complets, qualifiant l'épisode de plus gros lancement de modèle de l'histoire de la plateforme ; le précédent détenteur du record avait généré 4 400 milliards sur la même fenêtre.
25 août : l'API des modèles d'OpenRouter, triée par tokens traités sur la semaine écoulée, place Ox Alpha en tête des 558 modèles renvoyés. Personne, en dehors du laboratoire, ne sait qui l'a construit.
26 août : Z.AI confirme à Bloomberg qu'Ox Alpha est un nouveau modèle de sa série GLM. Les poids sont publiés la nuit même. L'article de lancement de l'entreprise précise qu'elle a testé GLM-5.3-Flash de façon anonyme sous le nom ox-alpha sur OpenCode et OpenRouter « afin de recueillir les retours des utilisateurs ». La page furtive d'OpenRouter est modifiée pour indiquer que le modèle « a été développé et exploité par ZAI, révélé comme étant ZAI GLM-5.3-Flash ».
Le chiffre de trafic est réel. Ce n'est pas pour autant un verdict de qualité.
C'est ici que la plupart des articles ont dérapé, alors soyons précis sur ce que mesurent ces 26 000 milliards de tokens.
Ils mesurent le débit d'un point de terminaison gratuit doté d'une fenêtre d'un million de tokens, consommé principalement par des agents de codage. Le tableau de bord d'OpenCode indique lui-même que 93 % des tokens d'entrée ont été servis depuis le cache — le même contexte de dépôt, relu encore et encore au fil d'une longue session. Un classement trié par tokens traités confère un avantage mécanique énorme à tout modèle gratuit doté d'une fenêtre gigantesque, car les harnais d'agents réinjectent le contexte, réessaient les appels d'outils échoués et renvoient la sortie des outils dans le prompt. Les sessions longues gonflent le chiffre par construction.
Le chiffre de 100 000 milliards de tokens par jour appelle le même traitement. Il s'agissait d'OpenCode décrivant une capacité de service agrégée, pas un usage livré ni un quota par utilisateur. L'usage réel s'est établi en moyenne autour de 6 500 milliards de tokens par jour sur les quatre premiers jours — 6,5 % du plafond annoncé. L'analyste Teortaxes a fait remarquer que générer 100 000 milliards de tokens de sortie par jour à 80 tokens par seconde exigerait environ 580 000 équivalents GPU, ce qui est exactement le genre de chiffre qui devrait vous pousser à demander ce que l'on compte avant de le relayer.
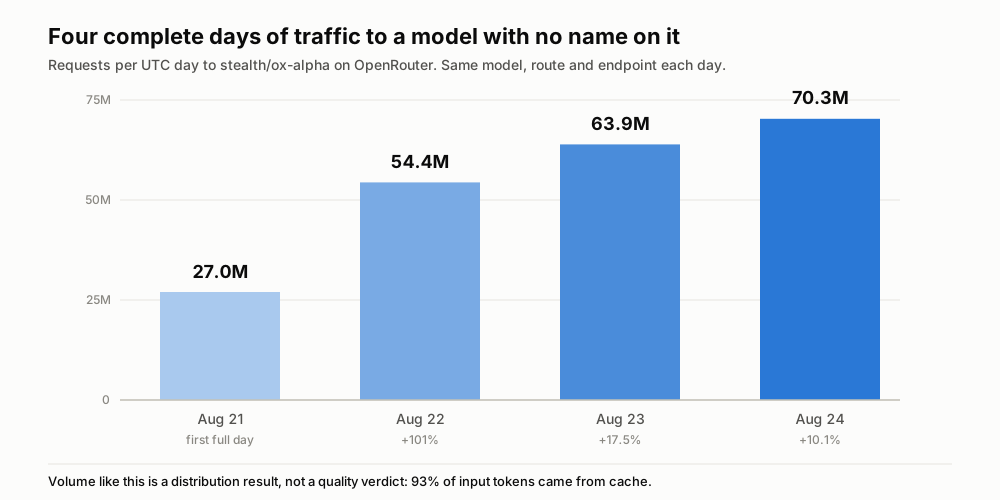
Nombre de requêtes quotidiennes issu du point de terminaison d'activité des modèles d'OpenRouter, instantané mis en cache le 25 août 2026. La plateforme peut réviser ces valeurs.
Que prouve donc réellement ce trafic ? Qu'un modèle gratuit de forme frontière doté d'une fenêtre d'un million de tokens, déposé dans les deux endroits où vivent déjà les agents de codage, sature la demande en 24 heures. C'est un résultat de distribution, et les résultats de distribution méritent d'être étudiés pour eux-mêmes. Cela ne dit rien de la qualité du modèle sur votre dépôt.
Pourquoi un laboratoire publie aujourd'hui un modèle sans y mettre son nom
Voici le point de bascule, et nous le signalons clairement : tout ce qui précède relève de la mesure, ce qui suit relève de notre lecture.
Publier anonymement achète à un laboratoire trois choses qu'il ne peut acquérir autrement. Appelons cette combinaison le dividende d'anonymat.
La première est une évaluation propre. Toute publication signée arrive à l'intérieur d'un a priori. Un modèle issu d'un laboratoire chinois est noté à l'aune de « étonnamment bon pour un modèle ouvert » ; un modèle issu d'un laboratoire frontière américain est noté à l'aune de « est-ce que ça vaut la hausse de prix ». Retirez le nom, et il ne reste plus au développeur qu'à réagir à la sortie. Les évaluations remontées pendant la semaine furtive ont été menées par des gens qui ignoraient totalement quel modèle ils louaient — soit la chose la plus coûteuse à fabriquer en marketing IA, et la moins chère à obtenir en se contentant de ne rien dire.
La deuxième est le volant d'inertie. Le mystère est la campagne. Personne n'écrit un article de blog médico-légal sur une montée de version de routine, mais une semaine d'empreintes de tokenizer, d'analyse de la couche de service et de spéculation produit un volume de couverture considérable que le laboratoire n'a pas eu à acheter. La révélation atterrit ensuite sur un public déjà investi dans la réponse. Z.AI a obtenu une semaine d'attention gratuite, puis un jour de lancement avec sa chute intégrée.
La troisième est une télémétrie à une échelle que l'argent n'achète pas facilement. 8,3 millions de sessions d'agents terminées, faites de travail réel, désordonné, à forme de production, cela constitue un jeu de données. La page OpenRouter d'Ox Alpha indiquait que les prompts et les complétions étaient conservés par le fournisseur et explicitement non utilisés pour l'entraînement — nous y revenons dans un instant. Mais la seule conservation livre déjà des modes de défaillance, des distributions de latence, des taux d'erreur sur les appels d'outils et des courbes de dégradation en contexte long, à travers des centaines de milliers de dépôts réels. Aucune suite d'évaluation interne ne vous donne cela.
Cette ligne sur les conditions relatives aux données mérite sa propre note, car c'est le seul élément véritablement inhabituel de cette histoire. Sur les quatorze fiches furtives qu'OpenRouter a exploitées depuis avril 2025, treize portaient une variante de « les prompts et les complétions sont journalisés par le fournisseur et peuvent être utilisés pour améliorer le modèle ». Seule celle d'Ox Alpha indiquait au contraire : conservés, non utilisés pour l'entraînement. Que cela vous rassure ou non dépend du poids que vous accordez à une ligne de texte sur la page d'une plateforme de routage. C'est au minimum un choix délibéré, et c'est la première fois qu'une fiche furtive le fait.
Le nom de code est devenu un genre à part entière
Ce n'est pas une manœuvre inédite. C'est un schéma avec cinq confirmations de première main à son actif, et connaître ce palmarès est ce qui permet de calibrer le suivant.
| Nom de code | S'est avéré être | Confirmé par | Date | Niveau de preuve |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1, instantané OpenAI avant publication | Le blog d'OpenRouter | 14/04/2025 | Source primaire |
| Optimus Alpha | GPT-4.1, instantané plus proche de la version finale | Le blog d'OpenRouter | 14/04/2025 | Source primaire |
| Horizon Alpha / Horizon Beta | Points de contrôle précoces de GPT-5 | OpenRouter, « GPT-5 is now live » | 07/08/2025 | Source primaire |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast, versions sans et avec raisonnement | Déduction communautaire uniquement | — | Rapporté, non confirmé |
| Hunter Alpha / Healer Alpha | Xiaomi MiMo | L'équipe MiMo de Xiaomi | 18/03/2026 | Source primaire |
| Owl Alpha | Meituan LongCat-2.0-Preview | Blog Meituan et @Meituan_LongCat | 30/06/2026 | Source primaire |
| Cypher Alpha / Aurora Alpha | Jamais élucidé | — | — | Aucun |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI à Bloomberg ; page OpenRouter modifiée | 26/08/2026 | Source primaire |
Deux enseignements sortent de ce tableau. Sept des treize fiches historiques ont fini par être confirmées par une déclaration de première main, un taux d'élucidation bien meilleur que ne le suggère le folklore — et trois de ces confirmations sont venues du laboratoire, pas d'OpenRouter, ce qui explique pourquoi les compilations qui ne surveillent que le blog d'OpenRouter sous-comptent systématiquement. Autre enseignement : le genre a changé de scène. Les lignes de 2025 sont OpenAI et xAI. Celles de 2026 sont Xiaomi, Meituan et Z.AI. Les laboratoires chinois n'ont pas inventé le lancement furtif ; ils l'ont industrialisé.
La révélation : 320 milliards au total, 18 milliards actifs, licence MIT
Passons aux spécifications, tirées de la fiche de Z.AI elle-même plutôt que du résumé de qui que ce soit.
GLM-5.3-Flash est décrit par ses auteurs comme « le premier modèle nativement multimodal de la série GLM-5 », avec 320 milliards de paramètres au total et 18 milliards actifs dans une configuration à mélange d'experts, entraîné sur un corpus multimodal de 30 000 milliards de tokens. L'architecture combine pour la première fois dans la série attention creuse et attention linéaire, à quoi s'ajoute une technique que l'article appelle Manifold-Constrained Hyper-Connections. La fenêtre de contexte est de 1 048 576 tokens, avec une réponse unique plafonnée à 131 072 tokens. La profondeur de raisonnement est exposée via un paramètre reasoning_effort à trois niveaux — low, high et max — avec max par défaut. La licence est MIT : pas une licence communautaire sur mesure avec seuil d'utilisateurs, mais MIT.
L'affirmation de Z.AI sur les capacités mérite une citation exacte, car elle est plus mesurée que la couverture qui l'entoure : le modèle « surpasse GLM-5.2 sur les benchmarks et les charges de travail réelles à un dixième du prix, tout en approchant Claude Opus 4.8 sur les benchmarks de code et d'agents ». Approchant. Pas battant.
Pour une lecture indépendante, Artificial Analysis l'a désormais évalué. GLM-5.3-Flash obtient 57 sur l'Artificial Analysis Intelligence Index, contre une médiane de 29 pour les modèles à poids ouverts comparables. Faire tourner cette suite d'évaluation complète a coûté 138,02 dollars de dépenses API — chiffre que nous citons parce que c'est la donnée unique la plus honnête de tout cet article sur ce que coûte aujourd'hui l'usage d'une intelligence proche de la frontière. La même évaluation signale deux faiblesses réelles : à 45 tokens de sortie par seconde, le modèle est lent, et il a généré 150 millions de tokens pour boucler l'index contre une médiane de 110 millions, ce qui le rend verbeux. La verbosité reste une facture, même quand le prix au token est faible.
Qu'un modèle de gamme Flash atteigne 57 points, voilà la vraie information
Mettons les chiffres côte à côte, avec la même convention de mixage 3:1 entrée-sortie qu'Epoch AI utilise pour comparer les prix.
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| Publication | 05/02/2026 | 14/08/2026 | 26/08/2026 |
| Poids | Fermés | Apache 2.0 | MIT |
| Intelligence Index | 44,9 | 52,0 | 57 |
| Prix par million en entrée | 5,00 $ | 0,45 $ | 0,15 $ |
| Prix par million en sortie | 25,00 $ | 3,20 $ | 0,50 $ |
| Mixte (3:1) | 10,00 $ | 1,09 $ | 0,24 $ |
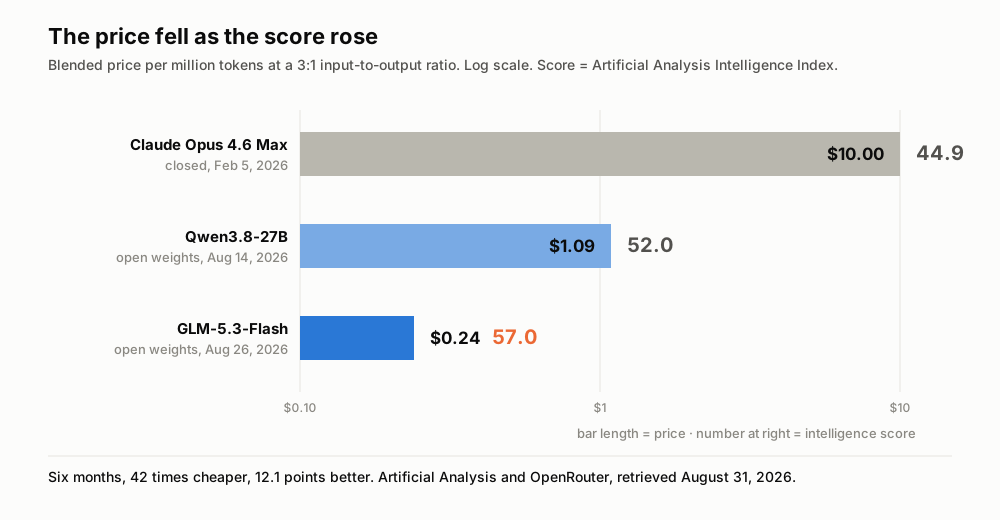
La longueur de la barre représente le prix ; le nombre à droite de chaque barre est le score d'intelligence. Artificial Analysis et OpenRouter, consultés le 31 août 2026.
GLM-5.3-Flash coûte 42 fois moins que le fleuron fermé de février et le devance de 12,1 points sur le même index indépendant. Face au 27B ouvert dont nous parlions il y a dix jours, il est 4,6 fois moins cher et 5 points meilleur. Ces deux écarts se sont creusés en six mois.
C'est la même courbe que notre article sur Qwen3.8 mesurait par l'autre bout : la série à seuil fixe d'Epoch AI, qui maintient un score de benchmark constant et suit le modèle le moins cher qui l'atteint, a établi que la performance de niveau GPT-4 est passée de 37,50 dollars par million de tokens en mars 2023 à 0,18 dollar en février 2025 — 208 fois moins cher en 23 mois. GLM-5.3-Flash montre à quoi ressemble cette courbe lorsqu'elle atteint la frontière actuelle plutôt qu'une frontière vieille de trois ans.
Et notez la gamme. Ce n'est pas le fleuron. Dans la nomenclature de tous les laboratoires, « Flash » désigne le petit frère bon marché, rapide et taillé pour le volume du modèle dont on veut réellement que vous soyez impressionné. Le fait intéressant n'est pas qu'un laboratoire chinois ait sorti un modèle solide. C'est que la référence d'entrée de gamme est désormais assez proche de la frontière pour qu'une semaine de tests anonymes en tête-à-tête n'ait pas immédiatement vendu la mèche.
Quatre choses que nous n'avons pas pu vérifier, signalées comme telles
L'enthousiasme autour de cette publication devance les preuves sur des points précis. Les voici.
L'affirmation selon laquelle Ox Alpha « surpasse GPT-5.6 » sur des tests à un million de tokens de contexte provient d'articles tiers, et non d'une méthodologie publiée que nous aurions pu examiner ; par ailleurs, la référence de comparaison de Z.AI est Claude Opus 4.8, pas GPT-5.6. Traitez la comparaison avec GPT-5.6 comme une affirmation communautaire non vérifiée.
Le score de 80 % en pass@1 sur DeepSWE, largement repris, n'est pas comparable aux plus de 96 % sur SWE-bench Verified que l'on voit à côté dans les mêmes tableaux. Harnais différent, jeu de tâches différent, difficulté différente. Tout tableau qui les place sur des lignes voisines produit un classement qui n'existe pas.
L'affirmation de Z.AI selon laquelle toute la semaine furtive a été servie sur des accélérateurs chinois domestiques, avec une amélioration du service de bout en bout d'un facteur 3 et un coût au token comparable au matériel NVIDIA, émane du fournisseur et n'a pas été auditée indépendamment. Si elle se confirme, c'est le détail le plus lourd de conséquences de toute l'histoire ; pour l'instant, c'est une affirmation de communiqué.
Enfin, l'aperçu gratuit était une subvention, pas une gamme tarifaire. Il a pris fin. Les prix actuels sont de 0,15 et 0,50 dollar, avec une remise promotionnelle de 50 % courant jusqu'au 9 septembre 2026 à 16 h 00 UTC — autrement dit, le chiffre honnête en régime permanent est celui hors remise, et vous devriez bâtir votre budget sur 0,15 / 0,50 dollar plutôt que sur le prix de cette semaine.
Ce que 24 cents changent pour un pipeline qui écoute, traduit et résume
Les produits vocaux sont exceptionnellement exposés au prix des tokens, parce qu'ils produisent des transcriptions puis les relisent en boucle. Chaque étape en aval — nettoyage, traduction, résumé, réponse aux questions — réingère le même texte. Voici le calcul, toutes hypothèses sur la table.
- Partez d'une unité de travail réelle. Une réunion de 60 minutes à deux, à environ 130 mots par minute, produit près de 7 800 mots. Avec les étiquettes de locuteur et les horodatages, comptons 12 000 tokens de transcription.
- Ajoutez la passe de résumé. Transcription complète en entrée, notes structurées en sortie : 12 000 tokens en entrée, environ 800 en sortie.
- Ajoutez la traduction en direct vers trois langues cibles. Chaque passe lit la transcription et écrit un volume comparable : 12 000 en entrée et 12 000 en sortie, trois fois.
- Totalisez la réunion. 48 000 tokens en entrée et 36 800 en sortie.
- Chiffrez deux fois. Aux 0,15 / 0,50 dollar de GLM-5.3-Flash, cette réunion coûte 2,6 cents. Aux 5,00 / 25,00 dollars de Claude Opus 4.6, la même réunion coûte 1,16 dollar.
Un écart de 45 fois sur une seule heure d'audio n'est pas une optimisation de ligne budgétaire. C'est la différence entre une fonctionnalité dont on mesure soigneusement l'usage et une fonctionnalité qu'on laisse activée par défaut. À 1,16 dollar la réunion, traduire vers trois langues pour tous les utilisateurs est une décision qu'il faut faire approuver par la finance. À 2,6 cents, c'est une case à cocher.
C'est la partie de cette histoire qui survivra au nom de code. Le lancement furtif était une manœuvre marketing, et une bonne. Le fait durable, c'est que la gamme bon marché d'un laboratoire de taille moyenne délivre désormais 57 points d'index à 24 cents en mixte, avec une licence MIT attachée pour que vous puissiez l'exécuter vous-même si le prix venait à évoluer dans le mauvais sens.
Le mot de la fin : la frontière n'est plus là où se trouvent les prix intéressants
Pendant trois ans, la question du choix de modèle a été « jusqu'où pouvez-vous vous permettre d'être proche de la frontière ». Les six jours d'Ox Alpha en ont posé une autre : quelle quantité de capacité se trouve désormais sous la gamme fleuron, tarifée comme une commodité, et livrée par des laboratoires assez confiants pour la tester avec leur nom retiré.
Le dividende d'anonymat ne se verse que si le modèle est assez bon pour survivre à une semaine sans marque. Z.AI a encaissé. Le prochain nom de code qui apparaîtra sur une plateforme de routage mérite le même traitement qu'Ox Alpha : faites-le tourner sur vos propres tâches avant que quiconque ne vous dise à qui il appartient, car pendant cette semaine-là, c'est la seule évaluation honnête que quiconque obtiendra.
La place de Telli.sh : cette courbe est précisément la raison pour laquelle nous construisons notre pipeline vocal sur une couche de fournisseurs de moteurs plutôt qu'autour de l'API d'un seul éditeur. Telli.sh route la transcription, la traduction et le résumé vers des moteurs interchangeables : une marche descendue sur cette courbe de prix arrive donc sous la forme de meilleures notes au même tarif, et non d'une annonce tarifaire. Ce qu'aucune publication de modèle ne vous donne, c'est le reste du travail : capter une heure d'audio sans la perdre, distinguer les locuteurs, traduire en direct dans 15 langues, et vous laisser des notes que vous pourrez encore chercher le trimestre prochain.
Démarrer une note IA en direct
Sources
- Page du modèle
stealth/ox-alphasur OpenRouter — date de mise en ligne du 20 août 2026, contexte d'un million de tokens et la mention ajoutée confirmant ZAI GLM-5.3-Flash ; consultée le 31 août 2026 - Page du modèle
z-ai/glm-5.3-flashsur OpenRouter — tarifs actuels et fenêtre promotionnelle jusqu'au 9 septembre 2026 ; consultée le 31 août 2026 - Fiche du modèle Hugging Face, zai-org/GLM-5.3-Flash — 320 milliards de paramètres au total / 18 milliards actifs, corpus multimodal de 30 000 milliards de tokens, licence MIT, niveaux de
reasoning_effortet la formulation sur l'approche de Claude Opus 4.8 - Ox Alpha, anonyme, traite 26 000 milliards de tokens sur OpenCode et bat le record de lancement d'OpenRouter — RuntimeWire, 26 août 2026 — 26 000 milliards de tokens, 327 000 utilisateurs, 8 328 244 sessions, le taux de cache de 93 % et le record de 11 600 milliards de tokens d'OpenRouter
- Usage, spécifications et indices sur l'identité d'Ox Alpha — LLM Rumors, 25 août 2026 — nombre de requêtes quotidiennes et première place sur 558 modèles
- Un modèle furtif de niveau frontière, Ox Alpha, apparaît gratuitement sur OpenRouter et OpenCode — WinBuzzer, 24 août 2026 — l'annonce de capacité de 100 000 milliards de tokens par jour et l'estimation GPU de Teortaxes
- Le chinois Z.AI est à l'origine du modèle furtif Ox Alpha, rival de DeepSeek — Bloomberg via Yahoo Finance, 26 août 2026 — la confirmation d'identité de première main
- Le modèle furtif qui a battu DeepSeek appartient à Zhipu — The Next Web — couverture de la révélation et engagement sur les poids ouverts
- Modèles furtifs d'OpenRouter : ce qu'ils étaient vraiment — Digital Applied, 22 août 2026 — le recensement des quatorze fiches, dates de révélation, niveaux de preuve et comparaison des conditions relatives aux données
- Artificial Analysis : GLM-5.3-Flash, analyse de l'intelligence, des performances et du prix — Intelligence Index de 57, coût d'évaluation de 138,02 dollars, 45 tokens par seconde, 150 millions de tokens générés ; consultée le 31 août 2026
- Epoch AI, « LLM inference prices have fallen rapidly but unequally across tasks », 12 mars 2025 — l'échelle de prix à seuil fixe derrière le chiffre de 208 fois
- Notre avant-après sur le retour des modèles locaux — les chiffres de Qwen3.8-27B, la courbe des prix et le délai de rattrapage