Czy OpenRE-Bench sprawdzi, czy AI zamieniło zgłoszenie na GitHubie w użyteczne wymaganie?
Zestaw dziesięciu przypadków pozwala porównać, jak systemy agentowe przekładają prośby o funkcje na wymagania. Przykład pokazuje, co oceniać przed napisaniem kodu.
W zgłoszeniu na GitHubie czytamy „Zachowaj moje filtry, gdy wrócę”. Agent programistyczny może od razu coś wdrożyć i wybrać błędną interpretację. Czy „wrócę” oznacza powrót do listy po otwarciu pozycji, odświeżenie przeglądarki, jutrzejsze logowanie czy zmianę obszaru roboczego? Każda odpowiedź daje inną funkcję i inny zestaw testów odbiorczych.
OpenRE-Bench bada etap między zgłoszeniem a implementacją. Preprint złożony w arXiv 10 listopada 2026 roku przedstawia wspólne środowisko testowe dla systemów agentowych tworzących wymagania. Pierwszy zestaw ma dziesięć przypadków. Pięć pochodzi z publicznych próśb o funkcje na GitHubie, pięć napisali badacze. Autorzy udostępnili trzy przykładowe adaptery, aby różne systemy mogły używać tych samych wejść i reguł oceny. Preprint OpenRE-Bench
Benchmark pozwala postawić dokładniejsze pytanie o wynik agenta. Czy dwie osoby po przeczytaniu proponowanego wymagania zbudują i sprawdzą to samo zachowanie? Przykład z filtrami pokazuje znaczenie zapisu decyzji obok końcowego opisu i to, jak sprawdzić własny proces przechodzenia od zgłoszenia do wymagania.
Zapisz decyzję, zanim powstanie kod
Inżynieria wymagań polega na wyjaśnieniu celów, ograniczeń i obserwowalnego zachowania na tyle, żeby ludzie mogli je uzgodnić. Dobre zgłoszenie może jasno przedstawiać problem i zostawiać kilka decyzji otwartych. Dwie osoby mogą się zgodzić, że nawigacja ma zachować pracę, i różnić co do przenoszenia ustawień między urządzeniami. Przydatny szkic odnotowuje różnicę, aby mogli ją rozstrzygnąć ludzie odpowiedzialni.
Oto przykładowa interpretacja. Gdy zalogowany użytkownik otworzy pozycję i wróci do listy w tym samym obszarze roboczym, lista przywróci poprzednie wartości filtrów. Zmiany ustawień w innych obszarach pozostają poza zakresem do osobnej decyzji. Test odbiorczy ma stan początkowy, działanie i obserwowalny wynik. Można go przeprowadzić na prototypie lub gotowej funkcji.
Druga interpretacja zapisuje filtry po wylogowaniu i na innym urządzeniu. Wymaga decyzji o zapisie na poziomie konta i reguły dla dwóch urządzeń z różnymi zapisanymi filtrami. Jednozdaniowe zgłoszenie nie określało tych zachowań. Agent, który dodaje je dla wygody, może zmienić małą poprawkę nawigacji w funkcję o innym koszcie i wpływie na prywatność.
| Część zgłoszenia | Pierwsza wersja do sprawdzenia | Co pozostaje do ustalenia |
|---|---|---|
| Powrót z pozycji do listy | Przywrócić widoczne filtry w tym samym obszarze | Czy przywracać też położenie na liście |
| Odświeżenie lub ponowne logowanie | Zapisać jako decyzję otwartą | Jak długo ustawienia są zachowane i gdzie się znajdują |
| Zmiana obszaru roboczego | Zapobiec pojawieniu się filtrów jednego obszaru w innym | Czy każdy obszar zachowuje własną historię |
| Udostępnienie linku z filtrami | Potraktować udostępnianie jako osobny przypadek | Jakie wartości można umieścić w udostępnianym URL |
Przykład przeglądu wygenerowanych wymagań przed implementacją. Ilustracja Telli.sh.
Pierwszy wiersz da się przetestować bez wyjaśnienia warstwy przechowywania. Widać też, że pozostałe wiersze wymagają decyzji. Przydatne wymaganie konkretnie opisuje obiecane zachowanie i pokazuje pytania, za które nadal odpowiada zespół.
Benchmark utrzymuje wspólne reguły wejścia i dowodów
Preprint opisuje wspólny CaseInput z nazwą przypadku, opisem i tekstem wymagania. Adapter tłumaczy między tym kontraktem a każdym uczestniczącym systemem. Zachowuje dane potrzebne środowisku testowemu i zostawia systemowi swobodę współpracy agentów. Dołączone przykłady to MARE, iReDev i QUARE. Według autorów MARE i iReDev to ponowne implementacje oparte na oryginalnych publikacjach. Publikacja OpenRE-Bench, część II
Środowisko gromadzi cztery etapy. Zapisuje modele początkowe, zapis negocjacji, model zintegrowany i wynik weryfikacji. Każdy etap odpowiada na inne pytanie. Co agenci widzieli na początku? Gdzie się różnili? Które wybory pozostały po integracji? Jak można sprawdzić rezultat? Wspólna struktura pozwala śledzić decyzje, gdy systemy różnie nazywają role wewnętrzne.
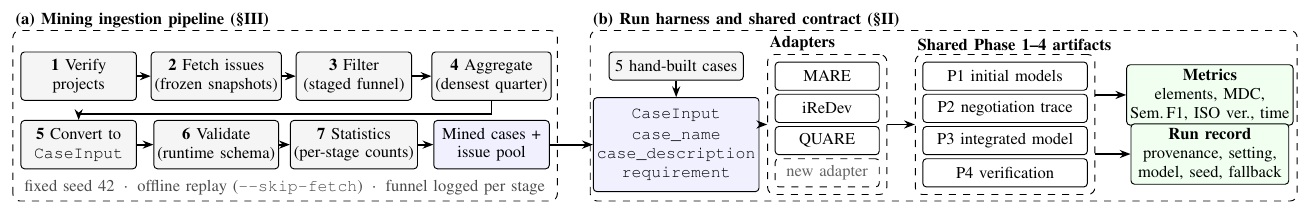
Rysunek 1 z OpenRE-Bench, Cheng i współautorzy, 10 listopada 2026 roku. Wycięto z PDF autorów i dopasowano rozmiar. Oryginalny rysunek · CC BY 4.0.
W przykładzie filtrów etap pierwszy może proponować zarówno „zachowaj listę przy powrocie”, jak i „pamiętaj ustawienia między urządzeniami”. Etap drugi może wskazać dwa możliwe zakresy. Zintegrowany wynik może zachować pierwszy i pozostawić drugi otwarty. Weryfikacja sprawdzi wtedy zachowane zachowanie. Przegląd czterech etapów odróżnia decyzję o zakresie od przypadkowego pominięcia.
Adaptery pozwalają też określić granice porównania. Zaawansowana reprezentacja wewnętrzna może stracić szczegóły przy eksporcie do wspólnego schematu. Zachowaj oryginalne materiały, jeśli wyjaśniają wynik. Ujednolicone wyjścia dają spójne porównanie, a oryginalne pokazują, gdzie system działał inaczej.
Dziesięć przypadków bardziej sprawdza proces niż całą dziedzinę
Cheng i współautorzy zaczęli od 3000 pobranych zgłoszeń z pięciu projektów w Pythonie, TypeScripcie i Javie. Po filtrowaniu zostało 1396 zgłoszeń. Z tej puli 18 wykorzystano w pięciu przypadkach opartych na zgłoszeniach. Z pięcioma przypadkami ręcznymi tworzą zestaw v1.0. Wielkość puli i liczba ocenianych przypadków to różne miary. Przebieg na dołączonym zestawie obejmuje dziesięć przypadków, choć proces zaczyna się od tysięcy zgłoszeń. Publikacja OpenRE-Bench, tabela I
Sposób doboru też stanowi wkład benchmarku. Zapis pobierania i filtrowania pokazuje, jak rzeczywiste zgłoszenie stało się przypadkiem testowym. Pomaga porównać nowy przebieg z opublikowanym. Recenzenci mogą zobaczyć, jakie prośby zbiór zwykle obejmuje i jak wpływają na to etykiety, komentarze, okresy agregacji i inne filtry.
Te wybory kształtują reprezentowane problemy. W publicznych repozytoriach zakres funkcji często ustala się otwarcie. Wewnętrzna zmiana uprawnień może być omawiana głównie w rozmowie z klientem lub zamkniętym przeglądzie projektu. Model dobry na publicznych przypadkach może wymagać prób specyficznych dla dziedziny. Dodaj przypadki z niepełnym kontekstem, wymaganiami rozłożonymi po dokumentach lub sprzecznymi komentarzami, jeśli są częste.
Pięć napisanych przypadków daje inny punkt wyjścia. Przygotowany przykład pozwala wyodrębnić niejednoznaczność, a przykład wydobyty ze zgłoszeń zachowuje naturalny sposób formułowania próśb. Raportuj oba osobno. System lepszy na czystym przykładzie, który gubi decyzje w publicznym wątku, może potrzebować innych poleceń lub dowodów przed użyciem do klasyfikacji zgłoszeń.
Wspólna punktacja daje stabilne porównanie i miejsce na własne kontrole. Ilustracja Telli.sh.
Ocena weryfikowalności potrzebuje sprawdzenia źródeł
Publikacja opisuje powtarzalną ocenę strukturalnej weryfikowalności od 1 do 5 na podstawie sygnałów zgodności związanych z ISO/IEC/IEEE 29148. Podaje też liczbę elementów, zachowanie sensu między początkowym i zintegrowanym wynikiem przebiegu oraz czas. Miary pokazują, czy system konsekwentnie tworzy uporządkowane wyniki i zachowuje pomysły. Nie rozstrzygają, czy wspólne dla wszystkich etapów założenie biznesowe było poprawne. Publikacja OpenRE-Bench, miary
Załóżmy, że pierwszy model interpretuje „wrócę” jako „zaloguję się za tydzień”. Jeśli interpretacja przechodzi do wyniku zintegrowanego, miara zachowania znaczenia może wykazać spójność. Człowiek czytający zgłoszenie nadal może uznać interpretację za bezpodstawną. Miara i przegląd odpowiadają na różne pytania. Oba pomagają, gdy ich zakres jest jasny.
Zachowaj mały zestaw referencyjny twierdzeń o źródle. Dla każdego zgłoszenia wskaż zdania bezpośrednio wspierające wymaganie i wybory pozostawione otwarte. Osoba sprawdzająca powinna oznaczać pominięte ograniczenia, domysły podane jako fakty i sprzeczności testu ze zgłoszeniem. Pięć konkretnych pytań może powiedzieć o wdrożeniu więcej niż średnia wielu różnie określonych przypadków.
Rozważ hipotetyczną funkcję eksportu. Zgłoszenie wymaga czytelności raportu w arkuszu po zmianie regionalnego formatu daty. Pierwszy szkic opisuje wykonawcę, zasób, sekwencję i zapis kontroli. Sama kontrola mówi „Sprawdź, czy datę wyeksportowano poprawnie”. Drugi szkic mówi „Wybierz ustawienia regionalne z dniem na początku, wyeksportuj wiersz z datą 4 marca 2026 roku i sprawdź, czy po otwarciu arkusza z miesiącem na początku nadal zawiera datę 4 marca 2026 roku”. Drugie zdanie łatwo zamienić w test. Pierwszy szkic ma więcej formalnych elementów, ale pozwala dwóm osobom inaczej rozumieć poprawny wynik.
Można sprawdzić także sam przegląd. Poproś dwie osoby o minimalne dane potrzebne do tego samego testu. Jeśli jedna wybierze niejednoznaczną datę, a druga 28. dzień miesiąca, ich dane mogą ujawnić różne klasy błędów. Dobry test odbiorczy wskazuje dane ujawniające problem. Agent może pomóc w jego przygotowaniu, jeśli zna powód zgłoszenia.
Czas i koszt wymagają takiej samej uwagi. Niektóre systemy wywołują modele częściej, aby uzgodnić sprzeczne stanowiska. Wolniejszy proces zasługuje na ten czas, gdy wykrywa konflikty regularnie pomijane przez zespół. Jeśli podejmuje te same decyzje co prostsze rozwiązanie i dodaje długie zapisy pośrednie, różnica należy do porównania kosztu. Uruchom oba na tym samym przypadku przed oceną dodatkowych kroków.
Porównaj kilka wymagań, które można samodzielnie ocenić
- Zacznij od wskazanej wersji materiałów publikacji i krótkiego testu offline. Autorzy opisują
single_agentniewymagający klucza. Pozwala sprawdzić środowisko i ścieżki wyników przed płatną próbą z modelem. Instrukcja materiałów OpenRE-Bench - Wybierz kilka publicznych lub zatwierdzonych zgłoszeń. Uwzględnij prostą prośbę, sprzeczne komentarze i otwartą decyzję o zasadach. Zapisz oczekiwane zachowanie i pytania przed oceną wyniku agenta.
- Użyj tego samego wejścia dla każdego systemu. Zapisz wersję, konfigurację modelu i ustawienia przebiegu. Zachowaj wyniki pośrednie. Stosuj te same kryteria braków i nieuzasadnionych założeń.
- Porównaj wyniki na poziomie decyzji. Zapytaj, co można sprawdzić w produkcie i jaki fragment zgłoszenia to uzasadnia. Zapisz, czy ktoś musi wyjaśnić zakres przed rozpoczęciem kodowania.
- Na podstawie wyników wybierz miejsce agenta. Część zgłoszeń nadaje się do szkicu testu odbiorczego, inne do pytań dla autora. Zachowaj oba typy odpowiedzi widoczne w procesie.
Kolejny krok to omówienie jednego wymagania na prawdziwym przeglądzie. Porównaj szkic agenta z tym, co zespół zgodzi się wdrożyć. Jeśli za każdym razem poprawia się tę samą kategorię twierdzeń, dodaj dla niej test. Wymaganie z dokładnym wynikiem i źródłem jest użyteczne nawet wtedy, gdy reszta dokumentu wymaga pracy.
OpenRE-Bench pozwala porównywać przed pierwszą zmianą w kodzie. Oceń, czy następna osoba dostrzeże uzgodnione zachowanie, źródło dowodu i decyzje, które jeszcze na kogoś czekają.
Źródła
- Cheng i współautorzy, preprint OpenRE-Bench, 10 listopada 2026 roku
- Pełna publikacja z metodami, danymi i oryginalnym rysunkiem 1
- Wersjonowane materiały udostępnione przez autorów
- Creative Commons Uznanie autorstwa 4.0 Międzynarodowe
Aby można było wyszukiwać decyzje dotyczące propozycji funkcji i przeglądów, załóż konto Telli.sh.