OpenRE-Bench può dirci se l’IA ha trasformato una issue di GitHub in un requisito utile?
Un benchmark con dieci casi confronta il modo in cui i framework di agenti trasformano le richieste di funzionalità in requisiti. Un esempio mostra cosa valutare prima di scrivere codice.
Una issue di GitHub dice: «Mantieni i miei filtri quando torno». Un agente di programmazione può iniziare subito a implementare qualcosa. Può anche scegliere l’interpretazione sbagliata. Tornare significa riaprire l’elenco dopo aver consultato un elemento, ricaricare il browser, accedere domani o passare a un altro spazio di lavoro? Ogni risposta porta a una funzionalità e a test di accettazione diversi.
OpenRE-Bench esamina ciò che succede tra una issue e la sua implementazione. Un preprint depositato su arXiv il 10 novembre 2026 presenta un ambiente di prova comune per i framework di agenti che producono requisiti. La prima suite contiene dieci casi, cinque ricavati da richieste di funzionalità pubbliche su GitHub e cinque scritti dai ricercatori. Gli autori forniscono tre adattatori di esempio per applicare gli stessi input e le stesse regole di valutazione a framework diversi. Preprint di OpenRE-Bench
Il benchmark permette di porre una domanda più precisa sul risultato dell’agente. Due persone che leggono i requisiti proposti costruirebbero e proverebbero lo stesso comportamento? L’esempio dei filtri mostra perché la traccia delle decisioni conta quanto il testo finale e come un gruppo può verificare il proprio processo di passaggio dalle issue ai requisiti.
Rendi visibili le decisioni prima di scrivere codice
L’ingegneria dei requisiti rende obiettivi, vincoli e comportamenti osservabili abbastanza chiari da consentire un accordo. Una buona issue può descrivere il problema di un utente e lasciare aperte diverse scelte di implementazione. Due persone possono concordare sul fatto che la navigazione debba preservare il lavoro e avere opinioni diverse sul fatto che le preferenze debbano seguire l’utente su altri dispositivi. Una prima bozza utile registra la differenza affinché possa risolverla chi ne ha la responsabilità.
Ecco un’interpretazione della richiesta sui filtri. Quando un utente autenticato apre un elemento e torna all’elenco nello stesso spazio di lavoro, l’elenco ripristina i filtri precedenti. Le preferenze di altri spazi restano fuori dal perimetro fino a una decisione separata. La verifica di accettazione ha uno stato iniziale, un’azione e un risultato osservabile. Può essere eseguita su un prototipo o sulla funzionalità completata.
Una seconda interpretazione mantiene i filtri dopo la disconnessione e su un altro dispositivo. Richiede una scelta sulla memorizzazione a livello di account e una regola per gestire filtri diversi salvati su due dispositivi. La issue di una sola riga non specificava questi comportamenti. Un agente che li aggiunge perché sembrano comodi può trasformare un piccolo intervento di navigazione in una modifica di prodotto con costi e implicazioni per la privacy diversi.
| Parte della richiesta | Prima bozza verificabile | Decisione ancora da prendere |
|---|---|---|
| Tornare da un elemento all’elenco | Ripristinare i filtri visibili nello stesso spazio di lavoro | Se ripristinare anche la posizione nell’elenco |
| Ricaricare o accedere di nuovo | Registrare la questione come aperta | Per quanto tempo conservare le preferenze e dove |
| Cambiare spazio di lavoro | Evitare che i filtri di uno spazio compaiano in un altro | Se ogni spazio mantiene uno storico proprio |
| Condividere un link con filtri | Trattare la condivisione come caso d’uso separato | Quali valori possono comparire in un URL condiviso |
Esempio di revisione dei requisiti generati prima dell’implementazione. Illustrazione originale di Telli.sh.
La prima riga si può verificare senza una spiegazione tecnica del livello di archiviazione. Chi fa la revisione vede anche che le altre righe richiedono decisioni. Un buon requisito precisa il comportamento promesso e lascia visibili le domande ancora in carico al gruppo.
Il benchmark mantiene fissi gli input e il formato delle evidenze
Il preprint descrive un CaseInput comune, con nome del caso, descrizione e testo del requisito. Un adattatore collega il formato a ciascun framework. Mantiene le informazioni necessarie al confronto e lascia che ogni framework scelga come far collaborare i suoi agenti. Gli esempi inclusi sono MARE, iReDev e QUARE. Gli autori descrivono MARE e iReDev come reimplementazioni basate sugli articoli originali. OpenRE-Bench, sezione II
L’ambiente di prova raccoglie i risultati di quattro fasi: modelli iniziali, verbale della negoziazione, modello integrato e risultato della verifica. Ogni fase risponde a una domanda. Che cosa hanno visto gli agenti all’inizio? Su che cosa hanno avuto opinioni diverse? Quali scelte sono confluite nel risultato integrato? Quali evidenze permettono di verificarlo? La struttura comune rende più semplice seguire una decisione anche se i framework usano nomi diversi per i ruoli interni.
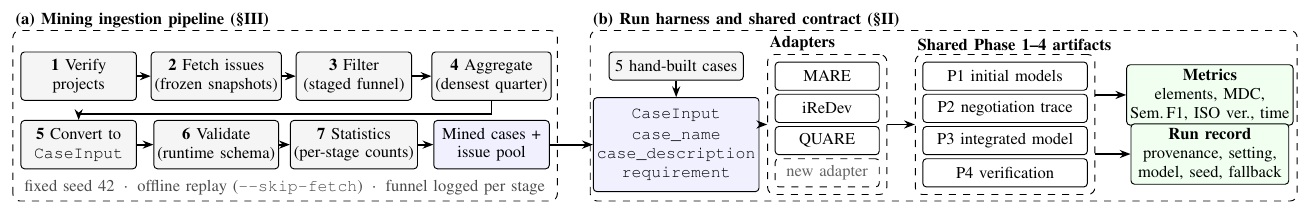
Figura 1 di Cheng e coautori, OpenRE-Bench, 10 novembre 2026. Ritagliata dal PDF degli autori e ridimensionata per la pubblicazione. Figura originale · CC BY 4.0.
Nell’esempio dei filtri, la fase 1 potrebbe proporre sia «conserva l’elenco attuale al ritorno» sia «ricorda le preferenze su più dispositivi». La fase 2 potrebbe registrarle come due possibili perimetri. Il risultato integrato potrebbe mantenere il primo e lasciare il secondo aperto. La verifica finale controllerebbe il comportamento mantenuto. La revisione di tutte e quattro le fasi distingue una scelta di perimetro legittima da un’omissione accidentale.
Gli adattatori aiutano anche a spiegare i limiti del confronto. Un sistema con una rappresentazione interna ricca può perdere sfumature quando esporta nello schema comune. Conserva gli artefatti nativi quando aiutano a spiegare un risultato. Gli output standardizzati danno una base coerente di confronto e gli artefatti nativi chiariscono dove si è comportato diversamente un framework.
I dieci casi mettono alla prova soprattutto il processo
Cheng e coautori riferiscono di essere partiti da 3.000 issue scaricate da cinque progetti in Python, TypeScript e Java. I filtri ne hanno lasciate 1.396. Da quel gruppo, 18 issue sono confluite in cinque casi estratti, che si sono aggiunti ai cinque casi scritti dagli autori nella suite v1.0. Il volume di partenza e il numero di casi valutati sono due quantità diverse. Un’esecuzione della suite inclusa lavora su dieci casi, anche se il processo a monte parte da migliaia di issue. OpenRE-Bench, tabella I
Il processo di selezione è parte del contributo del benchmark. Registrare i passaggi di raccolta e filtraggio mostra come una issue di un progetto reale sia diventata un caso di prova. Questo aiuta a confrontare una nuova esecuzione con un risultato pubblicato. Permette anche di vedere quali tipi di richieste il corpus tende a selezionare, per effetto di etichette, commenti, periodi di raccolta e altri filtri.
Queste scelte determinano quali problemi il benchmark rappresenta. Nei repository pubblici, il perimetro delle funzionalità viene spesso discusso in spazi leggibili da tutti. Un gruppo che pianifica modifiche ai permessi interni potrebbe concordare gran parte del perimetro in una chiamata con il cliente o durante una revisione privata. Un modello che funziona bene sui casi pubblici può aver bisogno di test specifici per quel contesto. Aggiungi casi con contesto incompleto, requisiti distribuiti in più documenti o commenti contraddittori se sono frequenti nel tuo lavoro.
I cinque casi scritti a mano danno alla suite un altro punto di partenza. Un caso costruito ad hoc può isolare una determinata ambiguità. Un caso estratto da un repository può preservare il modo in cui le richieste arrivano nella pratica. Riporta i risultati per ciascun gruppo. Un framework che migliora su un caso pulito ma perde le decisioni in una discussione reale può aver bisogno di istruzioni o evidenze diverse prima di entrare nel processo di selezione delle issue.
Una valutazione comune offre un confronto stabile e uno spazio per le verifiche specifiche del gruppo. Illustrazione originale di Telli.sh.
Affianca al punteggio di verificabilità un controllo della fonte
L’articolo descrive un punteggio riproducibile di verificabilità strutturale da 1 a 5, basato su indicatori di conformità associati a ISO/IEC/IEEE 29148. Riporta anche il numero di elementi, la conservazione semantica tra l’output iniziale e quello integrato di una stessa esecuzione e il tempo trascorso. Le misure mostrano se un sistema produce artefatti strutturati con regolarità e preserva le idee durante il processo. Se ogni fase ha ereditato la stessa ipotesi di business, il punteggio non può stabilire se l’ipotesi fosse corretta. OpenRE-Bench, metriche
Supponiamo che il primo modello interpreti «tornare» come «accedere la settimana prossima». Se la stessa interpretazione compare nel risultato integrato, una misura di conservazione semantica può rilevare coerenza tra le fasi. Chi legge la issue può comunque segnalare che quell’interpretazione non è giustificata. La metrica e la revisione rispondono a domande diverse. Sono entrambe utili quando si capisce il loro perimetro.
Prepara un piccolo insieme di riferimento per le affermazioni sulle fonti. Per ogni issue, individua le frasi che sostengono direttamente un requisito e le scelte che rimangono aperte. Chiedi a chi fa la revisione di segnalare vincoli omessi, ipotesi plausibili presentate come fatti e contraddizioni tra il test proposto e la issue. Una checklist con cinque domande specifiche può dire più sul tuo caso d’uso di una media calcolata su molti casi con perimetri diversi.
Considera una funzione di esportazione ipotetica. Una issue chiede che i report restino leggibili in un foglio di calcolo dopo un cambio di formato regionale delle date. Una bozza definisce un attore, una risorsa dati, una sequenza e un esito di verifica. La verifica dice «Controlla che la data sia esportata correttamente». Un’altra bozza dice «Dopo aver scelto un’impostazione locale con il giorno per primo e aver esportato una riga datata 4 marzo 2026, controlla che nel foglio riaperto con il mese per primo la data memorizzata sia ancora il 4 marzo 2026». La seconda frase si trasforma facilmente in un test. La prima include più elementi formali, ma lascia spazio a due lettori per scegliere esiti attesi diversi.
Anche il processo di revisione si può mettere alla prova. Chiedi a due persone di scrivere i dati di prova minimi per lo stesso controllo proposto. Se una sceglie una data ambigua e l’altra il giorno 28 del mese, i loro dati possono rivelare tipi diversi di errore. Un buon controllo di accettazione specifica quali dati fanno emergere il problema. L’agente può aiutare a scriverlo se capisce perché la issue iniziale contava.
Anche tempo e costi richiedono attenzione. Alcuni framework effettuano più chiamate per conciliare prospettive in conflitto. Un flusso più lento può valere il tempo se mette in luce contrasti che il gruppo perde abitualmente. Se prende le stesse decisioni di un riferimento più semplice e aggiunge artefatti intermedi prolissi, includi questa differenza nel confronto dei costi. Esegui il riferimento e il framework sullo stesso caso prima di decidere se i passaggi in più valgono la pena.
Fai un piccolo confronto su requisiti che puoi valutare
- Parti dall’artefatto alla versione indicata nell’articolo e da una prova di base offline. Gli autori documentano l’impostazione
single_agent, che non richiede una chiave API. Serve a controllare l’ambiente di esecuzione e i percorsi degli artefatti prima di pagare per un confronto basato su modelli. Istruzioni dell’artefatto di OpenRE-Bench - Scegli poche issue pubbliche o autorizzate. Includi una richiesta semplice, una con commenti in conflitto e una che lascia aperta una scelta di policy. Scrivi il comportamento atteso e le domande aperte prima di guardare l’output dell’agente.
- Esegui ogni candidato con lo stesso input e registra versione del framework, configurazione del modello e modalità di esecuzione. Salva gli artefatti intermedi. Usa gli stessi criteri per i requisiti mancanti e le ipotesi non supportate.
- Confronta gli output decisione per decisione. Chiedi cosa si può verificare osservando il prodotto e quale parte della issue lo giustifica. Registra se qualcuno deve chiarire il perimetro prima che si scriva codice.
- Usa i risultati per decidere dove collocare l’agente. Alcune richieste sono pronte per una bozza di test di accettazione. Per altre è meglio preparare un elenco di domande per l’autore. Mantieni entrambi i tipi di output visibili nel flusso.
Un passo successivo è portare un requisito a una vera riunione di revisione. Confronta la bozza dell’agente con ciò che il gruppo decide di rilasciare. Se i revisori riscrivono sempre la stessa categoria di affermazioni, aggiungi un test per quella categoria. Un requisito con un esito atteso preciso e una fonte rintracciabile è utile anche se altre parti del documento richiedono ancora modifiche.
OpenRE-Bench rende il confronto possibile prima della prima modifica al codice. Valuta se chi arriva dopo può capire quale comportamento il gruppo ha concordato, da dove vengono le evidenze e quali decisioni restano da prendere.
Fonti
- Cheng e coautori, preprint OpenRE-Bench, 10 novembre 2026
- Articolo completo con metodi, dati e figura 1 originale
- Artefatto con versione fornito dagli autori
- Creative Commons Attribuzione 4.0 Internazionale
Per ritrovare le decisioni dietro richieste di funzionalità e revisioni, crea un account Telli.sh.