OpenRE-Bench peut-il dire si l’IA a transformé un ticket GitHub en exigence exploitable ?
Un banc d’essai de dix cas compare la façon dont des cadres multiagents transforment des demandes en exigences. Un exemple montre quoi évaluer avant d’écrire du code.
Un ticket GitHub dit « Gardez mes filtres quand je reviens ». Un agent de programmation peut aussitôt proposer une modification. Il peut aussi choisir la mauvaise interprétation. « Revenir » signifie-t-il rouvrir la liste après avoir consulté un élément, recharger le navigateur, se reconnecter demain ou changer d’espace de travail ? Chaque réponse conduit à une fonctionnalité et à des tests d’acceptation différents.
OpenRE-Bench étudie le passage du ticket à l’implémentation. Une prépublication déposée sur arXiv le 10 novembre 2026 présente une infrastructure d’essai commune pour des cadres multiagents qui produisent des exigences. La première suite contient dix cas, dont cinq tirés de demandes publiques sur GitHub et cinq rédigés par les chercheurs. Les auteurs fournissent trois exemples d’adaptateurs pour que différents cadres utilisent les mêmes entrées et les mêmes règles de notation. Prépublication OpenRE-Bench
Le banc d’essai permet de poser une question plus précise sur le résultat d’un agent. Deux personnes qui liraient les exigences proposées mettraient-elles en œuvre et vérifieraient-elles le même comportement ? L’exemple des filtres montre pourquoi la trace des décisions compte autant que le texte final et comment une équipe peut examiner son propre passage du ticket à l’exigence.
Rendez les décisions visibles avant d’écrire le code
L’ingénierie des exigences consiste à expliciter les objectifs, les contraintes et les comportements observables pour que les personnes concernées puissent s’accorder. Un bon ticket peut décrire clairement le problème d’une personne et laisser ouvertes plusieurs décisions de mise en œuvre. Deux parties prenantes peuvent vouloir que la navigation préserve le travail en cours et avoir des avis différents sur la synchronisation des préférences entre appareils. Un premier brouillon utile conserve cette distinction pour que les responsables puissent trancher.
Voici une interprétation possible de la demande sur les filtres. Lorsqu’une personne connectée ouvre un élément et revient à la liste dans le même espace de travail, les valeurs de filtre précédentes sont restaurées. Les préférences des autres espaces restent hors du périmètre jusqu’à une décision distincte de l’équipe. Le test d’acceptation comporte un état initial clair, une action et un résultat observable. Il peut s’exécuter sur un prototype ou sur la fonctionnalité terminée.
Une autre interprétation conserve les filtres après la déconnexion et sur un autre appareil. Cette version exige une décision de stockage à l’échelle du compte et une règle pour deux appareils dont les filtres enregistrés diffèrent. Le ticket d’une ligne ne précisait aucun de ces comportements. Un agent qui les ajoute parce qu’ils paraissent pratiques peut transformer un petit correctif de navigation en changement de produit avec d’autres coûts et effets sur la confidentialité.
| Partie de la demande | Premier brouillon vérifiable | Décision encore ouverte |
|---|---|---|
| Revenir d’un élément à la liste | Rétablir les filtres visibles dans le même espace de travail | Faut-il rétablir aussi la position dans la liste ? |
| Recharger ou se reconnecter | Consigner la question comme une décision ouverte | Combien de temps conserver les préférences et où les stocker ? |
| Changer d’espace de travail | Empêcher les filtres d’un espace d’apparaître dans un autre | Chaque espace conserve-t-il son propre historique ? |
| Partager un lien filtré | Traiter le partage de lien comme un cas distinct | Quelles valeurs peuvent figurer dans une URL partagée ? |
Un exemple pour relire des exigences générées avant leur mise en œuvre. Illustration originale de Telli.sh.
La première ligne peut être vérifiée sans expliquer techniquement le stockage. On voit aussi que d’autres lignes exigent des décisions. Une exigence utile précise le comportement qu’elle promet et laisse visibles les questions qui relèvent encore de l’équipe.
Le banc d’essai fixe les entrées et les résultats attendus
La prépublication décrit un format partagé, CaseInput, qui contient un nom de cas, une description et un texte d’exigence. Un adaptateur relie ce format à chaque cadre participant. Il conserve les éléments nécessaires à la comparaison tout en laissant au cadre le choix de la coopération entre agents. Les exemples fournis sont MARE, iReDev et QUARE. Les auteurs décrivent MARE et iReDev comme des réimplémentations fondées sur les publications d’origine. Article OpenRE-Bench, section II
L’infrastructure recueille les résultats de quatre phases. Elle enregistre des modèles initiaux, une trace de négociation, un modèle intégré et un résultat de vérification. Chaque phase répond à une question. De quoi les agents disposaient-ils au départ ? Sur quels points étaient-ils en désaccord ? Quels choix sont restés après l’intégration ? Quelles preuves permettent de vérifier le résultat ? Cette structure commune facilite le suivi d’une décision même si les cadres donnent des noms différents à leurs rôles internes.
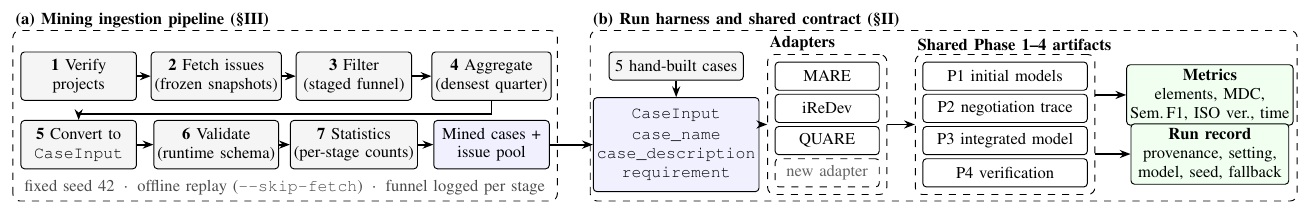
Figure 1 de Cheng et al., OpenRE-Bench, 10 novembre 2026. Recadrée à partir du PDF des auteurs et redimensionnée pour l’affichage. Figure originale · CC BY 4.0.
Dans l’exemple des filtres, la phase 1 pourrait proposer à la fois de « conserver la liste actuelle au retour » et de « mémoriser les préférences entre appareils ». La phase 2 pourrait signaler ces deux périmètres possibles. Le résultat intégré pourrait garder le premier et laisser le deuxième ouvert. La vérification finale porterait alors sur le comportement retenu. Relire les quatre phases permet de distinguer une décision de périmètre justifiée d’un oubli accidentel.
Les adaptateurs permettent aussi de préciser les limites de la comparaison entre cadres. Un système doté d’une représentation interne riche peut perdre des nuances lors de l’export vers un schéma commun. Conservez les résultats natifs lorsqu’ils aident à expliquer une décision. Les sorties normalisées donnent une base de comparaison constante. Les résultats natifs peuvent expliquer pourquoi un cadre s’est comporté différemment.
Les dix cas éprouvent surtout la chaîne de traitement
Cheng et ses coauteurs indiquent avoir collecté 3 000 tickets dans cinq projets qui utilisent Python, TypeScript et Java. Le filtrage en a retenu 1 396. Dans cet ensemble, 18 tickets ont servi à construire cinq cas extraits, auxquels s’ajoutent cinq cas rédigés à la main pour la version 1.0. La réserve de tickets et les cas évalués sont deux quantités différentes. Une exécution de la suite fournie porte sur dix cas, même si la préparation commence avec des milliers de tickets. Article OpenRE-Bench, tableau I
La méthode fait partie de l’apport du banc d’essai. Documenter la collecte et le filtrage montre comment un vrai ticket est devenu un cas de test. Cela aide à comparer une nouvelle exécution à un résultat publié. La personne chargée de la revue peut aussi voir quels types de demandes le corpus sélectionne et l’influence des étiquettes, des commentaires, des périodes de regroupement et d’autres filtres.
Ces choix façonnent les problèmes représentés. Dans un dépôt public, les discussions sur le périmètre des fonctionnalités sont souvent accessibles à tous. Une équipe qui prépare une modification interne des permissions peut en discuter surtout lors d’un appel client ou d’une revue de conception privée. Un modèle performant sur les cas publics peut encore nécessiter des tests propres à ce domaine. Ajoutez des cas où le contexte manque, où les exigences sont réparties sur plusieurs documents ou où des commentaires se contredisent, si votre carnet de demandes contient souvent ces situations.
Les cinq cas rédigés à la main donnent un autre point de départ. Un cas conçu pour le test isole plus facilement une ambiguïté. Un cas issu de tickets montre comment les demandes arrivent en pratique. Présentez les résultats pour chaque groupe. Un cadre qui progresse sur les cas bien délimités mais perd des décisions dans une discussion extraite d’un ticket peut avoir besoin d’autres consignes ou de meilleures sources pour le tri initial.
Une notation commune donne une comparaison stable et permet d’ajouter des vérifications propres à votre travail. Illustration originale de Telli.sh.
Un score de vérifiabilité demande aussi une vérification des sources
L’article décrit un score reproductible de vérifiabilité structurelle de 1 à 5, fondé sur des critères associés à ISO/IEC/IEEE 29148. Il indique également le nombre d’éléments, la préservation sémantique entre les sorties initiales et intégrées d’une même exécution et la durée. Ces mesures montrent si un système produit régulièrement des résultats structurés et conserve les idées d’une étape à l’autre. Elles ne peuvent pas établir qu’une hypothèse métier est juste si toutes les phases l’ont reprise. Article OpenRE-Bench, indicateurs
Supposons que le premier modèle comprenne « revenir » comme « se reconnecter la semaine prochaine ». Si l’interprétation subsiste dans le résultat intégré, la mesure de préservation sémantique peut indiquer une cohérence entre les phases. Une personne qui relit le ticket peut tout de même juger cette interprétation injustifiée. L’indicateur et la relecture répondent à des questions différentes. Les deux sont utiles si leur périmètre est clair.
Gardez un petit ensemble de références validées pour les affirmations sur les sources. Pour chaque ticket, repérez les phrases qui appuient directement une exigence et les choix que la source laisse ouverts. Demandez à une personne de signaler les contraintes perdues, les hypothèses plausibles présentées comme des faits et les contradictions entre le test proposé et le ticket. Cinq questions précises peuvent vous renseigner davantage sur votre déploiement qu’une seule moyenne sur des cas de périmètres différents.
Prenons une fonctionnalité d’export hypothétique. Un ticket demande que les rapports restent lisibles dans un tableur après un changement de format régional des dates. Un premier brouillon définit un acteur, une ressource de données, une séquence et un résultat de vérification. Il propose de « confirmer que la date est correctement exportée ». Un autre dit « Après avoir choisi un paramètre régional où le jour précède le mois et exporté une ligne datée du 4 mars 2026, vérifiez que le fichier exporté contient toujours la date du 4 mars 2026 à sa réouverture avec un paramètre où le mois précède le jour. » La deuxième phrase se traduit directement en test. Le premier brouillon contient plus d’éléments formels, mais sa consigne permet à deux personnes de comprendre différemment le bon résultat.
On peut aussi examiner la qualité de la relecture. Demandez à deux personnes d’écrire les données de test minimales pour la même vérification. Si l’une choisit une date ambiguë et l’autre le 28 du mois, leurs données peuvent révéler des catégories d’erreurs différentes. Un bon test d’acceptation nomme les données qui révèlent l’erreur. L’agent peut aider à écrire ce test s’il comprend pourquoi le ticket d’origine compte.
Le coût et la durée méritent la même attention. Certains cadres effectuent davantage d’appels pour rapprocher des points de vue différents. Un processus plus lent peut valoir ce temps s’il fait ressortir des conflits que l’équipe manque régulièrement. S’il prend les mêmes décisions qu’une version plus simple et produit seulement des résultats intermédiaires plus longs, cette différence entre dans la comparaison des coûts. Exécutez le cadre et la référence sur le même cas avant de juger l’utilité des étapes supplémentaires.
Comparez d’abord des exigences que vous pouvez juger
- Commencez par la version fixée de l’artefact de l’article et un essai rapide hors ligne. Les auteurs documentent un réglage
single_agentsans clé. Il permet de vérifier l’environnement et les chemins de sortie avant de payer une comparaison fondée sur des appels à un modèle. Instructions de l’artefact OpenRE-Bench - Choisissez quelques tickets publics ou autorisés. Incluez une demande simple, une avec des commentaires contradictoires et une qui laisse une décision de politique ouverte. Notez les comportements attendus et les questions ouvertes avant de lire les sorties de l’agent.
- Donnez les mêmes entrées à chaque candidat et notez la version du cadre, la configuration du modèle et le mode d’exécution. Conservez les résultats intermédiaires. Appliquez les mêmes critères pour repérer une exigence manquante ou une hypothèse sans preuve.
- Comparez les résultats au niveau des décisions. Demandez ce qui peut être vérifié en observant le produit et quel passage du ticket le justifie. Notez si une personne doit préciser le périmètre avant l’écriture du code.
- Utilisez ces résultats pour décider du rôle de l’agent. Certaines demandes sont prêtes pour un brouillon de test d’acceptation. D’autres bénéficient d’une liste de questions à poser à l’auteur. Gardez les deux résultats visibles dans le processus.
Vous pouvez ensuite apporter une exigence à une vraie réunion de revue. Comparez le brouillon de l’agent à ce que l’équipe finit par décider de livrer. Si les mêmes types d’affirmations sont réécrits à chaque fois, ajoutez un test qui les cible. Une exigence dotée d’un résultat attendu précis et d’une source traçable peut être utile même si le reste du document demande des retouches.
OpenRE-Bench permet de comparer les approches avant la première modification du code. Examinez si la personne suivante peut comprendre le comportement accepté par l’équipe, retrouver les preuves et voir quelles décisions exigent encore quelqu’un pour trancher.
Sources
- Prépublication OpenRE-Bench de Cheng et al., 10 novembre 2026
- Article intégral avec méthodes, données et figure 1 originale
- Artefact versionné fourni par les auteurs
- Creative Commons Attribution 4.0 International
Pour retrouver les décisions prises autour des demandes et de leurs revues, créez un compte Telli.sh.