¿Puede OpenRE-Bench decir si la IA convirtió una incidencia de GitHub en un requisito útil?
Un banco de diez casos compara cómo los marcos de agentes convierten peticiones de funcionalidades en requisitos. Un ejemplo muestra qué evaluar antes de escribir código.
Una incidencia de GitHub dice: «Conserva mis filtros cuando vuelva». Un agente de programación puede ponerse a implementar algo enseguida. También puede elegir la interpretación equivocada. ¿Volver significa abrir la lista tras consultar un elemento, recargar el navegador, iniciar sesión mañana o cambiar de espacio de trabajo? Cada respuesta da lugar a una funcionalidad y a unas pruebas de aceptación distintas.
OpenRE-Bench examina lo que sucede entre la incidencia y la implementación. Un preprint enviado a arXiv el 10 de noviembre de 2026 presenta un entorno de pruebas común para marcos de agentes que generan requisitos. El primer conjunto contiene diez casos, cinco derivados de peticiones públicas de funcionalidades en GitHub y cinco escritos por los investigadores. Los autores proporcionan tres adaptadores de ejemplo para aplicar a distintos marcos las mismas entradas y reglas de puntuación. Preprint de OpenRE-Bench
El banco de pruebas permite formular una pregunta más precisa sobre el resultado del agente. ¿Dos personas que lean los requisitos propuestos construirían y probarían el mismo comportamiento? El ejemplo de los filtros muestra por qué el rastro de las decisiones importa tanto como el texto final y cómo puede un equipo comprobar su propio proceso de convertir incidencias en requisitos.
Haz visibles las decisiones antes de escribir código
La ingeniería de requisitos aclara objetivos, restricciones y comportamientos observables para que las personas puedan llegar a un acuerdo. Una incidencia bien redactada puede explicar un problema del usuario y dejar abiertas varias decisiones de implementación. Dos partes interesadas pueden coincidir en que la navegación debe conservar el trabajo y discrepar sobre si las preferencias deben seguir al usuario entre dispositivos. Un primer borrador útil registra esa diferencia para que la resuelvan las personas responsables.
Veamos una interpretación de la petición de filtros. Cuando un usuario con sesión iniciada abre un elemento y vuelve a la lista del mismo espacio de trabajo, la lista restaura los filtros anteriores. El alcance excluye cambios en las preferencias de otros espacios hasta que el equipo tome una decisión aparte. La comprobación de aceptación tiene un estado inicial, una acción y un resultado observable. Puede ejecutarse en un prototipo o en una funcionalidad acabada.
Otra interpretación conservaría los filtros después de cerrar sesión y en otro dispositivo. Esa versión exige decidir si se guardan por cuenta y qué ocurre cuando dos dispositivos tienen guardados filtros distintos. La incidencia de una sola línea no especificaba estos comportamientos. Si un agente los añade porque parecen cómodos, un pequeño ajuste de navegación puede convertirse en un cambio de producto con otro coste e impacto sobre la privacidad.
| Parte de la petición | Primer borrador que se puede revisar | Qué queda por decidir |
|---|---|---|
| Volver de un elemento a la lista | Restaurar los filtros visibles en el mismo espacio | Si también debe restaurarse la posición en la lista |
| Recargar o volver a iniciar sesión | Registrar una decisión pendiente | Cuánto tiempo se conservan las preferencias y dónde se guardan |
| Cambiar de espacio de trabajo | Impedir que los filtros de un espacio aparezcan en otro | Si cada espacio guarda su propio historial |
| Compartir un enlace con filtros | Tratarlo como un caso de uso independiente | Qué valores se pueden representar en una URL compartida |
Ejemplo para revisar requisitos generados antes de la implementación. Ilustración original de Telli.sh.
La primera fila puede probarse sin una explicación técnica del almacenamiento. El revisor también puede ver que las demás filas necesitan decisiones. Un requisito útil concreta el comportamiento que promete y deja claras las cuestiones que siguen en manos del equipo.
El banco de pruebas mantiene constantes las entradas y el formato de las pruebas
El preprint describe una estructura común, CaseInput, con un nombre de caso, una descripción y el texto del requisito. Un adaptador conecta este formato con cada marco participante. Conserva la información necesaria para comparar y deja que cada marco elija cómo colaboran sus agentes. Los ejemplos incluidos son MARE, iReDev y QUARE. Los autores describen MARE e iReDev como reimplementaciones basadas en los artículos originales. OpenRE-Bench, sección II
El entorno de pruebas recoge resultados de cuatro fases: modelos iniciales, registro de la negociación, modelo integrado y resultado de la verificación. Cada fase responde a una pregunta. ¿Qué vieron los agentes al principio? ¿En qué discreparon? ¿Qué decisiones llegaron al resultado integrado? ¿Qué pruebas permiten comprobarlo? La estructura compartida facilita seguir una decisión aunque los marcos nombren de manera distinta sus papeles internos.
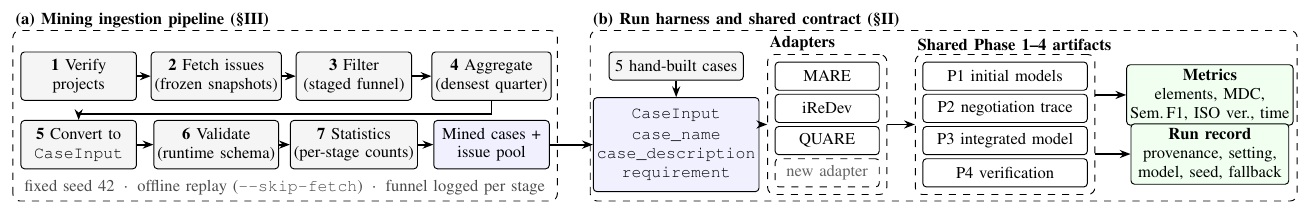
Figura 1 de Cheng y colaboradores, OpenRE-Bench, 10 de noviembre de 2026. Recortada del PDF de los autores y redimensionada para la publicación. Figura original · CC BY 4.0.
En el caso de los filtros, la fase 1 podría proponer «conservar la lista actual al volver» y «recordar las preferencias en distintos dispositivos». La fase 2 podría anotarlas como dos opciones de alcance. El artefacto integrado podría conservar la primera y dejar la segunda abierta. La verificación final comprobaría entonces el comportamiento elegido. Revisar las cuatro fases permite distinguir una decisión de alcance legítima de una omisión accidental.
Los adaptadores también ayudan a explicar los límites de la comparación. Un sistema con una representación interna detallada puede perder matices al exportarla al esquema común. Conserva los artefactos nativos cuando ayuden a explicar el resultado. Las salidas normalizadas ofrecen una base común y los artefactos nativos ayudan a entender dónde actuó de otra manera un marco.
Los diez casos ponen a prueba el proceso más que el campo en su conjunto
Cheng y sus colaboradores partieron de 3.000 incidencias extraídas de cinco proyectos en Python, TypeScript y Java. Tras aplicar los filtros quedaron 1.396. De ese grupo se usaron 18 incidencias para construir cinco casos, a los que se sumaron cinco casos de los investigadores en el conjunto v1.0. El volumen de origen y los casos evaluados son cantidades distintas. Cada ejecución del conjunto incluido trabaja con diez casos, aunque el proceso de origen empiece con miles de incidencias. OpenRE-Bench, tabla I
El proceso de selección forma parte de la contribución. Registrar los pasos de extracción y filtrado permite seguir el recorrido de una incidencia real hasta el caso de prueba. Eso ayuda a comparar una nueva ejecución con un resultado publicado. También permite ver qué peticiones tiende a seleccionar el corpus por efecto de etiquetas, comentarios, periodos de recopilación y otros filtros.
Estas elecciones determinan qué problemas representa el banco. En los repositorios públicos suele discutirse el alcance a la vista de todos. Un equipo que modifica permisos internos quizá negocie buena parte del alcance en una llamada con clientes o en una revisión de diseño privada. Un modelo que funcione bien en casos públicos puede necesitar pruebas específicas para ese contexto. Añade casos con contexto incompleto, requisitos repartidos entre documentos o comentarios contradictorios si son habituales en tu lista de trabajo.
Los cinco casos escritos por los autores ofrecen otro punto de partida. Un caso diseñado para el banco facilita aislar una ambigüedad. Uno extraído de un repositorio puede conservar la forma en que llegan las peticiones en la práctica. Informa de los resultados de cada grupo. Un marco que mejora en un caso limpio, pero pierde decisiones en un hilo real, quizá necesite otras instrucciones o pruebas de apoyo antes de incorporarse al proceso de clasificación de incidencias.
Una evaluación común da a los revisores una base estable y un lugar donde añadir comprobaciones propias. Ilustración original de Telli.sh.
Acompaña la puntuación de verificabilidad con una revisión de la fuente
El artículo describe una puntuación reproducible de verificabilidad estructural, del 1 al 5, basada en indicadores de conformidad asociados a ISO/IEC/IEEE 29148. También mide el número de elementos, la conservación del significado entre las salidas inicial e integrada de una ejecución y el tiempo transcurrido. Estas medidas permiten ver si un sistema produce artefactos estructurados de forma constante y conserva ideas durante el proceso. Si todas las fases heredaron una suposición de negocio, las métricas no pueden determinar si era correcta. OpenRE-Bench, métricas
Supongamos que el primer modelo interpreta «volver» como «iniciar sesión la semana que viene». Si la misma interpretación aparece en la salida integrada, una métrica de conservación semántica puede reflejar la coherencia entre fases. Una persona que lea la incidencia puede señalar que la interpretación carece de respaldo. La métrica y la revisión responden a preguntas distintas. Ambas sirven cuando queda claro qué comprueba cada una.
Guarda un pequeño conjunto de referencia para las afirmaciones sobre la fuente. Por cada incidencia, identifica las frases que respaldan directamente un requisito y las opciones que deja abiertas. Pide al revisor que marque restricciones omitidas, suposiciones plausibles presentadas como hechos y contradicciones entre la prueba propuesta y la incidencia. Una lista de cinco preguntas concretas puede decir más sobre tu despliegue que una sola media de casos con alcances diferentes.
Considera una funcionalidad de exportación hipotética. Una incidencia pide que los informes sigan siendo legibles en una hoja de cálculo cuando cambia el formato regional de la fecha. Un borrador define un actor, un recurso de datos, una secuencia y un registro de verificación. La comprobación dice «Confirma que la fecha se exporta correctamente». Otro borrador propone: «Tras elegir una configuración regional con el día primero y exportar una fila del 4 de marzo de 2026, verifica que al reabrir la hoja en una configuración con el mes primero la fecha almacenada siga siendo el 4 de marzo de 2026». La segunda frase se convierte con facilidad en una prueba. La primera incluye más elementos formales, pero dos lectores pueden discrepar sobre el resultado correcto.
También puedes poner a prueba la propia revisión. Pide a dos revisores que escriban los datos mínimos para la misma prueba propuesta. Si uno elige una fecha ambigua y el otro el día 28, sus datos pueden revelar clases distintas de problemas. Una buena comprobación de aceptación indica los datos que ponen de manifiesto el error. El agente puede ayudar a escribirla si entiende por qué importaba la incidencia inicial.
El coste y el tiempo merecen el mismo cuidado. Algunos marcos hacen más llamadas para conciliar perspectivas. Un proceso más lento puede compensar si detecta conflictos que el equipo suele pasar por alto. Si toma las mismas decisiones que una base más sencilla y añade artefactos intermedios extensos, incluye esa diferencia en la comparación de costes. Ejecuta ambos en el mismo caso antes de decidir si valen la pena los pasos adicionales.
Compara a pequeña escala con requisitos que puedas juzgar
- Empieza por el artefacto de versión fija del artículo y una prueba básica sin conexión. Los autores documentan un ajuste
single_agentque funciona sin clave de API. Permite comprobar el entorno de ejecución y las rutas de los artefactos antes de pagar por una comparación con modelos. Instrucciones del artefacto de OpenRE-Bench - Selecciona unas pocas incidencias públicas o autorizadas. Incluye una petición sencilla, una con comentarios contradictorios y una que deje abierta una decisión de política. Escribe el comportamiento esperado y las preguntas abiertas antes de mirar la salida del agente.
- Ejecuta cada opción con las mismas entradas y registra la versión del marco, la configuración del modelo y los parámetros de ejecución. Guarda los artefactos intermedios. Aplica los mismos criterios para detectar requisitos ausentes o suposiciones sin respaldo.
- Compara las salidas decisión por decisión. Pregunta qué se podría verificar observando el producto y qué texto de la incidencia lo justifica. Registra si una persona tiene que aclarar el alcance antes de escribir código.
- Utiliza el resultado para decidir dónde aporta valor el agente. Algunas peticiones ya permiten redactar una prueba de aceptación. Otras necesitan una lista de preguntas para el autor. Mantén ambas salidas visibles en el proceso.
Un paso posterior es llevar un requisito a una reunión de revisión real. Compara el borrador del agente con lo que el equipo acuerda publicar. Si los revisores reescriben siempre la misma categoría de afirmaciones, añade una prueba para ella. Un requisito con un resultado esperado preciso y una fuente rastreable es útil aunque el resto del documento todavía necesite cambios.
OpenRE-Bench facilita la comparación antes del primer cambio de código. Comprueba si la persona que toma el relevo puede ver qué comportamiento acordó el equipo, de dónde salen las pruebas y qué decisiones siguen pendientes.
Fuentes
- Cheng y colaboradores, preprint de OpenRE-Bench, 10 de noviembre de 2026
- Artículo completo con métodos, datos y figura 1 original
- Artefacto con versión facilitado por los autores
- Creative Commons Atribución 4.0 Internacional
Para poder buscar las decisiones tomadas durante las peticiones y revisiones de funcionalidades, crea una cuenta de Telli.sh.