Распознавание речи тихо стало открытым — и весит 1,56 ГБ
Модели Qwen3-ASR от Alibaba выпущены под Apache 2.0, покрывают 52 языка и диалекта и весят меньше двух гигабайт. Понятный разбор слоя открытых моделей транскрибации: что уже есть, что реально даёт запуск модели на своём ноутбуке и где закрытые API по-прежнему выигрывают.
Теперь распознавание речи с открытыми весами можно запускать на ноутбуке: команда Qwen из Alibaba выпускает Qwen3-ASR-0.6B, Qwen3-ASR-1.7B и дополнительную модель Qwen3-ForcedAligner-0.6B под лицензией Apache 2.0. Самая маленькая модель занимает 1,56 ГБ, поддерживает 52 языка и диалекта и с 26 июня запускается тремя строками стандартного Python. Запуск на собственном компьютере избавляет от оплаты за каждый запрос на транскрибацию.
Сдвиг будет знаком всем, кто следил за открытыми языковыми моделями: самостоятельное размещение даёт больше контроля над стоимостью, конфиденциальностью и автономной работой, а размещённые API проще в эксплуатации. В распознавании речи формируется такой же выбор: модели стали достаточно компактными для локального запуска.
Это руководство объясняет, как работает распознавание речи с открытыми весами, чем отличаются доступные модели и лицензии, на каком оборудовании можно запускать небольшую модель и в чём размещённые API пока сохраняют преимущество.
TL;DR:
- Открытая транскрибация уже пригодна к работе: Qwen3-ASR под Apache 2.0 с 52 языками и диалектами, Whisper под MIT, Parakeet и Canary от NVIDIA под CC BY 4.0, Voxtral от Mistral под Apache 2.0.
- Собственный хостинг даёт приватность, автономную работу и контроль над расходами. По независимому рейтингу Artificial Analysis, размещение открытой модели стоит 1,50 доллара за 1000 минут против 6,00 у Microsoft MAI-Transcribe-1.5 и 18,15 у Gemini 3.1 Pro Preview.
- Первое место по точности всё ещё занимает закрытая предварительная точка доступа. Но открытая модель под Apache 2.0, Voxtral Small, уже на пятом месте — примерно в одном процентном пункте по доле ошибочных слов.
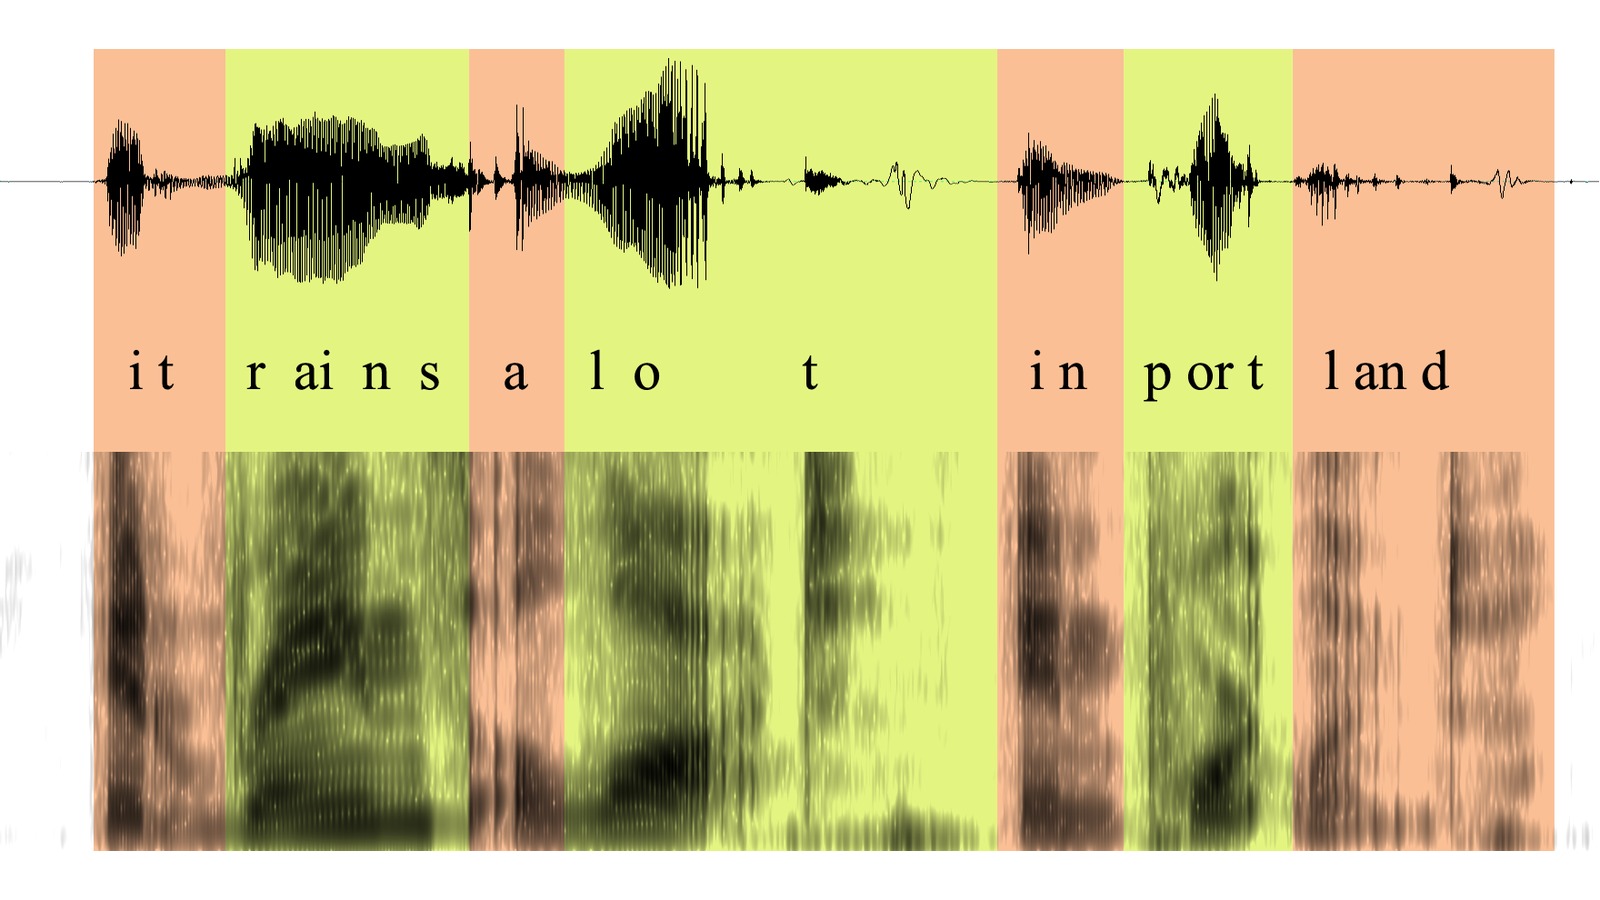
Изображение: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Осциллограмма и спектрограмма фразы «it rains a lot in Portland», буквы расставлены над теми участками звука, которым соответствуют, — именно с таким сырьём работает любая модель распознавания речи.
Что вы на самом деле скачиваете, когда скачиваете модель транскрибации
Модель ASR — автоматическое распознавание речи, то же самое, что STT, речь в текст, — это программа, которая принимает звук и выдаёт текст. Вся её работа в этом. Она не решает, кто говорил, не резюмирует, не знает, о чём была ваша встреча. Она слышит слова и записывает их.
«Открытые веса» означают, что лаборатория опубликовала сам файл готовой модели. Веса модели — это огромная сетка чисел, выученная при обучении, и их публикация означает, что вы скачиваете этот файл, запускаете на своём железе и строите поверх, ни у кого не спрашивая разрешения и не платя за каждый запрос. Альтернатива — закрытая модель: веса остаются на серверах поставщика, а вы арендуете доступ через API — звук уходит наверх, текст возвращается, счёт идёт по минутам.
Число в названии — количество параметров, и для речевых моделей оно необычайно осязаемо. «0.6B» значит около 600 миллионов параметров, а на практике это делает Qwen3-ASR-0.6B файлом на 1,56 ГБ, а Qwen3-ASR-1.7B — на 4,08 ГБ. Оба достаточно малы, чтобы лежать на SSD ноутбука незаметно. Сравните с открытыми языковыми моделями из нашего обзора китайской волны, где главный релиз занимал 1,56 терабайта в 96 частях, и кластер требовался только чтобы его загрузить. Речевые модели примерно в тысячу раз меньше передовых текстовых, и один этот факт объясняет, почему здесь сдвиг бьёт сильнее, чем там.
Назовём этот диапазон размеров ноутбучным классом: модели настолько компактны, что попробовать их можно скачиванием, а не решением вопроса о бюджете на оборудование. Большинство передовых текстовых моделей в него не входят; многие речевые — входят.
Перед тем как выбирать модель, проверьте её лицензию. Apache 2.0 и MIT разрешают использовать, изменять и распространять модель в коммерческих целях; CC BY 4.0, под которой выпускаются модели NVIDIA, тоже разрешает коммерческое использование, но требует указания авторства.
Qwen выпустила семейство в январе; лёгким оно стало в июне
Семейство Qwen3-ASR впервые появилось 28 января 2026 года, а на следующий день на arXiv вышел технический отчёт. 26 июня Qwen опубликовала версии -hf всех трёх моделей, совместимые с Hugging Face Transformers начиная с версии 5.13.0.
Изменение упаковки сделало настройку привычнее: вместо установки пакета Qwen qwen-asr или бэкенда vLLM разработчики, работающие с Transformers, могут загружать контрольные точки -hf с помощью стандартного Python. Это снижает затраты на настройку, не меняя того, что распознаёт модель.
В карточках моделей указано распознавание и определение языка для 30 языков, включая английский, китайский, корейский, японский, испанский, арабский, хинди, тайский, вьетнамский и польский, а также для 22 китайских диалектов — всего 52 языка и диалекта. Обе модели поддерживают потоковую и офлайновую обработку, работают с длинными аудиозаписями, а среди поддерживаемых типов аудио в карточках указаны пение и песни с фоновой музыкой.
Qwen3-ForcedAligner-0.6B добавляет принудительное выравнивание: получив аудио и расшифровку, модель отмечает время начала и конца каждого слова с точностью до миллисекунды для 11 языков и фрагментов длиной до пяти минут. Это позволяет создавать расшифровки с переходом по клику, синхронизировать субтитры и переходить к моменту, когда прозвучало нужное слово. Публикация выравнивателя вместе с распознавателем делает это семейство полезным для создания продуктов транскрибации, а не только для запуска демо.
В карточках Qwen приведены результаты Hugging Face Open ASR Leaderboard от 26 июня 2026 года: средняя доля ошибочных слов составляет 5,59 % у модели 1.7B и 6,31 % у 0.6B; для поднабора записей встреч AMI показатели равны 9,26 % и 10,57 %. Чем ниже доля ошибочных слов, тем меньше ошибок в распознанном тексте. Qwen называет модель 1.7B передовой среди открытых ASR-моделей и конкурентоспособной с коммерческими API; это результаты, опубликованные поставщиком. В независимом рейтинге ниже используется другое аудио, поэтому напрямую сравнивать оценки нельзя.
Всё начал Whisper — и его же до сих пор запускают все
Ничего этого в нынешнем виде не было бы без Whisper от OpenAI. Репозиторий открыли 16 сентября 2022 года под лицензией MIT — код и веса вместе — в момент, когда серьёзное распознавание речи означало договор с облачным провайдером. С тех пор он набрал 106 679 звёзд на GitHub.
Важным Whisper сделал не столько сам модельный файл, сколько то, что сообщество надстроило поверх за считаные месяцы. whisper.cpp переписал его на чистом C и C++, лицензия MIT, 52 591 звезда, и заставил работать на ноутбуках и телефонах без Python и без GPU. faster-whisper пересобрал его на CTranslate2 с большим выигрышем по скорости и памяти, снова MIT, 24 750 звёзд. Модель была семенем; деревом стала экосистема.
Четыре года спустя Whisper по-прежнему широко используется. За 30 дней до 5 августа 2026 года модель whisper-large-v3-turbo скачали с Hugging Face 8,72 миллиона раз, а whisper-large-v3 — 5,50 миллиона; Qwen3-ASR-0.6B скачали 4,29 миллиона раз. В рейтинге Artificial Analysis Whisper Large v3 набрал 4,07 % AA-WER против 1,73 % у лидера в том снимке рейтинга.

Открытый речевой слой пришёл двумя волнами с разрывом в три года, между которыми почти ничего. Даты публикации по GitHub и Hugging Face, снято 5 августа 2026 года.
Открытая сторона — это не одна лаборатория
Qwen не одинока, и остальные хороши в заметно разном.
Линейка Parakeet от NVIDIA ориентирована на скорость. parakeet-tdt-0.6b-v3, выпущенная в августе 2025 года под CC BY 4.0, содержит 600 миллионов параметров, поддерживает 25 европейских языков, автоматическое определение языка, пунктуацию, заглавные буквы и пословные метки времени; за один проход обрабатывает до 24 минут аудио. Семейство Canary от NVIDIA — canary-1b-v2 и canary-qwen-2.5b, также под CC BY 4.0 — предлагает схожие возможности. Модели Voxtral от Mistral, выпущенные в июле 2025 года под Apache 2.0, находятся среди лидеров независимого сравнения ниже.
Вот открытая сторона рядом друг с другом; в последней строке для контраста — размещённый API.
| Модель | Загрузка | Лицензия | Языки | Где работает | Сильна в |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 ГБ | MIT | 99 | Ноутбук или одна GPU | Значение по умолчанию, которое уже все поддерживают |
| Qwen3-ASR-0.6B | 1,56 ГБ | Apache 2.0 | 52 с диалектами | Ноутбук | Многоязычность при наименьшем размере |
| Qwen3-ASR-1.7B | 4,08 ГБ | Apache 2.0 | 52 с диалектами | Ноутбук или одна GPU | Лучшая точность в семействе Qwen |
| Parakeet TDT 0.6B v3 | 2,51 ГБ | CC BY 4.0 | 25 европейских | Ноутбук или одна GPU | Скорость и пословные метки времени |
| Voxtral Small | — | Apache 2.0 | — | Серверная GPU, 24 млрд параметров | Лучший открытый результат в независимом рейтинге |
| Размещённый API | Скачать нельзя | Проприетарная | По-разному | Облако поставщика | Разделение говорящих, потоковая передача, доступность |
Размер загрузки указан для контрольной точки по умолчанию в каждом репозитории Hugging Face. «—» означает, что в использованных для сравнения материалах это значение не приводилось. Снимок от 5 августа 2026 года.
Дальше идёт работа по упаковке, которая доводит эти модели до реальных устройств, — точка, где ноутбучный класс перестаёт быть теорией. whisperkit-coreml, то есть Whisper, скомпилированный под железо Apple, за последние 30 дней скачали 8,31 миллиона раз. Сборка Parakeet под Apple Silicon на MLX набрала 1,87 миллиона, а две конверсии в GGUF — квантованный формат, позволяющий запускать модели на обычных процессорах, — 2,04 и 1,87 миллиона. Миллионы людей ежемесячно скачивают распознавание речи, упакованное специально для запуска на собственной машине. Это не исследовательская диковинка. Это канал дистрибуции.
Первое место — по-прежнему предварительная точка доступа, которую не скачать
Сравнение позволяет отдельно оценить точность распознавания и практические преимущества самостоятельного запуска модели.
В рейтинге речи-в-текст Artificial Analysis, полученном 5 августа 2026 года, открытые и закрытые модели оцениваются на одном и том же аудио. Среди результатов AA-WER v2:
| Место | Модель | AA-WER | Можно скачать? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | Нет — предварительная точка доступа |
| 2 | Scribe v2, ElevenLabs | 2,18 % | Нет — размещённый API |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | Нет — размещённый API |
| 4 | Smallest AI Pulse Pro | 2,43 % | Нет — размещённый API |
| 5 | Voxtral Small, Mistral | 2,77 % | Да — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | Нет — размещённый API |
| 11 | Whisper Large v3 | 4,07 % | Да — MIT |
Источник: рейтинг речь-в-текст Artificial Analysis, AA-WER v2, снят 5 августа 2026 года. Доступность для скачивания определена по опубликованной лицензии каждой модели.
Первые четыре строки показывают, что в этом снимке рейтинга лидируют размещённые модели, а первая из них доступна как предварительная версия, а не как скачиваемая модель.
Voxtral Small выпущена под Apache 2.0 и занимает пятое место с показателем 2,77 % — примерно на один процентный пункт хуже закрытой предварительной модели-лидера. Для часовой встречи на 6300 слов эта разница составляет около 66 слов. Разрыв реален, но для команд, которым важен локальный запуск, он не непреодолим.
Для многих задач открытые речевые модели уже пригодны к работе. Теперь выбор сводится к тому, стоит ли умеренный разрыв в точности контроля, который даёт самостоятельный запуск, или дополнительные функции размещённого сервиса оправдывают его стоимость.
Что даёт запуск у себя и чего он стоит
К собственному хостингу команды толкают три вещи, и точность не входит ни в одну из них.
Первое — приватность, и обычно она решающая. Если вы расшифровываете врачебные приёмы, юридические интервью или кадровые беседы, «звук не покидает наше железо» — не предпочтение, а требование закупки, и только собственная модель выполняет его чисто. Второе — автономная работа: модель на устройстве работает в самолёте, в подвале, в цеху, на объекте без связи. Именно поэтому у whisper.cpp и сборок GGUF такие цифры скачиваний.
Третье — стоимость, и здесь цифры резкие. Из того же среза Artificial Analysis, цена за 1000 минут аудио: Whisper Large v3 на fal.ai — 0,50 доллара, Canary Qwen 2.5B от NVIDIA на Replicate — 0,74, Parakeet TDT 0.6B V3 на Together AI — 1,50. На закрытой стороне: Nova-3 от Deepgram — 4,30, MAI-Transcribe-1.5 — 6,00, Gemini 3.1 Pro Preview — 18,15. Это четырёхкратный разрыв с Microsoft и двенадцатикратный с Google — и это лишь за размещение открытой модели на чужих серверах, до того как рассматривать запуск на своих, где предельная стоимость тысячного часа равна электричеству.
Показатели скорости в том же снимке рейтинга выше всего у Parakeet TDT 0.6B V3, размещённого на Together AI: 885-кратная скорость относительно реального времени — около четырёх секунд на обработку часа аудио. Nova-3 от Deepgram достигает 512x, Whisper Large v3 на Together — 478x, а MAI-Transcribe-1.5 — 189x. Самый быстрый вариант в списке — модель с открытыми весами, но здесь измеряется работа Together AI, а не локального оборудования.

Выбор никогда не стоял между точностью и точностью. Он стоит между контролем и стоимостью с одной стороны и функциями вокруг распознавания с другой.
Так что же тогда продают размещённые API? Всё, что не является распознаванием. Документация Deepgram — честная опись: разделение по говорящим, потоковая передача в реальном времени, форматирование, пользовательский словарь, маскирование сущностей, определение языка и эксплуатационная гарантия, что сервис жив, пока вы спите. Скачайте Qwen3-ASR — получите слова и метки времени. Никаких меток говорящих, никакого SLA, а счёт за GPU, масштабирование и звонок в три часа ночи — ваши.
Самая скачиваемая модель категории вовсе не транскрибирует
Статистика загрузок также показывает спрос на определение говорящих наряду с транскрибацией.
Если отсортировать всю категорию автоматического распознавания речи на Hugging Face по скачиваниям, наверху окажется не Whisper, не Qwen и не Parakeet. Это pyannote/speaker-diarization-3.1 с 8,91 миллиона скачиваний за последние 30 дней, а вторая модель разделения по говорящим от pyannote занимает пятое место с 5,26 миллиона. Разделение по говорящим — это механика, определяющая, кто и когда говорил, то есть слой прямо над транскрибацией.

Открытые веса теперь покрывают два нижних слоя. Слои, которые решают, полезна ли заметка, лежат выше.
Самая скачиваемая модель в категории распознавания речи сама речь не распознаёт: она определяет, кто и когда говорил. Этот спрос указывает на слой над транскрибацией, где метки говорящих помогают превратить распознанные слова в полезную запись встречи. Это перекликается с пробелом в продукте, описанным в нашем анализе закрытого рынка.
Итог
Интересный вопрос об открытом распознавании речи никогда не звучал как «не хуже ли оно закрытых моделей». Оно примерно в одном процентном пункте по ошибкам, оно быстрее, оно в четыре-двенадцать раз дешевле и помещается на ноутбуке. Интересный вопрос в том, что вы построите в пространстве, которое открывается, когда транскрибация перестаёт быть арендованной статьёй расходов, — потому что файл на 1,56 ГБ, слышащий 52 языка, не продукт. Это деталь, которая только что стала бесплатной.
Для команды, выбирающей инструмент для заметок со встреч, а не модель, практический вывод короток. Работает продукт на открытой модели или на закрытом API — сегодня это по большей части деталь реализации, и всё чаще будет и то и другое: открытые веса для массовой работы, размещённые API там, где разделение по говорящим, потоковая передача и масштаб оправдывают цену. Telli.sh уже использует открытую модель в слое резюмирования, поэтому улучшения на открытой стороне попадают прямиком в транскрибацию, перевод и заметки со встреч без изменения цены. Судите об инструменте по тому, что выходит в конце: говорит ли заметка, кто и что взял на себя.
Источники
- Карточка модели Qwen3-ASR-0.6B-hf (Hugging Face) — лицензия, список языков, показатели рейтинга на 26 июня 2026 года
- Карточка модели Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (подан 29 января 2026 года)
- Репозиторий OpenAI Whisper (MIT, опубликован 16 сентября 2022 года)
- whisper.cpp и faster-whisper
- Карточка модели NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Рейтинг речь-в-текст Artificial Analysis — AA-WER v2, данные по скорости и цене сняты 5 августа 2026 года
- Hugging Face Open ASR Leaderboard
- Документация Deepgram по разделению говорящих
- Страница изображения на Wikimedia Commons
