O reconhecimento de fala virou open weight em silêncio — e cabe em 1,56 GB
Os modelos Qwen3-ASR da Alibaba são Apache 2.0, cobrem 52 idiomas e dialetos e ocupam menos de dois gigabytes. Um guia em linguagem simples da camada de transcrição open weight: o que existe, o que rodar um modelo no seu próprio notebook realmente entrega e onde as APIs fechadas continuam vencendo.
Agora você pode rodar reconhecimento de fala com pesos abertos num notebook: a equipe Qwen, da Alibaba, publica Qwen3-ASR-0.6B, Qwen3-ASR-1.7B e o complemento Qwen3-ForcedAligner-0.6B sob Apache 2.0. O menor download tem 1,56 GB, oferece suporte a 52 idiomas e dialetos e, desde 26 de junho, pode rodar com três linhas de Python padrão. Executá-lo na sua própria máquina evita pagar por cada solicitação de transcrição.
Essa mudança será familiar a quem acompanhou os modelos de linguagem abertos: hospedar por conta própria dá mais controle sobre custo, privacidade e uso offline, enquanto APIs hospedadas são mais fáceis de operar. O reconhecimento de fala está desenvolvendo a mesma opção, com modelos pequenos o bastante para rodar localmente.
Este guia explica o que o reconhecimento de fala com pesos abertos faz, como os modelos disponíveis e suas licenças diferem, o que um modelo pequeno consegue executar e onde as APIs hospedadas ainda levam vantagem.
TL;DR:
- Transcrição open weight já é utilizável hoje: Qwen3-ASR sob Apache 2.0 com 52 idiomas e dialetos, Whisper sob MIT, Parakeet e Canary da NVIDIA sob CC BY 4.0, Voxtral da Mistral sob Apache 2.0.
- Hospedar por conta própria traz privacidade, operação offline e controle de custo. No ranking independente da Artificial Analysis, hospedar um modelo aberto sai por 1,50 dólar a cada 1.000 minutos, contra 6,00 do MAI-Transcribe-1.5 da Microsoft e 18,15 do Gemini 3.1 Pro Preview.
- O primeiro lugar em precisão ainda é um endpoint fechado em prévia. Mas um modelo aberto sob Apache 2.0, o Voxtral Small, já ocupa o quinto lugar, a cerca de um ponto de taxa de erro de palavra.
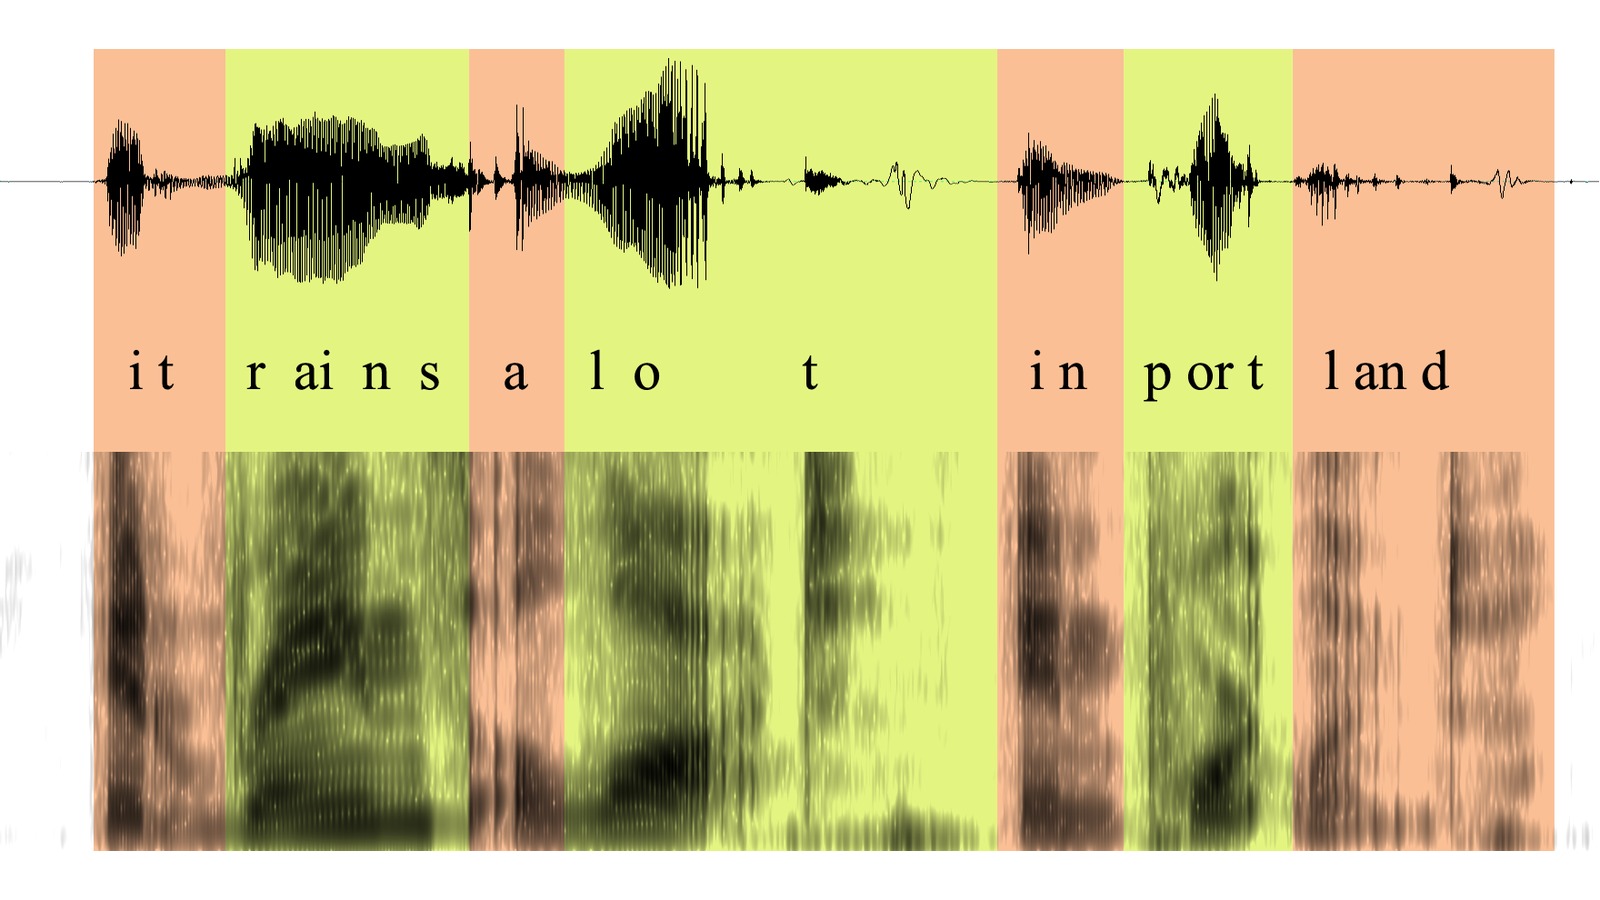
Imagem: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Forma de onda e espectrograma da frase «it rains a lot in Portland», com as letras posicionadas sobre o áudio a que correspondem — é exatamente essa a matéria-prima com que todo modelo de reconhecimento de fala trabalha.
O que você baixa de fato quando baixa um transcritor
Um modelo ASR — reconhecimento automático de fala, usado como sinônimo de STT, fala para texto — é um programa que recebe áudio e devolve texto. O trabalho é esse. Ele não decide quem falou, não resume, não sabe do que tratava a sua reunião. Ele ouve palavras e as escreve.
«Open weights» significa que o laboratório publicou o próprio arquivo do modelo pronto. Os pesos de um modelo são a enorme grade de números que ele aprendeu durante o treinamento, e publicá-los significa que você baixa esse arquivo, roda no seu próprio hardware e constrói em cima sem pedir permissão nem pagar por requisição. A alternativa é um modelo fechado: os pesos ficam nos servidores do fornecedor e você aluga o acesso por uma API — o áudio sobe, o texto volta, e a cobrança é por minuto.
O número no nome é a contagem de parâmetros e, em modelos de fala, ele é incomumente concreto. «0.6B» quer dizer cerca de 600 milhões de parâmetros, o que na prática faz do Qwen3-ASR-0.6B um arquivo de 1,56 GB e do Qwen3-ASR-1.7B um de 4,08 GB: ambos pequenos o bastante para viver no SSD de um notebook sem que ninguém perceba. Compare com os modelos de linguagem abertos que cobrimos no nosso apanhado sobre a China, em que o lançamento principal tinha 1,56 terabyte em 96 fragmentos e exigia um cluster só para carregar. Modelos de fala são cerca de mil vezes menores que os modelos de texto de fronteira, e esse único fato explica por que essa virada bate mais forte aqui do que lá.
Vamos chamar essa faixa de tamanho de faixa de notebook: modelos pequenos o bastante para que testá-los exija um download, não uma decisão de orçamento de hardware. A maioria dos modelos de texto de ponta fica de fora; muitos modelos de fala cabem nela.
Confira a licença antes de adotar um modelo. Apache 2.0 e MIT permitem uso, modificação e distribuição comercial; CC BY 4.0, usada nos modelos da NVIDIA, também permite uso comercial, mas exige atribuição.
A Qwen lançou a família em janeiro; em junho é que ficou fácil
O Qwen3-ASR apareceu pela primeira vez em 28 de janeiro de 2026, e o relatório técnico saiu no arXiv no dia seguinte. Em 26 de junho, a Qwen publicou versões -hf dos três modelos, compatíveis com o Hugging Face Transformers a partir da versão 5.13.0.
A mudança de empacotamento deixa a configuração mais familiar: em vez de instalar o pacote qwen-asr da Qwen ou um backend vLLM, quem usa Transformers pode carregar os checkpoints -hf com Python padrão. Isso reduz o custo de configuração sem mudar o que o modelo reconhece.
Os cartões dos modelos listam identificação de idioma e reconhecimento em 30 idiomas — incluindo inglês, chinês, coreano, japonês, espanhol, árabe, híndi, tailandês, vietnamita e polonês — além de 22 dialetos chineses, totalizando 52 idiomas e dialetos. Os dois tamanhos aceitam inferência em streaming e offline com um único modelo, áudio longo e incluem canto e músicas com trilha de fundo entre os tipos de áudio compatíveis.
O Qwen3-ForcedAligner-0.6B acrescenta alinhamento forçado: recebe áudio e transcrição e marca o início e o fim de cada palavra com precisão de milissegundos em 11 idiomas, em trechos de até cinco minutos. Isso permite criar transcrições clicáveis, sincronizar legendas e saltar para o instante em que uma palavra foi dita. Publicar um alinhador junto com o reconhecedor torna a família útil para construir produtos de transcrição, não só para rodar uma demonstração.
Os cartões da Qwen informam resultados do Hugging Face Open ASR Leaderboard, datados de 26 de junho de 2026: taxa média de erro de palavra de 5,59 % para o modelo 1.7B e de 6,31 % para o 0.6B; no subconjunto de áudio de reuniões AMI, os valores são 9,26 % e 10,57 %. Uma taxa menor significa menos palavras erradas. A Qwen descreve o modelo 1.7B como de ponta entre os modelos ASR abertos e competitivo com APIs comerciais; são resultados informados pelo fornecedor. O ranking independente abaixo usa outro áudio, portanto as pontuações não são diretamente comparáveis.
Foi o Whisper que começou isso, e ainda é o modelo que todo mundo roda
Nada disso existiria nesse formato sem o Whisper, da OpenAI. O repositório foi aberto em 16 de setembro de 2022 sob licença MIT — código e pesos juntos — num momento em que reconhecimento de fala sério significava contrato com um provedor de nuvem. De lá para cá, acumulou 106.679 estrelas no GitHub.
O que tornou o Whisper importante foi menos o modelo do que aquilo que a comunidade construiu em cima dele em poucos meses. O whisper.cpp o reimplementou em C e C++ puros, licença MIT, 52.591 estrelas, e o fez rodar em notebooks e celulares sem Python e sem GPU. O faster-whisper o reconstruiu sobre CTranslate2 com grande ganho de velocidade e memória, MIT também, 24.750 estrelas. O modelo era a semente; o ecossistema, a árvore.
Quatro anos depois, o Whisper continua amplamente usado. Nos 30 dias anteriores a 5 de agosto de 2026, o whisper-large-v3-turbo foi baixado 8,72 milhões de vezes do Hugging Face e o whisper-large-v3, 5,50 milhões; o Qwen3-ASR-0.6B chegou a 4,29 milhões. No ranking da Artificial Analysis, o Whisper Large v3 marca AA-WER de 4,07 %, contra 1,73 % do líder naquela fotografia.

A camada de fala aberta chegou em duas ondas separadas por três anos, com quase nada no meio. Datas de lançamento do GitHub e do Hugging Face, consultadas em 5 de agosto de 2026.
O lado aberto é mais do que um laboratório
A Qwen não está sozinha, e os outros são bons em coisas bem diferentes.
A linha Parakeet da NVIDIA prioriza velocidade. O parakeet-tdt-0.6b-v3, lançado em agosto de 2025 sob CC BY 4.0, tem 600 milhões de parâmetros, cobre 25 idiomas europeus e oferece detecção automática de idioma, pontuação, uso de maiúsculas e marcações de tempo por palavra para áudios de até 24 minutos por execução. A família Canary da NVIDIA — canary-1b-v2 e canary-qwen-2.5b, também sob CC BY 4.0 — oferece recursos semelhantes. Os modelos Voxtral da Mistral, lançados em julho de 2025 sob Apache 2.0, estão entre os primeiros na comparação independente abaixo.
Eis o lado aberto lado a lado, com uma API hospedada na última linha para contraste.
| Modelo | Download | Licença | Idiomas | Roda em | Melhor em |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 GB | MIT | 99 | Notebook ou uma GPU | Ser o padrão que tudo já suporta |
| Qwen3-ASR-0.6B | 1,56 GB | Apache 2.0 | 52 com dialetos | Notebook | Multilíngue no menor tamanho |
| Qwen3-ASR-1.7B | 4,08 GB | Apache 2.0 | 52 com dialetos | Notebook ou uma GPU | Melhor precisão da família Qwen |
| Parakeet TDT 0.6B v3 | 2,51 GB | CC BY 4.0 | 25 europeus | Notebook ou uma GPU | Velocidade e marcações de tempo por palavra |
| Voxtral Small | — | Apache 2.0 | — | GPU de servidor, 24 bilhões de parâmetros | Maior pontuação aberta no ranking independente |
| API hospedada | Não baixável | Proprietária | Varia | A nuvem do fornecedor | Diarização, streaming, disponibilidade |
O tamanho do download é o checkpoint padrão de cada repositório no Hugging Face. "—" indica que o material usado nesta comparação não informa o valor. Fotografia consultada em 5 de agosto de 2026.
Depois vem o trabalho de empacotamento que leva esses modelos a aparelhos reais, o ponto em que a faixa notebook deixa de ser teórica. O whisperkit-coreml — Whisper compilado para hardware da Apple — foi baixado 8,31 milhões de vezes nos últimos 30 dias. Uma build MLX do Parakeet para Apple Silicon somou 1,87 milhão, e duas conversões GGUF — o formato quantizado que roda modelos em CPUs comuns — 2,04 e 1,87 milhão. Milhões de pessoas por mês baixam reconhecimento de fala empacotado especificamente para rodar na própria máquina. Isso não é curiosidade de pesquisa. É canal de distribuição.
O primeiro lugar ainda é um endpoint em prévia que você não pode baixar
A comparação separa a precisão do reconhecimento das vantagens operacionais de rodar um modelo por conta própria.
A classificação de fala para texto da Artificial Analysis, consultada em 5 de agosto de 2026, mede modelos abertos e fechados no mesmo áudio. Os resultados AA-WER v2 incluem:
| Posição | Modelo | AA-WER | Dá para baixar? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | Não — endpoint em prévia |
| 2 | Scribe v2, ElevenLabs | 2,18 % | Não — API hospedada |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | Não — API hospedada |
| 4 | Smallest AI Pulse Pro | 2,43 % | Não — API hospedada |
| 5 | Voxtral Small, Mistral | 2,77 % | Sim — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | Não — API hospedada |
| 11 | Whisper Large v3 | 4,07 % | Sim — MIT |
Fonte: ranking de fala para texto da Artificial Analysis, AA-WER v2, consultado em 5 de agosto de 2026. A possibilidade de download foi avaliada pela licença publicada de cada modelo.
As quatro primeiras linhas mostram que os modelos mais bem pontuados nesta fotografia são hospedados e que o líder é um endpoint em prévia, não um modelo baixável.
O Voxtral Small usa Apache 2.0 e ocupa o quinto lugar, com 2,77 %, cerca de um ponto percentual atrás do modelo fechado em prévia que lidera. Numa reunião de uma hora com 6.300 palavras, essa diferença equivale a cerca de 66 palavras. É uma diferença real, mas não intransponível para equipes que valorizam a execução local.
Para muitas tarefas, os modelos de fala abertos já são utilizáveis; a decisão restante é se uma diferença modesta de precisão compensa o controle da hospedagem própria ou se os recursos adicionais de um serviço hospedado justificam o custo.
O que rodar por conta própria entrega e o que custa
Três coisas empurram equipes para a auto-hospedagem, e nenhuma delas é precisão.
Privacidade é a primeira e costuma ser a decisiva. Se você transcreve consultas médicas, entrevistas jurídicas ou conversas de RH, «o áudio não sai do nosso hardware» não é preferência, é requisito de compra, e um modelo hospedado por você é a única arquitetura que atende isso de forma limpa. Operação offline é a segunda: um modelo no aparelho funciona no avião, no subsolo, no chão de fábrica, num campo sem sinal. É exatamente por isso que o whisper.cpp e as builds GGUF têm os números de download que têm.
Custo é a terceira, e aqui os números são crus. Da mesma fotografia da Artificial Analysis, preço por 1.000 minutos de áudio: Whisper Large v3 hospedado no fal.ai sai por 0,50 dólar, o Canary Qwen 2.5B da NVIDIA no Replicate por 0,74 e o Parakeet TDT 0.6B V3 no Together AI por 1,50. Do lado fechado, o Nova-3 da Deepgram está em 4,30, o MAI-Transcribe-1.5 em 6,00 e o Gemini 3.1 Pro Preview em 18,15. É um fator de 4 contra a Microsoft e de 12 contra o Google só para hospedar um modelo aberto em servidor alheio — antes de considerar rodar no seu, onde o custo marginal da milésima hora é eletricidade.
Os dados de velocidade da mesma fotografia favorecem o Parakeet TDT 0.6B V3 servido no Together AI, a 885 vezes o tempo real — processa uma hora de áudio em cerca de quatro segundos. O Nova-3 da Deepgram chega a 512x, o Whisper Large v3 no Together a 478x e o MAI-Transcribe-1.5 a 189x. A opção mais rápida listada é um modelo de pesos abertos, embora esse resultado meça o serviço do Together AI, não a execução em hardware local.

A troca nunca foi precisão contra precisão. É controle e custo contra as funções embrulhadas em volta do reconhecimento.
Então o que as APIs hospedadas ainda vendem? Tudo o que não é reconhecimento. A documentação da Deepgram é um inventário justo: diarização de falantes, streaming em tempo real, formatação, vocabulário personalizado, mascaramento de entidades, detecção de idioma e a garantia operacional de que continua de pé enquanto você dorme. Baixe o Qwen3-ASR e você recebe palavras e marcações de tempo. Sem rótulos de falante, sem SLA, e são seus a conta de GPU, o escalonamento e o chamado das três da manhã.
O modelo mais baixado da categoria não é um transcritor
Os padrões de download também mostram demanda por identificação de falantes além da transcrição.
Quando você ordena por downloads a categoria inteira de reconhecimento automático de fala do Hugging Face, o modelo no topo não é o Whisper, nem a Qwen, nem o Parakeet. É o pyannote/speaker-diarization-3.1, com 8,91 milhões de downloads nos últimos 30 dias, e um segundo modelo de diarização da pyannote fica em quinto com 5,26 milhões. Diarização é a engrenagem que descobre quem falou e quando — a camada logo acima da transcrição.

Os pesos abertos já cobrem as duas primeiras camadas da pilha. As que decidem se uma nota serve ficam acima delas.
O modelo mais baixado da categoria de reconhecimento de fala não reconhece o que foi dito: identifica quem falou e quando. Essa demanda aponta para a camada acima da transcrição, em que rótulos de falante ajudam a transformar palavras reconhecidas num registro útil de reunião. Isso ecoa a lacuna de produto descrita na nossa análise do mercado fechado.
Conclusão
A pergunta interessante sobre reconhecimento de fala open weight nunca foi «ele é tão bom quanto os modelos fechados». Ele está a cerca de um ponto de taxa de erro de palavra, é mais rápido, custa de quatro a doze vezes menos e cabe num notebook. A pergunta interessante é o que você constrói no espaço que se abre quando a transcrição deixa de ser uma linha de custo alugada — porque um arquivo de 1,56 GB que ouve 52 idiomas não é um produto. É uma peça que acabou de ficar de graça.
Para um time escolhendo uma ferramenta de notas de reunião, e não um modelo, a leitura prática é curta. Se um produto roda um modelo aberto ou uma API fechada hoje é, em grande medida, detalhe de implementação, e cada vez mais será os dois: pesos abertos para o volume, APIs hospedadas onde diarização, streaming e escala justificam o preço. A Telli.sh já roda um modelo aberto na camada de resumo, então os avanços do lado aberto chegam direto à transcrição, à tradução e às notas de reunião sem mudança de preço. Julgue a ferramenta pelo que sai no fim: se a nota diz quem se comprometeu com o quê.
Começar uma nota de IA ao vivo
Fontes
- Cartão do modelo Qwen3-ASR-0.6B-hf (Hugging Face) — licença, lista de idiomas, números de ranking datados de 26 de junho de 2026
- Cartão do modelo Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (submetido em 29 de janeiro de 2026)
- Repositório OpenAI Whisper (MIT, publicado em 16 de setembro de 2022)
- whisper.cpp e faster-whisper
- Cartão do modelo NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Ranking de fala para texto da Artificial Analysis — AA-WER v2, números de velocidade e preço consultados em 5 de agosto de 2026
- Hugging Face Open ASR Leaderboard
- Documentação da Deepgram sobre diarização
- Página da imagem no Wikimedia Commons
