La reconnaissance vocale est passée en open weight sans bruit — et tient dans 1,56 Go
Les modèles Qwen3-ASR d'Alibaba sont sous licence Apache 2.0, couvrent 52 langues et dialectes et pèsent moins de deux gigaoctets. Un guide en langage clair de la couche de transcription open weight : ce qui existe, ce qu'un modèle sur votre propre ordinateur vous apporte réellement, et là où les API fermées gardent l'avantage.
Vous pouvez désormais faire tourner de la reconnaissance vocale open weight sur un portable : l'équipe Qwen d'Alibaba publie Qwen3-ASR-0.6B, Qwen3-ASR-1.7B et le modèle compagnon Qwen3-ForcedAligner-0.6B sous Apache 2.0. Le téléchargement le plus petit pèse 1,56 Go, prend en charge 52 langues et dialectes et, depuis le 26 juin, s'exécute en trois lignes de Python standard. L'exécuter sur votre propre machine évite une facture de transcription à chaque requête.
Ce changement semblera familier à ceux qui ont suivi les modèles de langage ouverts : l'auto-hébergement offre davantage de contrôle sur les coûts, la confidentialité et l'usage hors ligne, tandis que les API hébergées sont plus simples à exploiter. La reconnaissance vocale propose désormais le même choix, avec des modèles assez petits pour fonctionner localement.
Ce guide explique ce que fait la reconnaissance vocale open weight, en quoi les modèles et licences disponibles diffèrent, sur quel matériel un petit modèle peut tourner et où les API hébergées gardent un avantage.
TL;DR:
- La transcription open weight est utilisable dès maintenant : Qwen3-ASR sous Apache 2.0 avec 52 langues et dialectes, Whisper sous MIT, Parakeet et Canary de NVIDIA sous CC BY 4.0, Voxtral de Mistral sous Apache 2.0.
- L'auto-hébergement apporte confidentialité, fonctionnement hors ligne et maîtrise des coûts. Sur le classement indépendant d'Artificial Analysis, héberger un modèle ouvert revient à 1,50 dollar pour 1 000 minutes, contre 6,00 pour MAI-Transcribe-1.5 de Microsoft et 18,15 pour Gemini 3.1 Pro Preview.
- La première place en précision reste un point de terminaison fermé en préversion. Mais un modèle ouvert sous Apache 2.0, Voxtral Small, occupe désormais la cinquième place, à environ un point de taux d'erreur de mots derrière.
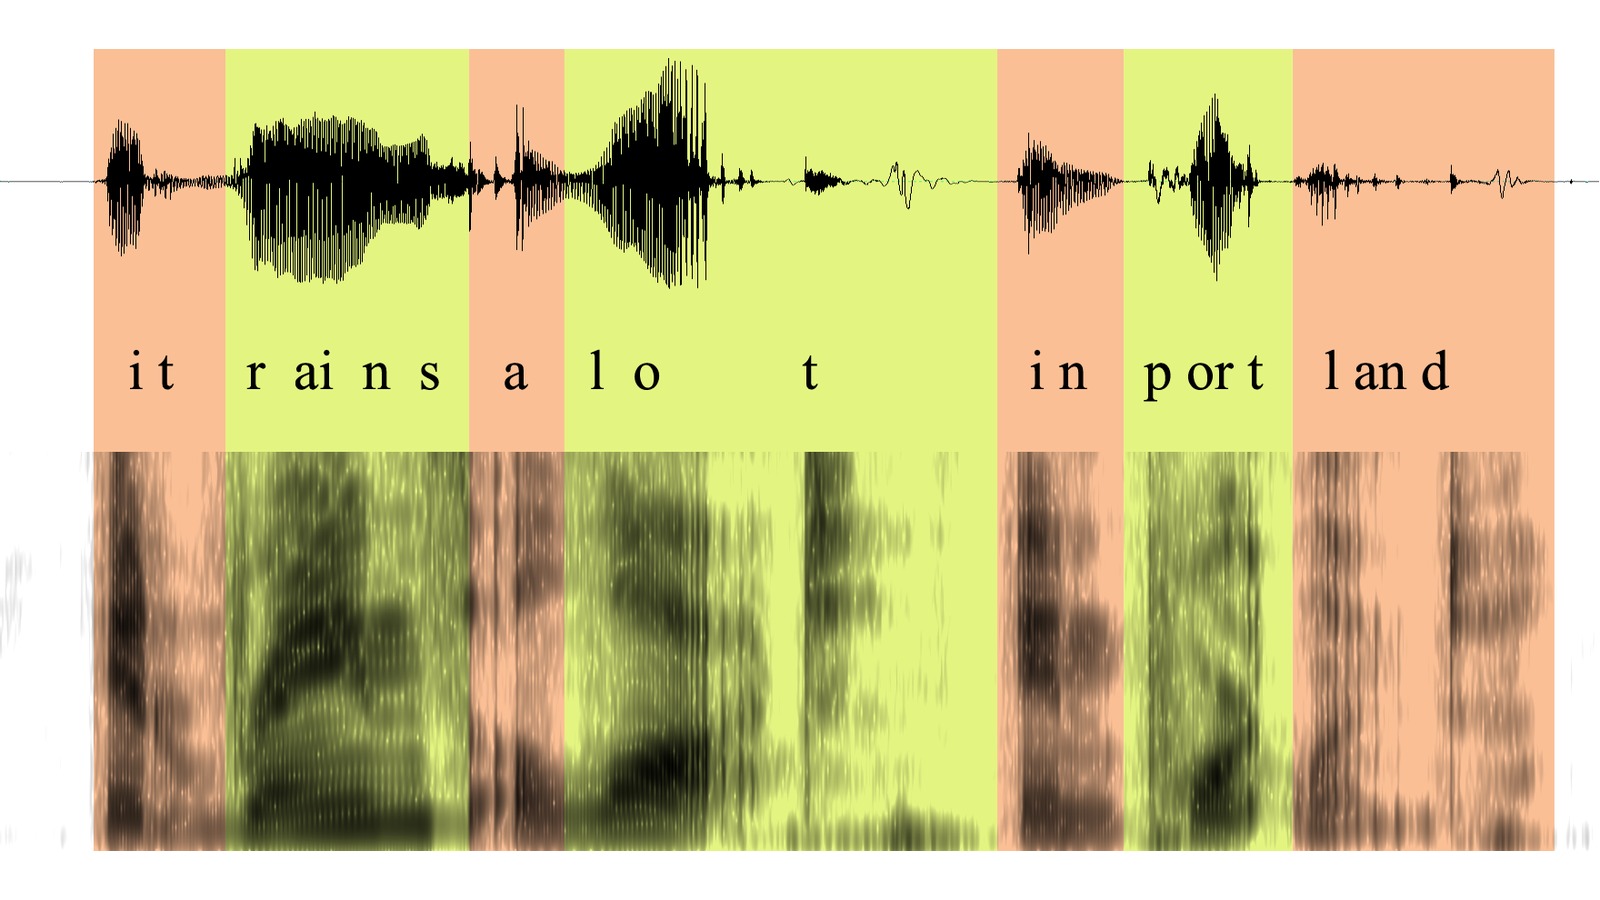
Image : Aaron Parecki, Wikimedia Commons, CC BY 2.0. Forme d'onde et spectrogramme de la phrase « it rains a lot in Portland », les lettres étant placées au-dessus de l'audio auquel elles correspondent — c'est exactement la matière première que traite tout modèle de reconnaissance vocale.
Ce que vous téléchargez vraiment quand vous téléchargez un modèle de transcription
Un modèle ASR — reconnaissance automatique de la parole, synonyme de STT, de la parole vers le texte — est un programme qui prend de l'audio en entrée et produit du texte en sortie. C'est toute sa mission. Il ne décide pas qui a parlé, ne résume pas, ne sait pas de quoi parlait votre réunion. Il entend des mots et les écrit.
« Open weights » signifie que le laboratoire a publié le fichier du modèle fini lui-même. Les poids d'un modèle sont l'immense grille de nombres qu'il a apprise pendant l'entraînement, et les publier signifie que vous téléchargez ce fichier, l'exécutez sur votre propre matériel et construisez dessus sans demander la permission ni payer à la requête. L'alternative est un modèle fermé : les poids restent sur les serveurs du fournisseur et vous louez l'accès via une API — l'audio monte, le texte redescend, et la facturation se fait à la minute.
Le nombre dans le nom est le compte de paramètres, et pour les modèles vocaux il est inhabituellement concret. « 0.6B » veut dire environ 600 millions de paramètres, ce qui donne en pratique un fichier de 1,56 Go pour Qwen3-ASR-0.6B et de 4,08 Go pour Qwen3-ASR-1.7B — tous deux assez petits pour tenir sur le SSD d'un portable sans que personne ne le remarque. Comparez avec les modèles de langage ouverts évoqués dans notre tour d'horizon chinois, où la sortie vedette pesait 1,56 téraoctet réparti sur 96 fragments et exigeait un cluster rien que pour être chargée. Les modèles vocaux sont environ mille fois plus petits que les modèles de texte de pointe, et ce seul fait explique pourquoi ce basculement frappe plus fort ici que là-bas.
Appelons cette gamme de tailles le palier portable : des modèles assez petits pour que les essayer relève du téléchargement, et non d'une décision de budget matériel. La plupart des modèles de texte de pointe n'en font pas partie ; beaucoup de modèles vocaux, si.
Vérifiez la licence avant d'adopter un modèle. Apache 2.0 et MIT autorisent l'utilisation, la modification et la distribution commerciale. CC BY 4.0, utilisée pour les modèles NVIDIA, permet également un usage commercial, mais exige une attribution.
Qwen a publié la famille en janvier ; c'est en juin qu'elle est devenue simple
Qwen3-ASR est apparu le 28 janvier 2026, et son rapport technique a suivi sur arXiv le lendemain. Le 26 juin, Qwen a publié les versions -hf des trois modèles, compatibles avec Hugging Face Transformers à partir de la version 5.13.0.
Ce changement de packaging simplifie la mise en route : au lieu d'installer le paquet qwen-asr de Qwen ou un back-end vLLM, les développeurs qui utilisent Transformers peuvent charger les points de contrôle -hf avec du Python standard. La mise en place est plus légère, sans modifier les capacités de reconnaissance du modèle.
Les fiches de modèle indiquent l'identification de la langue et la reconnaissance vocale dans 30 langues — dont l'anglais, le chinois, le coréen, le japonais, l'espagnol, l'arabe, l'hindi, le thaï, le vietnamien et le polonais — ainsi que dans 22 dialectes chinois, soit 52 langues et dialectes au total. Les deux tailles prennent en charge le streaming et l'inférence hors ligne dans un même modèle, acceptent les longues séquences audio et listent le chant ainsi que les chansons avec musique de fond parmi les types audio pris en charge.
Qwen3-ForcedAligner-0.6B ajoute l'alignement forcé : à partir d'un audio et d'une transcription, il repère le début et la fin de chaque mot à la milliseconde près dans 11 langues, pour des extraits allant jusqu'à cinq minutes. Cela permet de créer des transcriptions cliquables, de caler les sous-titres et de revenir à l'instant où un mot a été prononcé. Publier un aligneur avec le moteur de reconnaissance rend cette famille utile à la création de produits de transcription, et pas seulement au lancement d'une démo.
Les fiches de Qwen rapportent les résultats du Hugging Face Open ASR Leaderboard au 26 juin 2026 : le taux d'erreur de mots moyen est de 5,59 % pour le modèle 1.7B et de 6,31 % pour le 0.6B ; sur le sous-ensemble de réunions AMI, les chiffres sont de 9,26 % et 10,57 %. Un taux d'erreur plus faible signifie moins de mots mal reconnus. Qwen présente son modèle 1.7B comme le meilleur parmi les modèles ASR ouverts et comme concurrent des API commerciales ; ce sont des résultats rapportés par le fournisseur. Le classement indépendant ci-dessous utilise un autre audio, ses scores ne sont donc pas directement comparables.
C'est Whisper qui a lancé tout cela, et c'est encore lui que tout le monde exécute
Rien de tout cela n'existerait sous cette forme sans Whisper d'OpenAI. Le dépôt est devenu public le 16 septembre 2022 sous licence MIT — code et poids ensemble — à un moment où la reconnaissance vocale sérieuse signifiait un contrat avec un fournisseur cloud. Il a depuis rassemblé 106 679 étoiles sur GitHub.
Ce qui a rendu Whisper important tient moins au modèle qu'à ce que la communauté a bâti dessus en quelques mois. whisper.cpp l'a réimplémenté en C et C++ purs, sous licence MIT, 52 591 étoiles, et l'a fait tourner sur des portables et des téléphones sans Python ni GPU. faster-whisper l'a reconstruit sur CTranslate2 avec un net gain de vitesse et de mémoire, MIT également, 24 750 étoiles. Le modèle était la graine ; l'écosystème était l'arbre.
Quatre ans plus tard, Whisper reste très utilisé. Au cours des 30 jours précédant le 5 août 2026, whisper-large-v3-turbo a été téléchargé 8,72 millions de fois sur Hugging Face et whisper-large-v3, 5,50 millions ; Qwen3-ASR-0.6B a atteint 4,29 millions de téléchargements. Sur le classement d'Artificial Analysis, Whisper Large v3 obtient un AA-WER de 4,07 %, contre 1,73 % pour le leader de cet instantané.

La couche vocale ouverte est arrivée en deux vagues séparées de trois ans, avec presque rien entre les deux. Dates de publication issues de GitHub et Hugging Face, relevées le 5 août 2026.
Le camp ouvert ne se limite pas à un laboratoire
Qwen n'est pas seul, et les autres sont bons dans des domaines nettement différents.
La gamme Parakeet de NVIDIA mise sur la vitesse. Sorti en août 2025 sous CC BY 4.0, parakeet-tdt-0.6b-v3 compte 600 millions de paramètres, couvre 25 langues européennes et intègre la détection automatique de la langue, la ponctuation, les majuscules et les horodatages au mot ; il traite jusqu'à 24 minutes d'audio par passe. La famille Canary de NVIDIA — canary-1b-v2 et canary-qwen-2.5b, également sous CC BY 4.0 — offre des capacités comparables. Les modèles Voxtral de Mistral, publiés en juillet 2025 sous Apache 2.0, se classent parmi les meilleurs de la comparaison indépendante ci-dessous.
Voici le camp ouvert côte à côte, avec une API hébergée en dernière ligne pour le contraste.
| Modèle | Téléchargement | Licence | Langues | Tourne sur | Meilleur pour |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 Go | MIT | 99 | Portable ou un GPU | Le choix par défaut que tout prend déjà en charge |
| Qwen3-ASR-0.6B | 1,56 Go | Apache 2.0 | 52 avec dialectes | Portable | Le multilingue dans la plus petite taille |
| Qwen3-ASR-1.7B | 4,08 Go | Apache 2.0 | 52 avec dialectes | Portable ou un GPU | La meilleure précision de la famille Qwen |
| Parakeet TDT 0.6B v3 | 2,51 Go | CC BY 4.0 | 25 européennes | Portable ou un GPU | La vitesse et les horodatages au mot |
| Voxtral Small | — | Apache 2.0 | — | GPU serveur, 24 Md de paramètres | Le meilleur score ouvert du classement indépendant |
| API hébergée | Non téléchargeable | Propriétaire | Variable | Le cloud du fournisseur | Diarisation, streaming, disponibilité |
La taille de téléchargement correspond au point de contrôle par défaut de chaque dépôt Hugging Face. « — » signifie que les sources utilisées pour cette comparaison ne fournissaient pas la valeur. Instantané relevé le 5 août 2026.
Vient ensuite le travail d'empaquetage qui met ces modèles sur de vrais appareils, le point où le palier portable cesse d'être théorique. whisperkit-coreml — Whisper compilé pour le matériel Apple — a été téléchargé 8,31 millions de fois sur les 30 derniers jours. Une version MLX de Parakeet pour Apple Silicon en a totalisé 1,87 million, et deux conversions GGUF — ce format quantifié qui fait tourner les modèles sur des processeurs ordinaires — 2,04 et 1,87 million. Des millions de personnes par mois téléchargent de la reconnaissance vocale empaquetée spécifiquement pour tourner sur leur propre machine. Ce n'est pas une curiosité de laboratoire. C'est un canal de distribution.
La première place reste un point de terminaison en préversion que vous ne pouvez pas télécharger
Cette comparaison distingue la précision de reconnaissance des avantages opérationnels liés à l'exécution d'un modèle chez soi.
Le classement speech-to-text d'Artificial Analysis, consulté le 5 août 2026, mesure les modèles ouverts et fermés sur le même audio. Ses résultats AA-WER v2 comprennent :
| Rang | Modèle | AA-WER | Téléchargeable ? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | Non — point de terminaison en préversion |
| 2 | Scribe v2, ElevenLabs | 2,18 % | Non — API hébergée |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | Non — API hébergée |
| 4 | Smallest AI Pulse Pro | 2,43 % | Non — API hébergée |
| 5 | Voxtral Small, Mistral | 2,77 % | Oui — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | Non — API hébergée |
| 11 | Whisper Large v3 | 4,07 % | Oui — MIT |
Source : classement speech-to-text d'Artificial Analysis, AA-WER v2, relevé le 5 août 2026. La possibilité de téléchargement est déduite de la licence publiée de chaque modèle.
Les quatre premières lignes montrent que les modèles les mieux notés de cet instantané sont hébergés, et que le leader est un point de terminaison en préversion plutôt qu'un modèle téléchargeable.
Voxtral Small est sous Apache 2.0 et se classe cinquième à 2,77 %, à environ un point de pourcentage du modèle fermé en préversion en tête. Pour une réunion d'une heure et de 6 300 mots, cet écart représente environ 66 mots. C'est un écart réel, mais pas infranchissable pour les équipes qui privilégient le déploiement local.
Pour de nombreux usages, les modèles vocaux ouverts sont déjà suffisamment bons. La décision restante consiste à savoir si un écart de précision modéré vaut le contrôle de l'auto-hébergement, ou si les fonctions supplémentaires d'un service hébergé justifient son coût.
Ce que l'exécution en interne vous apporte, et ce qu'elle coûte
Trois choses poussent les équipes vers l'auto-hébergement, et aucune n'est la précision.
La confidentialité est la première et généralement la décisive. Si vous transcrivez des consultations médicales, des entretiens juridiques ou des entretiens RH, « l'audio ne quitte pas notre matériel » n'est pas une préférence mais une exigence d'achat, et seul un modèle que vous hébergez y répond proprement. Le fonctionnement hors ligne est la deuxième : un modèle embarqué marche en avion, dans un sous-sol, dans un atelier, sur un site sans réseau. C'est exactement pourquoi whisper.cpp et les builds GGUF affichent les chiffres de téléchargement qu'ils affichent.
Le coût est la troisième, et les chiffres sont brutaux. Toujours d'après le même relevé d'Artificial Analysis, prix pour 1 000 minutes d'audio : Whisper Large v3 hébergé sur fal.ai revient à 0,50 dollar, Canary Qwen 2.5B de NVIDIA sur Replicate à 0,74, Parakeet TDT 0.6B V3 sur Together AI à 1,50. Côté fermé, Nova-3 de Deepgram est à 4,30, MAI-Transcribe-1.5 à 6,00 et Gemini 3.1 Pro Preview à 18,15. Soit un facteur 4 face à Microsoft et un facteur 12 face à Google, rien que pour héberger un modèle ouvert sur les serveurs d'un tiers — avant même d'envisager de le faire tourner chez vous, où le coût marginal de la millième heure est de l'électricité.
Dans le même instantané, les chiffres de vitesse favorisent Parakeet TDT 0.6B V3 hébergé sur Together AI, à 885 fois le temps réel — environ quatre secondes pour traiter une heure d'audio. Nova-3 de Deepgram atteint 512x, Whisper Large v3 sur Together 478x et MAI-Transcribe-1.5 189x. L'option la plus rapide listée est un modèle open weight, mais ce résultat mesure l'hébergement par Together AI, pas l'exécution sur une machine locale.

L'arbitrage n'a jamais été précision contre précision. C'est contrôle et coût contre les fonctions qui entourent la reconnaissance.
Que vendent alors les API hébergées ? Tout ce qui n'est pas de la reconnaissance. La documentation de Deepgram en dresse un inventaire honnête : diarisation des locuteurs, streaming en temps réel, mise en forme, vocabulaire personnalisé, masquage d'entités, détection de la langue, et la garantie que le service tourne pendant que vous dormez. Téléchargez Qwen3-ASR et vous obtenez des mots et des horodatages. Pas d'étiquettes de locuteur, pas de SLA, et à vous la facture GPU, la montée en charge et l'astreinte de trois heures du matin.
Le modèle le plus téléchargé de la catégorie n'est pas un modèle de transcription
Les téléchargements montrent également une demande d'identification des locuteurs, en plus de la transcription.
Quand on trie toute la catégorie reconnaissance automatique de la parole de Hugging Face par téléchargements, le modèle en tête n'est ni Whisper, ni Qwen, ni Parakeet. C'est pyannote/speaker-diarization-3.1, avec 8,91 millions de téléchargements sur les 30 derniers jours, et un second modèle de diarisation pyannote prend la cinquième place avec 5,26 millions. La diarisation est la mécanique qui détermine qui a parlé et quand — la couche située juste au-dessus de la transcription.

Les poids ouverts couvrent désormais les deux premières couches de la pile. Celles qui décident si une note est utile se trouvent au-dessus.
Le modèle le plus téléchargé de la catégorie reconnaissance vocale ne transcrit pas la parole : il identifie qui a parlé et à quel moment. Cette demande souligne le rôle de la couche au-dessus de la transcription, où les étiquettes de locuteur transforment les mots reconnus en compte rendu de réunion utile. Cela rejoint le manque fonctionnel décrit dans notre analyse du marché fermé.
En résumé
La question intéressante sur la reconnaissance vocale open weight n'a jamais été « est-elle aussi bonne que les modèles fermés ». Elle est à environ un point de taux d'erreur de mots, elle est plus rapide, elle coûte quatre à douze fois moins cher, et elle tient sur un portable. La question intéressante, c'est ce que vous bâtissez dans l'espace qui s'ouvre quand la transcription cesse d'être une ligne de dépense louée — car un fichier de 1,56 Go qui entend 52 langues n'est pas un produit. C'est un composant qui vient de devenir gratuit.
Pour une équipe qui choisit un outil de notes de réunion plutôt qu'un modèle, la lecture pratique est courte. Qu'un produit fasse tourner un modèle ouvert ou une API fermée relève désormais largement du détail d'implémentation, et ce sera de plus en plus les deux : poids ouverts pour le gros du travail, API hébergées là où diarisation, streaming et passage à l'échelle justifient leur prix. Telli.sh exécute déjà un modèle ouvert dans sa couche de synthèse, si bien que les progrès du camp ouvert se répercutent directement sur la transcription, la traduction et les notes de réunion, sans changement de tarif. Jugez l'outil sur ce qui sort à la fin : est-ce que la note vous dit qui s'est engagé à quoi.
Démarrer une note IA en direct
Sources
- Fiche du modèle Qwen3-ASR-0.6B-hf (Hugging Face) — licence, liste des langues, chiffres du classement datés du 26 juin 2026
- Fiche du modèle Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (soumis le 29 janvier 2026)
- Dépôt OpenAI Whisper (MIT, publié le 16 septembre 2022)
- whisper.cpp et faster-whisper
- Fiche du modèle NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Classement speech-to-text d'Artificial Analysis — AA-WER v2, chiffres de vitesse et de prix relevés le 5 août 2026
- Hugging Face Open ASR Leaderboard
- Documentation Deepgram sur la diarisation
- Page de l'image sur Wikimedia Commons
